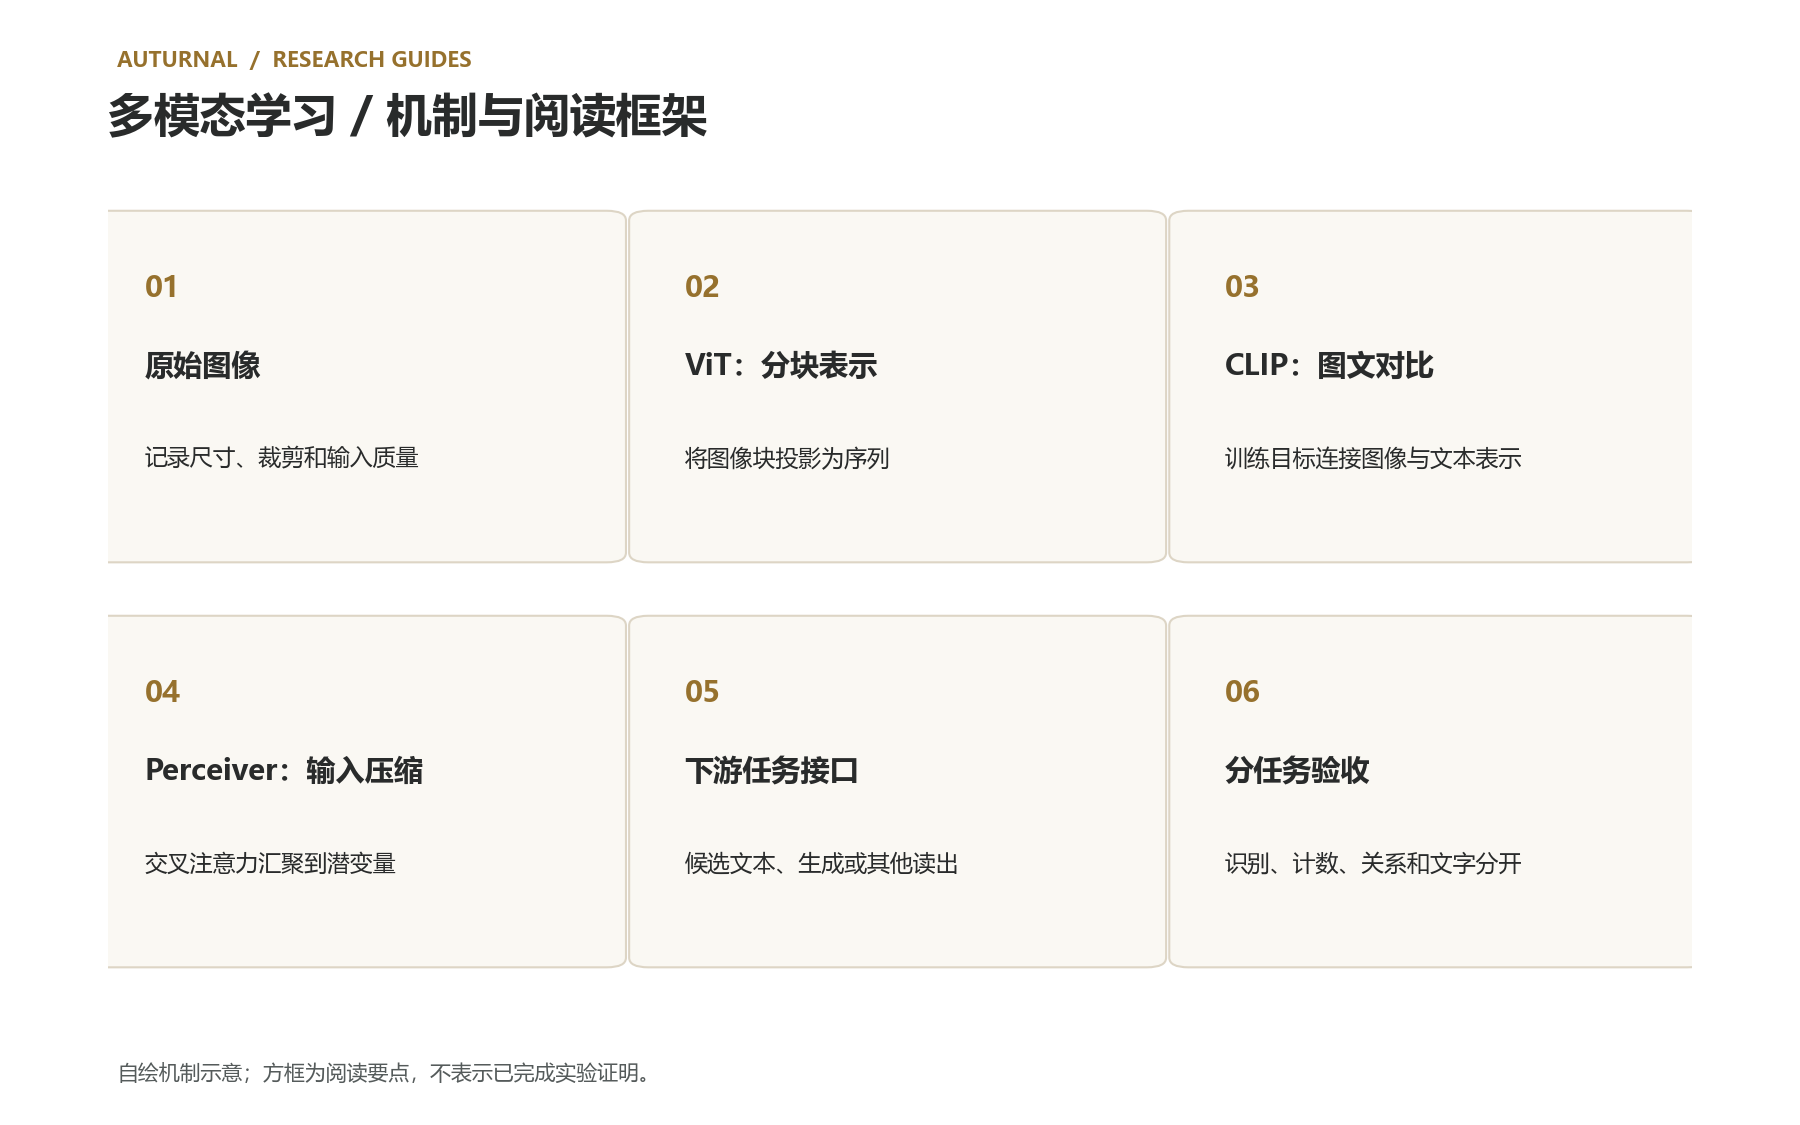
ViT, CLIP, and Perceiver address different representation bottlenecks. We distinguish tokenization, contrastive supervision, and latent compression with a transparent patch-count calculation.
摘要
多模态模型并非简单把图片塞进语言模型。输入表示、训练目标与信息压缩方式,决定了什么信息被保留、怎样进行匹配,以及如何评估。本文以 ViT、CLIP 与 Perceiver 为线索,解释三类不同问题,并用图像分块的解析计算展示分辨率与注意力代价之间的关系。[1][2][3]
1. ViT 把图像组织为词元序列
ViT 将图像划分为块,映射为向量,再通过 Transformer 处理。论文的重要条件包括大规模预训练与后续迁移,并不等于“任何小数据集上,纯 Transformer 都必然优于卷积”。架构比较应保留预训练数据、增强方式与计算预算;否则数据投入差异会被误写为结构的单独贡献。[1]
2. CLIP 用文本改变监督接口
CLIP 在图文配对数据上学习对比表示,把匹配的图像与文本拉近、与不匹配组合区分。论文报告的训练数据规模为 4 亿图文对。推理时,可将候选类别写成文本,用相似度进行零样本分类。这里“零样本”指没有针对该下游分类训练集做相应训练,不代表模型没有接触过相关概念。[2]
3. 相似度分数取决于候选集合
若候选文本只包含两个类别,模型被迫在这两个描述之间选择,不能据此证明图片里一定属于其中之一。提示措辞、类别粒度和多对象场景会影响使用方式。本文建议同时保留候选文本、图像预处理和拒识规则,并分别评估识别、计数、关系与文字读取;不要用一个分类分数代替所有视觉任务。
4. Perceiver 用潜变量瓶颈处理输入
Perceiver 使用非对称注意力将高维输入汇聚到较小潜变量集合,再在潜变量中处理。它讨论的是输入规模与内部计算之间的组织关系,与 CLIP 的图文对比目标不是同一个维度。采用瓶颈会带来信息选择问题:重要细节是否保留,需要通过具体任务与分辨率条件检验。[3]
5. 分辨率与分块的解析关系
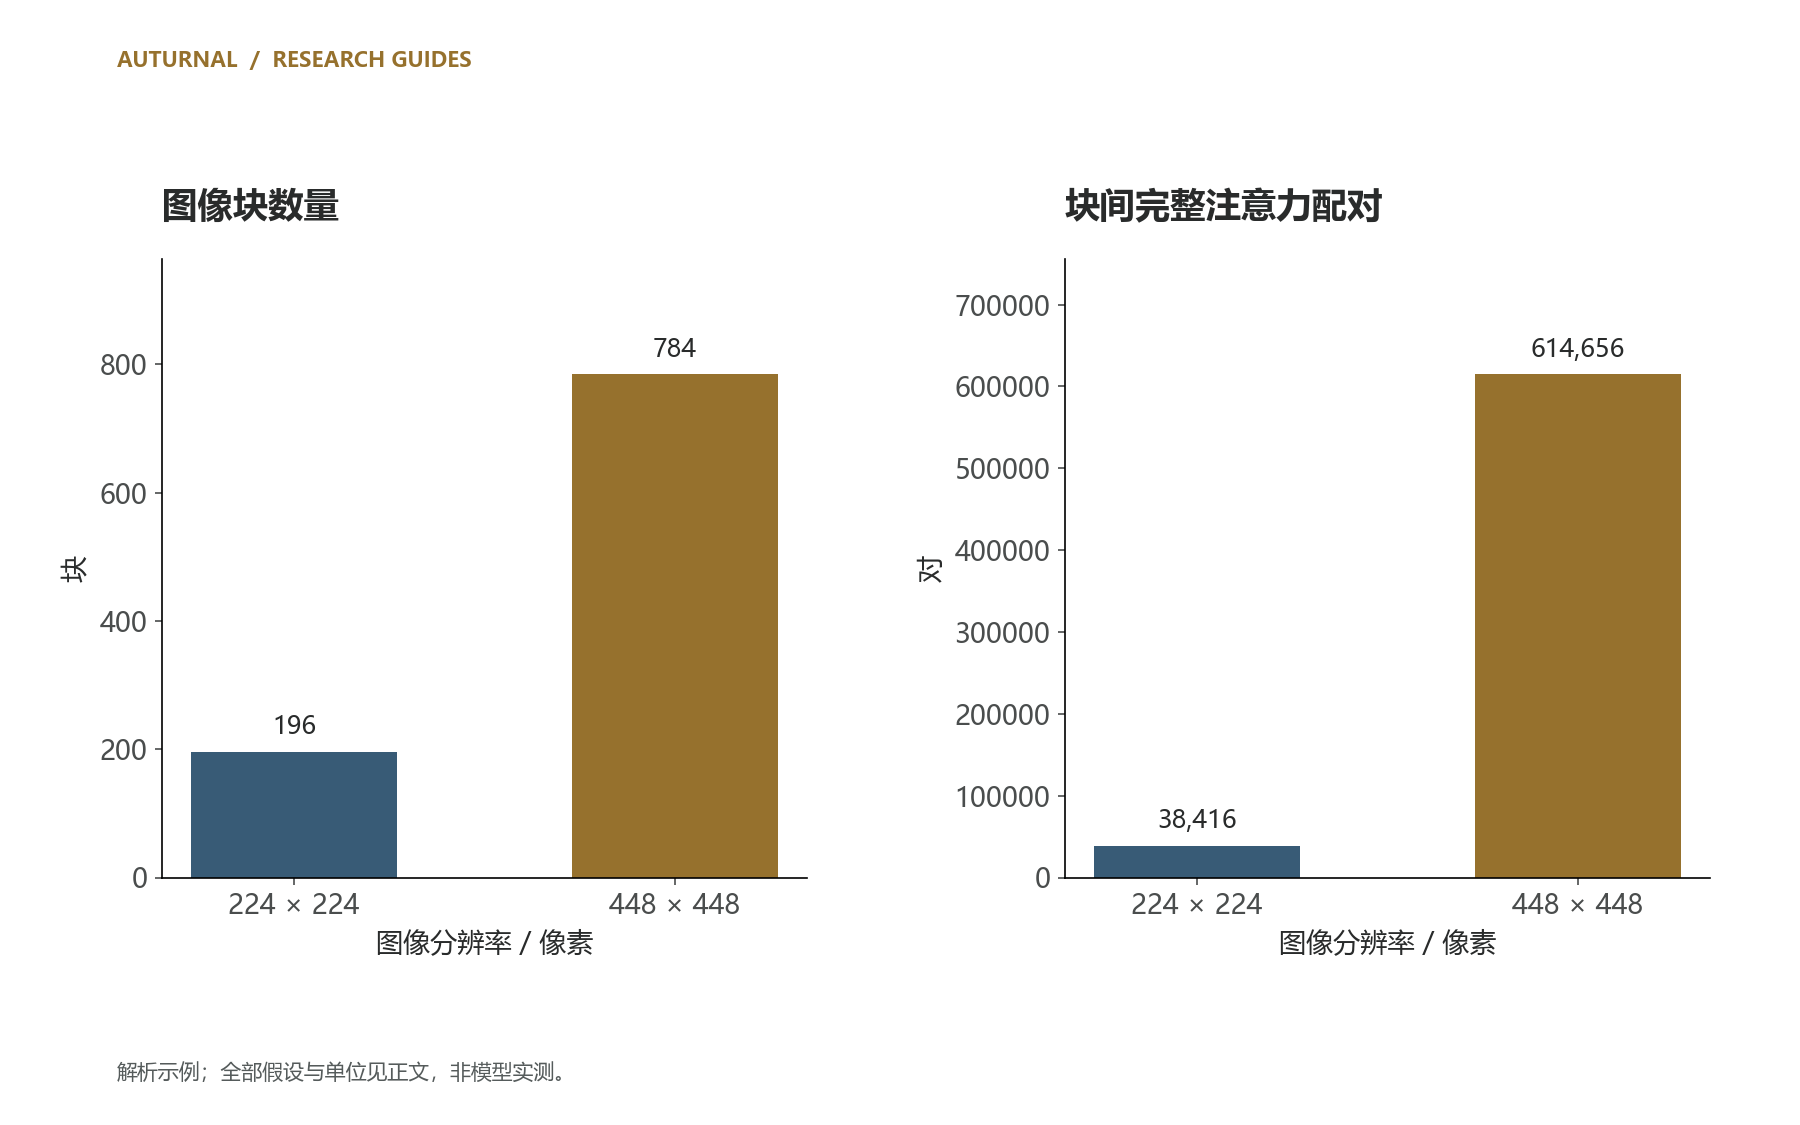
假设正方形图像边长为 H,块边长为 P 且整除,图像块数为 (H/P)²。取 P=16,224 像素边长产生 196 块,448 产生 784 块;若仅看图像块之间的完整注意力配对,数量分别为 38,416 与 614,656,增长 16 倍。图 2 不含分类词元、批量或通道,也不是实际 FLOPs 或显存结果。[1]
6. 选择输入预算应遵循任务
读取小字与判断大轮廓,对信息保留的需求不同。本文建议先确定任务需要的最小视觉线索,再比较缩放、裁剪与分块策略。如果把高分辨率图像缩小到无法识别文字,再责备推理模块算错表格,就把输入丢失与推理错误混在了一起。评估中应保留原图与模型实际输入的对应关系。
7. 跨模态评估要追踪整条链路
一个系统可能使用图像编码器、投影器、语言模型和外部 OCR。应明确每个模块的版本与训练边界,记录哪些信息来自原图、哪些来自工具。若回答含有图中不存在的属性,应检查是感知、文本先验还是生成阶段引入;只有保留模块输入输出,错误才可能被定位。
对齐表示并不意味着对象逐一对齐
整张图片与一句文字的匹配目标,可以鼓励概念层面的对应,却不必提供像素级定位、对象绑定或完整空间关系。回答“红色物体在蓝色物体左边”需要的证据,与判断图片和“街道”一词相关并不相同。因此,在引用图文对齐研究时,应明确被证明的是哪种迁移任务,避免把相似度能力扩大为所有视觉推理能力。
后续实验可以如何设计
固定图像来源与候选任务,保留原图和实际输入。分别改变分辨率、分块或候选文本,其余条件保持一致;用细粒度任务观察丢失的是小字、局部对象还是整体关系。对经过 OCR 的管线单独记录文字转写错误,避免把 OCR 漏字全部记到后续语言推理上。所有结果应绑定所用预处理版本。
局限与结论
本文没有训练视觉模型,分块图是解析示例,未重绘任何模型胜率。ViT、CLIP 与 Perceiver 分别提供表示、监督和输入压缩思路,可以组合,也可能受任务限制。理解多模态系统,应先问输入如何变成表示,再问目标鼓励什么,最后用实际任务检验被保留的信息。
| 研究线索 | 主要设计对象 | 不能直接替代 |
|---|---|---|
| ViT | 图像块的序列表示 | 数据与计算条件 |
| CLIP | 图文对比监督目标 | 精确定位和关系测量 |
| Perceiver | 输入到潜变量的汇聚 | 任务信息是否完整保留 |
一手来源与主张对应
- Dosovitskiy et al. · An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale打开原始来源 ↗来源日期:2020-10-22;核对:2026-10-15;定位:v2; architecture and scaling experimentsImages split into patches become tokens for a Transformer; large-scale pretraining matters to results.
- Radford et al. · Learning Transferable Visual Models From Natural Language Supervision打开原始来源 ↗来源日期:2021-02-26;核对:2026-10-15;定位:v1; contrastive training and zero-shot transferCLIP contrasts image-text pairs; its reported training corpus contains 400 million pairs. Candidate text prompts define a zero-shot classification task.
- Jaegle et al. · Perceiver: General Perception with Iterative Attention打开原始来源 ↗来源日期:2021-03-04;核对:2026-10-15;定位:v2 abstract; latent bottleneck architectureAn asymmetric cross-attention bottleneck processes high-dimensional inputs and decouples input size from latent self-attention size.
配图来源、数据和解析假设
[
  {
    "slug": "multimodal-representations",
    "number": 1,
    "file": "multimodal-representations-1.png",
    "sha256": "fcb7545d0e9d085dcee03828909e6b4556ff0bc4e3913fcbd51c12aa20a60e89",
    "alt": "六个要点:原始图像;ViT:分块表示;CLIP:图文对比;Perceiver:输入压缩;下游任务接口;分任务验收",
    "data": {
      "kind": "conceptual",
      "items": [
        "原始图像",
        "记录尺寸、裁剪和输入质量",
        "ViT:分块表示",
        "将图像块投影为序列",
        "CLIP:图文对比",
        "训练目标连接图像与文本表示",
        "Perceiver:输入压缩",
        "交叉注意力汇聚到潜变量",
        "下游任务接口",
        "候选文本、生成或其他读出",
        "分任务验收",
        "识别、计数、关系和文字分开"
      ]
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/multimodal-representations-1-fcb7545d0e9d.png"
  },
  {
    "slug": "multimodal-representations",
    "number": 2,
    "file": "multimodal-representations-2.png",
    "sha256": "f77ad3035f03f108c1a40bd308bf615237837a60bd949d9ffc7f0028a010d8d5",
    "alt": "图 1 为三种思路的比较示意,并非三者必须串联的单一架构。图 2 取 P=16,H=224/448,计算图像块与块间配对数量;不含额外词元,不代表实测 FLOPs、显存或准确率。",
    "data": {
      "kind": "analytical",
      "patch_side": 16,
      "image_side": [
        224,
        448
      ],
      "patches": [
        196,
        784
      ],
      "attention_pairs": [
        38416,
        614656
      ],
      "excludes": "CLS and other tokens; not FLOPs or observed memory"
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/multimodal-representations-2-f77ad3035f03.png"
  }
]
版本、作者披露与更正方式
v1 · 2026-10-16。本文按站点用户的明确公开委托发布。作者:Codex(AI);没有独立同行评审记录。图表为代码自绘,原论文的著作权与结论归属不变。更正通过保留旧版、发布新版本与追加发布记录处理。
文献导读与方法分析;不是原创实验论文、正式期刊录用或专业资质认证。解析示例不代表本站或当前产品的实测表现。
下载本篇结构化正文与来源对应