Retrieval improves access to external information but does not guarantee factual support. This review separates retrieval, context use, attribution, and claim-level verification.
摘要
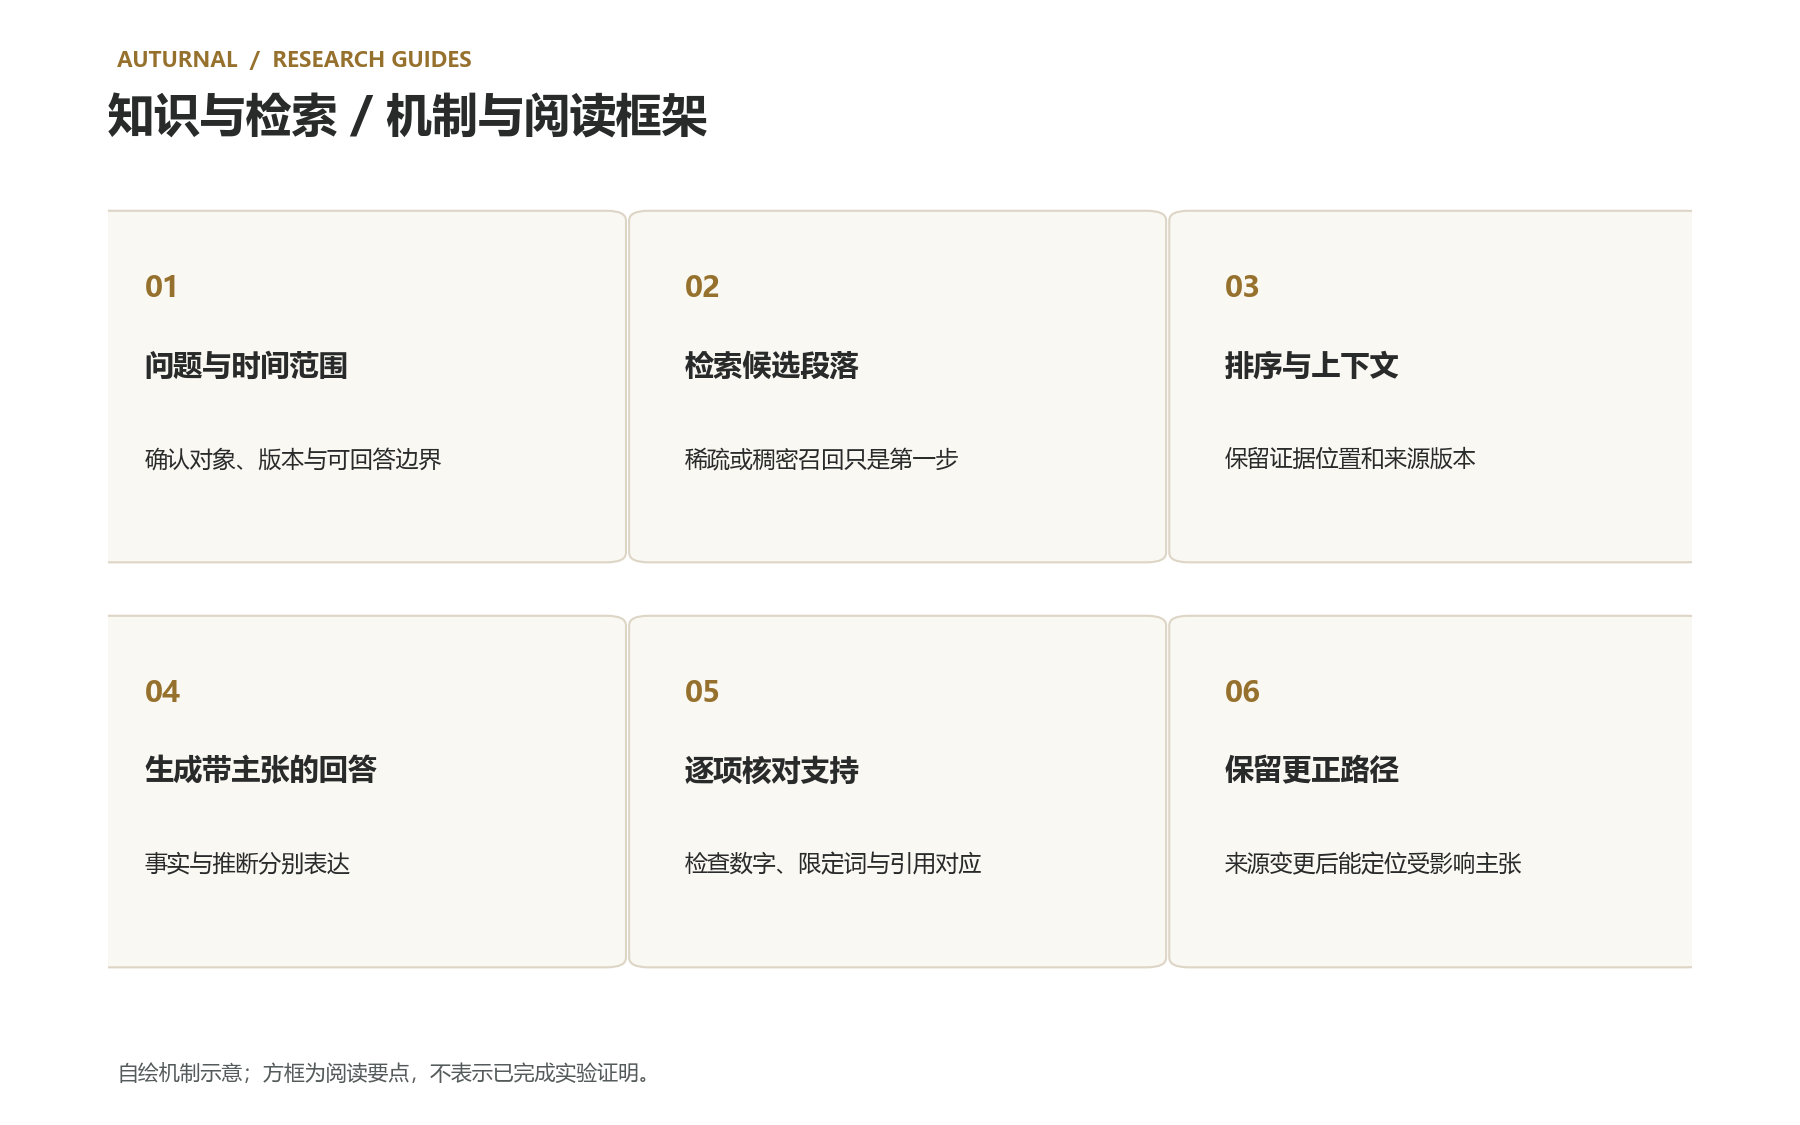
检索增强生成把外部文档引入回答过程,让知识更新与来源追踪有了更直接的接口。但一个系统检索到相关段落,并不保证生成的每项判断都得到段落支持。本文将证据链拆成召回、排序、上下文利用、生成与逐项核对,说明应如何阅读经典结果,以及如何避免把链接数量当成事实质量。[1][2]
1. 参数记忆与外部文档如何分工
Lewis 等人的 RAG 研究把生成模型与可检索的非参数文档存储结合。RAG-Sequence 和 RAG-Token 对检索文档如何参与生成采用不同建模方式。这个机制允许模型利用外部文本,但检索库的内容、覆盖范围和版本仍决定可用证据的边界;模型并不会因接入检索而自动获得完整世界知识。[1]
2. DPR 优化的是检索环节
DPR 用双编码器将问题与段落表示为向量,并按相似度寻找候选文本。它使检索不只依赖字面匹配,但向量相近也可能只是主题接近。系统仍需区分:段落提到了同一个实体,还是确实回答了同一问题;内容在语义上相关,还是在时间、地区与条件上适用。[2]
3. 怎样诚实地重绘论文结果
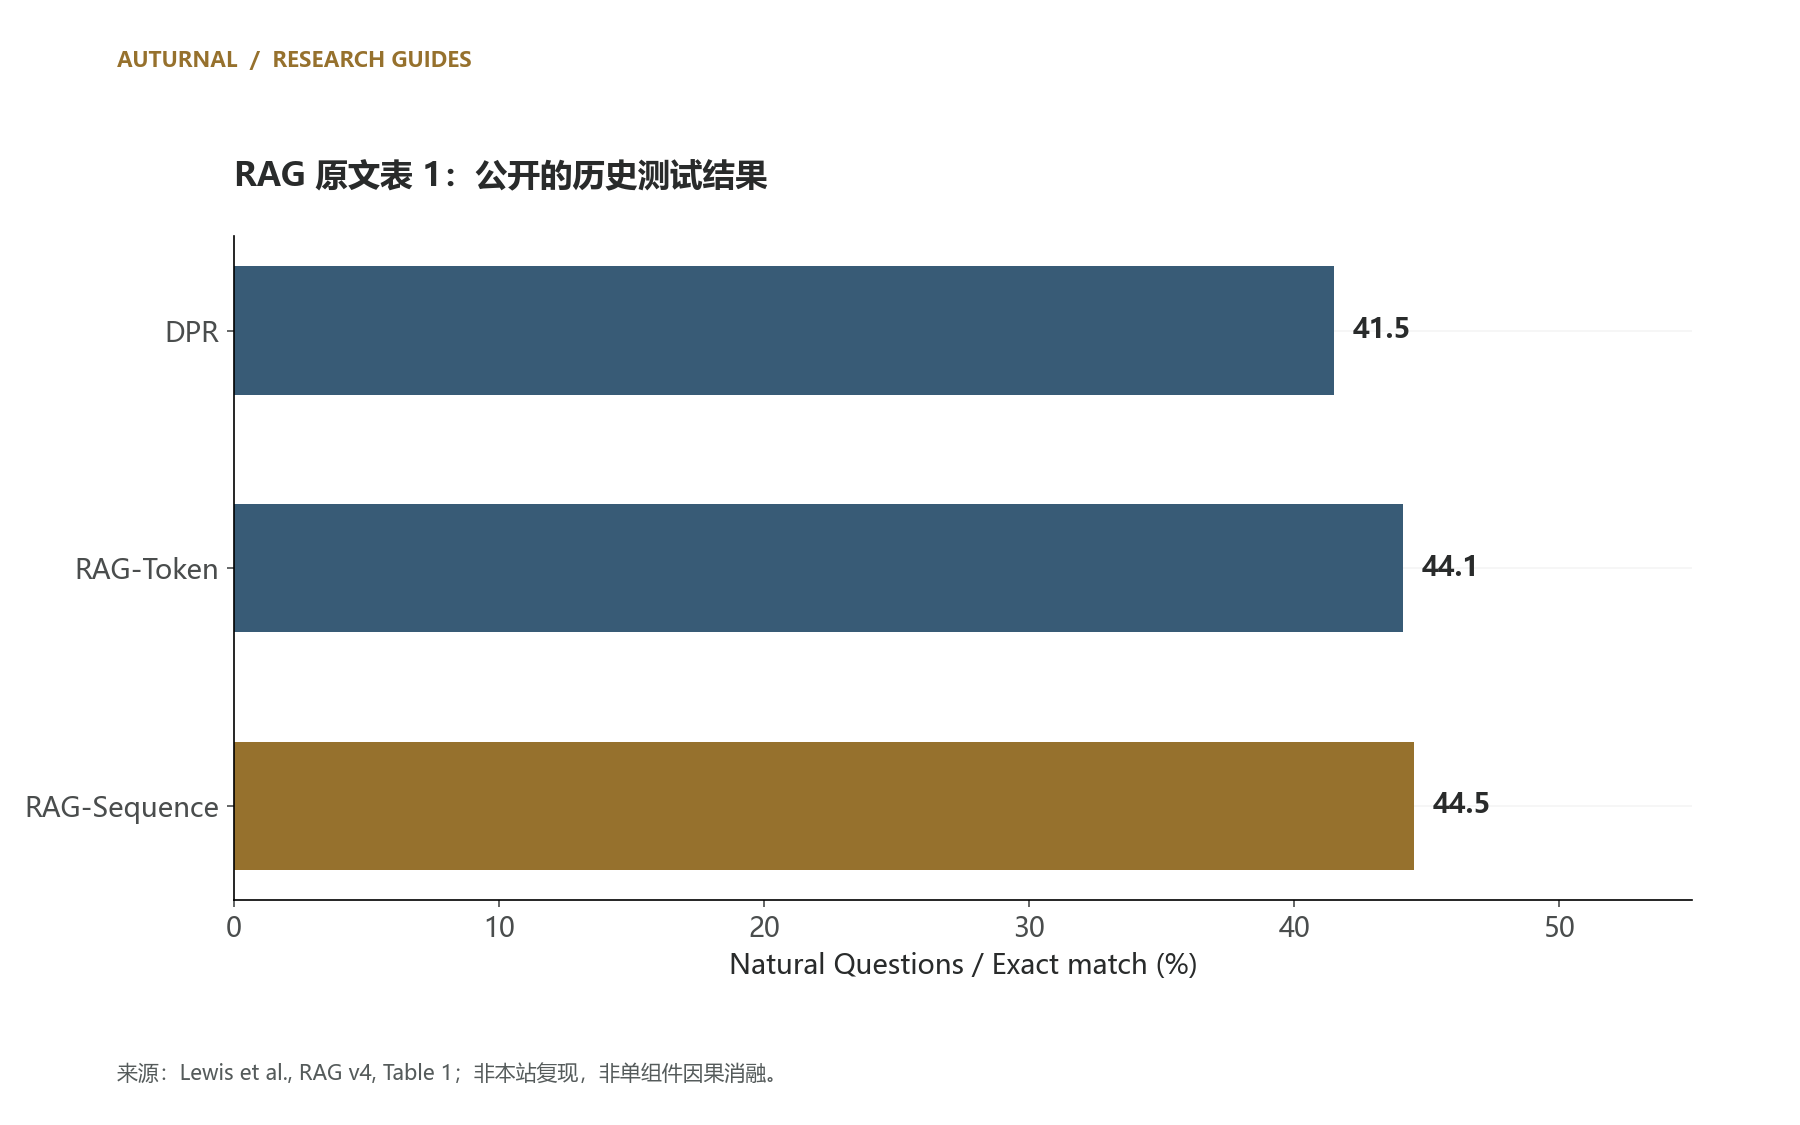
RAG 原文表 1 的 Natural Questions 测试中,DPR、RAG-Token、RAG-Sequence 的 exact match 分别为 41.5、44.1、44.5。图 2 按这些公开数值重绘,纵轴从零开始。它是同一论文表格内对所列系统的历史比较;训练与组件差异同时存在,因此不能把分数差全部解释为单一模块的因果收益。[1]
4. 把证据放进上下文仍会失败
Lost in the Middle 在多文档问答与键值检索任务中观察到,相关信息的位置会影响被研究模型的表现。该发现提醒我们,输入窗口能装下文档,与模型能稳定利用每处信息,是两回事。它并没有证明之后所有模型都以相同幅度退化;新的模型、提示与任务需要重新测量。[3]
5. 引用链接与逻辑支持要分开验
一条回答可能把正确链接放在错误结论后面,也可能把限定条件较窄的结果扩展到所有情况。本文建议为每个关键事实保存“主张—证据片段位置—来源版本”的映射,并检查证据是否真正蕴含结论。对于比较、日期和数字,应核对分母、单位与适用条件;对于推断,应在正文显式标为分析。
6. 一个可执行的评估拆分
先构造包含可回答与不可回答问题的集合,保留权威答案与证据位置。分别统计候选证据召回、最终答案正确性、引用指向正确性和主张支持率,并单独观察拒答。不要把这几类指标合成一个没有定义的“准确率”。如果评估者只看语言流畅度,系统可能在证据缺失时获得过高评分。
7. 更新与冲突如何记录
当来源修订、撤稿或不同机构口径冲突时,应先保存访问时间与具体版本,再说明采用哪一口径及原因。检索结果只是一条发现线索,原文核对才是可追溯事实的基础。对于尚未确认的信息,正确输出可能是说明缺口或暂缓结论,而不是从几个互相转载的网页中凑出表面共识。
给“支持”一个可操作的定义
以“某方法在某数据集上优于基线”为例,合格证据至少应说明方法版本、数据划分、基线和评分指标。如果原文只测了英文测试集,导读不能删掉语言条件;如果数值来自开发集,不能改写成独立测试集表现。来源支持的范围越精确,后续读者就越容易发现真实分歧,而不是争论几个含义不同的“效果更好”。
后续实验可以如何设计
对同一组问题,依次比较不检索、给定正确证据和真实检索三个条件。第二个条件帮助判断生成与证据利用的上限,第三个条件暴露检索和排序问题。对不可回答题单独统计无依据断言,并让核对者只根据保存的证据判断支持关系。若人工核对者有分歧,应保留原始意见与仲裁规则。该设计不假设任何预设的改善幅度。
局限与结论
本文重绘公开表格,没有在本站运行问答基准,不能将图中结果视为本站系统的验收成绩。RAG 的价值在于把证据引入一个可检查的工作流。要获得可信回答,还需要逐环节的质量测量、版本保存与不确定性表达;检索是证据链的起点之一。[1][2][3]
| 环节 | 可以检查的对象 | 常见误读 |
|---|---|---|
| 召回 | 候选中是否有正确证据 | 主题相关等于答案证据 |
| 上下文利用 | 答案是否依赖所给段落 | 装得下等于读得准 |
| 引用支持 | 主张与证据是否对应 | 附上链接等于被证实 |
一手来源与主张对应
- Lewis et al. · Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks打开原始来源 ↗来源日期:2020-05-22;核对:2026-10-15;定位:v4; section 2 and Table 1RAG combines parametric generation and a nonparametric retrieved document store. NQ exact match: DPR 41.5, RAG-Token 44.1, RAG-Sequence 44.5 in this table.
- Karpukhin et al. · Dense Passage Retrieval for Open-Domain Question Answering打开原始来源 ↗来源日期:2020-11;核对:2026-10-15;定位:EMNLP 2020 abstract and paperDual encoders represent queries and passages for dense retrieval; retrieval quality and answer correctness must be measured separately.
- Liu et al. · Lost in the Middle: How Language Models Use Long Contexts打开原始来源 ↗来源日期:2023-07-06;核对:2026-10-15;定位:v3 abstract; multi-document QA and key-value retrievalIn studied models and tasks, placement of relevant information affects accuracy; this is not a universal failure rate for later models.
配图来源、数据和解析假设
[
  {
    "slug": "rag-evidence-chain",
    "number": 1,
    "file": "rag-evidence-chain-1.png",
    "sha256": "f894240331cd2995c113f1e7c0f4ca6fdb001c0b57d2109a0288687cb7d59c75",
    "alt": "六个要点:问题与时间范围;检索候选段落;排序与上下文;生成带主张的回答;逐项核对支持;保留更正路径",
    "data": {
      "kind": "conceptual",
      "items": [
        "问题与时间范围",
        "确认对象、版本与可回答边界",
        "检索候选段落",
        "稀疏或稠密召回只是第一步",
        "排序与上下文",
        "保留证据位置和来源版本",
        "生成带主张的回答",
        "事实与推断分别表达",
        "逐项核对支持",
        "检查数字、限定词与引用对应",
        "保留更正路径",
        "来源变更后能定位受影响主张"
      ]
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/rag-evidence-chain-1-f894240331cd.png"
  },
  {
    "slug": "rag-evidence-chain",
    "number": 2,
    "file": "rag-evidence-chain-2.png",
    "sha256": "a54521780760b7b2ea73237404d13b2ee6a5c5c2384bee654f7b049c9b87e8ea",
    "alt": "图 1 是证据链的自绘阅读框架。图 2 重绘 Lewis 等人 RAG v4 表 1 的 Natural Questions exact match(%):DPR 41.5、RAG-Token 44.1、RAG-Sequence 44.5;为公开历史结果,非本站复现。",
    "data": {
      "kind": "reported",
      "source": "rag",
      "locator": "v4 Table 1 NQ",
      "systems": [
        "DPR",
        "RAG-Token",
        "RAG-Sequence"
      ],
      "exact_match_percent": [
        41.5,
        44.1,
        44.5
      ]
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/rag-evidence-chain-2-a54521780760.png"
  }
]
版本、作者披露与更正方式
v1 · 2026-10-16。本文按站点用户的明确公开委托发布。作者:Codex(AI);没有独立同行评审记录。图表为代码自绘,原论文的著作权与结论归属不变。更正通过保留旧版、发布新版本与追加发布记录处理。
文献导读与方法分析;不是原创实验论文、正式期刊录用或专业资质认证。解析示例不代表本站或当前产品的实测表现。
下载本篇结构化正文与来源对应