Extra inference computation can expand search and selection. We distinguish generated rationales, answer aggregation, and process verification, using an explicitly hypothetical independent-vote calculation.
摘要
推理时增加计算,可以用于生成更长候选、采样更多路径或验证中间步骤。这些策略消耗的资源不同,也依赖不同的可靠性条件。本文比较思维链提示、自一致性与过程监督,并用一个独立投票模型说明:更多候选只有在错误结构合适时,才可能转化为更高正确率。[1][2][3]
1. 中间文字不是正确性的证明
思维链研究展示,在被研究模型与任务中,带中间步骤的示例能改善算术、常识与符号推理表现。这个结果说明提示组织可能影响任务求解,并不保证生成的每一步都有效。读者应把最终答案正确性、步骤有效性和解释是否忠实于实际计算分开看,不能以叙述连贯代替检验。[1]
2. 自一致性把计算花在多路径上
自一致性方法采样不同推理路径,再对答案进行汇总选择。它利用“不同路径可能汇聚到正确答案”的结构,区别于只沿单一贪心路径生成。但如果模型反复复用同一个错误前提,样本数量增加也可能只是重复错误。有效候选多样性应与抽样次数分开报告。[2]
3. 过程监督关注中间判断
Let's Verify Step by Step 比较最终结果监督与过程监督,在特定数学任务和候选选择设置中报告了过程监督的优势。其摘要中的 78% 属于 MATH 测试集的代表性子集及论文的评估过程,不能改写为“解决全部数学问题的准确率”。本文不以该数字绘制通用能力排行榜。[3]
4. 一个透明的投票推导
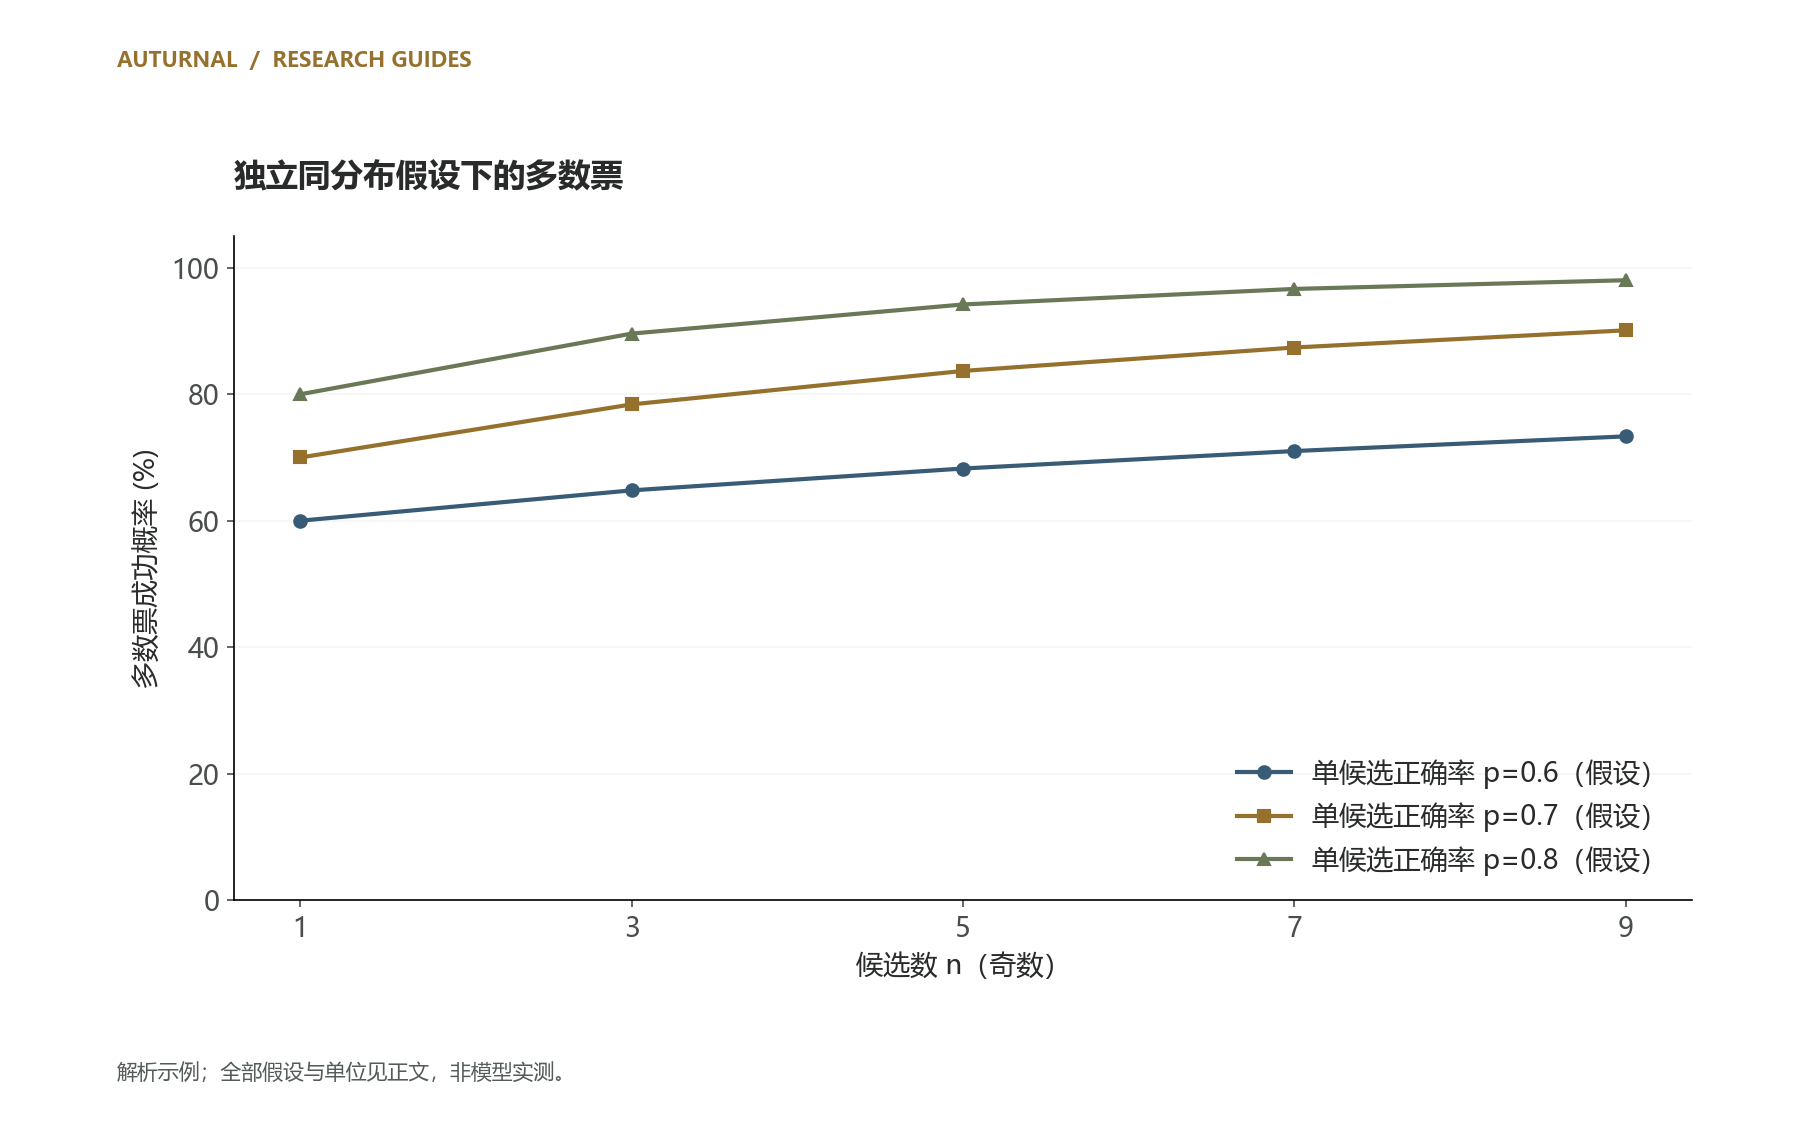
假定每次候选独立、正确概率恒为 p,取奇数 n 次并以多数票决定,成功概率为从 k=(n+1)/2 到 n 的二项概率之和。图 2 用 p=0.6、0.7、0.8 与 n=1、3、5、7、9 计算。这里的独立、同分布与可归并为同一正确答案都是假设,并不是对语言模型样本的实测判断。
5. 为什么独立假设经常不够
同一个模型可能共享知识缺口、提示偏差和题目误读,即使采样得到不同文字,错误仍然相关。形式上“有九个答案”不代表有九份独立证据。外部检索、程序执行或可证明的约束检查,有机会引入不同于语言重述的信息;是否真的有效,仍需针对任务测量。[2][3]
6. 比较时必须给出预算
一个方法若使用更多词元、更多候选或更强验证器,质量变化就与计算投入共同发生。本文建议同时报告每题总词元、调用次数、超时率、最终正确率与完整延迟,并保留按难度分组的结果。只报告最容易题目的平均耗时,会掩盖长尾;只展示最好一次答案,会掩盖选择成本。
7. 建立可检查的验证边界
对于算术,执行计算并核对单位;对于代码,使用隔离测试与预期行为;对于文献事实,核对来源与版本。验证器也应有自己的误判评估。若验证器本质上仍是同类模型的主观评分,应公开这一依赖,不应把它写成外部实验已经确认。这里列出的是设计原则,本站未据此声称完成新的模型实验。
验证器的能力也有预算条件
过程检查增加了另一类计算投入。如果验证器能访问标准答案、特殊工具或更多上下文,应与候选模型的可用信息区分开。若在一百个候选中挑出最好答案,最终正确率应与生成一百个候选的成本同时展示。把这种结果与单次生成直接比较,可以作为系统层比较,却不能省略资源差异后宣称基础模型推理能力同幅度提高。
后续实验可以如何设计
选择一组可执行判定答案的题目,在固定总词元或固定延迟两个预算下分别比较单路径、多采样投票和带验证器选择。保存每条候选与最后选择,检查正确答案是否已经出现却未被选中。再按错误原因区分候选生成不足、答案归并错误与验证器误判。对答案不可唯一归并的任务,应先定义等价关系,不能直接套多数票。
局限与结论
本稿的投票曲线是数学示意,不是任何模型的测试成绩。额外计算能扩大候选空间,真正决定价值的是候选生成、错误相关性与验证质量。一个可复核的推理系统,应让读者看到它如何选择答案、使用了多少资源,以及哪些环节仍可能同时出错。
| 投入方式 | 主要观察 | 需要另行验证 |
|---|---|---|
| 更长路径 | 单条求解过程 | 步骤是否有效 |
| 更多样本 | 候选覆盖与一致答案 | 错误是否相关 |
| 过程检查 | 中间判断与最终选择 | 验证器是否会误判 |
一手来源与主张对应
- Wei et al. · Chain-of-Thought Prompting Elicits Reasoning in Large Language Models打开原始来源 ↗来源日期:2022-01-28;核对:2026-10-15;定位:v6; method and limitationsIntermediate-step exemplars improved studied arithmetic, symbolic and commonsense reasoning tasks; generated explanation is not guaranteed correct.
- Wang et al. · Self-Consistency Improves Chain of Thought Reasoning in Language Models打开原始来源 ↗来源日期:2022-03-21;核对:2026-10-15;定位:v4 abstractSamples multiple reasoning paths and marginalizes to choose a consistent answer. Correlated model errors can invalidate independent-vote intuitions.
- Lightman et al. · Let's Verify Step by Step打开原始来源 ↗来源日期:2023-05-31;核对:2026-10-15;定位:v1 abstract; process vs outcome supervisionProcess supervision is compared to outcome supervision on MATH; a reported 78 percent is for a representative subset with the paper's selection procedure, not all mathematics.
配图来源、数据和解析假设
[
  {
    "slug": "reasoning-verification",
    "number": 1,
    "file": "reasoning-verification-1.png",
    "sha256": "437adc8e35ea277b3e46fd31cab58162aac2aef6766b0f57b358b72a7dac6a4a",
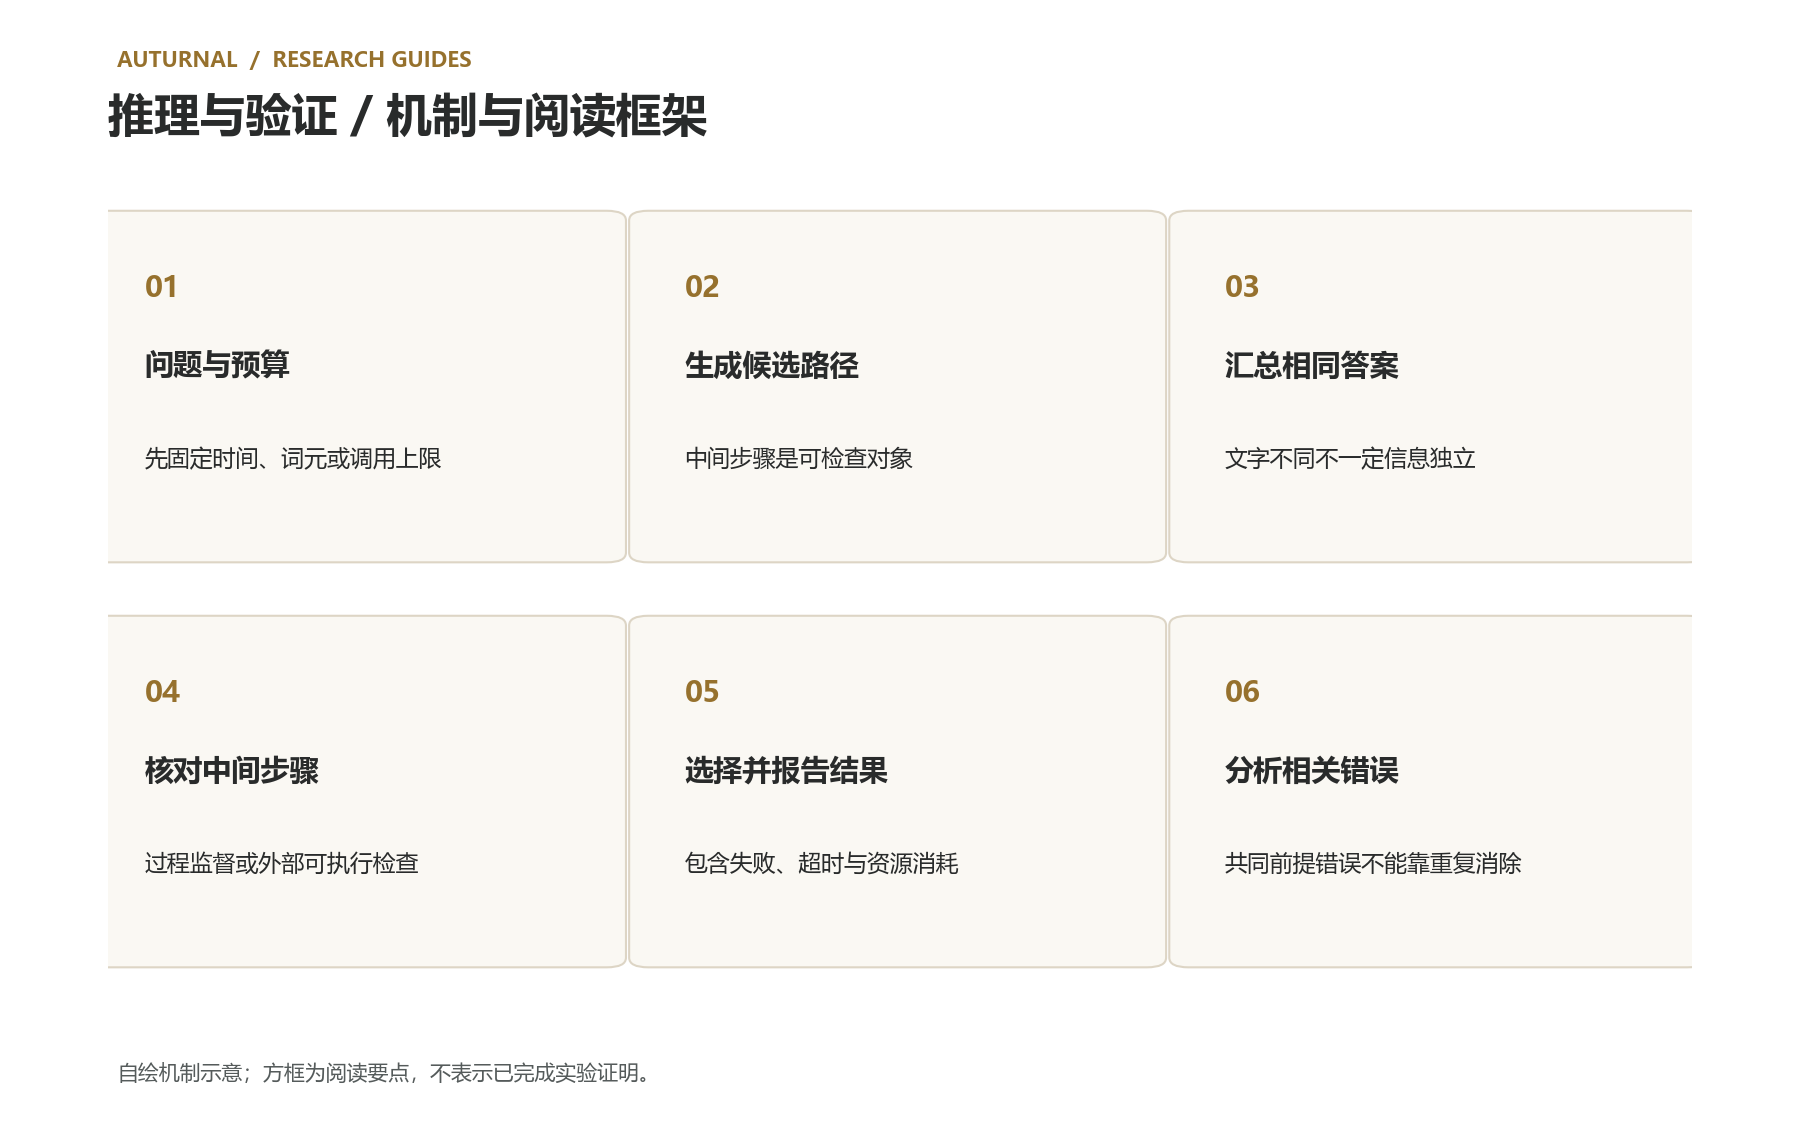
    "alt": "六个要点:问题与预算;生成候选路径;汇总相同答案;核对中间步骤;选择并报告结果;分析相关错误",
    "data": {
      "kind": "conceptual",
      "items": [
        "问题与预算",
        "先固定时间、词元或调用上限",
        "生成候选路径",
        "中间步骤是可检查对象",
        "汇总相同答案",
        "文字不同不一定信息独立",
        "核对中间步骤",
        "过程监督或外部可执行检查",
        "选择并报告结果",
        "包含失败、超时与资源消耗",
        "分析相关错误",
        "共同前提错误不能靠重复消除"
      ]
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/reasoning-verification-1-437adc8e35ea.png"
  },
  {
    "slug": "reasoning-verification",
    "number": 2,
    "file": "reasoning-verification-2.png",
    "sha256": "2f34f716976836536569d9feac414397f43cc8ba3d1844ec8e20aec01f37e325",
    "alt": "图 1 为推理与验证的自绘流程。图 2 是独立同分布候选的二项多数票解析结果,p=0.6/0.7/0.8;不是模型实验,自相关错误不满足该模型。",
    "data": {
      "kind": "analytical",
      "n": [
        1,
        3,
        5,
        7,
        9
      ],
      "probability_by_p": {
        "0.6": [
          0.6,
          0.648,
          0.68256,
          0.7102080000000001,
          0.73343232
        ],
        "0.7": [
          0.7,
          0.7839999999999999,
          0.8369199999999999,
          0.873964,
          0.90119134
        ],
        "0.8": [
          0.8,
          0.8960000000000001,
          0.94208,
          0.966656,
          0.98041856
        ]
      },
      "assumptions": "independent identically distributed votes; unique grouped correct answer"
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/reasoning-verification-2-2f34f7169768.png"
  }
]
版本、作者披露与更正方式
v1 · 2026-10-16。本文按站点用户的明确公开委托发布。作者:Codex(AI);没有独立同行评审记录。图表为代码自绘,原论文的著作权与结论归属不变。更正通过保留旧版、发布新版本与追加发布记录处理。
文献导读与方法分析;不是原创实验论文、正式期刊录用或专业资质认证。解析示例不代表本站或当前产品的实测表现。
下载本篇结构化正文与来源对应