
摘要
被动声学能够扩大生态观测范围,AI 分类器则将海量录音转化为候选物种记录。但叫声事件、物种存在、个体数量与种群趋势不是同一个终点。本文比较 BirdNET 原始研究与独立全球评价,分析地区差异、阈值、重复检测和误报对生态结论的影响。我们推导占据与检测的关系,并用构造季节变化展示固定存在状态如何产生表观下降。图中没有真实录音、物种丰度或保护状态判断,核心目的是让模型输出进入可检验的生态测量框架。[1] BirdNET: A deep learning solution for avian diversity m[2] A global assessment of BirdNET performance: Differences
English abstract
Bioacoustic classifiers detect vocal evidence, while ecological inference concerns occupancy, abundance and change. We examine BirdNET and an independent global assessment, then derive repeated-detection and false-positive relationships. A synthetic occupancy example shows that identical presence can produce different apparent trends when vocal activity or sensor conditions change. We propose site-and-season holdouts, species-specific calibration and uncertainty-aware review. The figures contain no real recordings or population estimates.
1. 原始分类任务与野外声景的难度不同
BirdNET 原始研究针对其当时的 984 种鸟类模型,分别评估单物种录音与完整声景。两类任务的背景、重叠与标签结构不同,不能直接比较指标高低来判断模型退化。本文保留原始模型年代与类别范围,不把它与后续版本覆盖混合。野外评价必须包含没有目标叫声的连续时段、同时发声和非生物噪声;只在精选单物种片段上验证,无法估计长期监测中需要人工处理多少候选。[1] BirdNET: A deep learning solution for avian diversity m
2. 全球评价提醒区域和物种差异不能被平均值覆盖
独立全球研究报告不同洲、生态环境与物种间性能存在明显差异,阈值也依物种和分析目标变化。这说明训练分布与声学条件会影响可迁移性。本文建议先固定监测问题,再按地区、季节、设备和物种分别校准;不能从某个熟悉地区的准确率推出热带复杂声景同样可靠。低出现率物种还受到样本不足与误报基数的双重影响,应该保留不可判定与人工确认状态,而不是直接计算一个精确的丰富度。[2] A global assessment of BirdNET performance: Differences
3. 本文推导:存在而没听见的概率可以很高
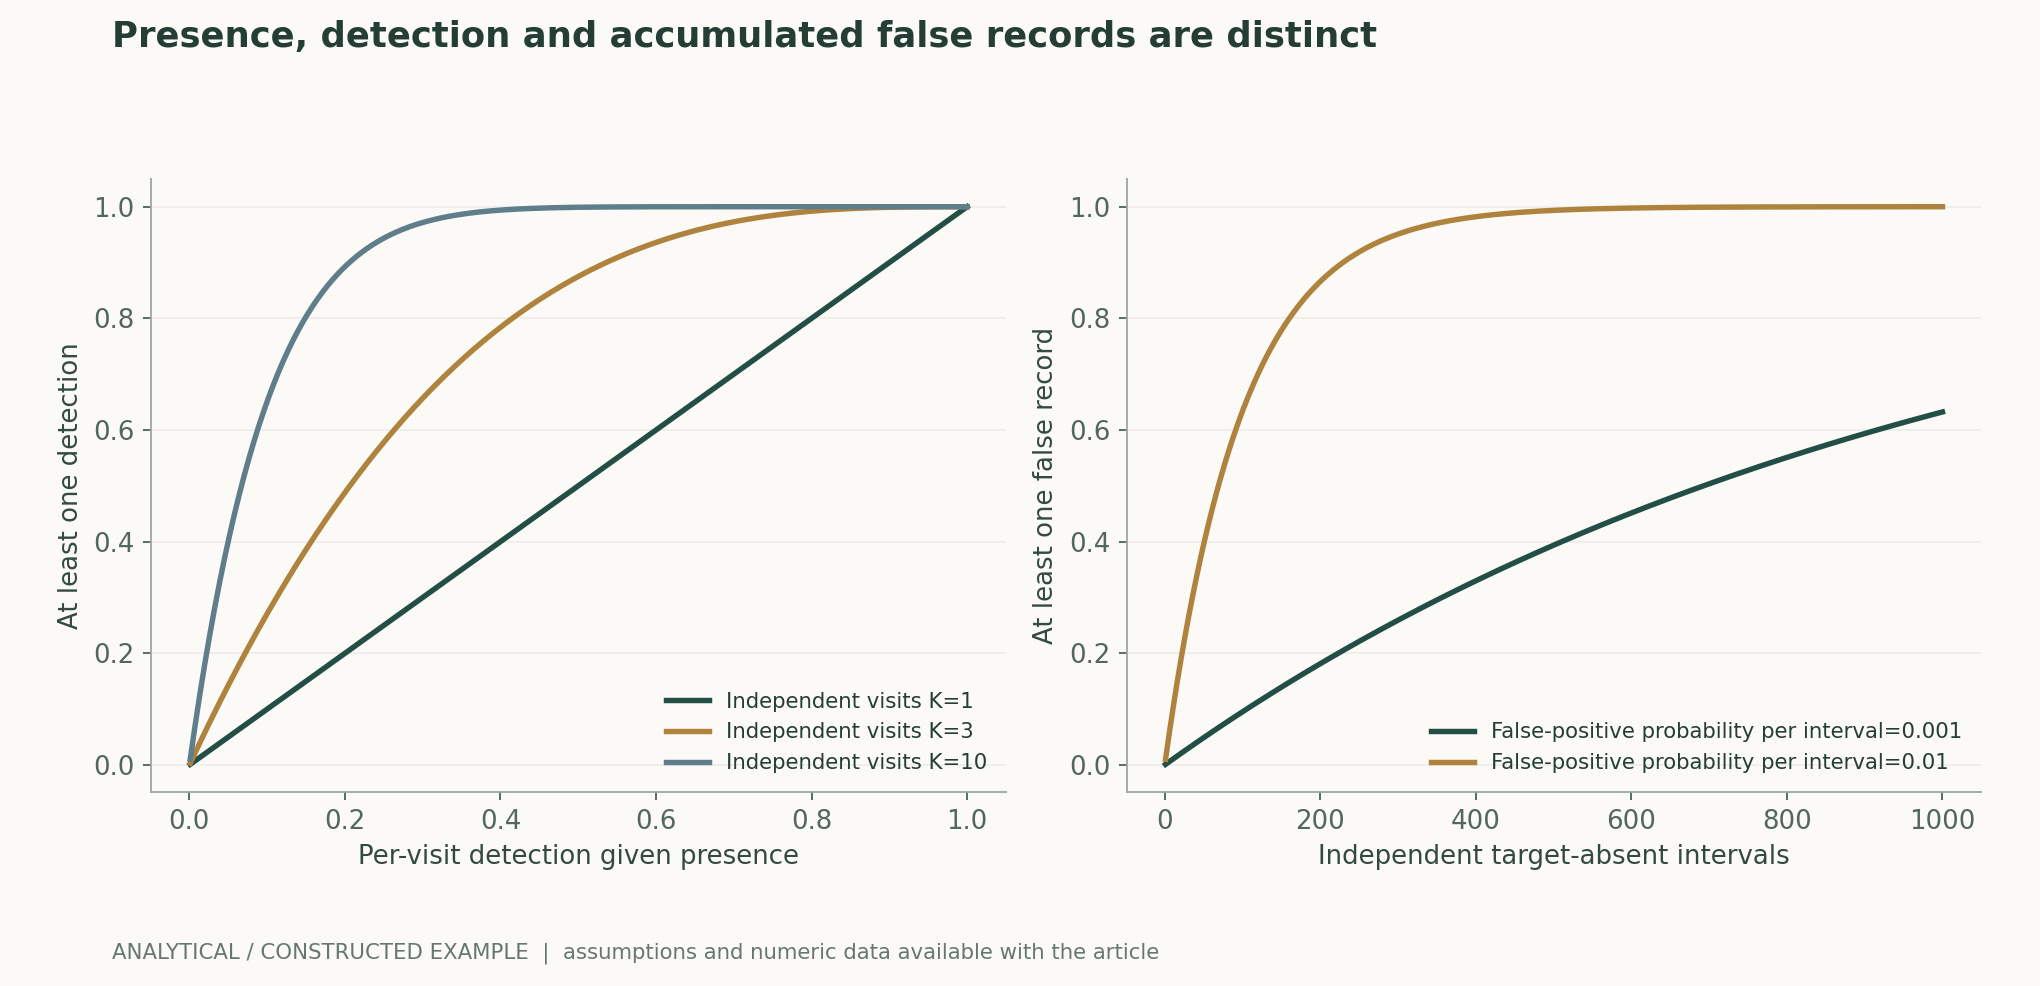
设物种在站点存在的概率为 ψ,存在条件下每次独立调查检出概率为 p;K 次至少听见一次的概率为 ψ[1−(1−p)^K]。p=0.2、K=3 时,存在条件下至少检出概率仅 0.488;K=10 时约为 0.893。这个例子表明不检出并不等于不存在。真实调查的叫声活动和噪声常相关,独立假设需要验证;模型置信分数也不能直接当成调查检出概率 p,后者包含发声、传播、采集与分类整条链。作者分析与复核建议 / Author analysis
4. 本文分析:同一占据状态也能产生表观趋势
构造某物种两个季节都实际存在,但检出概率从 0.5 降到 0.2,调查次数均为 3。至少一次检出的概率从 0.875 降到 0.488,表面上下降约 44.2%,尽管占据没有变化。图以固定 ψ 和可变 p 展示这一关系;参数不来自真实物种。天气、繁殖期叫声、植被、麦克风与背景噪声都可能改变观测概率。生态趋势分析必须建模这些观测条件,不能把分类记录减少直接解释为种群下降。作者分析与复核建议 / Author analysis
5. 稀少物种的误报需要单独控制
长期监测包含大量无目标时段,即使每个片段误报率很小,也会累积可观假记录。本文推导 K 个独立无目标片段至少一次误报的概率,并展示随 K 增长的曲线。实际噪声片段可能高度相关,因此按片段率推断站点误报必须校准。简单提高阈值会降低误报,也可能漏掉远距离或安静叫声;应按物种给出精确率、召回和所需人工核验量,而不是用全物种通用阈值掩盖差异。作者分析与复核建议 / Author analysis
6. 叫声次数不等于个体丰度
一个个体可以重复发声,多只个体也可能重叠;发声倾向、距离和遮挡影响记录次数。本文建议把声学活动指数与个体数量明确区分,只有经过独立计数或适当观测模型校准,才能推向丰度。把相邻时间片或不同设备记录的同一声事件重复计数,会进一步放大偏差。研究应保存时间、设备与去重规则,并对录音切片长度、重叠和事件合并做敏感性分析。作者分析与复核建议 / Author analysis
7. 生态指标会放大分类和覆盖偏差
丰富度、群落相似性与周转率对不同错误类型的敏感性不相同。少量稀有物种误报可以明显增加丰富度,而常见物种的漏报可能改变群落结构。本文提出从候选叫声到物种记录再到生态指标逐层传播不确定性,至少以阈值、核验与站点重采样生成区间。不能只把每条记录的最高分物种放进最终清单,再假装生态统计没有测量误差。[1] BirdNET: A deep learning solution for avian diversity m[2] A global assessment of BirdNET performance: Differences
8. 外部验证要按站点和季节隔离
同一录音背景、同一个体叫声或相邻切片跨训练测试,会让分类器利用重复声学环境。本文建议以站点、日期或完整录音为分组单位,另设跨洲或生态区的更强外推测试。预处理、降噪和物种地域先验应一起冻结;如果地理过滤提前排除了真实迁徙或罕见对象,模型可能看起来更准确却失去发现能力。地域先验应作为可审查条件,而不是隐藏在分类结果后面。[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[2] A global assessment of BirdNET performance: Differences
9. 人工核验应是一种有抽样设计的测量
只检查高分候选无法估计漏报;只检查有趣稀有对象又会使总体精确率偏倚。本文提出在分数、物种、站点和无候选片段上分层抽样,保留核验者一致性与不确定标签。对于生态结论关键的稀有记录,可独立复核,但不把人工意见当作永远无误的真值。核验预算也需进入监测成本,比较自动系统时应报告完整工作量,而非只报音频处理速度。作者分析与复核建议 / Author analysis
技术补充 A · 声谱表示改变了可用信息
短时变换的窗长控制时间与频率分辨率,频带裁剪、归一化和重采样则影响不同叫声的可见性。BirdNET 原始工作研究了声学表示与增强的作用。本文建议将这些设置作为模型的一部分保存,跨设备时核对频响和采样单位。对背景降噪也需验证:某些弱叫声可能同时被去掉。处理后听起来更干净不等于生态检测更完整,应通过独立标注的弱、重叠与远距离声音分别评估。[1] BirdNET: A deep learning solution for avian diversity m
技术补充 B · 占据与检测需要重复设计才能分离
只有一次调查时,未检出既可能因为不存在,也可能因为存在而没发声或未被采集。重复调查提供区分 ψ 与 p 的信息,但仍依赖调查期间占据稳定、条件处理合理等假设。本文建议将调查设计与模型训练一起考虑,记录重复间隔和环境条件。增加同一时刻高度相关片段,不等于增加独立调查;如果季节跨度太大又违反状态稳定,需要改用相应动态模型。作者分析与复核建议 / Author analysis
技术补充 C · 多物种筛查会积累站点假记录
即使每个物种的站点误报率很小,跨数百个物种筛查仍可能产生多个假记录。本文建议以最终物种清单和生态指标为校准对象,而不只逐片段优化阈值。对于罕见或对结论影响很大的记录,保留可回听证据并独立核验。多重比较校正可以控制特定错误口径,却不能解决未覆盖物种和漏报;两类问题需要分别测量,不能只靠提高阈值一起消除。作者分析与复核建议 / Author analysis
技术补充 D · 跨年设备变化需要桥接观测
监测设备或模型版本升级后,记录量变化可能来自灵敏度而非生态。本文提出在适当重叠时期使用并行或共同参考录音,估计版本差异,再判断哪些趋势可继续比较。若没有桥接信息,应将断点作为测量变化登记,避免直接拼成连续时间序列。模型更新本身有价值,但保留旧版本分析和新的更正关系,才能让长期生态研究区分自然变化与工具进步。作者分析与复核建议 / Author analysis
10. 结论:生态 AI 需要区分生物过程与观测过程
声学分类器为长期生态监测提供了强大工具,但可靠结论来自对存在、发声、采集和识别过程的共同建模。本文的重复检测与表观趋势推导说明,即使模型输出完全可复算,生态解释仍可能因观测条件变化而错误。公开交付应保存设备、站点、季节、阈值和核验流程,让物种记录与生态指标都能被回查。这样的研究才能将“听见更多”转化为对自然变化更准确的理解。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 存在概率 ψ、条件独立检测概率 p 与 K 次调查;无假阳性的简化占据模型。
LaTeX
P(D\ge1)=\psi[1-(1-p)^K](2) 独立无目标片段的累计误报示例,真实相关性需另验。
LaTeX
P(\mathrm{false\ site\ record})=1-(1-f)^K(3) 稀有叫声的先验比例改变候选可靠性;分类分数并非直接等于此概率。
LaTeX
\operatorname{PPV}=\frac{s\pi}{s\pi+f(1-\pi)}(4) 阈值与核验条件下的观测物种丰富度,不自动等于真实物种数。
LaTeX
\widehat R(\tau)=\sum_{j=1}^{S}\mathbf1\{\exists\ \mathrm{reviewed\ detection\ of}\ j\ \mathrm{at}\ \tau\}方法与证据流程
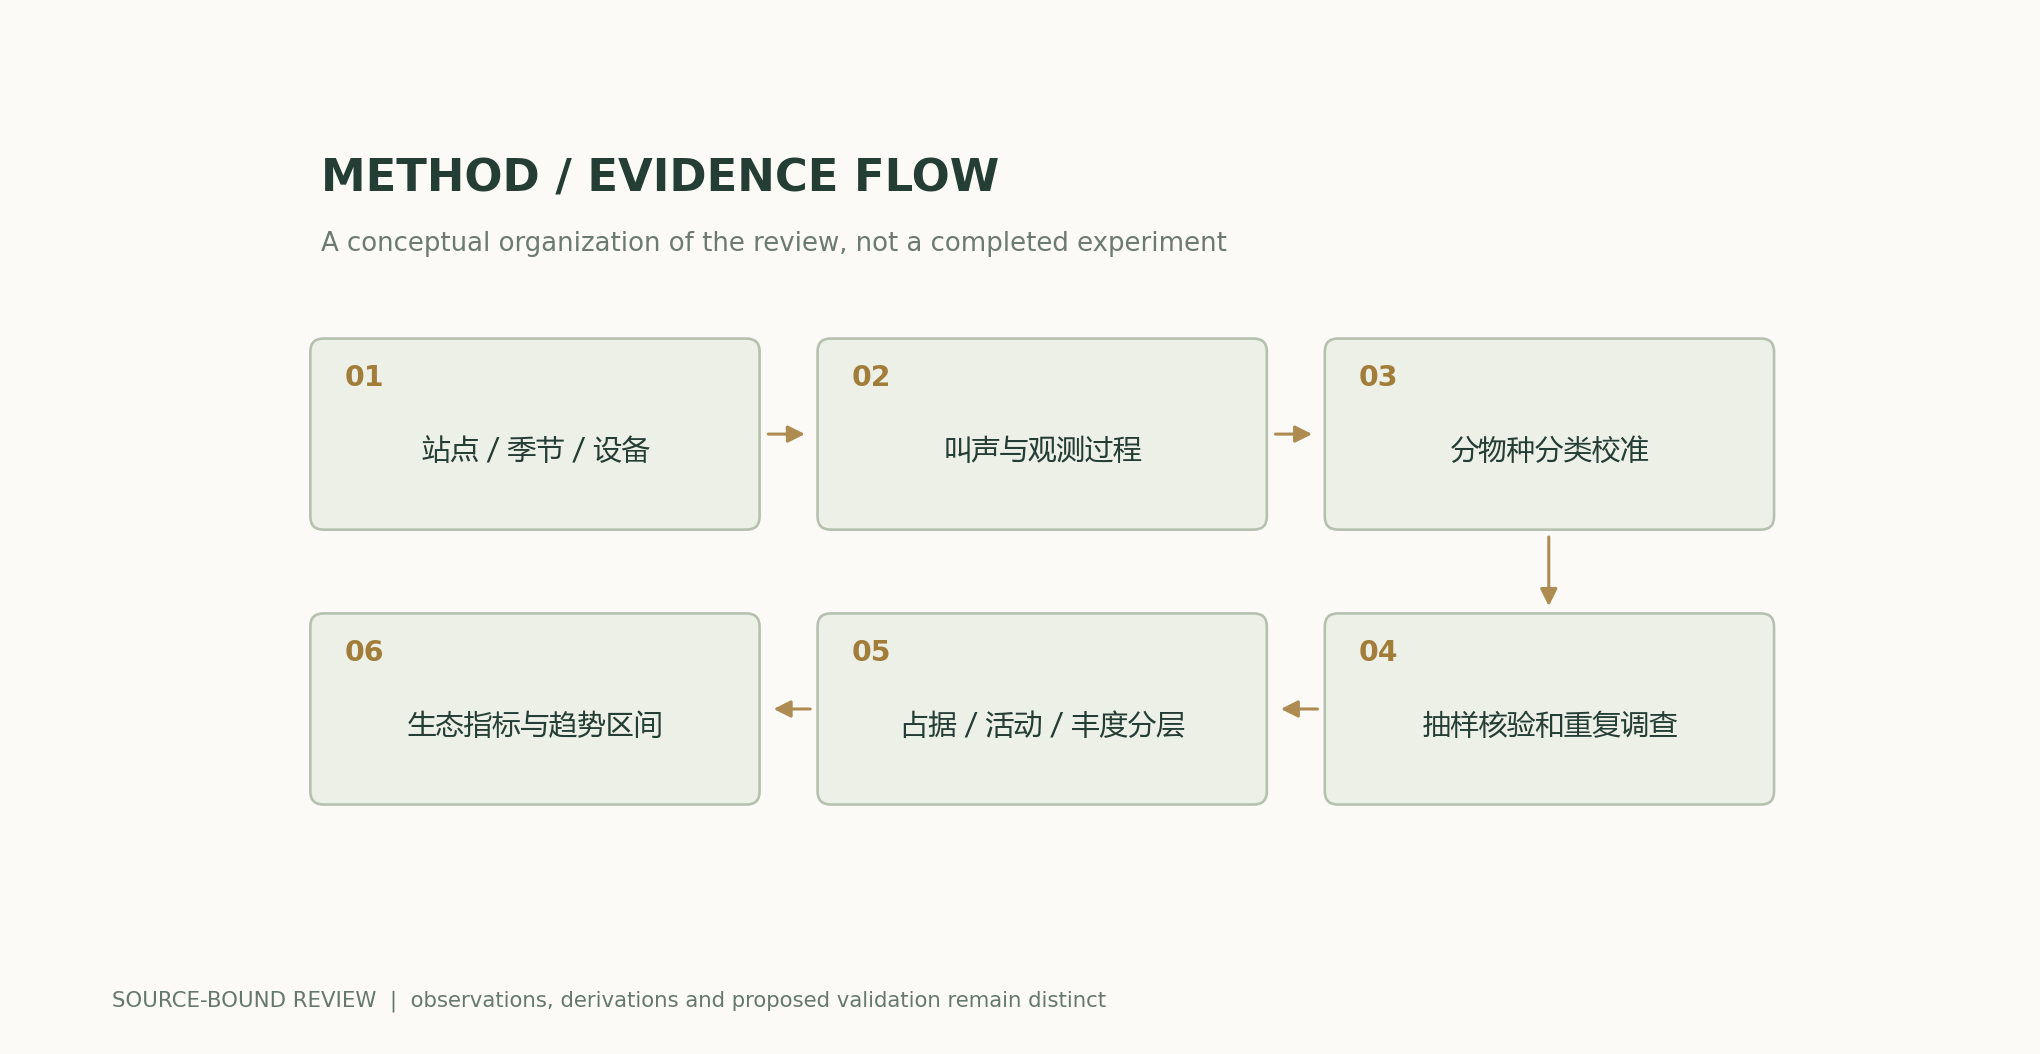
解析图与数值示例
可复算例题
p=0.2时K=3检出0.488,K=10约0.892626;p由0.5降至0.2且K=3,检出由0.875降0.488,变化约-44.23%,不代表存在状态变化。
方法比较
| 对象 | 需要的观测模型 | 不能直接解释为 |
|---|---|---|
| 叫声片段 | 噪声、重叠、分类阈值 | 个体存在概率 |
| 站点记录 | 重复调查和误报 | 真实占据 |
| 活动次数 | 发声、距离和事件去重 | 个体数量 |
| 丰富度 | 物种层错分与覆盖 | 精确真实物种数 |
| 时间趋势 | 季节与设备观测变化 | 种群必然变化 |
| 全球迁移 | 地区、物种和生态环境 | 单地区分数普适 |
复核与实验方案
- 固定模型版本、类别表、设备与录音处理规则。
- 以完整录音、站点和日期隔离重复背景。
- 按物种和生态区校准,另验地域先验的排除影响。
- 记录调查次数、发声条件与无候选时段。
- 分层抽样核验高低分和无候选片段,估计漏报与误报。
- 将活动、占据、丰度及生态指标分开,不合并终点。
- 在站点和季节层传播不确定性,保留未知记录。
- 公开可追溯核验及阈值差异;解析曲线不登记为实际种群变化。
适用范围与局限
- 所有检测与趋势曲线均为假定概率计算。
- 没有处理真实录音或产生新的生态估计。
- 独立重复检测在野外可能不成立。
- 分类器置信度不能直接当调查检出概率。
- 原始和后续模型的类别覆盖及指标不可混合。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 原始 984 物种模型分别测试单物种录音与声景。 | 两类指标和后续模型版本不能直接混合。 | BirdNET: A deep learning solution for avian diversity monitoringAbstract and independent datasets |
| 独立全球评价显示地区、物种和阈值差异。 | 总体平均不能替代目标生态环境验证。 | A global assessment of BirdNET performance: Differences among continents, biomes, and speciesAbstract; regional and species analysis |
值得检验的研究问题
- 实际监测中,发声概率与分类误差各贡献多少趋势偏差?
- 物种阈值与地域先验如何改变罕见对象发现能力?
- 有限人工预算下,怎样抽样最有效地校准生态指标?
一手来源与主张对应
- BirdNET: A deep learning solution for avian diversity monitoringKahl, Wood, Eibl and Klinck · 2021Original 984-species model; single-species recordings and annotated soundscapes are different evaluation domains.
- A global assessment of BirdNET performance: Differences among continents, biomes, and speciesFunosas, Sebastián-González et al. · 2026-01-06Independent global soundscape benchmark; species, region and threshold dependence; public annotation data linked.
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c