
摘要
高预测精度并不能自动回答“改变某个因素会怎样”。本文区分观察条件分布与干预分布,在显式结构方程中推导混杂如何改变关联,并讨论后门调整、表示识别与分布变化的条件。配图来自可穷举的二元混杂模型,变量和概率完全公开,不是实际人群或政策效果研究。[1] Towards Causal Representation Learning[2] Invariant Risk Minimization[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
English abstract
Causal inference requires identification assumptions in addition to predictive accuracy. We distinguish observational conditioning from intervention and work through an explicit binary-confounder model. The calculated association and causal effect differ despite a fixed structural equation. No real treatment effect or policy recommendation is estimated; the example demonstrates assumptions and non-identification risks.
1. 预测问题与干预问题使用不同分布
观察P(Y|X=x)描述已发生数据中X取某值的群体;干预P(Y|do(X=x))描述外部设置X后系统的结果。二者可能因共同原因而不同。因果图和结构方程把假设写出来,但图本身不是从高分预测器中自动获得的真理。需要说明变量含义、时间顺序、遗漏因素和可接受干预,尤其不能把统计控制任意变量当作总能消除偏差。[1] Towards Causal Representation Learning
2. 一个二元混杂模型可精确揭示差异
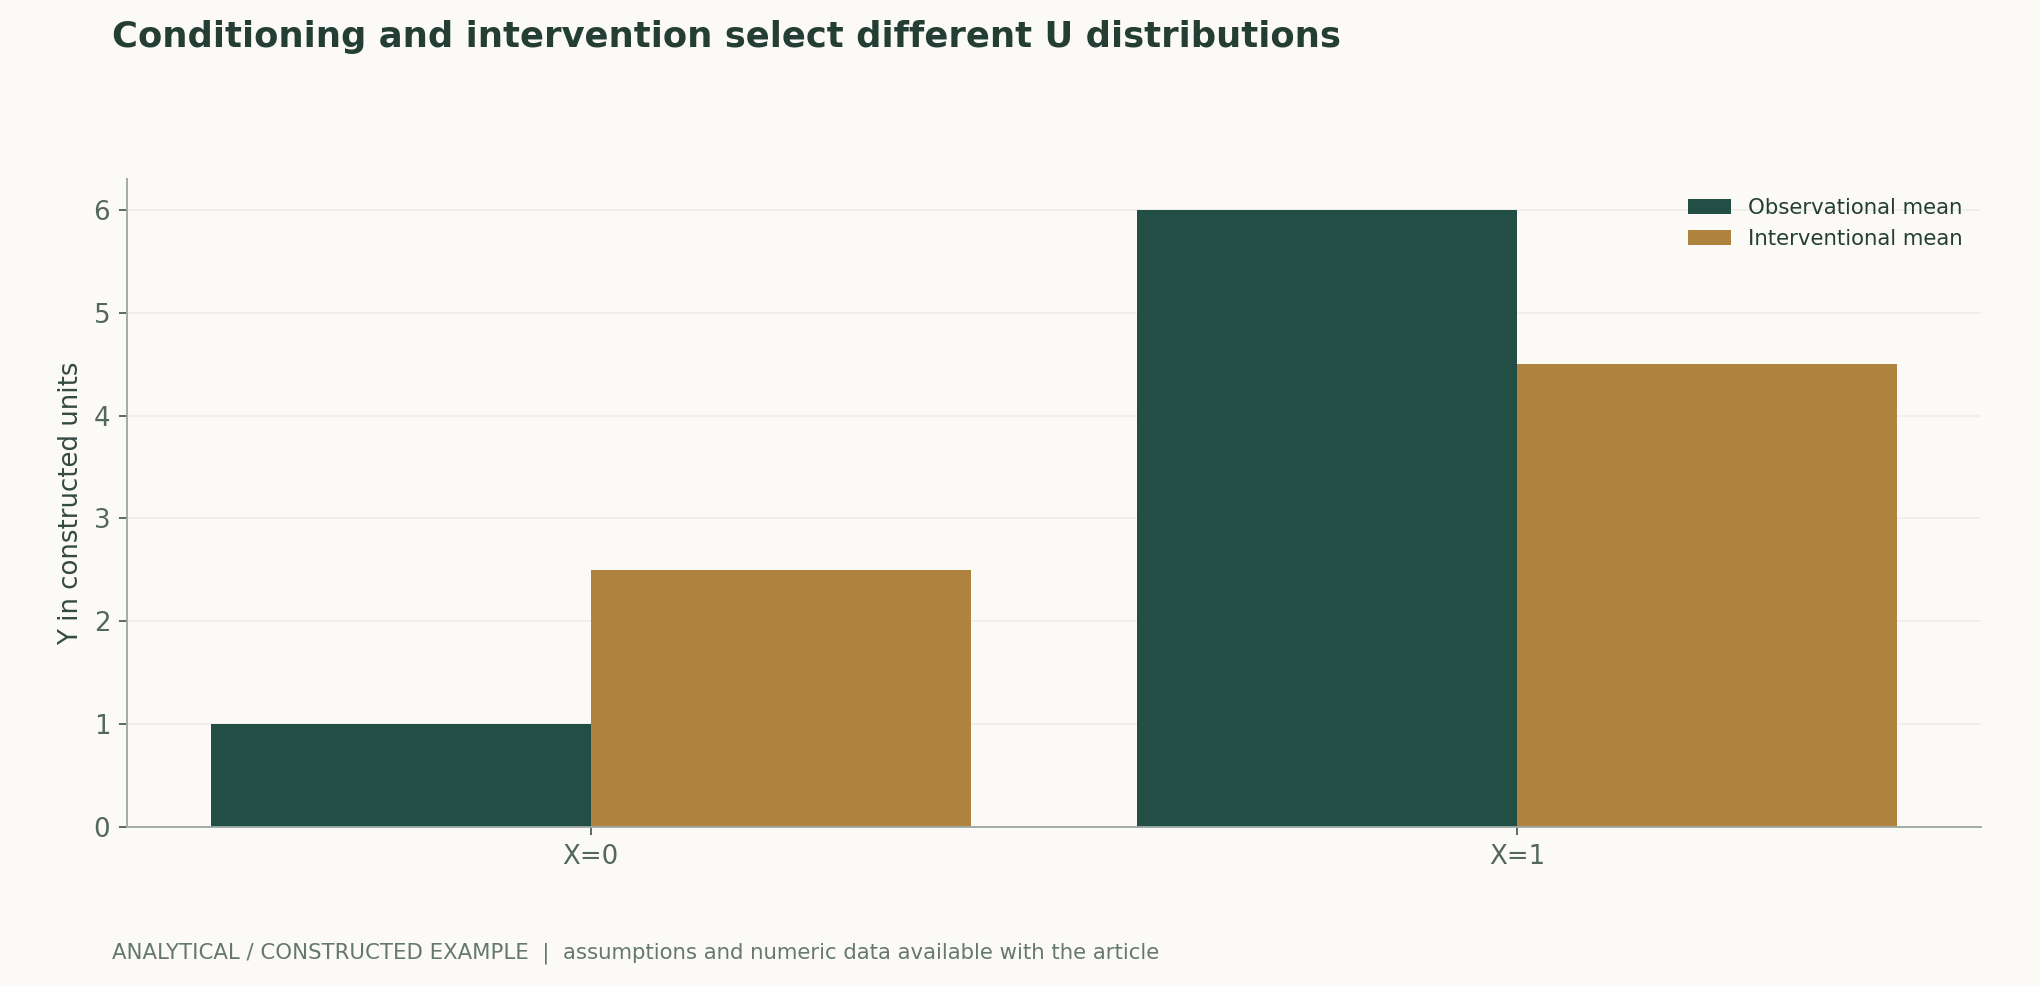
令U等概率取0或1,P(X=1|U=1)=0.8、P(X=1|U=0)=0.2,结果Y=2X+5U。观察X=1者中U=1的比例为0.8,而X=0者中为0.2,因此观察均值差为2+5×0.6=5。干预X时保持U分布不变,均值差只有2。这里没有抽样误差,差异来自生成机制;现实数据则还需要识别这些条件是否可信。[1] Towards Causal Representation Learning
3. 后门调整依赖可检验与不可检验条件
若U满足适当的调整条件,干预均值可由按总体P(U)加权的条件均值计算。还需要一致性、相关层内的正值支持以及足够的测量质量。若某类人从未接受某种处理,模型外推不等于数据支持。控制碰撞点或处理后的中介还可能引入新偏差或改变目标效应。报告应先定义估计对象,再说明图与调整集,不能按相关性强弱机械选择变量。[1] Towards Causal Representation Learning
4. 表示学习的识别有额外结构要求
将高维观察压缩为潜变量,可能有助于因果建模,但仅靠重建良好或独立性正则通常不足以唯一确定因果因素。非线性ICA与因果表示研究讨论了辅助变量、结构限制等识别条件。一个可解释命名的潜维度,不自动成为可干预的真实因素。应明确哪些变量可观测、哪些不可识别,避免把表示旋转后的名称当作因果发现。[2] Invariant Risk Minimization[1] Towards Causal Representation Learning
5. 分布不变性是一种假设而非万能答案
不同环境中的稳定预测关系可能提供线索,但环境数量、变化机制和隐藏混杂会影响结论。分布变化研究显示,简单的数据增强、预训练和模型选择也会影响跨域表现。因而跨环境准确率高不能独自证明学到了因果结构;应设计能区分竞争解释的干预或反事实检验,并报告哪些变化仍超出训练支持。[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] Towards Causal Representation Learning
6. 可信结论需要敏感性与外部证据
现实研究应记录目标总体、处理、结果、时间窗口、缺失机制和调整依据,使用负对照、敏感性分析或合法随机化证据检验假设。无法识别时可以报告边界或关联,不应强行给出单一因果数值。本文模型只是教学反例:它证明相关与干预可以不同,不证明某个真实应用存在相同比例偏差,也不构成医疗或政策建议。[1] Towards Causal Representation Learning[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
Equations and derivations
(1) 仅在U满足识别与支持等条件时成立;不是对任意控制变量都可用的恒等式。
LaTeX
\mathbb E[Y\mid do(X=x)]=\sum_u\mathbb E[Y\mid X=x,U=u]P(U=u)(2) 完全构造的结构模型;X由U影响,X被干预时U分布保持不变。
LaTeX
Y=2X+5U,\quad P(U=1)=1/2(3) 由公开概率表精确计算,没有使用真实人群数据或估计真实处理效应。
LaTeX
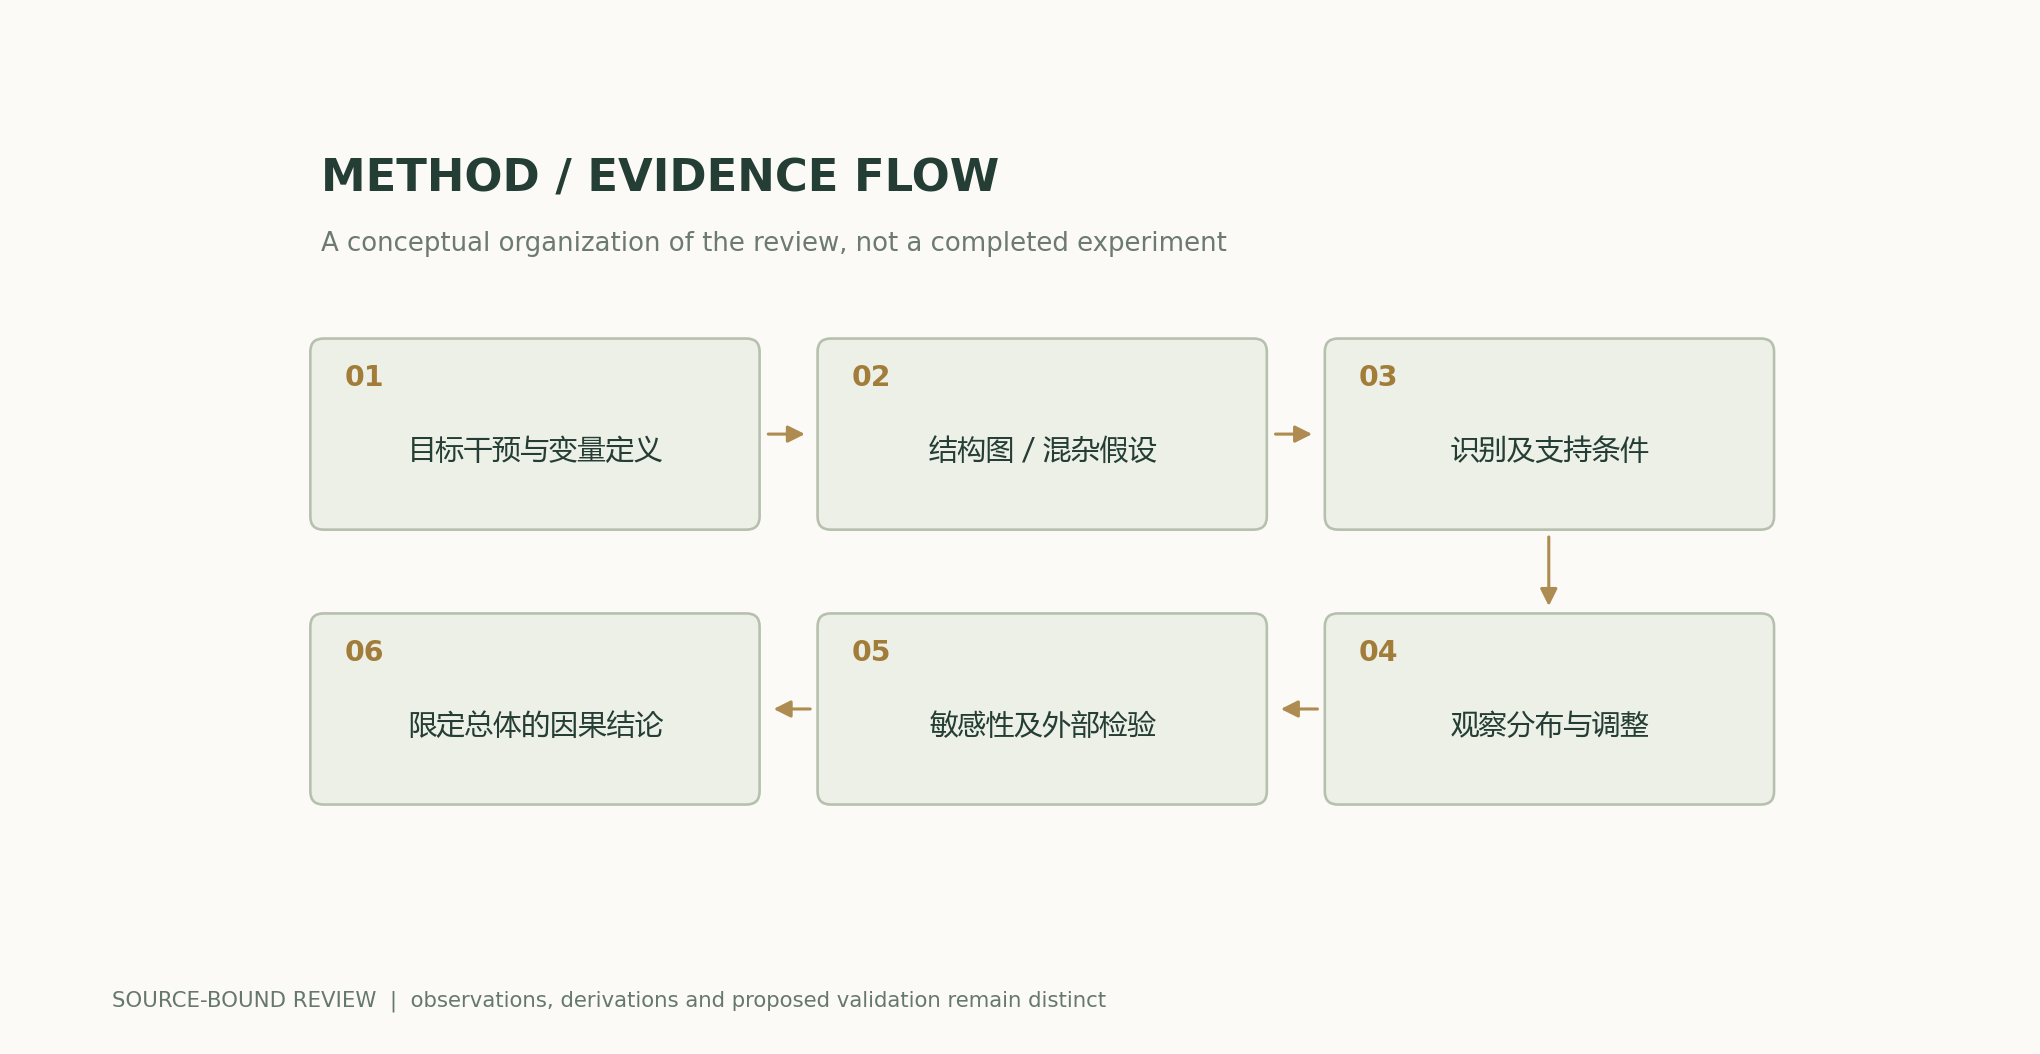
\Delta_{\mathrm{obs}}=5,\qquad\Delta_{\mathrm{do}}=2Method and evidence flow
Analytical figures
Worked calculation
观察均值为1与6,差5;干预均值为2.5与4.5,差2。后门加权使用总体U分布恢复干预均值,但现实是否可调整仍需因果假设。
Method comparison
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 观察预测 | 报告P(Y|X)与数据来源 | 预测准确不识别干预效果 |
| 后门调整 | 给出图、调整集与支持条件 | 错误控制可增加偏差 |
| 潜在表示 | 列出识别假设和等价解 | 可解释命名不等于因果变量 |
| 跨域稳定 | 设计环境与竞争解释对照 | 稳定准确率不单独证明因果 |
Verification protocol
- 定义目标总体、处理、结果、时间及要估计的效应。
- 画出因果假设和变量时间顺序,登记隐藏混杂风险。
- 检查调整集、一致性、正值支持、测量误差和缺失机制。
- 用可穷举模拟先核对估计器,再在合法数据上分析。
- 执行敏感性、负对照或外部干预检验,保留竞争解释。
- 不可识别时明确报告关联或边界,不把预测结果改写成因果结论。
Scope and limitations
- 模型与概率完全构造。
- 没有估计任何真实干预效果。
- 识别假设通常不能只由数据证明。
- 跨域预测不自动证明因果结构。
Primary sources and claim mapping
- Towards Causal Representation LearningBernhard Schölkopf, Francesco Locatello, Stefan Bauer, Nan Rosemary Ke, Nal Kalchbrenner, Anirudh Goyal, Yoshua Bengio · 2021-02-22Abstract and sections on interventions, independent mechanisms and causal representations
- Invariant Risk Minimization, , , · 2019-07-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citations and exports
BibTeXRISCSL JSONTXTArticle JSON
Author, versions and sources
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Cover and figure provenance · Data, sources and assumptions · Publication and version record
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1