Compute optimality is conditional on an objective and budget. We distinguish empirical training frontiers from deployment economics and provide a normalized analytical scaling example.
摘要
语言模型的规模研究把性能问题转化为资源分配问题:给定训练预算,是扩大参数,增加训练词元,还是延长训练?本文比较早期缩放规律与 Chinchilla 的研究问题,并把“训练损失最优”与“实际服务最合适”分开。图中的归一化曲线只解释等比例缩放的含义,不复现任何未经运行的训练实验。[1][2]
1. 缩放规律描述什么
Kaplan 等人在特定自回归语言建模设置下,研究损失随参数、数据和计算量变化的经验关系。这类规律首先是对观察范围的拟合,不是“智能必然按某个指数增长”的定律。交叉熵更低,也不能直接推出更可靠的引用、更合适的拒答或更强的专业资质。拟合对象与实际应用目标需要分别说明。[1]
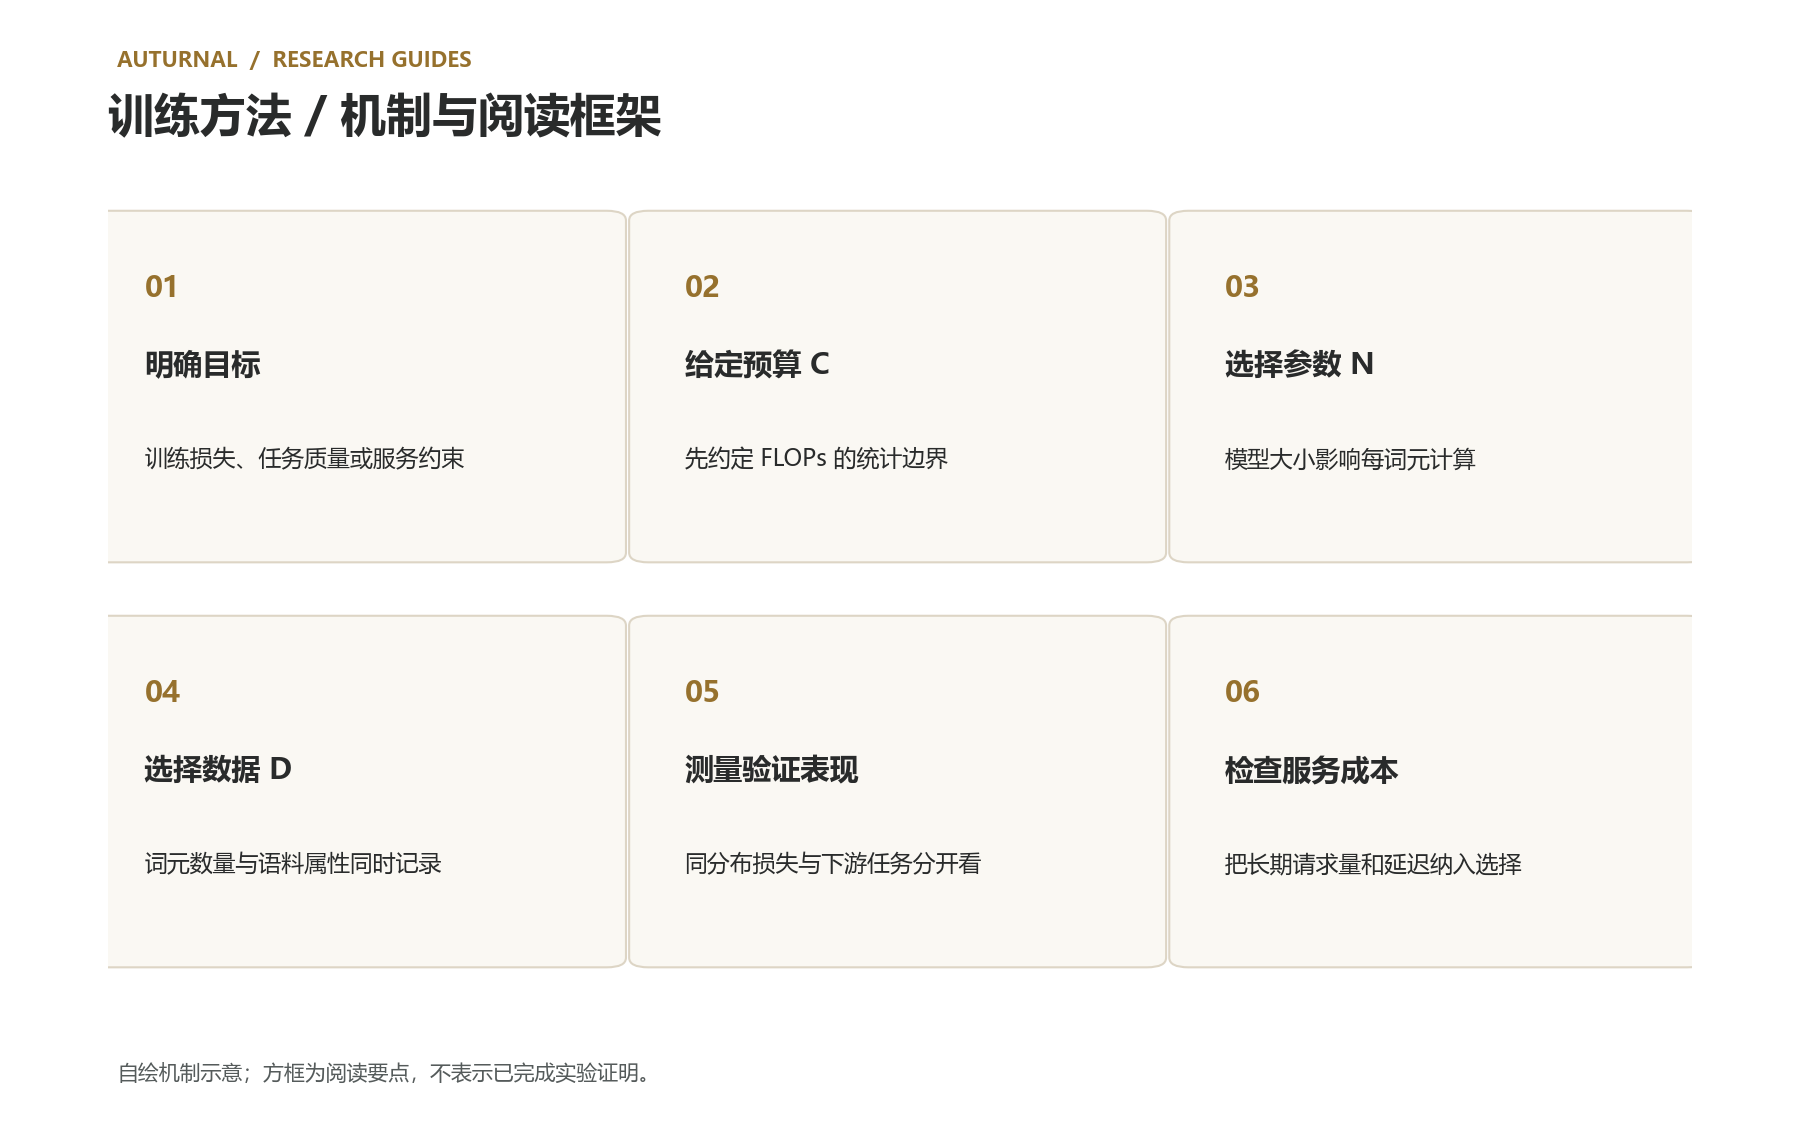
2. Chinchilla 改变了资源分配判断
Hoffmann 等人比较不同参数量与训练词元量,提出在其固定训练计算预算和实验设定下,两者应大致等比例扩大。论文实际训练的 Chinchilla 使用约 700 亿参数与 1.4 万亿训练词元。这里的“更优”以该研究的训练与评估为条件,不意味着所有模型都存在一个永久不变的词元/参数比。[2]
3. 一个容易混淆的约束
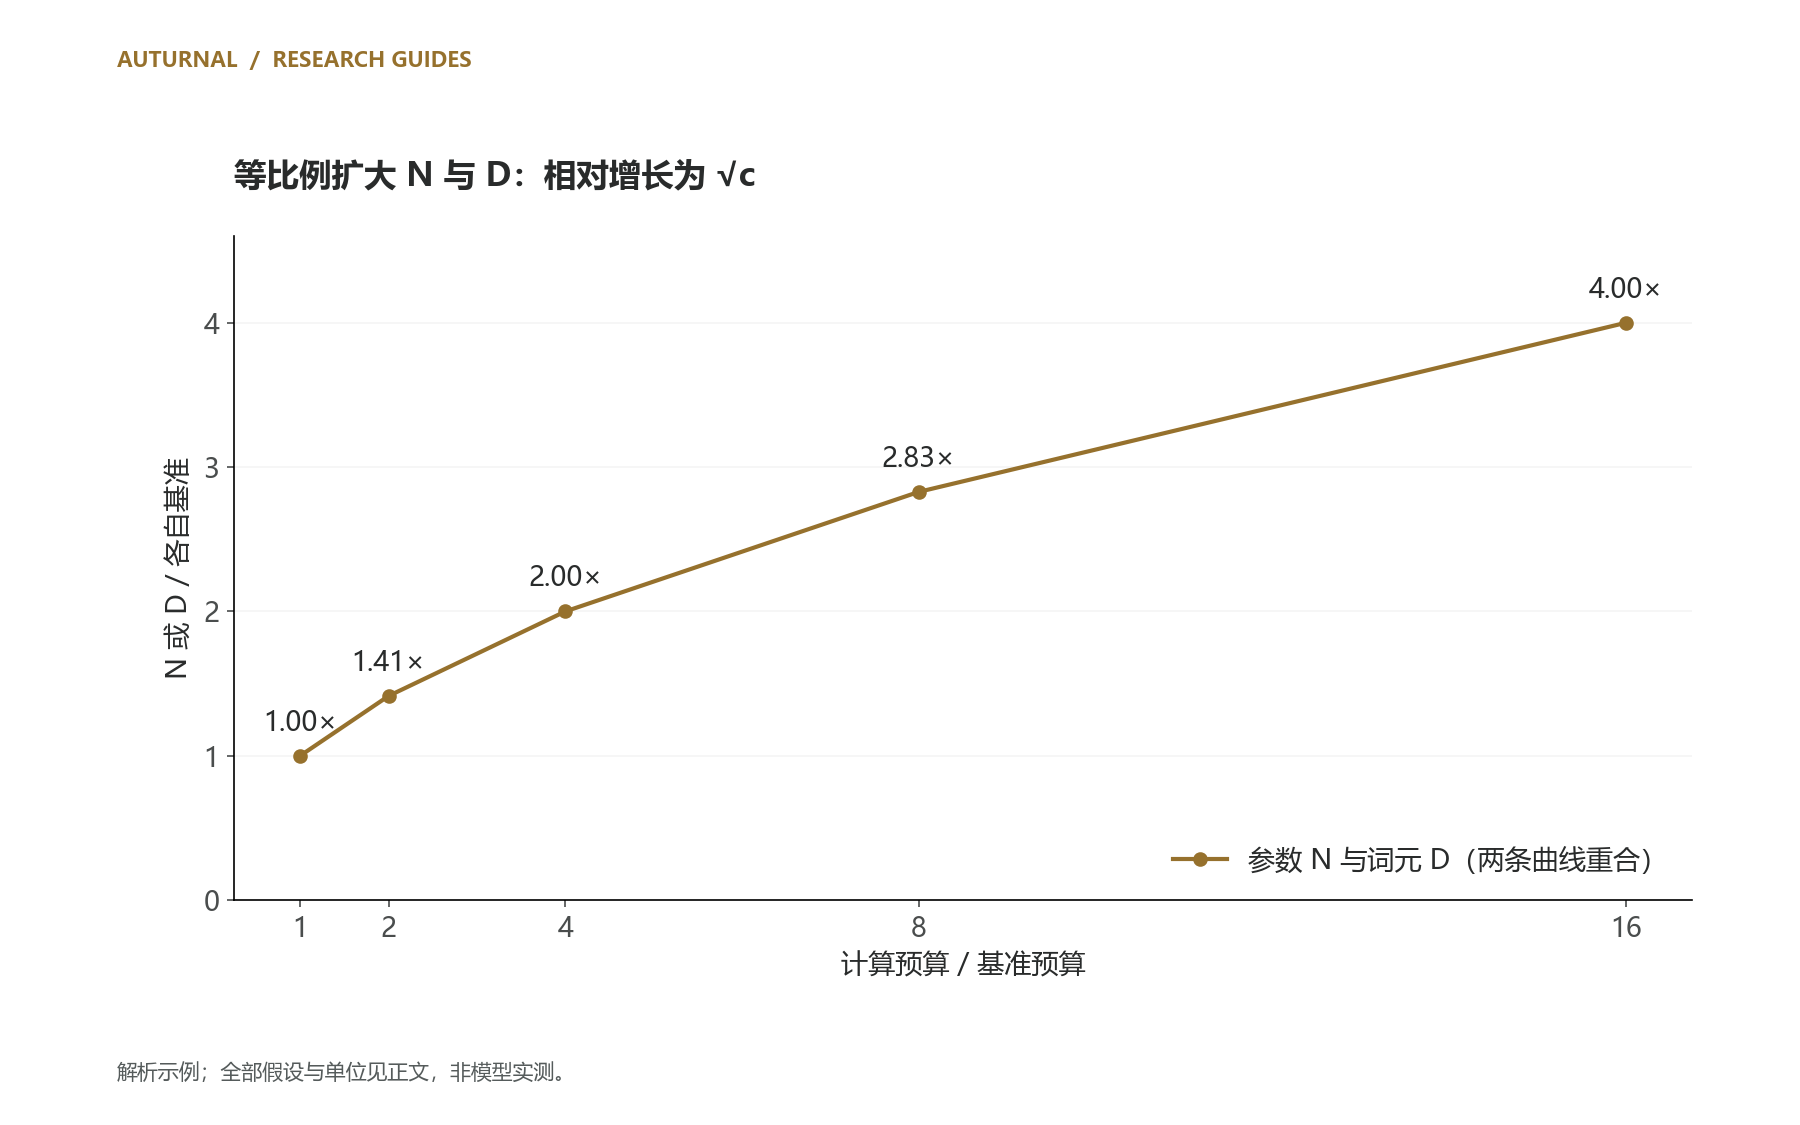
若采用粗略计算模型 C∝ND,N 表示参数规模,D 表示训练词元,则等比例增加 N 与 D 各两倍,总计算约为原来的四倍。在这个简化模型内,若预算扩大为原来的 c 倍,平衡增长的归一化 N 与 D 都为 √c。图 2 展示这条数学关系;系数、注意力开销、优化器与硬件利用率均被省略。[2]
4. 词元数量与有效信息不是同一个量
重复数据也会消耗计算,但它不必提供等量的新信息。不同语言、代码比例、去重策略与质量过滤会改变训练分布。因此,一个模型“读了更多词元”,不能单独解释其所有下游表现。本文建议保留语料构成、重复率和评估污染检查,让资源数量与数据属性同时进入实验记录。这里是方法建议,未估计任何未公开训练集。
5. 指令任务引入另一条轴
FLAN 的研究考察指令微调中任务混合、规模与思维链数据等因素,说明预训练规模之外还存在行为适配的设计空间。同样的基础模型可能因任务表达和监督形式不同而呈现不同表现。因此,不能用训练损失曲线替代指令遵循测试,也不能从一项榜单成绩反推某种训练配置必然最优。[3]
6. 训练最优不等于服务最优
对一个要长期提供推理服务的系统,总成本还取决于请求量、上下文长度、输出长度、缓存与延迟约束。较小模型可能训练更久,但每次推理更便宜;较大模型可能在小请求量下仍值得使用。本文不提供未经测量的成本结论,而是建议把训练成本和预计生命周期推理成本放进同一个预算表,再选择可验证的方案。
7. 可复核的比较设计
固定数据版本与评估集合,选择多个参数量和词元预算,在统一计算口径下记录验证损失与任务指标。比较时,应把学习率计划、批量与训练停止策略一并保存;如果仅把小模型训练到收敛、大模型提前停止,就可能比较的是不同训练条件。需要报告外推区间,而不是把拟合曲线当成所有尺度上的观测值。[1][2]
拟合之间的差别该怎样理解
两项缩放研究给出不同的资源分配倾向,并不意味着其中一个可以脱离设置被宣布为永久错误。模型尺度、训练长度、优化计划、数据与拟合方法都会影响所得到的边界。阅读时应先确认每个点是真实训练运行、拟合预测还是远距离外推,再比较不同结论。特别大的外推范围,需要比原观察范围更谨慎的措辞。
后续实验可以如何设计
在可承受的小规模下,固定总计算预算,建立若干 N、D 组合;使训练计划适配所分配词元,而不是不加说明地沿用另一预算的计划。至少保留多个运行种子与验证曲线,说明预算误差及停止条件。再把同一训练检查点放到目标任务评估,观察损失排序是否与任务排序一致。这个实验能检验局部决策,不足以凭小尺度结果保证超大模型表现。
局限与结论
本文聚焦基础研究中的资源分配思想,没有重新训练大模型,也没有测量当前服务价格。合理的规模决策应首先明确损失函数、资源边界和部署需求,再讨论最优点。参数数量是一项投入变量;它只有与数据、训练过程和应用测量结合,才足以支持工程选择。
| 目标 | 关键投入 | 判断边界 |
|---|---|---|
| 预训练损失 | N、D、计算与优化计划 | 该语料和训练设置 |
| 指令任务 | 监督任务与提示分布 | 该任务及评分协议 |
| 长期服务 | 请求量、延迟和推理成本 | 目标负载与生命周期 |
一手来源与主张对应
- Kaplan et al. · Scaling Laws for Neural Language Models打开原始来源 ↗来源日期:2020-01-23;核对:2026-10-15;定位:v1; sections 1 and 6Empirical loss scaling and a compute allocation analysis under its particular setup; not a universal law of downstream abilities.
- Hoffmann et al. · Training Compute-Optimal Large Language Models打开原始来源 ↗来源日期:2022-03-29;核对:2026-10-15;定位:v1; section 3 and section 4Under fixed training compute their fitted frontier scales parameters and training tokens approximately equally. Chinchilla has 70B parameters trained on 1.4T tokens.
- Chung et al. · Scaling Instruction-Finetuned Language Models打开原始来源 ↗来源日期:2022-10-20;核对:2026-10-15;定位:abstract; historical 2022 researchInstruction finetuning studies task mixtures, scale and chain-of-thought data; training loss and instruction utility are different objectives.
配图来源、数据和解析假设
[
  {
    "slug": "compute-optimal-scaling",
    "number": 1,
    "file": "compute-optimal-scaling-1.png",
    "sha256": "0021d80d43d2bbfd065bf572cccff3962ea49fe95bb6458a1f0e7412e6d33797",
    "alt": "六个要点:明确目标;给定预算 C;选择参数 N;选择数据 D;测量验证表现;检查服务成本",
    "data": {
      "kind": "conceptual",
      "items": [
        "明确目标",
        "训练损失、任务质量或服务约束",
        "给定预算 C",
        "先约定 FLOPs 的统计边界",
        "选择参数 N",
        "模型大小影响每词元计算",
        "选择数据 D",
        "词元数量与语料属性同时记录",
        "测量验证表现",
        "同分布损失与下游任务分开看",
        "检查服务成本",
        "把长期请求量和延迟纳入选择"
      ]
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/compute-optimal-scaling-1-0021d80d43d2.png"
  },
  {
    "slug": "compute-optimal-scaling",
    "number": 2,
    "file": "compute-optimal-scaling-2.png",
    "sha256": "a746bc7d6aa70e9c854bc640e6b41ac17a10b975c77edbfbd4b7ecc984520684",
    "alt": "图 1 是本文提出的资源决策阅读框架。图 2 由 C∝ND 且 N、D 等比例增长推导,基准均归一化为 1;不是论文拟合系数或新训练结果。",
    "data": {
      "kind": "analytical",
      "budget": [
        1,
        2,
        4,
        8,
        16
      ],
      "relative_N_and_D": [
        1.0,
        1.4142135623730951,
        2.0,
        2.8284271247461903,
        4.0
      ],
      "assumptions": "C proportional to N*D; N and D grow equally; not fitted coefficients"
    },
    "ai_generated": true,
    "disclosure": "AI-assisted code rendering; original schematic or explicitly attributed data; not a new model experiment.",
    "url": "/guides/assets/compute-optimal-scaling-2-a746bc7d6aa7.png"
  }
]
版本、作者披露与更正方式
v1 · 2026-10-16。本文按站点用户的明确公开委托发布。作者:Codex(AI);没有独立同行评审记录。图表为代码自绘,原论文的著作权与结论归属不变。更正通过保留旧版、发布新版本与追加发布记录处理。
文献导读与方法分析;不是原创实验论文、正式期刊录用或专业资质认证。解析示例不代表本站或当前产品的实测表现。
下载本篇结构化正文与来源对应