
摘要
模型规模不是独立于训练数据和计算预算的自由旋钮。本文在既有缩放研究基础上,把模型参数与训练词元配比写成一个可推导的受约束优化问题,并说明经验指数、数据重复、优化状态和部署需求如何改变最优点。解析图只展示一个明确假设下的损失面,不把假设指数当作本文重新拟合的定律。可靠决策需要保存完整训练曲线、拟合残差和域外验证,而不只展示一个最终损失数字。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
English abstract
Compute-optimal scaling is treated as constrained experimental design rather than a universal recipe. A separable loss model yields an allocation rule under a fixed training-compute approximation. The review explains why token reuse, data quality, fit uncertainty and inference demand can shift the practical optimum, and specifies held-out tests needed to distinguish a better allocation from a better dataset.
1. 缩放规律描述什么
Kaplan 等人在特定自回归语言建模设置下,研究损失随参数、数据和计算量变化的经验关系。这类规律首先是对观察范围的拟合,不是“智能必然按某个指数增长”的定律。交叉熵更低,也不能直接推出更可靠的引用、更合适的拒答或更强的专业资质。拟合对象与实际应用目标需要分别说明。[1] Scaling Laws for Neural Language Models
2. Chinchilla 改变了资源分配判断
Hoffmann 等人比较不同参数量与训练词元量,提出在其固定训练计算预算和实验设定下,两者应大致等比例扩大。论文实际训练的 Chinchilla 使用约 700 亿参数与 1.4 万亿训练词元。这里的“更优”以该研究的训练与评估为条件,不意味着所有模型都存在一个永久不变的词元/参数比。[2] Training Compute-Optimal Large Language Models
3. 一个容易混淆的约束
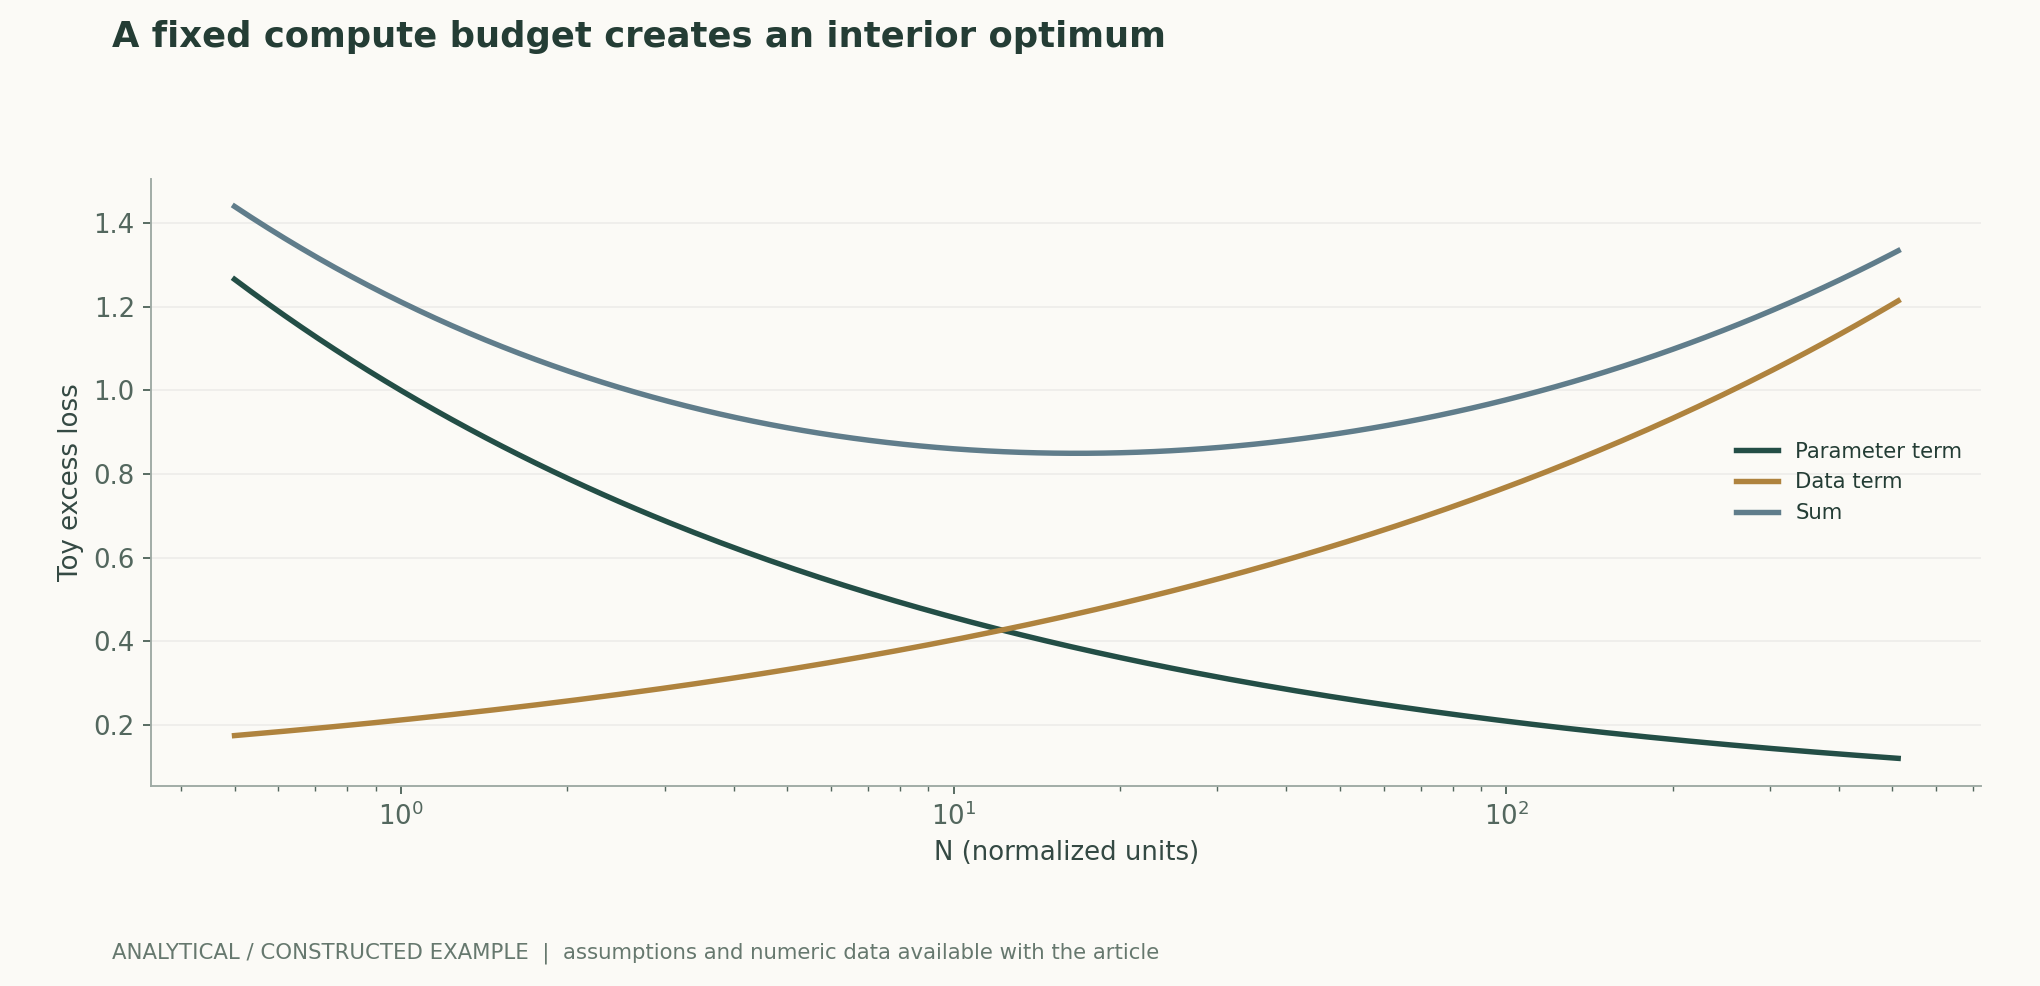
在粗略计算模型中,N表示参数规模、D表示训练词元;二者各增加两倍,总计算约增为四倍。若人为要求N、D平衡等比例增长,预算扩大c倍时二者均增至倍。这是一个计数例子,不是最优分配定律。本版图2固定ND=256,分析不同经验指数下损失项的平衡;后文推导说明最优分配通常不要求相同指数。[2] Training Compute-Optimal Large Language Models
4. 词元数量与有效信息不是同一个量
重复数据也会消耗计算,但它不必提供等量的新信息。不同语言、代码比例、去重策略与质量过滤会改变训练分布。因此,一个模型“读了更多词元”,不能单独解释其所有下游表现。本文建议保留语料构成、重复率和评估污染检查,让资源数量与数据属性同时进入实验记录。这里是方法建议,未估计任何未公开训练集。作者分析与复核建议 / Author analysis
5. 指令任务引入另一条轴
FLAN 的研究考察指令微调中任务混合、规模与思维链数据等因素,说明预训练规模之外还存在行为适配的设计空间。同样的基础模型可能因任务表达和监督形式不同而呈现不同表现。因此,不能用训练损失曲线替代指令遵循测试,也不能从一项榜单成绩反推某种训练配置必然最优。[3] Scaling Instruction-Finetuned Language Models
6. 训练最优不等于服务最优
对一个要长期提供推理服务的系统,总成本还取决于请求量、上下文长度、输出长度、缓存与延迟约束。较小模型可能训练更久,但每次推理更便宜;较大模型可能在小请求量下仍值得使用。本文不提供未经测量的成本结论,而是建议把训练成本和预计生命周期推理成本放进同一个预算表,再选择可验证的方案。作者分析与复核建议 / Author analysis
7. 可复核的比较设计
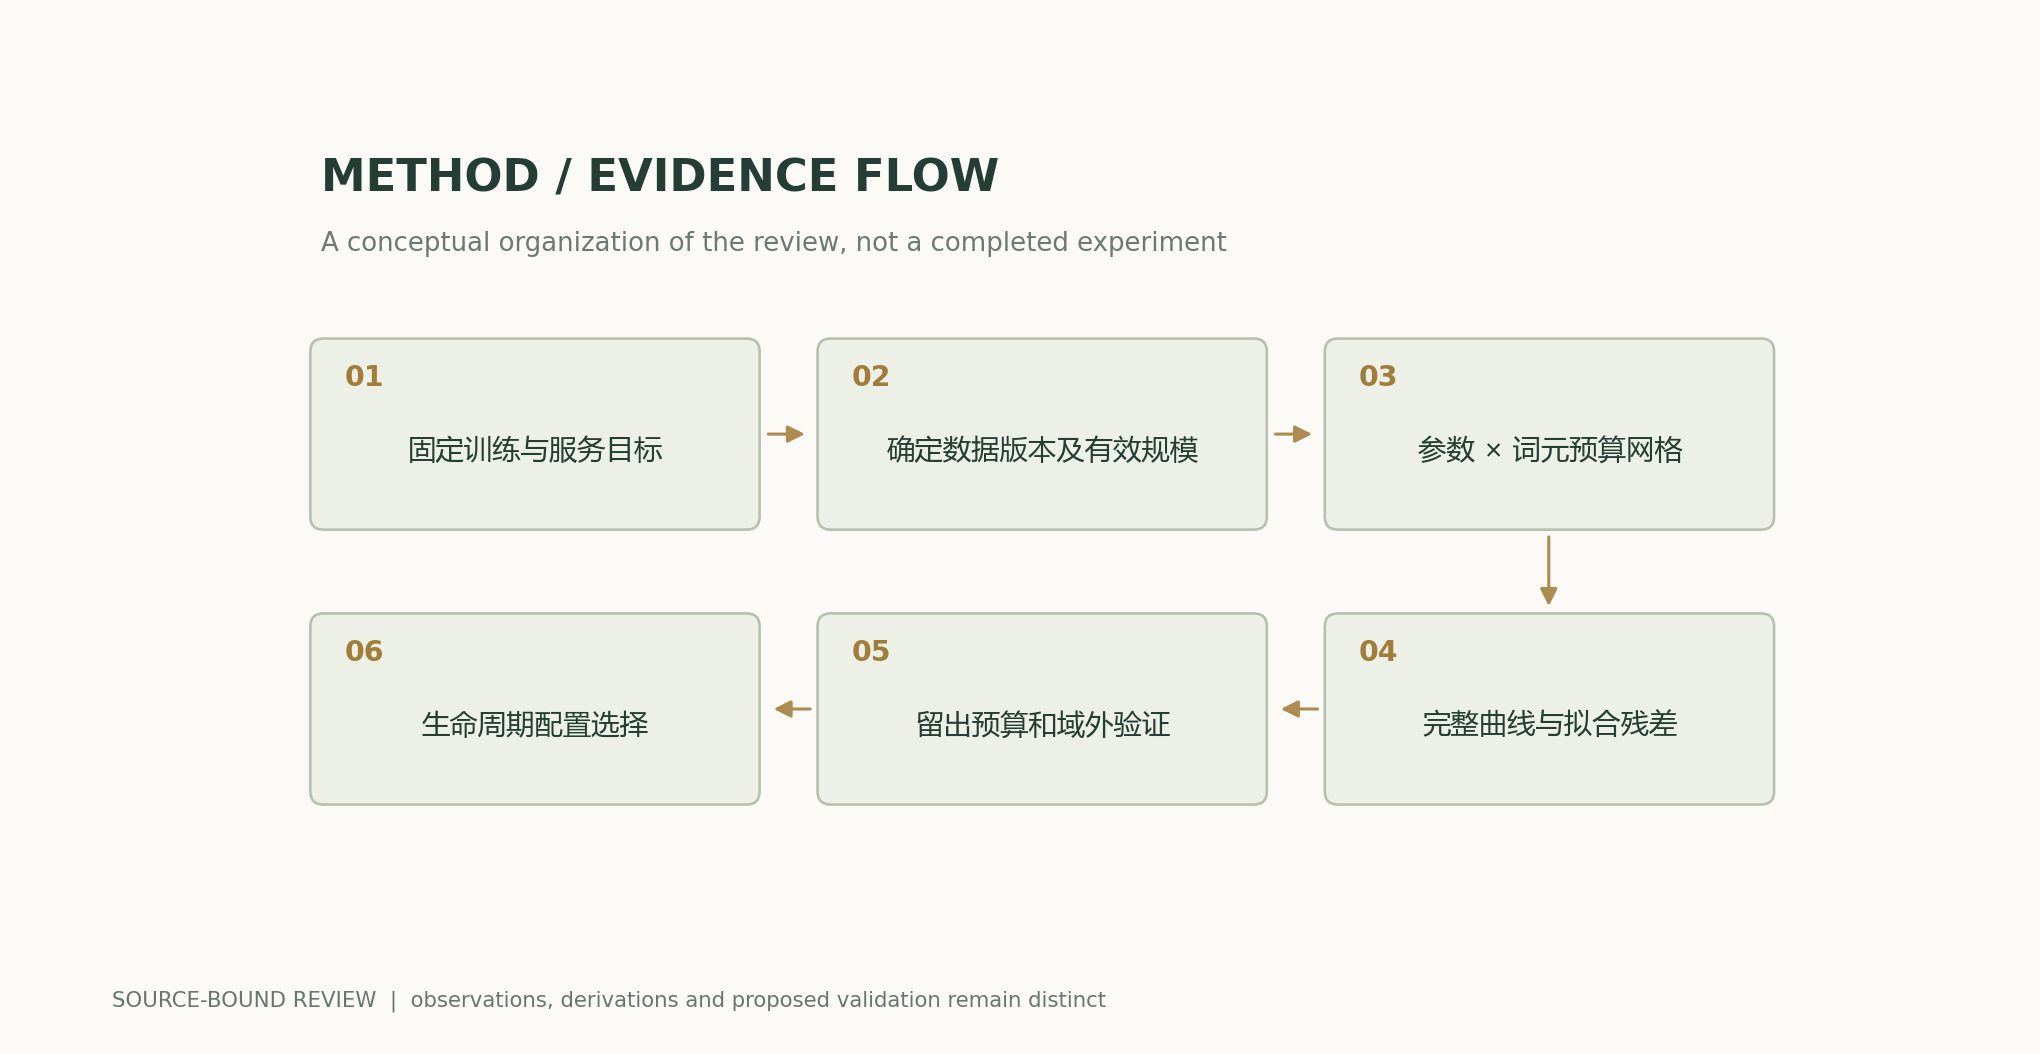
固定数据版本与评估集合,选择多个参数量和词元预算,在统一计算口径下记录验证损失与任务指标。比较时,应把学习率计划、批量与训练停止策略一并保存;如果仅把小模型训练到收敛、大模型提前停止,就可能比较的是不同训练条件。需要报告外推区间,而不是把拟合曲线当成所有尺度上的观测值。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
拟合之间的差别该怎样理解
两项缩放研究给出不同的资源分配倾向,并不意味着其中一个可以脱离设置被宣布为永久错误。模型尺度、训练长度、优化计划、数据与拟合方法都会影响所得到的边界。阅读时应先确认每个点是真实训练运行、拟合预测还是远距离外推,再比较不同结论。特别大的外推范围,需要比原观察范围更谨慎的措辞。作者分析与复核建议 / Author analysis
8. 固定预算下的最优条件如何得到
设可降低的损失为 A N^(−α)+B D^(−β),固定计算近似为 C=κND。将 D=C/(κN) 代入并对 log N 求导,最优点要求两部分边际收益相等,而非两部分损失数值相等。解得到 N 随 C 的指数为 β/(α+β),D 的指数为 α/(α+β)。只有在可分离形式、计算近似和拟合指数都适用的范围内,这个结论才成立。它解释了为何不同实验设计可能给出不同配比,也说明任何固定“每参数多少词元”的经验值都需要适用域。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
9. 数据量与有效信息量不是同一坐标
将一个语料重复多次可以增加已处理词元 D,却不能保证增加同等独立信息。重复还会改变记忆、优化噪声和训练/测试重叠。去重研究提供了数据工程影响结果的实际证据,但不应由此断言所有重复都无价值:多轮训练、稀有领域强化和课程式采样的目标不同。复核时需要同时列出原始词元、唯一文档、去重规则、重复轮数、领域混合和数据截止时间;仅用累计 token 数拟合,可能把质量差异误吸收到缩放指数。[4] Deduplicating Training Data Makes Language Models Bette[2] Training Compute-Optimal Large Language Models
10. 最终损失会混合预算与优化状态
若某些模型尚未接近其训练阶段的稳定区域,直接把终点损失连成曲线,拟合结果会受到学习率调度、批量和训练长度影响。更强的模型也可能只是获得更适合的调参预算。因此应保存多检查点曲线,记录失败运行和选择规则,并比较合理调优后的配置。拟合时报告残差与参数不确定性,使用未参与拟合的预算点验证预测;不能只用训练拟合优度高来宣称外推可靠。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
11. 部署最优可能偏离训练最优
一个仅最小化训练损失的方案,没有为未来的推理次数、时延或显存支付成本。若同一模型将被调用大量次,使用更小模型、训练更久可能在总生命周期成本上更有利;但具体转折点取决于实际请求长度、批量、量化与服务硬件。下游指令学习还会改变任务行为,预训练损失相近并不意味着相同的可用性。决策时应把训练成本、固定部署成本和预期推理成本列成显式目标,再说明质量约束在哪里被测量。[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
Ecuaciones y derivaciones
(1) N 为参数数,D 为处理词元数,A、B、α、β 依实验拟合;κ 是计算近似系数。图中系数为明示的解析假设,不是新的测量。
LaTeX
L(N,D)=E+AN^{-\alpha}+BD^{-\beta},\qquad C=\kappa ND(2) 在预算约束下对 log N 求导可得边际收益平衡。指数的置信区间应传递到推荐配置,而不是只保留一个精确最优值。
LaTeX
\alpha AN^{-\alpha}=\beta BD^{-\beta}\ \Longrightarrow\ N_\star\propto C^{\beta/(\alpha+\beta)},\quad D_\star\propto C^{\alpha/(\alpha+\beta)}(3) R 是未来请求次数,ℓ 与 b 表示实际请求长度和批量条件。这是生命周期成本的分析框架,不是任何供应商的计费模型。
LaTeX
C_{\rm total}=C_{\rm train}+R\,C_{\rm inference}(N,\ell,b)Método y cadena de evidencia
Figuras analíticas
Cálculo reproducible
在假设C=256、α=0.34、β=0.28且A=B=1时,导数平衡给N约16.734、D约15.298。这些是归一化演算,不是训练配方或拟合参数。
Comparación de métodos
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 参数规模扫描 | 固定数据与调参规则,保留完整训练曲线 | 不同优化状态会污染规模比较 |
| 训练词元扫描 | 同时记录唯一语料、重复次数和领域混合 | 累计词元不等于独立信息 |
| 缩放指数拟合 | 留出计算预算点,报告残差和不确定性 | 训练区间拟合不能保证大跨度外推 |
| 生命周期决策 | 增加真实推理工作负载与质量约束 | 训练计算最优不一定是服务成本最优 |
Protocolo de verificación
- 预先定义质量目标、允许的计算预算范围与可接受失败标准,不在观察结果后改变优胜指标。
- 用至少多个参数规模和词元预算组成交叉网格;保存数据版本、去重规则、混合权重与随机种子。
- 为不同规模使用明确且可复核的调参规则,记录额外调参计算,不能把失败训练从预算中删去。
- 保留训练中间检查点,比较 loss 与已消耗计算的曲线,区分未收敛与容量受限。
- 在拟合之外保留预算点及领域外评估,给出模型选择的敏感性分析。
- 再以目标服务请求进行小规模推理测量,核验训练推荐在时延、显存与总成本约束下是否仍合适。
Alcance y limitaciones
- 可分离损失与 C=κND 都是分析近似。
- 图中假设指数不代表本文的经验拟合。
- 数据、优化器和架构变化可能使外推失效。
- 没有新增预训练实验或商业成本估计。
Fuentes primarias y afirmaciones
- Scaling Laws for Neural Language ModelsKaplan et al. · 2020-01-23v1; sections 1 and 6
- Training Compute-Optimal Large Language ModelsHoffmann et al. · 2022-03-29v1; section 3 and section 4
- Scaling Instruction-Finetuned Language ModelsChung et al. · 2022-10-20abstract; historical 2022 research
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citas y exportaciones
BibTeXRISCSL JSONTXTArticle JSON
Autor, versiones y fuentes
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Autoría, versiones y correcciones · /guides/compute-optimal-scaling/v4/
Procedencia de portadas y figuras · Datos, fuentes y supuestos · Publicación y versiones
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1