
要旨
コンフォーマル予測は、交換可能性などの条件の下で、周辺被覆保証を持つ予測集合を構成できる。しかし、すべての個人や部分集団が同じ被覆率を達成することを無条件に保証するものではない。本稿では、分割較正の有限標本分位点を導出し、小標本における順位の離散性を説明したうえで、分布シフト、モデル選択、集合の大きさを論じる。図示では、異なる較正標本数に対する順位閾値のみを計算しており、現実の課題について較正を完了したと主張するものではない。[1] A Gentle Introduction to Conformal Prediction and Distr[2] Conformalized Quantile Regression[3] Holistic Evaluation of Language Models
原文の英語要旨の日本語訳
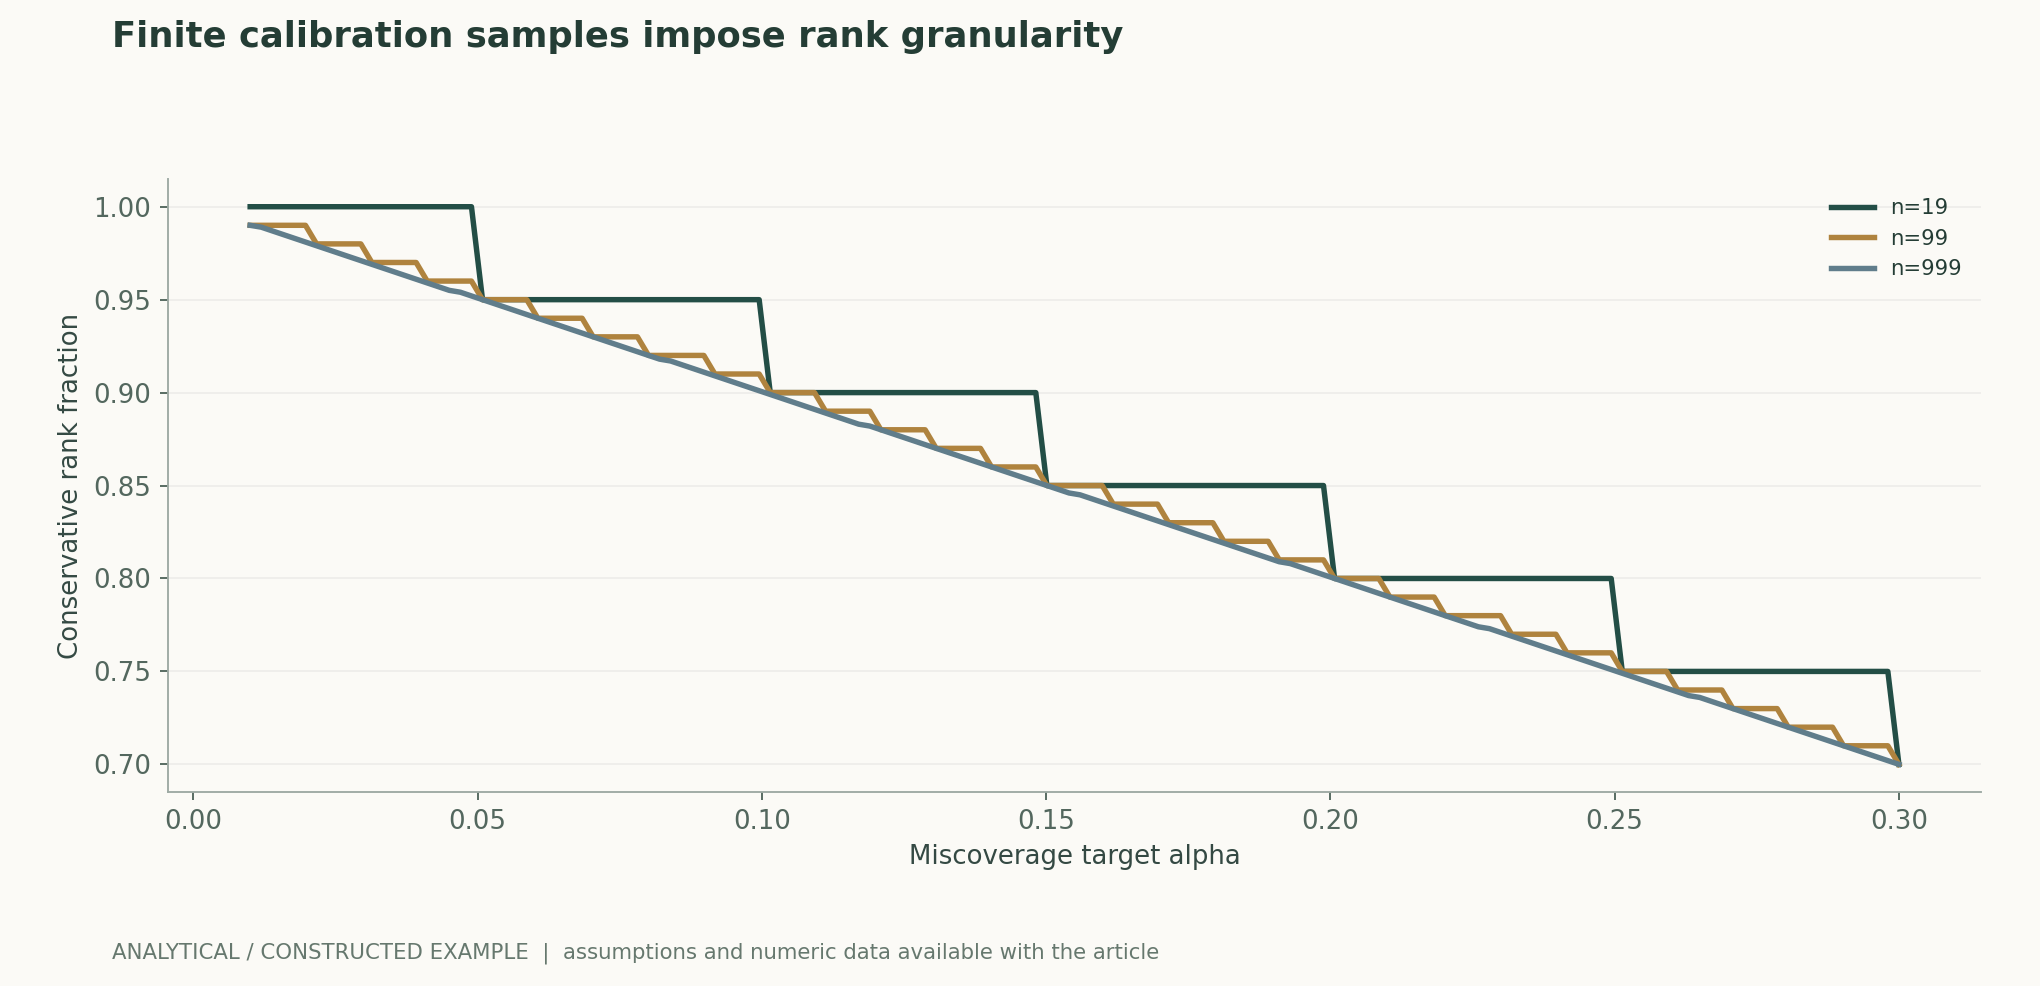
分割コンフォーマル予測は、交換可能性の下で順位を用いてスコアを較正する。本稿では有限標本分位点を導出し、周辺被覆と条件付き被覆の違いを説明する。順位曲線は決定論的な計算であり、データセット上で測定した被覆率ではない。分布シフト、部分集団における保証の不達成、集合の大きさは、名目上の保証とは独立に評価する必要がある。
1. 予測集合が扱うのは被覆であり、点予測の良否ではない
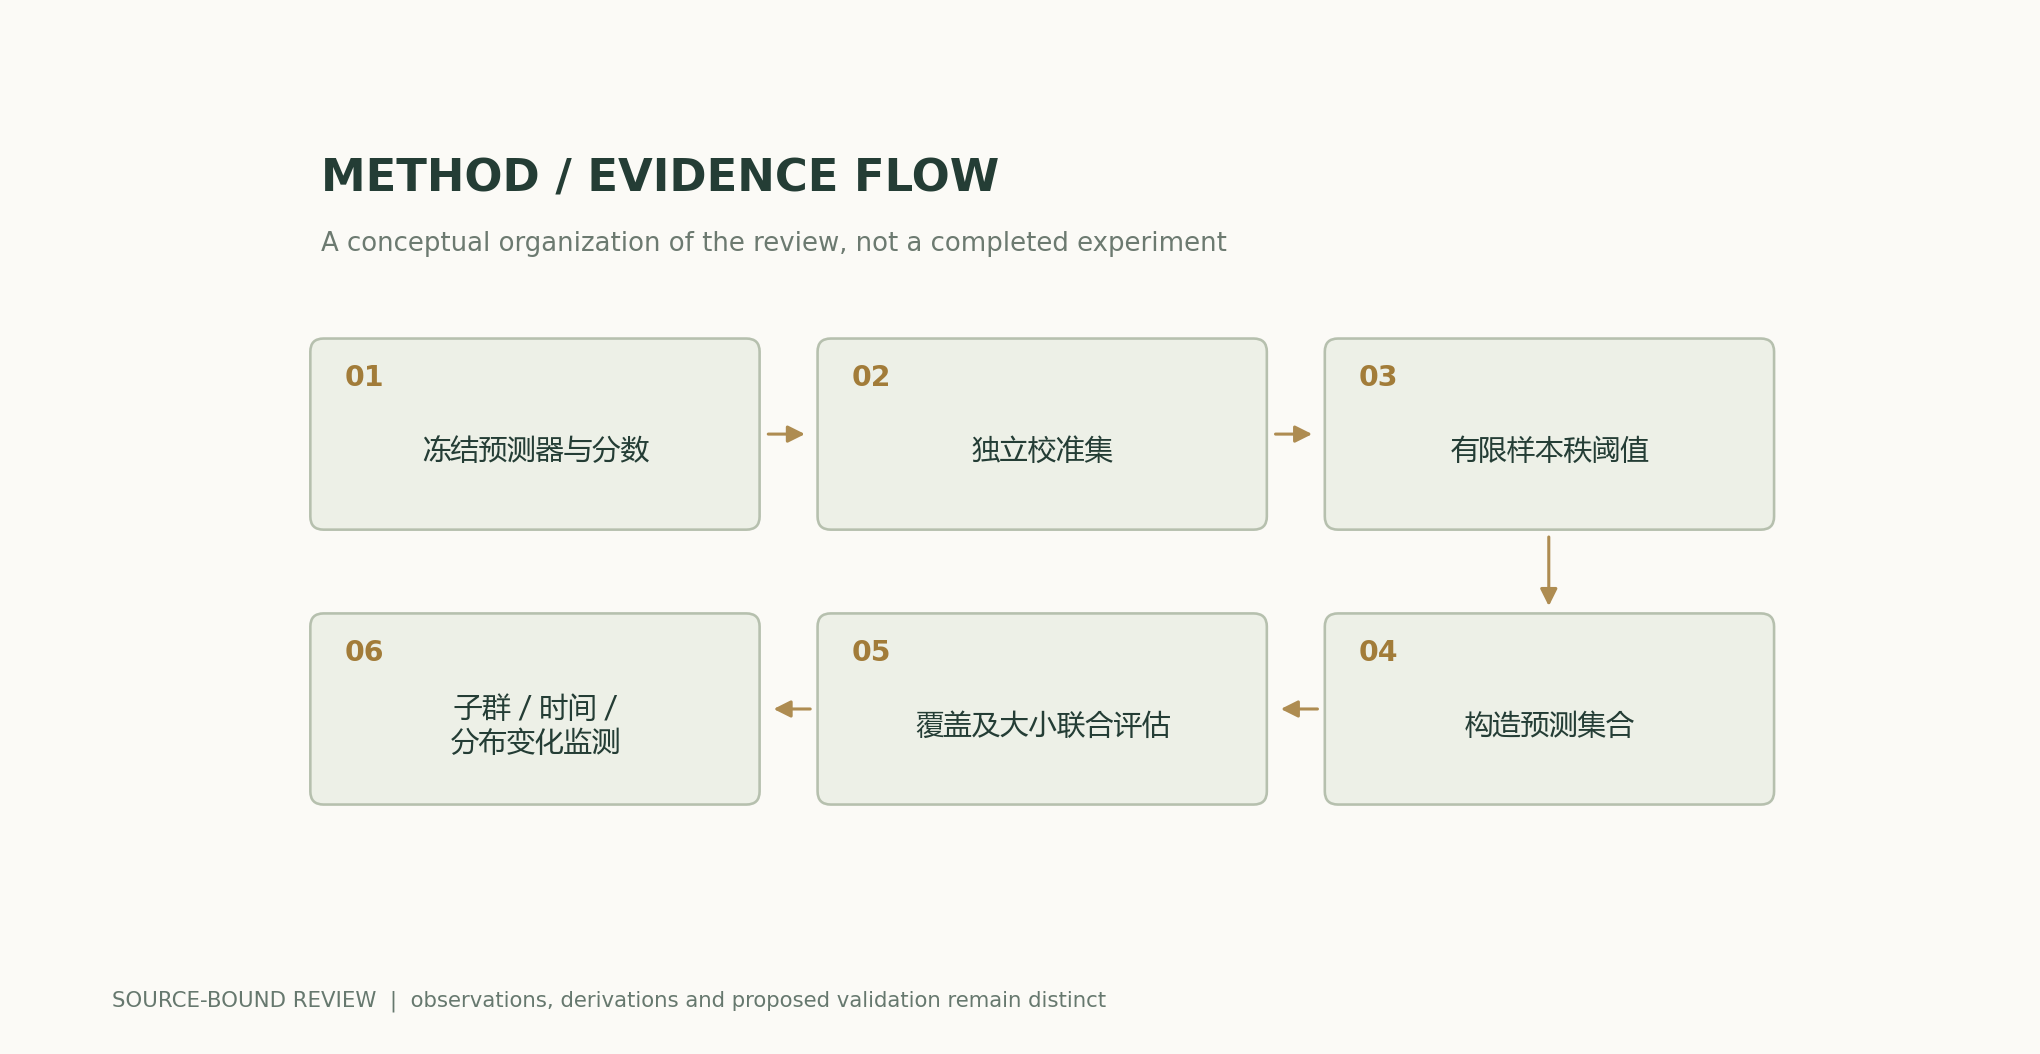
まず予測器を学習して固定し、次に独立した較正データセットで非適合度スコアを計算し、最後に閾値を選択して集合を構成する。回帰では絶対残差、分類ではラベルに依存するスコアを利用でき、スコアの設計が集合の形状と効率を決める。高い被覆率は非常に大きな集合に由来する可能性があるため、集合の大きさや区間幅も併せて報告しなければならない。コンフォーマル法が較正するのは、指定された仮定の下での手順の被覆であり、不正確なモデルを自動的に情報量の多い予測器へ変えるものではない。[1] A Gentle Introduction to Conformal Prediction and Distr
2. 有限標本補正は順位の対称性に由来する
較正スコアと新たな標本のスコアが交換可能であれば、新たな標本の順位には対称性がある。ceil((n+1)(1−α))に対応する較正スコアの順序統計量を用いることで、少なくとも1−αの周辺被覆保証が得られる。必要な順位がnを超える場合、保守的な実装では無限大の閾値または全体集合を用いる必要があり、最後のスコアを黙って選択してはならない。同点スコアの処理とランダム化の規則は厳密性に影響するため、記録すべきである。図中の較正標本数19、99、999は順位の粒度を示しており、被覆率の実測ではない。[1] A Gentle Introduction to Conformal Prediction and Distr
3. 周辺保証は各集団や各個人に対する保証ではない
全体の被覆率が目標を満たしていても、まれな集団、入力空間の特定領域、または高リスクの標本では被覆が不足する可能性がある。集団別較正は、各集団が対応する条件を満たし、十分な標本数を持つ場合に、より細かな保証を提供できる。しかし、小さな集団では分位点が粗くなり、集合が広くなる。完全に分布に依存しない詳細な条件付き被覆には根本的な限界がある。全体の保証を、各予測が「95%の確率で正しい」と言い換えるのではなく、事前に定義した部分集団と最悪集団の性能を報告すべきである。[1] A Gentle Introduction to Conformal Prediction and Distr
4. 分布シフトは較正の根拠を損ないうる
運用時の入力、ラベル生成機構、またはデータ収集方法が変化すると、交換可能性が成立しなくなる可能性がある。重み付き手法やオンライン手法にはそれぞれ追加条件があり、元の分割較正の保証表現をそのまま引き継ぐことはできない。スコア分布、集合の大きさ、ラベル付き標本の被覆率を監視し、遅延と欠測を記録すべきである。モデル更新、閾値の調整、較正データセットの繰り返し選択も手順を変えるため、学習、開発、較正、テストを改めて分離し、較正情報がモデル選択に繰り返し利用されることを避ける必要がある。[1] A Gentle Introduction to Conformal Prediction and Distr[3] Holistic Evaluation of Language Models
5. 確率較正とコンフォーマル被覆は同じ目標ではない
温度スケーリングなどの確率較正は、予測確率と経験頻度の関係を対象とする。一方、コンフォーマル予測はスコアの順位から集合を構成する。確率の質が低いモデルでも、条件が満たされれば保守的な被覆を得られる場合がある。また、確率が良好に較正されたモデルであっても、適切な集合構成規則が必要である。分類の難易度はクラス数や入力によっても変わる。確率の質、集合の被覆率、集合の大きさを別々に示し、単一の指標で信頼性全体を代表させることを避けるべきである。[2] Conformalized Quantile Regression[1] A Gentle Introduction to Conformal Prediction and Distr
6. 工学的な受入評価には較正手順全体の保存が必要である
モデルのハッシュ、スコア関数、標本分割、α、分位点の実装、同点処理を記録する。手順を固定した後、独立したテストデータセットで被覆率とその信頼区間を推定し、集団と時間で層別化するとともに、分布シフトをシミュレーションする。高リスク用途では、予測集合は意思決定情報の一部にすぎず、独立した意思決定規則と責任を明確にする手順が依然として必要である。本稿は順位閾値の導出のみを行っており、特定のモデルがすでに被覆保証を獲得したことの証明にはならない。[1] A Gentle Introduction to Conformal Prediction and Distr[3] Holistic Evaluation of Language Models
主要な数式と導出
(1) sは並べ替えた較正スコアを表す。k=n+1の場合は、無限大の閾値や全体集合を用いるなどの保守的な処理が必要である。
LaTeX
k=\lceil(n+1)(1-\alpha)\rceil,\qquad q=s_{(k)}(2) 絶対残差スコアに対応する回帰区間。他のスコアでは異なる集合が得られる。
LaTeX
C(x)=[\hat f(x)-q,\hat f(x)+q](3) 交換可能性や適切な分割などの条件の下での周辺保証。任意の分布シフト下や各部分集団に対する条件付き保証ではない。
LaTeX
P\{Y_{n+1}\in C(X_{n+1})\}\ge1-\alpha方法とエビデンスの流れ
解析図と数値例
再計算可能な例題
α=0.05の場合、n=19では第19順位、n=99では第95順位を用いる。n=19かつα=0.01の場合、k=20は標本数を超えるため、無限大の閾値や全体集合を用いるなどの保守的な処理が必要である。
方法の比較
| 方法または判断 | 統制変数と測定 | 成立しなくなる条件と解釈 |
|---|---|---|
| 周辺被覆 | 手順を固定し、交換可能性を確認する | 各個人や各集団への保証と同義ではない |
| 集合の効率 | 幅またはラベル数も併せて報告する | 全体集合でも高い被覆率を得られるが、情報量は少ない |
| 有限標本の順位 | n+1補正を用い、範囲外の順位を処理する | 小さな較正データセットは分位点の精度を制限する |
| 分布シフト | スコアと真のラベルの被覆率を監視する | 元の保証を無条件に移すことはできない |
検証と実験の計画
- 学習、開発、較正、テストを分離し、モデルとスコア関数を固定する。
- α、分位点の丸め、同点処理、範囲外の処理を記録し、まず小標本で手計算による照合を行う。
- 独立したテストデータセットで、被覆率の信頼区間と集合の大きさを報告する。
- 事前に定義した部分集団、難易度、時間で層別化し、全体だけでなく最悪集団を確認する。
- 共変量またはラベル生成機構の変化をシミュレーションし、適用されなくなる保証を明確にする。
- モデルや手順の更新後に再較正し、バージョンを保存する。最も有利な較正データセットを繰り返し選ぶことを禁止する。
適用範囲と限界
- 交換可能性は重要な条件である。
- 周辺被覆を個人の確率に言い換えることはできない。
- 順位図はデータセット上の被覆率の実測ではない。
- 分布シフトと繰り返しの調整は保証を損なう可能性がある。
一次資料と主張の対応
- A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification, · 2021-07-15Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Conformalized Quantile Regression, , · 2019-05-08Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿について独立した査読や独自のモデル実験を実施した記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一の場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学的な図解は区別されている。科学図は公開された数式と明示された仮定に基づいて計算され、原論文の結果はすべて帰属先が明記されている。
著者、バージョン、訂正履歴 · /guides/conformal-uncertainty/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770