
摘要
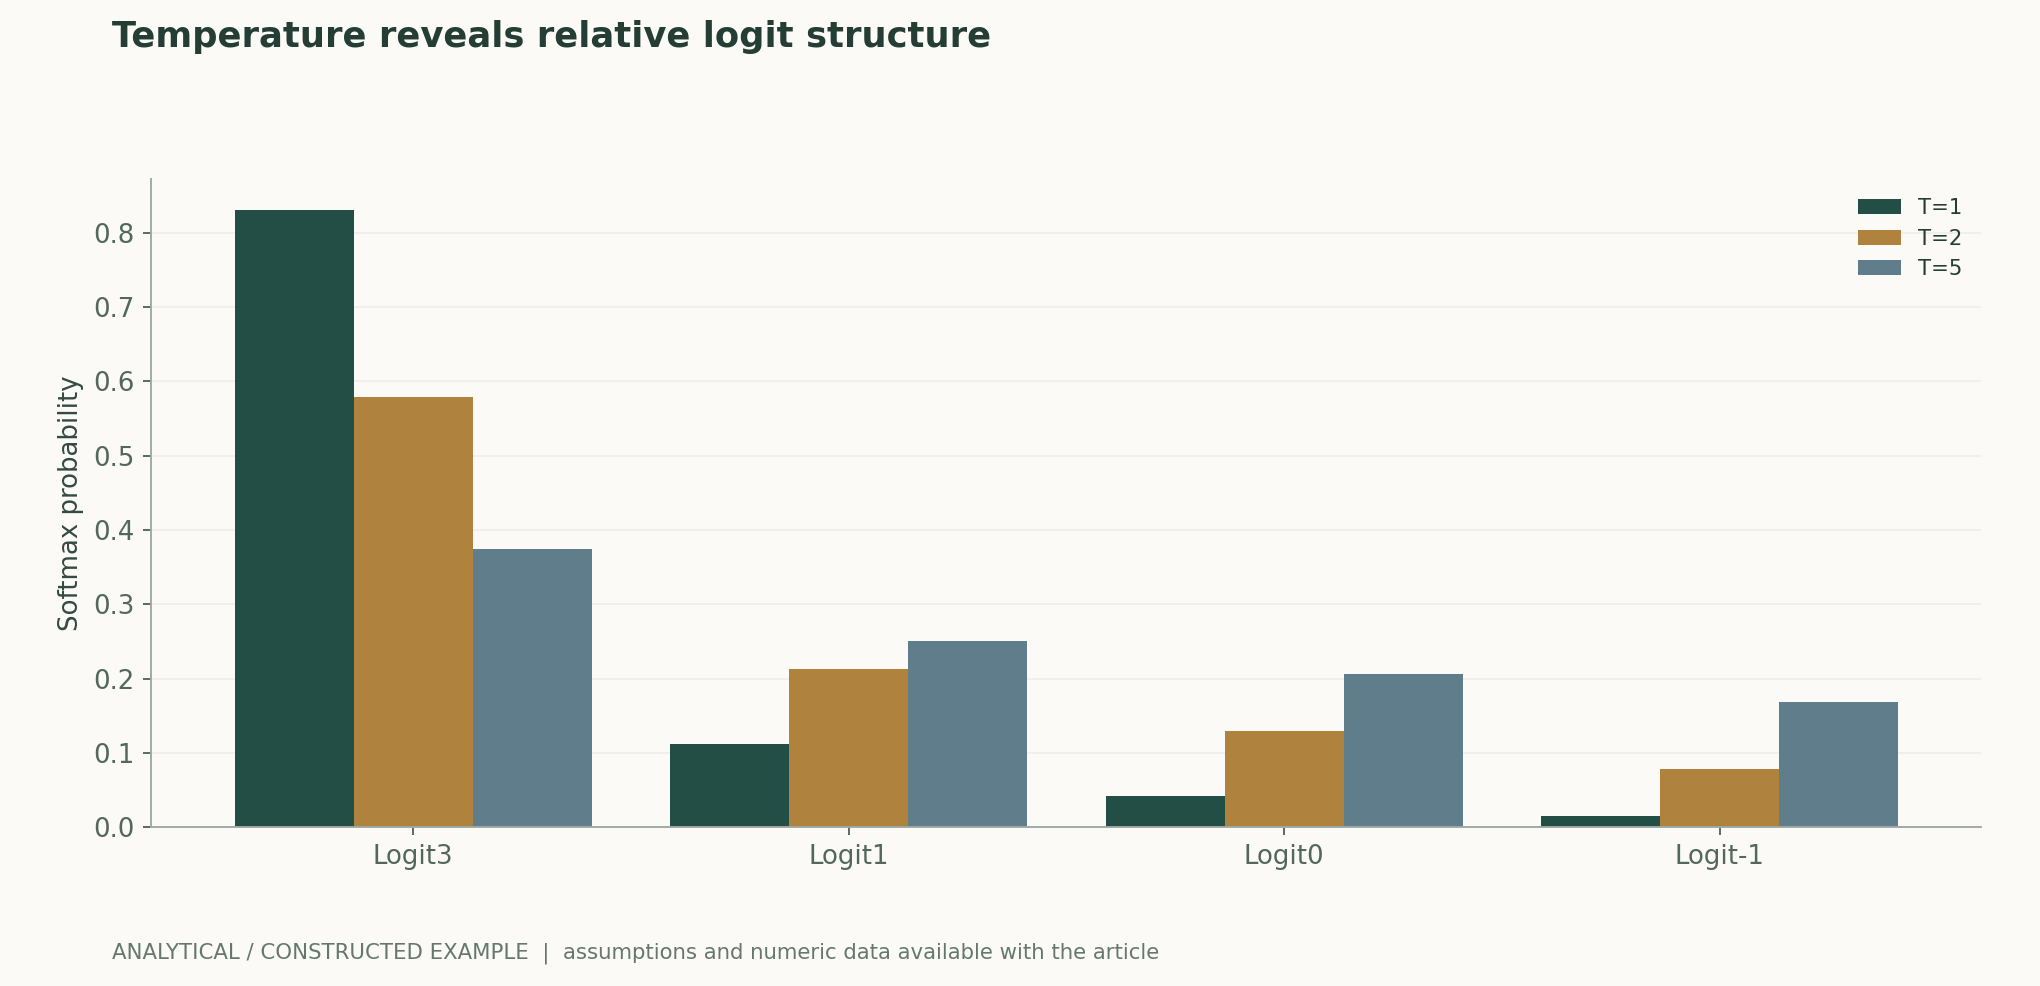
蒸馏通过教师输出或中间表示训练学生,可能传递类别之间的相对关系,也可能传递偏差和错误。本文推导温度对概率和梯度的作用,说明常见T平方缩放的条件,并讨论分类logit蒸馏与序列生成蒸馏的差异。图示使用四个固定logit,不是任何模型实测;复核方案要求独立真值、教师失败分层和相同资源约束。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste[3] LoRA: Low-Rank Adaptation of Large Language Models
English abstract
Knowledge distillation transfers a teacher distribution rather than ground truth itself. We analyze temperature scaling, gradient magnitude and capacity limits, and distinguish logit, sequence and representation supervision. A fixed four-logit example illustrates entropy changes only. Student quality requires independent labels and evaluation of inherited teacher errors, latency and resource use.
1. 软标签携带相对关系也携带偏差
硬标签只给出一个目标类别;教师分布还能表达其他类别间的相对相似性。但这些概率来自教师和其训练语境,未必经过校准,也未必反映真实不确定性。学生可能学到有用结构,也可能复制教师对某些群体或罕见输入的系统错误。因此蒸馏损失降低只能证明学生更接近所用教师信号,不能直接证明更接近独立真值。教师与学生应同时在未参与开发的标注集上评估。[1] Distilling the Knowledge in a Neural Network
2. 温度改变概率形状与梯度尺度
将logit除以T会在较大T时使分布更平缓,暴露次高类别的相对关系。对于温度相同的教师与学生,交叉熵对学生logit的梯度含1/T;高温近似下概率差还可能随1/T缩小,因此常用T平方调整损失量级。这个近似不等于任意T和任意分布下梯度严格相同。权重、硬标签比例和优化器都应记录,不能把改变温度后的损失数值直接横向比较。[1] Distilling the Knowledge in a Neural Network
3. 学生容量限制可逼近的教师行为
即使监督数据充足,学生架构也可能无法同时表示教师的全部行为。层数、隐藏维度、注意力结构和词表都会影响逼近误差;相同参数数不保证相同延迟。DistilBERT展示了一种具体的预训练蒸馏路径,不代表所有任务都能按固定比例压缩而保持能力。需要区分架构缩小、训练目标变化与数据增加的作用,并保存未蒸馏学生基线。[2] DistilBERT, a distilled version of BERT: smaller, faste[1] Distilling the Knowledge in a Neural Network
4. 序列蒸馏会改变训练数据分布
用教师生成文本训练学生,监督的是被采样或筛选过的序列,而非完整逐位置分布。温度、解码、提示和过滤改变了哪些行为进入训练。若只保留教师正确或易答样本,学生可能缺少困难边界和拒答情形;若教师解释错误,也可能被当作目标学习。应记录生成设置和样本选择,不把文本模仿与概率蒸馏混称为同一种监督。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
5. 资源比较需要固定质量约束
较小学生可能降低存储和推理开销,但实际服务速度依赖设备、批量、长度及内核。若学生需要更多采样或外部检索才能达到质量,系统成本未必按参数数下降。LoRA属于参数更新方式,与缩小推理模型是不同目标;冻结大模型并训练少量参数不会自动得到小模型服务。应在同一质量或延迟目标下比较完整系统,而非把训练参数减少当作推理压缩。[3] LoRA: Low-Rank Adaptation of Large Language Models[2] DistilBERT, a distilled version of BERT: smaller, faste
6. 教师的盲点必须成为验收入口
除了总体指标,应单独查看教师正确而学生错误、教师错误而学生跟随、以及学生纠正教师的样本。多教师或硬标签能提供额外约束,但不能自动保证无偏。最终报告要说明教师来源、版本、数据许可、生成成本和独立评估,避免教师评价自己的学生形成循环证据。本文只分析损失与概率形状,没有完成学生训练或宣称保持了某个能力百分比。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
核心公式与推导
(1) 图示logit为3、1、0、−1,温度为1、2、5;只展示概率平滑。
LaTeX
p_i^{(T)}=\frac{\exp(z_i/T)}{\sum_j\exp(z_j/T)}(2) 一种常见混合目标;教师固定,λ、T及硬标签来源都必须公开。
LaTeX
\mathcal L=(1-\lambda)\operatorname{CE}(y,p_s^{(1)})+\lambda T^2\operatorname{KL}(p_t^{(T)}\Vert p_s^{(T)})(3) 给出显式温度因子;T平方缩放的动机还依赖高温下概率差的近似行为。
LaTeX
\frac{\partial\operatorname{CE}(p_t^{(T)},p_s^{(T)})}{\partial z_{s,i}}=\frac{p_{s,i}^{(T)}-p_{t,i}^{(T)}}{T}方法与证据流程
解析图与数值示例
可复算例题
固定logit下,最大类别概率在T=1时约0.831、T=5时约0.375。分布更平缓不等于学生学得更好,需另测真实标签质量。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| logit蒸馏 | 保存温度、分布和硬标签比例 | 接近教师不等于接近真值 |
| 序列蒸馏 | 记录提示、采样和筛选规则 | 生成文本不是完整教师分布 |
| 表示蒸馏 | 明确层映射和损失权重 | 相似表示不保证相同任务行为 |
| 部署压缩 | 测相同质量下的完整服务成本 | 训练参数效率不是模型缩小 |
复核与实验方案
- 冻结教师与学生版本,记录架构、词表和数据来源。
- 划分训练、开发与独立标注测试集,避免教师筛选污染测试。
- 扫描温度及混合权重,记录未蒸馏学生和硬标签基线。
- 按教师成功/失败及任务难度分层,检查错误继承。
- 测模型存储、峰值内存、预填充及解码延迟,固定硬件和批量。
- 公开生成及训练成本,保留独立评估而不由教师单独给结论。
适用范围与局限
- 没有训练学生模型。
- 概率平滑图不代表质量提高。
- 温度梯度近似有适用条件。
- 教师监督可能继承系统偏差。
一手来源与主张对应
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter, , , · 2019-10-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation