Parameter-efficient adaptation, quantized storage, and IO-aware attention target different cost terms. We provide exact illustrative parameter counts and distinguish raw weight memory from total runtime memory.
摘要
“省显存”可能来自减少可训练参数、降低冻结权重精度,也可能来自减少中间状态搬运。本文以 LoRA、QLoRA 与 FlashAttention 为线索,建立分层成本视角。所有计算示例都给出矩阵维度或位宽假设;它们解释机制,不宣称任何设备上可达到未经测试的训练规模与速度。[1][2][3]
1. LoRA 改变的是更新的表示
LoRA 冻结原权重 W,通过低秩矩阵乘积 BA 表示可训练增量。对于 的矩阵,完整更新有 个可训练数,而低秩部分有 个。这个计数不包含其他层、偏置或框架额外状态,也不能据此证明任意低秩都能达到完整微调的质量。[1]
2. 一个可独立复算的例子
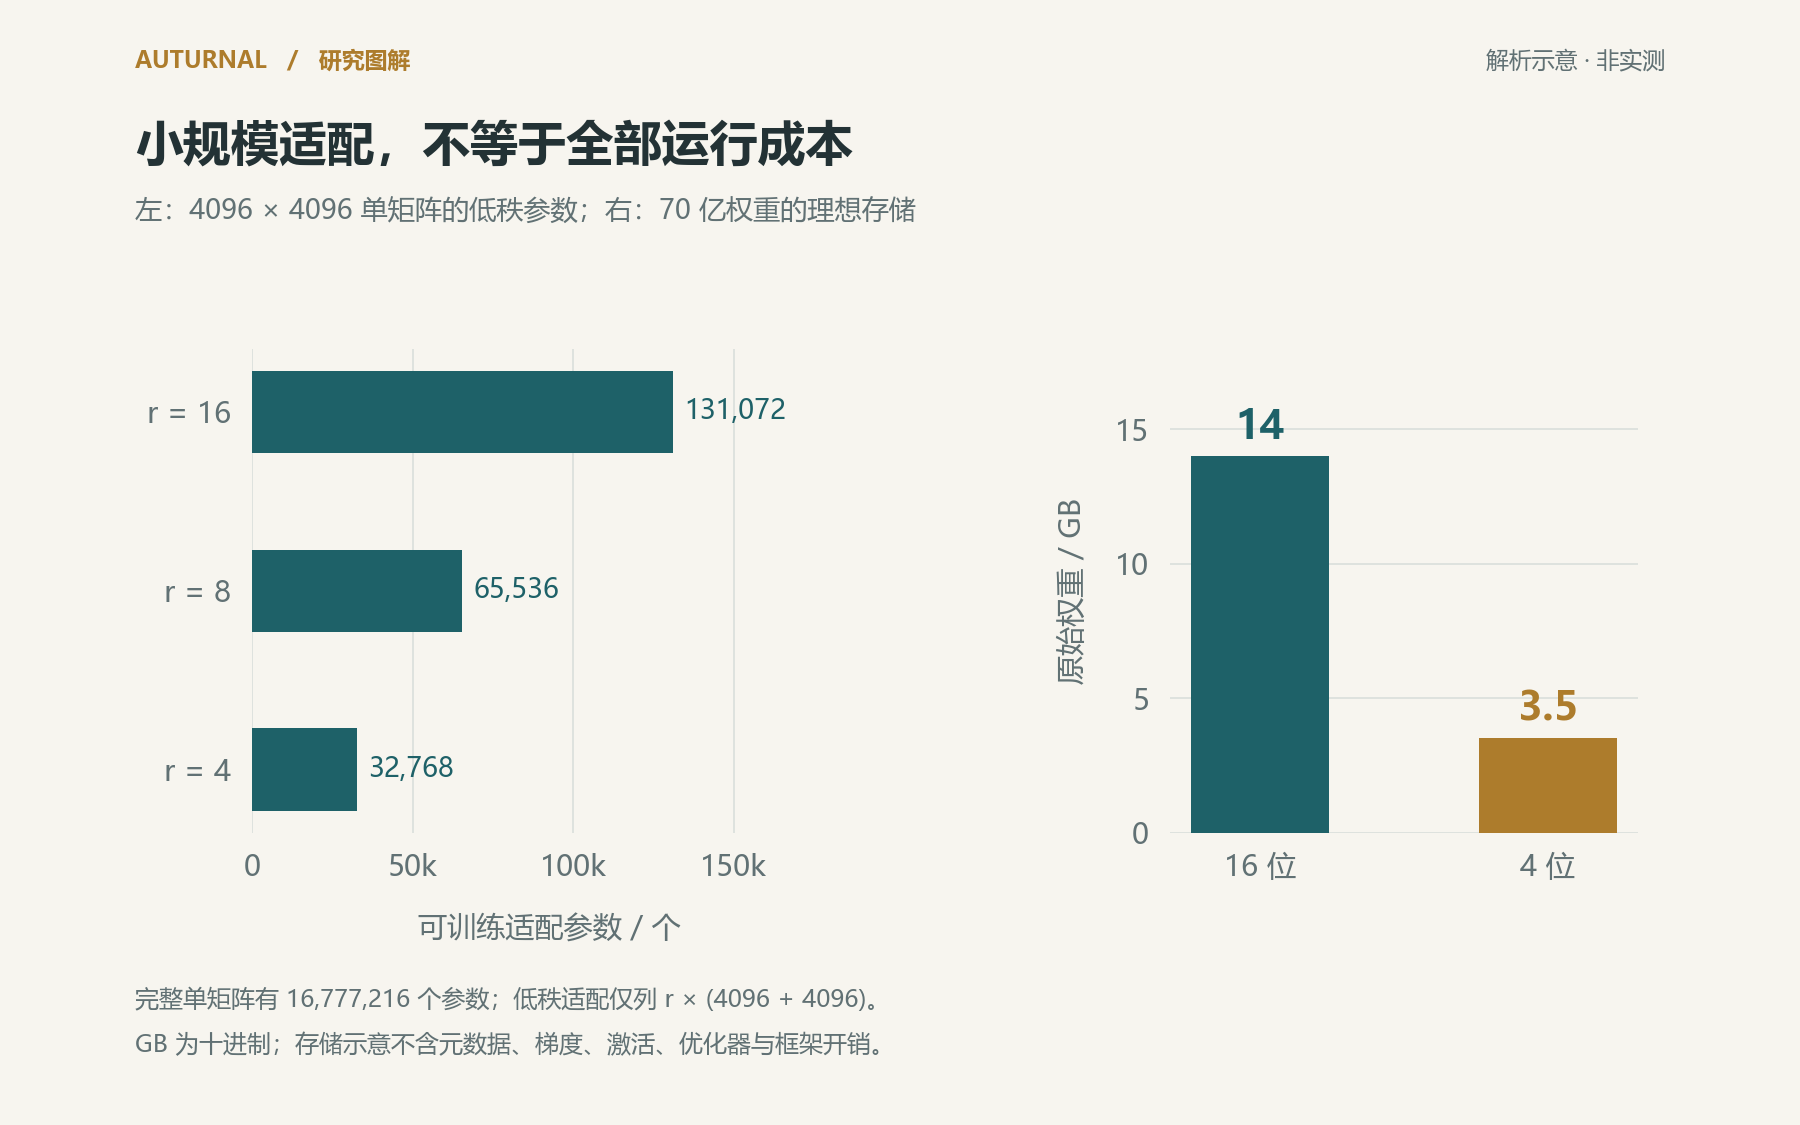
令 ,则原矩阵有 16,777,216 个数。取 ,两个低秩矩阵共有 65,536 个可训练数,是完整矩阵的 ; 与 16 时分别为 32,768 与 131,072。图 2 用同一公式展示这些量。它是单矩阵参数计数,不能写成整个模型训练显存缩小了 256 倍。[1]
3. 量化压缩另一项成本
QLoRA 把冻结预训练权重以 4 位形式保存,并将梯度传播到低秩适配器;论文还讨论 NF4、双重量化与分页优化器。其节省依赖表示方式、量化元数据、计算精度与优化器管理,不能概括为“整个训练过程都用 4 位”。冻结权重位宽、算子计算类型和适配器状态需要分别记录。[2]
4. 原始权重账本不等于峰值显存
假设恰有 70 亿个权重,16 位原始存储为 14 GB,4 位为 3.5 GB,这里 字节。这个理想化计算不含量化常数、激活、缓存、梯度、适配器、优化器、临时缓冲或框架分配,因此不能据此保证某张显卡可训练或运行该模型。图中数字只用于分清核算边界。
5. FlashAttention 优化不同的项
FlashAttention 通过 IO 感知的分块等方式减少注意力计算中的显存读写与中间保存。它不是 LoRA 的替代品:一个改变可训练增量,一个改变精确注意力的执行。把三种方法组合使用,可能作用于不同成本项;是否兼容、是否达到预期质量与速度,仍需在具体实现与输入上测量。[3][1][2]
6. 质量对照不能只看训练损失
低秩、量化和数据选择可能以不同方式影响任务表现。本文建议固定基础检查点和训练材料,比较完整微调与不同秩、精度的方案,记录任务指标、输出分布与失败类型。若适配器只在某类提示上训练,应保留域外测试。不能因为训练损失下降,就认定事实性或通用能力没有退化。
7. 合并、切换与部署也要验收
LoRA 增量在适当实现中可以与权重合并,但量化权重上的合并、重新量化或多适配器切换具有各自执行细节。应保存基础模型、适配器、量化配置与合并过程的版本,核对部署输出是否与被评测产物一致。对延迟的结论,应由实际部署路径测量,而不是仅从参数数目推断。[1]
稀疏更新与实际文件体积也有区别
适配器中的可训练数目可以精确计数,但保存文件还含有张量名称、元数据与精度信息。将一个适配器文件压缩后得到的字节数,不能直接与另一个未压缩完整检查点比较后宣称相同的参数节省倍数。同理,峰值显存包含同时存在的多种对象;即使冻结权重变小,激活也可能成为新的主要项。
后续实验可以如何设计
先核对基础模型与适配器矩阵维度,用脚本统计实际可训练数。随后在固定批量、序列长度与梯度累积设置下测量峰值显存,并分别记录加载阶段、前向、反向与优化器步骤。再在保留任务集上比较质量与延迟。若出现内存不足,应按失败记录保留,而不是不断降低输入条件后仍称原配置通过。
局限与结论
本稿未运行微调实验,也不提供显卡采购或容量承诺。成本核算需要区分原始权重、训练状态、激活与计算搬运。只有分别列账、对齐质量目标,并在目标环境测量峰值资源,参数高效与内存高效这两个判断才有可检查的含义。
| 成本项 | 计数或测量方式 | 不能直接替代 |
|---|---|---|
| 可训练参数 | 实际矩阵元素计数 | 总训练显存 |
| 冻结权重 | 位宽、元数据与存储 | 算子计算精度 |
| 峰值运行内存 | 目标配置真实测量 | 单纯权重文件体积 |
المصادر الأولية وربطها بالادعاءات
- Hu et al. · LoRA: Low-Rank Adaptation of Large Language Modelsافتح المصدر الأصلي ↖تاريخ المصدر:2021-06-17;تاريخ التحقق:2026-10-15;الموضع:v2; low-rank update formulationA frozen matrix W receives a trainable low-rank BA update. The number of trainable values r(d_in+d_out) differs from the full matrix size.
- Dettmers et al. · QLoRA: Efficient Finetuning of Quantized LLMsافتح المصدر الأصلي ↖تاريخ المصدر:2023-05-23;تاريخ التحقق:2026-10-15;الموضع:v1; NF4, double quantization, paged optimizers and limitations4-bit frozen weights and low-rank adapters reduce finetuning memory under the paper's setup; total memory includes more than raw weight storage.
- Dao et al. · FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awarenessافتح المصدر الأصلي ↖تاريخ المصدر:2022-05-27;تاريخ التحقق:2026-10-15;الموضع:v1; sections 2-3Exact attention reorganizes memory IO using tiling; this is not a linear-time approximation of attention.
مصدر الرسوم والبيانات والافتراضات
[
  {
    "slug": "efficient-adaptation-lora",
    "role": "conceptual-cover",
    "generator": "OpenAI built-in image_gen",
    "ai_generated": true,
    "alt": "极薄金箔改变深色层叠板局部形状的低秩适配概念插画。",
    "original_sha256": "04575754e54c4be123903486859b2b4107d554c35ba1ed00cd725f5099006afd",
    "prompt": "Create exceptional premium science journal editorial COVER ART in landscape 3:2, no text, labels, numbers, logos, border or watermark. A sculptural still-life with extremely believable tactile materials and sophisticated art direction, beautiful soft cinematic lighting, precise craftsmanship, warm gold details, rich yet restrained colors. Coherent with museum sculpture photography in a contemporary research magazine, memorable at thumbnail size. Clearly conceptual art and not a new scientific result. Avoid plastic CGI, glowing brain and microchip clichés, rainbow gradients, flat vector infographics and neon cyberpunk. Topic: low-rank adaptation and efficient fine-tuning. A monumental stack of many very thin dark graphite slate sheets, separated just enough to reveal layers; a single delicate flowing gold foil sheet enters the stack and subtly changes the shape of the top layers into a beautiful curved lifted edge. Precise geometry plus graceful minimal intervention, powerful metaphor of a small adaptation affecting a large system. Warm ivory-gray architectural studio, quiet copper-gold edge light, dark charcoal sheets, a single muted terracotta accent, three-quarter low angle, compelling contrast and clean editorial composition.",
    "files": [
      {
        "file": "assets/covers/efficient-adaptation-lora.png",
        "width": 1280,
        "height": 853,
        "bytes": 1607019,
        "sha256": "54d281c76515220f9662d30d17dab34ae84cab23060a64c1740a6fd9f361f8d6",
        "url": "/guides/assets/v2-efficient-adaptation-lora-54d281c76515.png"
      },
      {
        "file": "assets/covers/efficient-adaptation-lora-480.png",
        "width": 480,
        "height": 320,
        "bytes": 246177,
        "sha256": "651742a92fed36af9590f90970cefbd70d4ac6f5789ed72a65025b8fd1566acf",
        "url": "/guides/assets/v2-efficient-adaptation-lora-480-651742a92fed.png"
      }
    ],
    "url": "/guides/assets/v2-efficient-adaptation-lora-54d281c76515.png",
    "thumbnail_url": "/guides/assets/v2-efficient-adaptation-lora-480-651742a92fed.png"
  },
  {
    "slug": "efficient-adaptation-lora",
    "role": "data-chart",
    "file": "assets/charts/efficient-adaptation-lora.png",
    "width": 1800,
    "height": 1125,
    "sha256": "b9b67df16943d58e12db3b8c169d6c133e6ec22e43414f2f99ed54d7408a3f51",
    "bytes": 124196,
    "alt": "图表:按 4096×4096 单矩阵计算 LoRA 参数;另列恰有 70 亿权重在 16/4 位下的理想原始存储(十进制 GB),未计元数据、激活或运行开销,非显卡容量承诺。",
    "data": {
      "kind": "analytical",
      "matrix": [
        4096,
        4096
      ],
      "full_parameters": 16777216,
      "ranks": [
        4,
        8,
        16
      ],
      "adapter_parameters": [
        32768,
        65536,
        131072
      ],
      "weights": 7000000000,
      "bits": [
        16,
        4
      ],
      "raw_GB": [
        14,
        3.5
      ],
      "excludes": "metadata, gradients, activations, optimizer, framework"
    },
    "data_source_sha256": "963323d4a7a0cad4aebd986f09a55251a7c21f68c757d21b76245a128675e13e",
    "ai_generated": true,
    "disclosure": "AI-assisted deterministic rendering of unchanged v1 data; not a new experiment.",
    "url": "/guides/assets/v2-efficient-adaptation-lora-b9b67df16943.png"
  }
]
المؤلف والإصدارات والتصحيحات
يضيف v3 خمس لغات للواجهة، مع الاحتفاظ بالنص الأصلي و29 مصدرًا وبيانات المخططات. ويبقى الإصداران v1 وv2 متاحين.
文献导读与方法分析;不是原创实验论文、正式期刊录用或专业资质认证。解析示例不代表本站或当前产品的实测表现。
عرض الأصل v1 · تنزيل المقال والرسوم وربط المصادرعرض الأصل v2