
摘要
排行榜把复杂能力压缩为一个数字,便于比较,也容易隐藏样本选择、标注、污染和聚合权重的影响。本文在既有多维评价框架上补充统计推导、配对比较和数据治理分析,解释高分为何仍不能独立回答可靠性、迁移性或实际工作负载问题。新增置信区间与污染混合算例均为公开公式计算,不是对某个在用模型的实测。建议把评价对象、代码、样本和失败分布一起发布,而不是只发布排序结果。[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
English abstract
Benchmark scores are treated as measurements with sampling, annotation and selection uncertainty. The review derives finite-sample accuracy intervals, distinguishes paired from independent model comparisons, and explains why aggregate rankings can reverse under task reweighting. Contamination control and an auditable evaluation manifest are necessary to interpret an apparent improvement; the numerical examples are constructed statistical calculations.
1. MMLU 扩展了知识测试的覆盖
MMLU 包含 57 项学术与专业任务,让研究者能够观察模型在不同领域的差异。一个跨任务平均值可以帮助概括,却可能掩盖某个领域的失败。选择题表现也不能直接等同于开放式咨询、长任务执行或取得专业资质。基准的贡献是提供可比较的问题集合,而不是替代所有现实验证。[1] Measuring Massive Multitask Language Understanding
2. HELM 说明准确率只是一个维度
HELM 把准确率、校准、鲁棒性、公平性、偏差、毒性与效率纳入评估框架,并说明哪些场景能够测量哪些维度。这种设计的重要之处在于把覆盖缺口与权衡公开。不能把不同含义、不同单位的指标随意加总为一个“综合智能分”,也不应把尚未测量的格子填成零分。[2] Holistic Evaluation of Language Models
3. 多模态题目改变了被测对象
MMMU 以跨学科的图文题目检验知识与推理,包含约 1.15 万道题、30 个学科。其价值不只是增大题量,而是引入图表、结构图等信息形式。若评估系统先通过另一个模型将图片转成文字,分数衡量的是整条处理链;若直接输入图片,则需要记录图像分辨率、裁剪与输入方式。[3] MMMU: A Massive Multi-discipline Multimodal Understandi
4. 样本量决定结论能有多精确
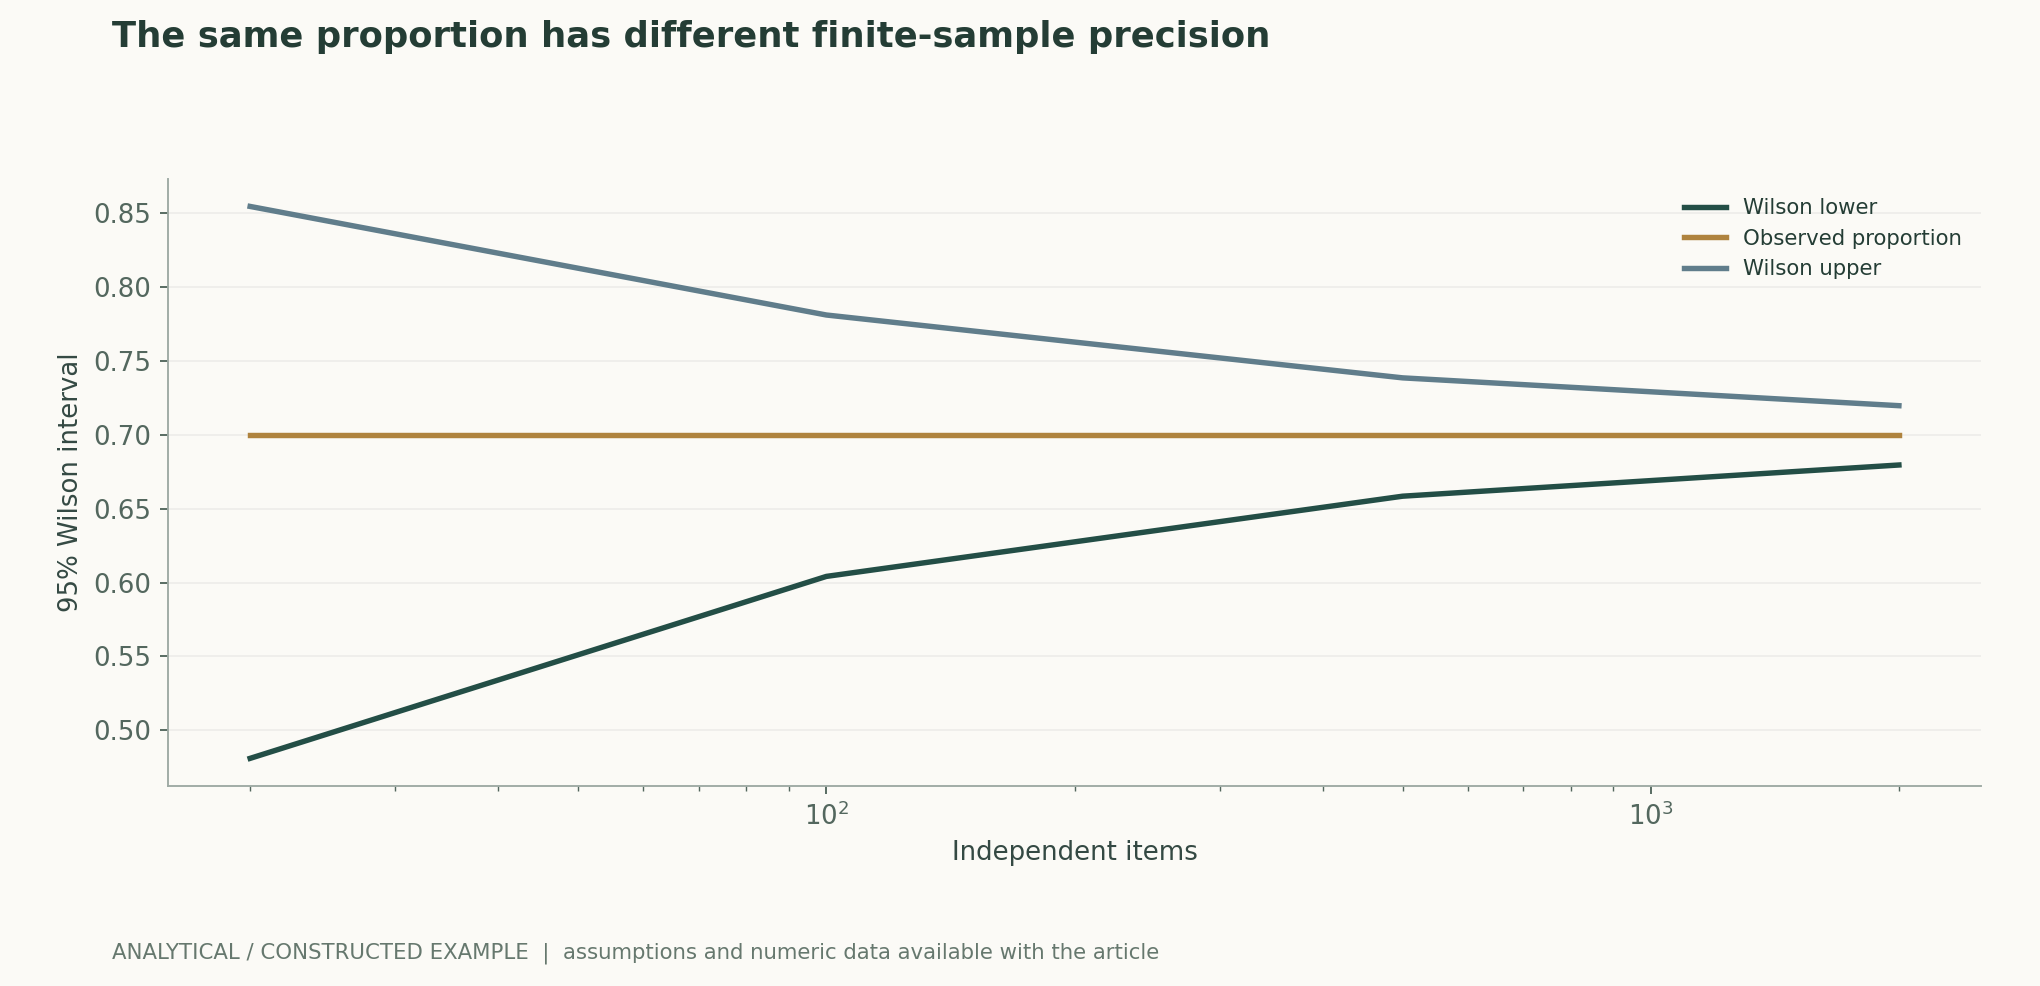
本版图2固定观测比例70%,取n=20、100、500、2000,并计算95% Wilson区间,解释样本量与区间宽度的关系,不来自任何模型。区间依赖独立二项观测;同一文档的多道题、重复用户或共享模板可能降低有效样本量。应根据真实相关结构选择重采样或分层估计,不能只把题目数量当作独立证据数量。作者分析与复核建议 / Author analysis
5. 测试污染需要可追踪的时间线
如果评估题目或答案进入训练材料,基准可能同时测到记忆与泛化。本文建议记录训练可得数据的时间边界、评估集发布历史、去重方式与可能的近似重复。不能因为测试集没有出现在一个已知清单,就宣称完全无污染;也不能没有证据便指控某个具体模型泄漏数据。作者分析与复核建议 / Author analysis
6. 配对比较比两根柱子更有信息
同一批题目上比较两个模型,应保留逐题对错与任务类别,关注在哪些题目发生分歧。单独给出两个准确率和各自区间,不足以完整判断差异的不确定性。若题目具有类别层级,可使用相应分层或配对方法;若反复挑选最有利设置,应披露选择过程。本文未计算任何真实模型的显著性。作者分析与复核建议 / Author analysis
7. 复现记录应包含什么
至少保存题目版本、提示模板、few-shot 样例、解码参数、工具权限、模型标识、运行时间、失败与重试规则、评分器版本。开放权重与在线服务的可复现条件不同;服务可能在同一产品名下更新。记录协议可以帮助后续判断:变化来自模型、系统组件,还是评分条件。作者分析与复核建议 / Author analysis
平均值需要一个明确的权重
把每道题同权平均,与先算每个学科再同权平均,可能得到不同结果。前者让题量大的学科权重更高,后者强调领域之间平衡;两种做法都必须公开定义。如果目标用户只处理其中少数任务,还应报告与真实任务分布相匹配的结果。本文不指定一种适合所有用途的权重,也不把缺失学科推断为已覆盖。作者分析与复核建议 / Author analysis
8. 准确率的点估计需要误差范围
若n个独立样本服从相同成功概率,样本准确率的标准误差近似为sqrt[p(1−p)/n]。但小样本或接近0、1时,简单正态区间可能不稳定,Wilson区间通常更适合展示有限样本不确定性。它仍依赖采样模型;同一文档或同一问题变体形成簇时,不能把每个变体当独立样本。应按抽样单位进行重采样,说明区间覆盖的是题目抽样、模型随机性还是标注误差。[2] Holistic Evaluation of Language Models[1] Measuring Massive Multitask Language Understanding
9. 同一题集上的模型比较是配对问题
两个模型若回答同一批题,比较差值时应保留每题对应关系。两组独立样本的误差公式忽略了这种相关结构,可能夸大或缩小不确定性。可报告“仅A正确、仅B正确、都正确、都错误”的交叉表,或对题目/文档簇进行配对bootstrap。重复尝试多个提示后只报告最佳提示,也会引入选择偏差;提示搜索预算必须纳入实验说明。[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
10. 总分可能被任务权重主导
设每个领域得分为s_j,总分为各领域权重w_j的加权平均。模型在一组权重下排名更高,并不保证在另一种用户需求分布下仍更高。多模态评价还需区分图像理解、文字读取、知识和推理错误,避免把所有失败都叫视觉能力不足。除预注册总分外,应公开领域成绩、权重、缺失项和最差分组表现,让使用者能按实际任务重新聚合。[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
11. 污染与去重应进入评价清单
如果评价样本或其近似变体进入训练、检索或提示示例,分数就可能混合记忆与泛化。仅检查精确字符串不能覆盖语义改写,但过宽的相似度过滤也可能删去真正需要的领域知识。建议记录数据时间、来源、精确及近似去重规则,并用新构造、人工复核的题集交叉验证。构造污染混合模型可以解释分数为何上升,但不能根据这一图反推某个现实模型的污染比例。[4] Deduplicating Training Data Makes Language Models Bette[5] Documenting Large Webtext Corpora: A Case Study on the
Equations and derivations
(1) c是成功数。独立同分布假设不适用于所有题集;图中p=0.7只是解析设定。
LaTeX
\widehat p=\frac{c}{n},\qquad \mathrm{SE}(\widehat p)\approx\sqrt{\widehat p(1-\widehat p)/n}(2) z取标准正态分位数时得到相应近似置信区间。应说明抽样单位,不把区间当作对所有未来任务表现的保证。
LaTeX
\mathrm{CI}_{\rm Wilson}=\frac{\widehat p+\frac{z^2}{2n}\ \pm\ z\sqrt{\frac{\widehat p(1-\widehat p)}{n}+\frac{z^2}{4n^2}}}{1+\frac{z^2}{n}}(3) 任务权重是评价设计的一部分。缺失任务如何处理、是否重归一化,应在比较前固定并披露。
LaTeX
S=\sum_jw_js_j,\quad \sum_jw_j=1,\quad w_j\ge0Method and evidence flow
Analytical figures
Worked calculation
观察比例均为0.7时,n=20的Wilson区间约[0.481,0.855],n=500约[0.658,0.739]。相关题目会让这个独立模型过于乐观。
Method comparison
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 单一总分 | 固定任务权重并同时给出分项与最差分组 | 聚合可能掩盖局部失败或改变排名 |
| 题目准确率 | 明确抽样单位和区间计算方法 | 相关题目不能充当独立样本 |
| 同题集模型差值 | 保留配对表或按文档簇重采样 | 独立两样本公式可能不适用 |
| 污染检测 | 时间切分、精确/近似去重和新题交叉验证 | 字符串不重叠不能证明不存在训练接触 |
Verification protocol
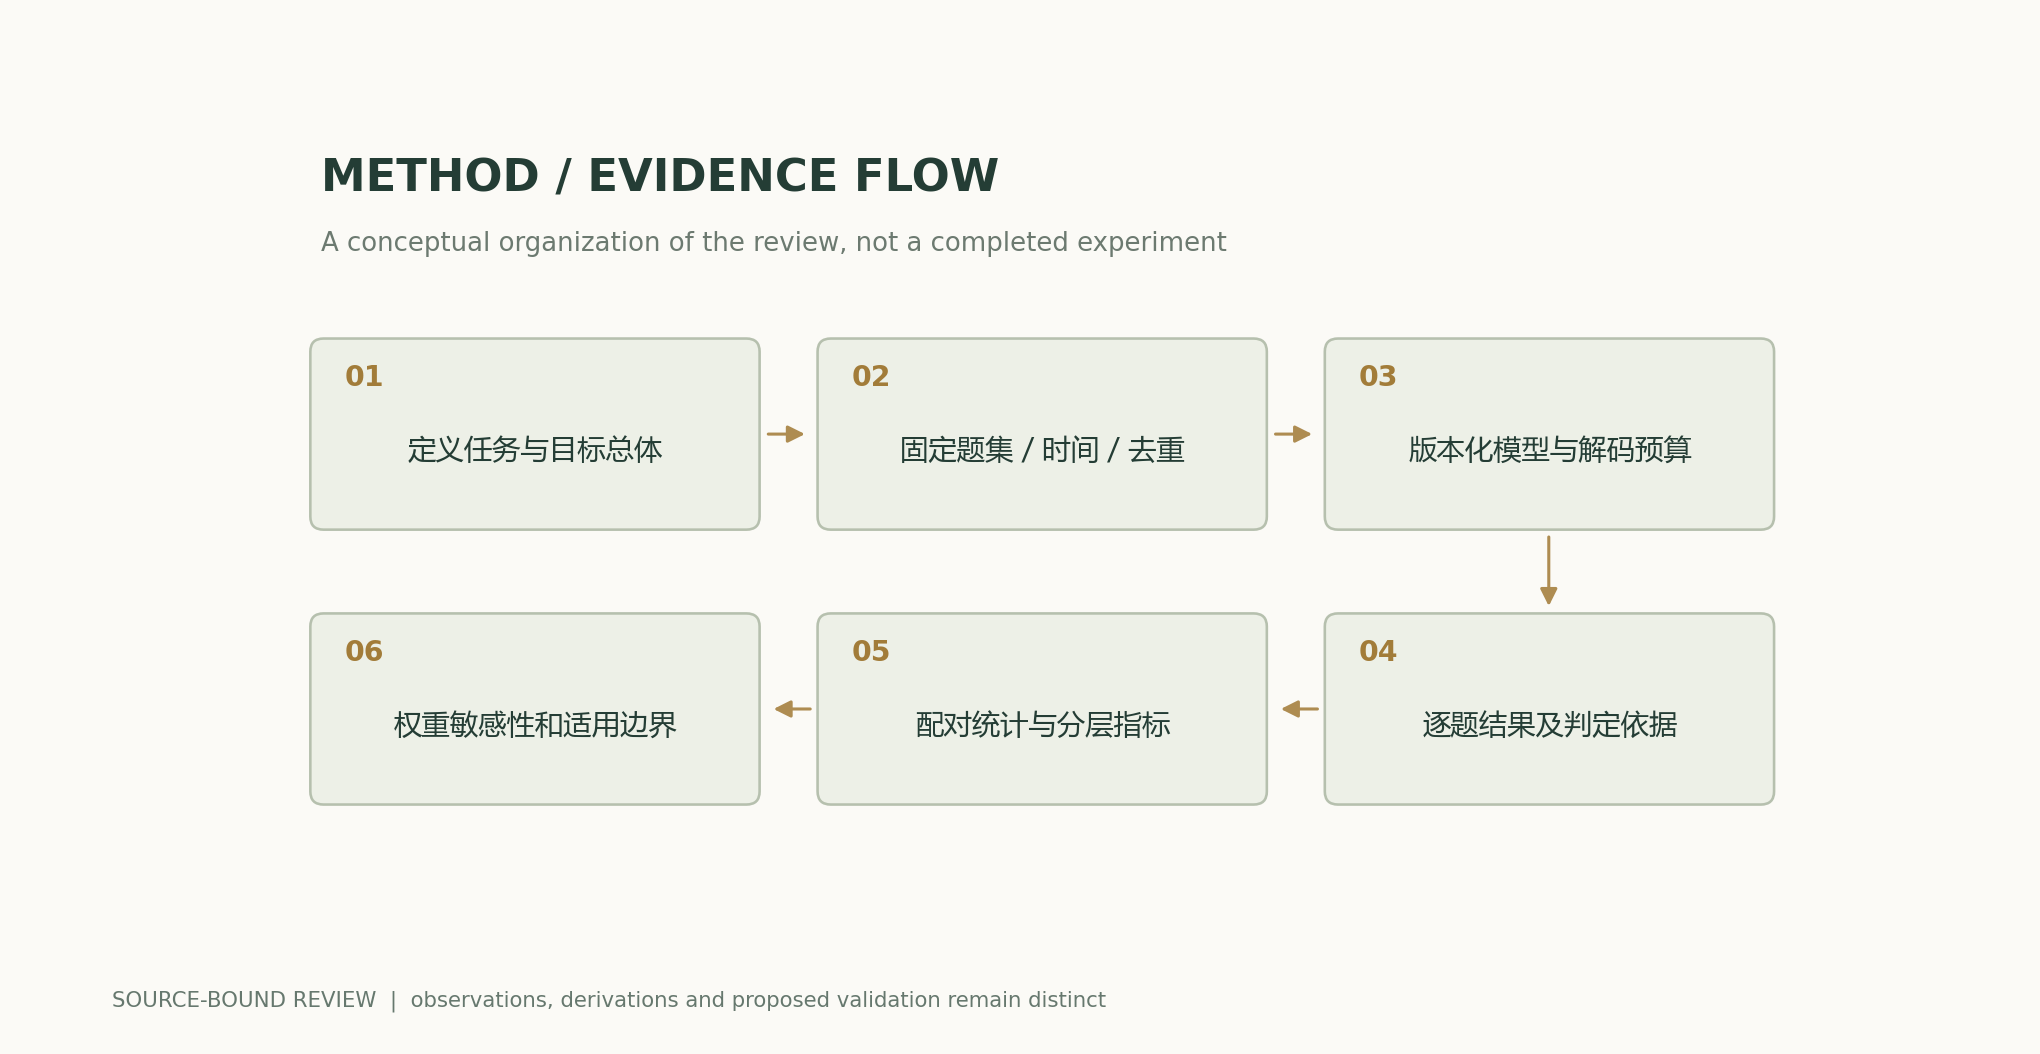
- 预先固定模型版本、评价代码、任务集合、评分规则、聚合权重和提示搜索预算。
- 保存每题输出、判定依据、随机种子与失败类型;不能只保存总分。
- 按原始文档或题目家族建立采样单位,给出区间并对不同抽样假设做敏感性分析。
- 比较模型时保留同题对应,公开差异交叉表或可复跑的配对重采样过程。
- 记录数据来源、时间和污染检测规则,将原题、近似变体与新题评价分开。
- 同时报告时延、成本、拒答及无法判定比例;更换评分器后重新计算全部模型,不只重算新模型。
Scope and limitations
- 统计区间取决于抽样与相关性假设。
- 标注分歧和评分器误差不能由题数自动消除。
- 解析污染例子不诊断任何现实模型。
- 没有新增模型榜单或能力认证。
Primary sources and claim mapping
- Measuring Massive Multitask Language UnderstandingHendrycks et al. · 2020-09-07v3 abstract; 57-task benchmark
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
- MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGIYue et al. · 2023-11-27v4 abstract; dataset scope
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citations and exports
BibTeXRISCSL JSONTXTArticle JSON
Author, versions and sources
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Author, versions and corrections · /guides/evaluation-beyond-leaderboards/v4/
Cover and figure provenance · Data, sources and assumptions · Publication and version record
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1