
摘要
把训练数据留在设备上可以减少原始数据集中收集,却不自动隐藏模型更新中的信息。本文区分FedAvg的优化机制、安全聚合对单个更新可见性的保护,以及差分隐私的概率保证,分析非独立同分布、参与偏差和裁剪的影响。图中梯度完全构造,没有使用个人数据,也没有计算任何真实隐私预算。[1] Communication-Efficient Learning of Deep Networks from [2] Deep Learning with Differential Privacy[3] Practical Secure Aggregation for Federated Learning on
English abstract
Federated learning, secure aggregation and differential privacy address different exposure channels. We derive weighted averaging and clipping, and state the need for a privacy unit, adjacency definition and accountant. Constructed gradient and clipping plots contain no private client data and imply no privacy budget. Non-IID participation, dropout and system costs are part of the evaluation.
1. 联邦优化首先改变数据与计算位置
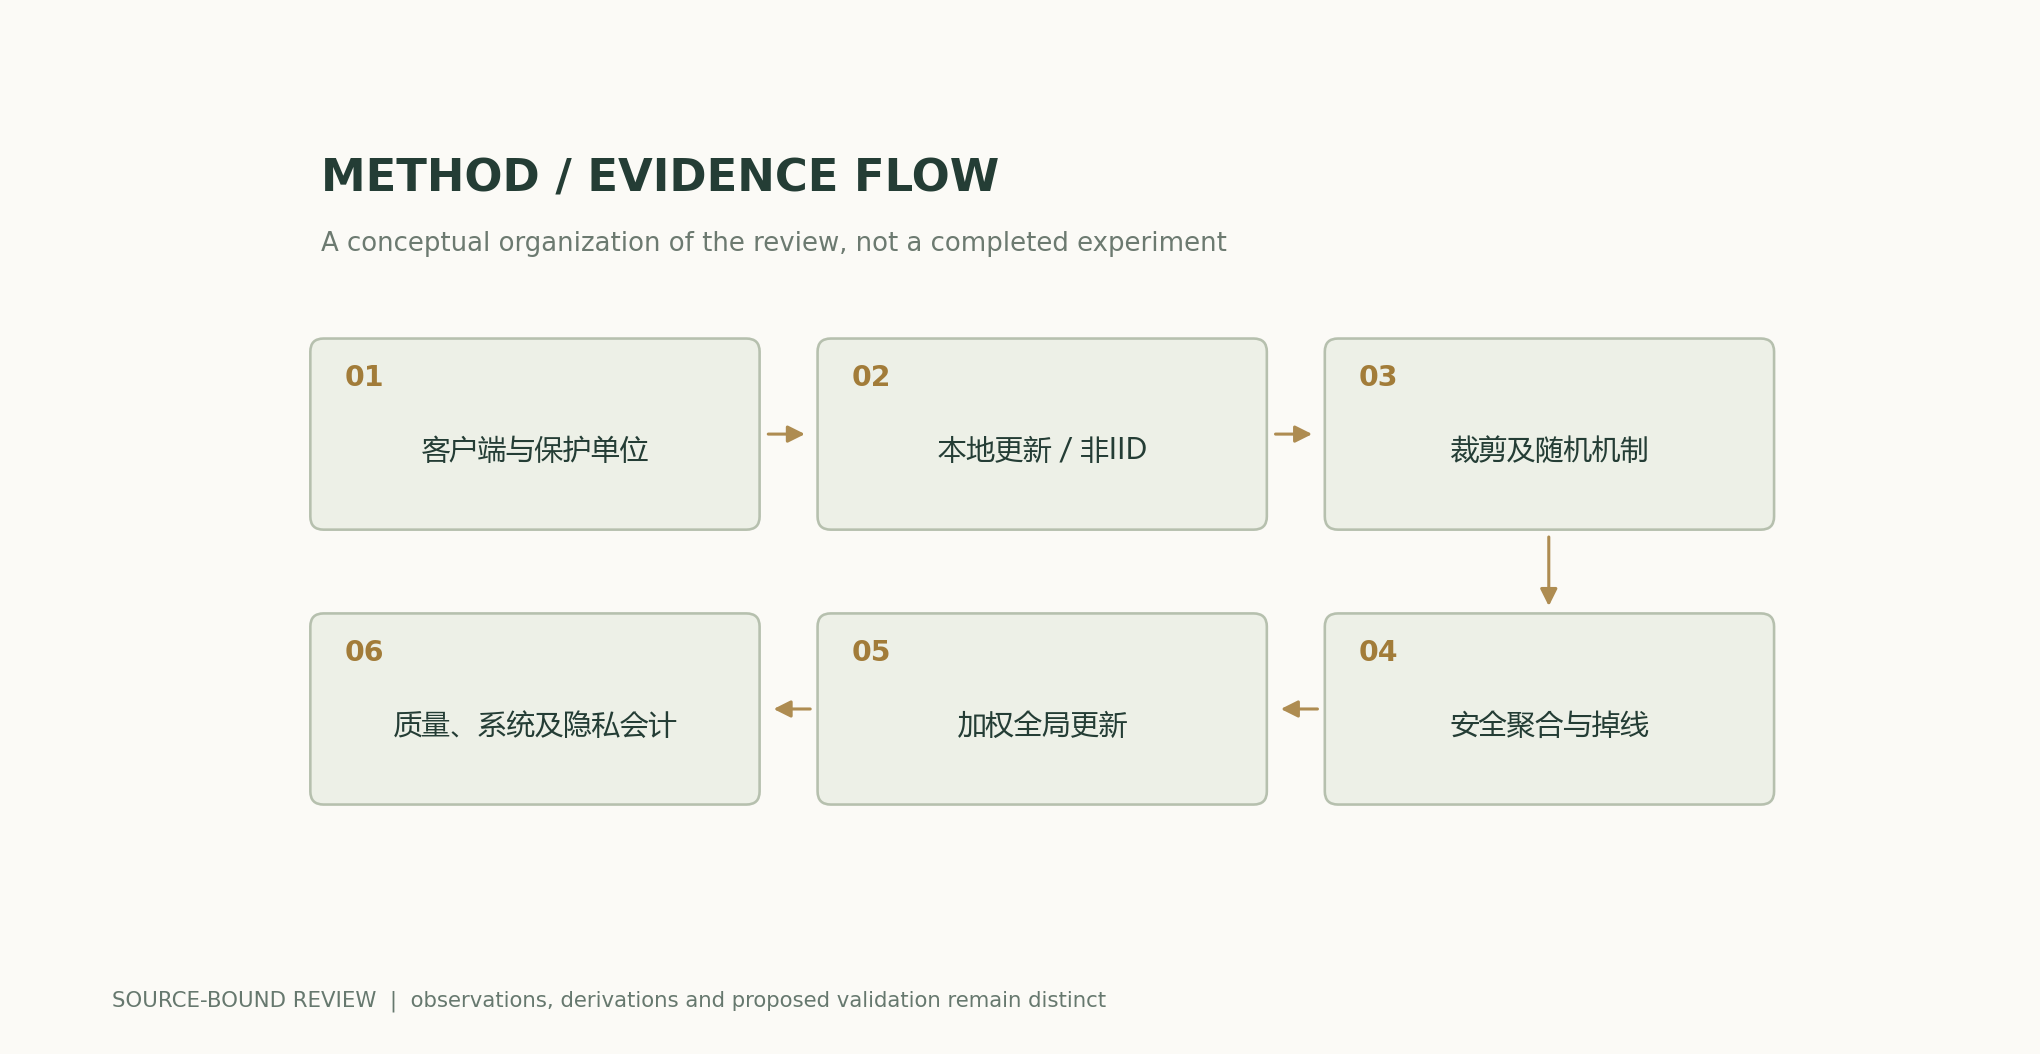
FedAvg让客户端执行本地更新,再按规定权重聚合。按样本数加权与每客户端等权对应不同目标,非独立同分布和多步本地训练会造成客户端漂移。设备可用性、网络和参与频率还会让实际参与者偏离目标总体。因此“原始数据不上传”只是流程描述,不能替代优化目标、公平性和隐私分析。[1] Communication-Efficient Learning of Deep Networks from
2. 更新仍可能携带敏感信息
梯度或模型差分是数据的函数,服务器看到更新不等于看不到数据相关信号。安全聚合使服务器在协议条件下获得聚合值而非单个明文更新,但仍需说明参与门槛、串谋与掉线处理。聚合结果本身可能泄漏总体或小群体信息,协议也不自动限制恶意客户端提交异常更新。安全通信、鲁棒聚合与统计隐私应分别验收。[3] Practical Secure Aggregation for Federated Learning on
3. 裁剪控制单次贡献但引入偏差
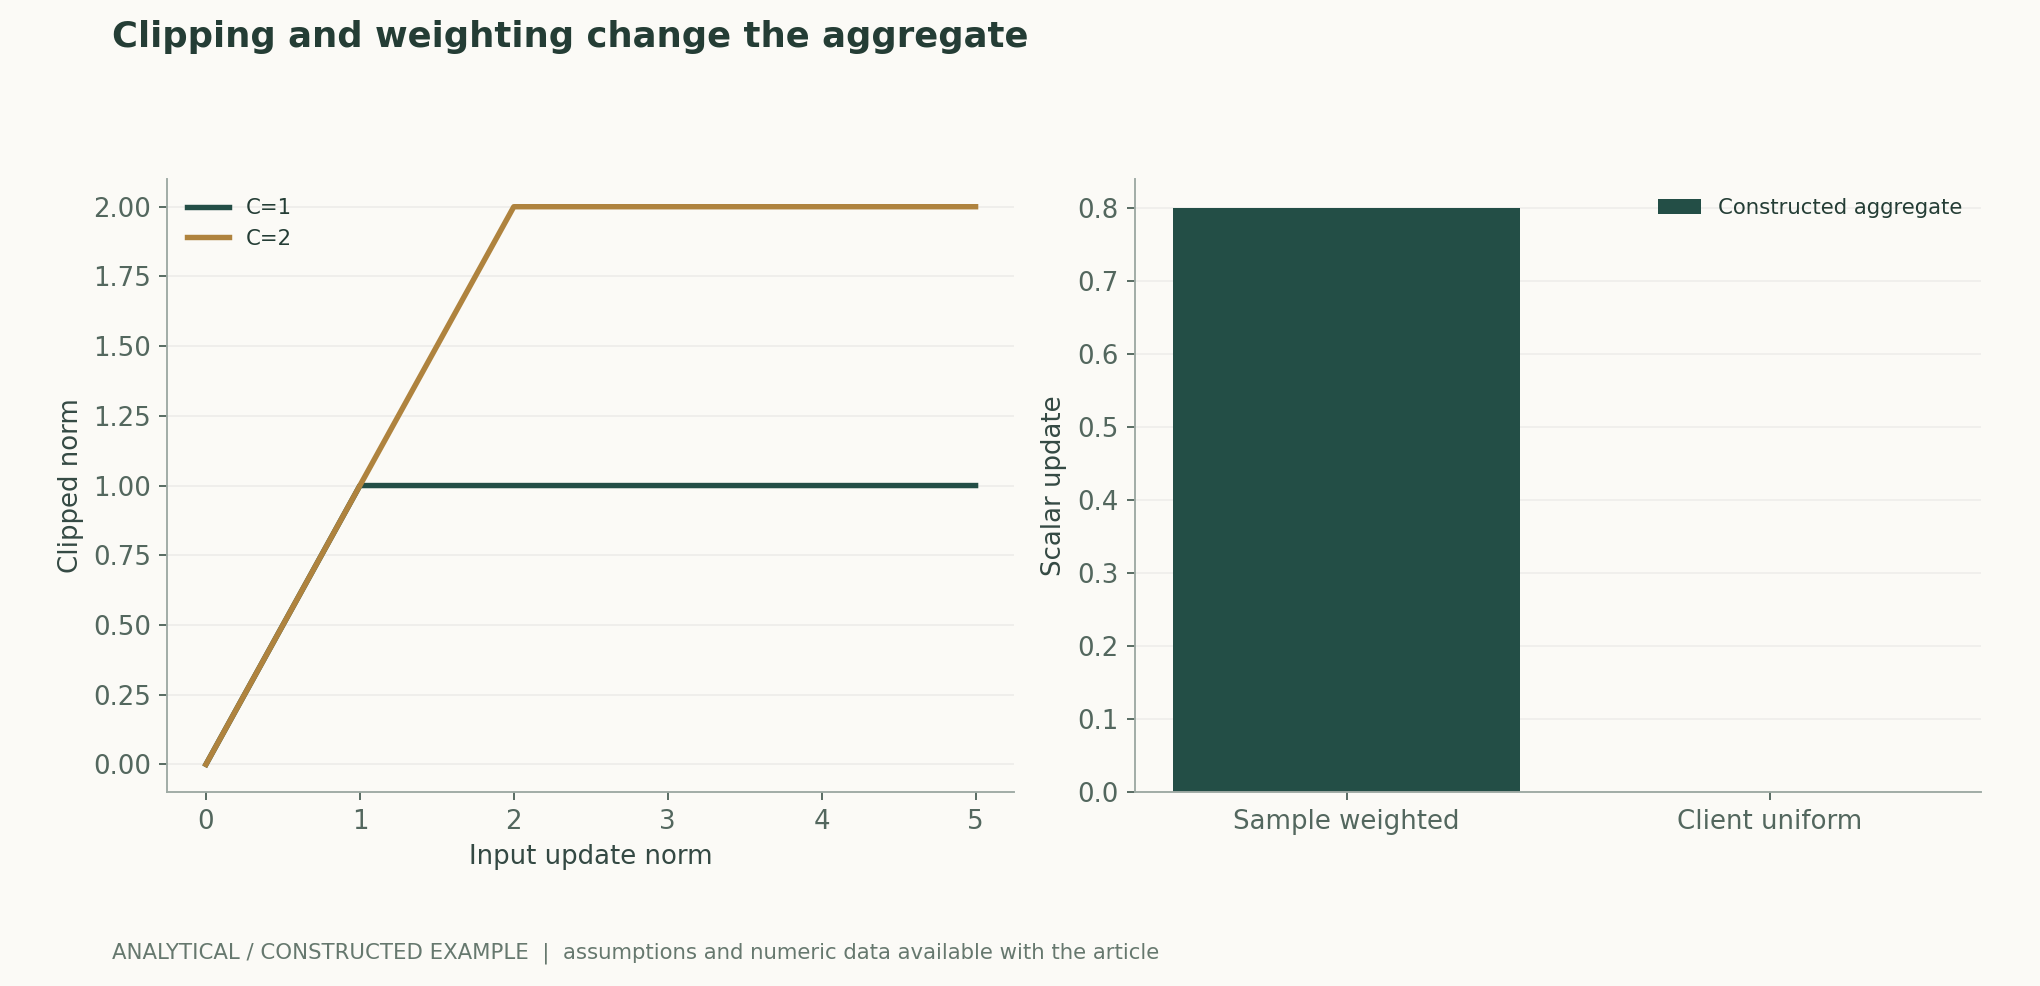
将更新范数限制到C,可以界定敏感度并避免少数大更新无限主导;超过阈值的更新被缩小,因此方向和幅度分布会改变。不同客户端数据量和任务难度可能导致不同裁剪比例。图示只画输入范数与裁剪后范数min(r,C),以及两个构造客户端的加权结果,不表示真实训练质量。C的选择应与隐私、优化和群体影响联合分析。[2] Deep Learning with Differential Privacy[1] Communication-Efficient Learning of Deep Networks from
4. 差分隐私必须定义保护单位
差分隐私比较相邻数据集上输出概率。保护一条记录、一个用户或整个客户端,对邻接关系和敏感度的要求不同;噪声乘数本身不是ε。采样、轮数、裁剪、噪声分布和会计方法共同决定预算,重复发布也会组合消耗。集中式与本地差分隐私的信任边界不同,不能只写“加了噪声所以隐私安全”。[2] Deep Learning with Differential Privacy
5. 掉线与非IID参与是系统和统计问题
较慢或不稳定设备被排除可能提高轮次速度,却改变数据覆盖。安全聚合需要在掉线条件下仍正确恢复允许的聚合,隐私会计则依赖真实采样机制。应记录每轮被邀请、参与、完成和纳入聚合的数量,按合法且最小化的元数据检查偏差。尾延迟、通信量、能耗与模型质量应联合报告,不用轮数代替成本。[1] Communication-Efficient Learning of Deep Networks from [3] Practical Secure Aggregation for Federated Learning on
6. 三种承诺需要三组证据
优化正确性通过集中参考与非IID消融检验;安全聚合通过协议威胁和掉线测试检验;差分隐私通过明确邻接、机制和会计复算检验。任何一组通过都不能自动替其他组背书。本文只给出公开机制与玩具计算,没有部署联邦系统、处理私有客户端数据或声称某个ε保证。[1] Communication-Efficient Learning of Deep Networks from [2] Deep Learning with Differential Privacy[3] Practical Secure Aggregation for Federated Learning on
数式と導出
(1) 样本数加权示意;实际参与集与本地步数影响优化目标。
LaTeX
w_{t+1}=\sum_{k\in S_t}\frac{n_k}{\sum_{j\in S_t}n_j}w_{t+1}^{(k)}(2) g为零时定义输出为零。裁剪限制范数,也可能改变优化方向与群体影响。
LaTeX
\operatorname{clip}_C(g)=g\min\{1,C/\|g\|_2\}(3) 必须明确D与D′的邻接关系以及完整机制;本文不计算真实隐私预算。
LaTeX
P(M(D)\in A)\le e^\epsilon P(M(D^{\prime})\in A)+\delta手法と根拠の流れ
解析図と数値例
再計算できる例題
两客户端更新+1与−1,按0.9和0.1样本权重得0.8,等客户端权重得0。裁剪只限制贡献范数,差分隐私还需要噪声、采样和完整会计。
手法の比較
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 联邦学习 | 说明本地更新和聚合权重 | 数据留本地不等于更新无泄漏 |
| 安全聚合 | 列出串谋、门槛和掉线条件 | 隐藏单个更新不保证总体输出隐私 |
| 差分隐私 | 定义单位、邻接与会计 | 噪声乘数不是ε |
| 系统成本 | 测参与偏差、通信和尾延迟 | 轮数不代表完整训练开销 |
検証プロトコル
- 定义参与总体、隐私单位和威胁边界,确认数据使用授权。
- 固定聚合权重、本地步数及非IID划分,核对集中参考。
- 记录裁剪阈值和分层裁剪率,检查质量与群体影响。
- 若使用DP,公开采样、噪声、轮数及会计并独立复算。
- 在协议范围内测试掉线、串谋假设和聚合正确性。
- 联合报告模型质量、参与偏差、通信与隐私预算,不互相替代证据。
適用範囲と限界
- 玩具梯度没有真实客户端数据。
- 没有计算任何真实ε预算。
- 安全聚合与DP提供不同保护。
- 参与偏差可能影响优化和会计。
一次資料と主張の対応
- Communication-Efficient Learning of Deep Networks from Decentralized Data, , , , · 2016-02-17Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Deep Learning with Differential Privacy, , , , , , · 2016-07-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Practical Secure Aggregation for Federated Learning on User-Held Data, , , , , , , , · 2016-11-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用とエクスポート
BibTeXRISCSL JSONTXTArticle JSON
著者・版・出典
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
表紙と図の出典 · データ・出典・仮定 · 公開とバージョンの記録
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1