
摘要
图神经网络通过邻域聚合传播信息,但聚合器的可辨性、重复传播的混合与图划分方式共同决定结果。本文比较GCN、GIN与邻域采样思想,区分过平滑和过挤压,并用六节点路径图计算重复平均后的方差变化。配图没有训练参数,不代表真实图任务准确率。[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
English abstract
Message-passing graph networks are analyzed through normalized aggregation, permutation behavior and multiset distinguishability. A six-node path calculation illustrates smoothing for one declared propagation operator. It is not a universal oversmoothing theorem or model benchmark. Graph-level and temporal splits, feature provenance and inductive access rules are required for credible evaluation.
1. 邻域聚合应尊重节点重编号
节点编号通常不应改变图的含义,因此节点表示应随重编号相应变换,图级输出则应保持不变。归一化邻接传播与共享参数可以满足这种结构要求,但特征中的ID或划分信息仍可能引入泄漏。GCN中的自环和度归一化会改变传播尺度,应保存是否有向、是否加权和自环规则,不能只用“用了GCN”描述实现。[1] Semi-Supervised Classification with Graph Convolutional
2. 聚合器能否区分多重集合很关键
平均、求和和最大值对不同邻域可能产生相同结果;例如相同均值的不同多重集合会被均值聚合混同。GIN研究了消息传递网络与图可辨性之间的联系,其结论依赖函数类和假设,不能理解为任意训练后的GIN都能区分所有图。结构不可辨与优化未学会也应分开:增加训练轮数不能修复某个固定聚合器固有的信息丢失。[2] How Powerful are Graph Neural Networks?
3. 重复混合可能导致表示趋同
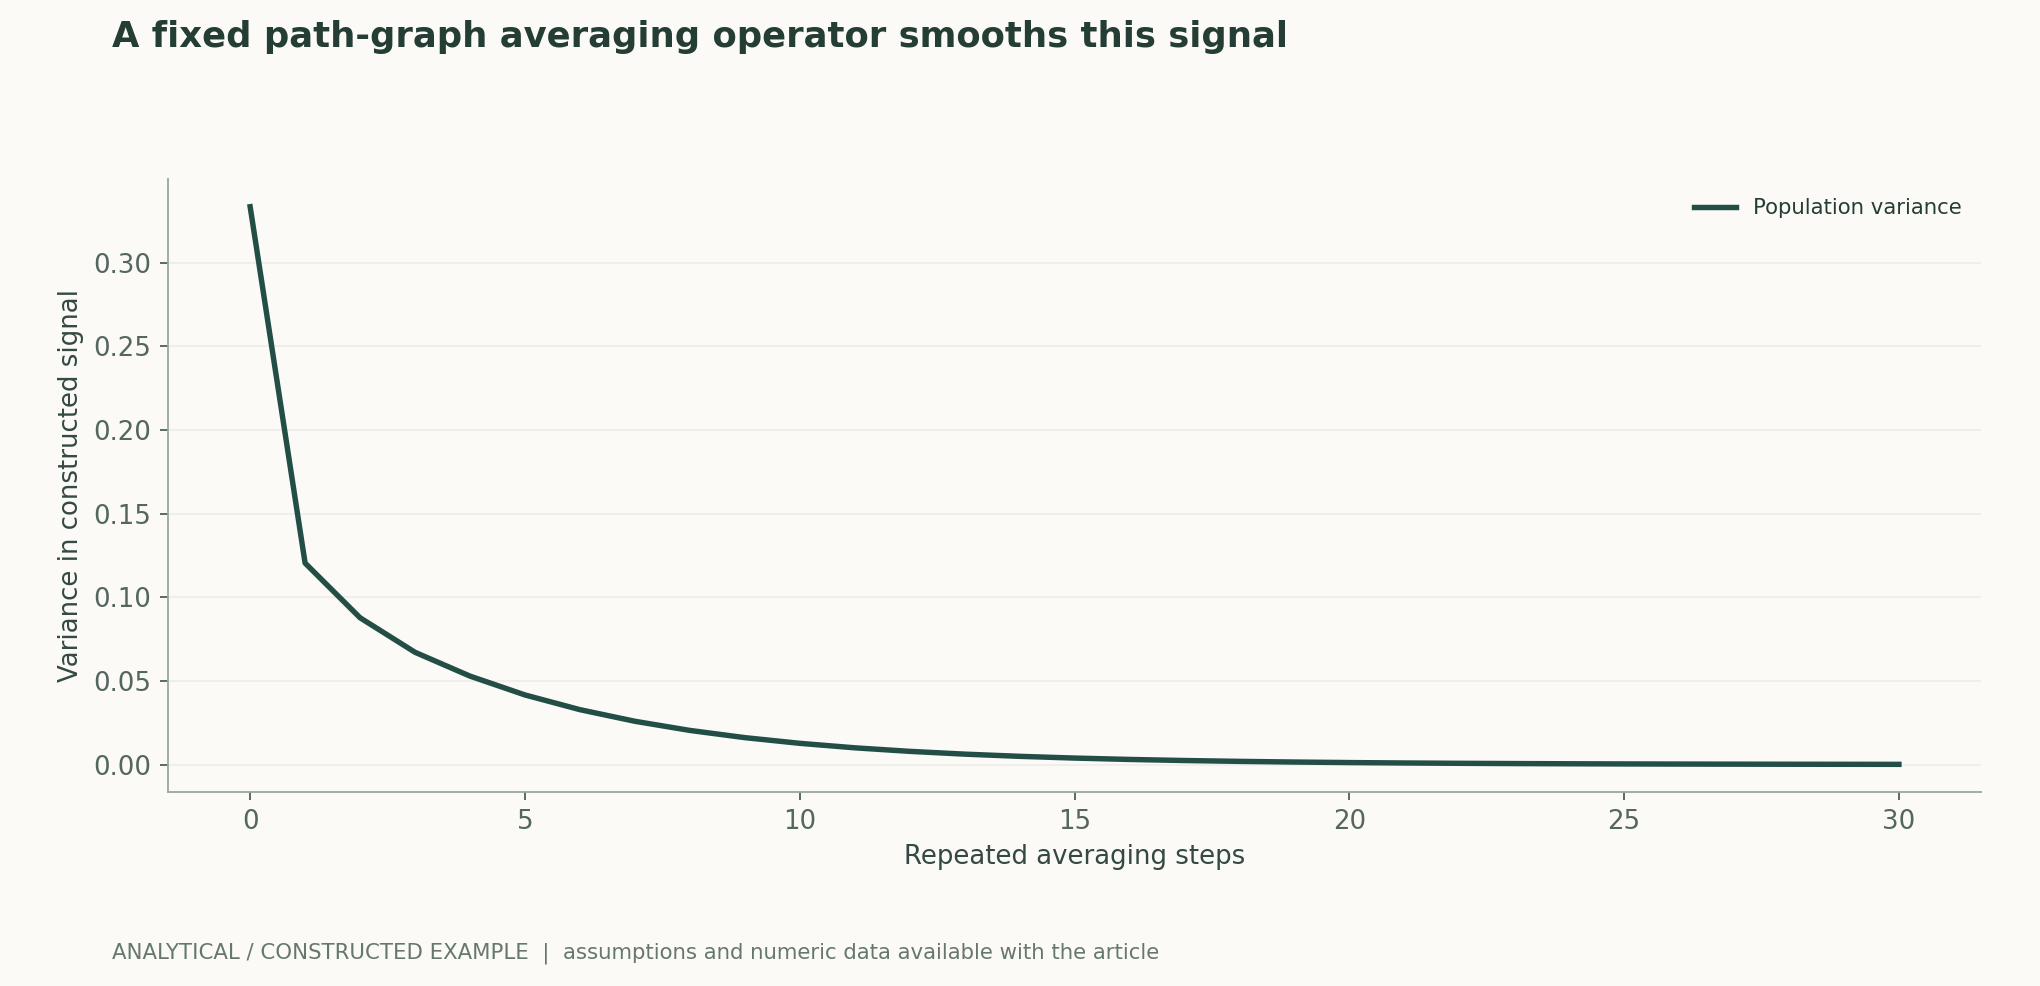
在固定线性传播下,邻域平均会逐步混合节点信息;特定连通与谱条件下可分析其长期行为。实际网络包含非线性、残差、归一化和训练权重,不能把简单平均的方差曲线当成所有GNN的定理。本篇六节点路径加自环后采用行归一化,直接迭代一个固定输入向量,展示这一算子下的趋同现象;没有测分类质量。[1] Semi-Supervised Classification with Graph Convolutional
4. 过平滑与过挤压不是同一个瓶颈
表示趋同强调不同节点难以区分;过挤压强调大量远处信息需要经过有限宽度或少量边压缩。某个图任务可能只需局部信息,也可能需要跨图长距离关系。增加层数会扩大感受野,同时改变优化和信息混合。应构造能分离局部与远程需求的测试,并将结构、宽度、残差与采样分别消融,不能看到深层效果差就归为单一原因。[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
5. 归纳与传导评估的可见信息不同
传导设置可能允许训练时看到未标注测试节点的图结构,归纳设置则需要对新节点或新图泛化。GraphSAGE研究采样和聚合的归纳表示方式,但实现必须明确训练时能访问哪些边和特征。若时间后的边或目标标签派生特征进入训练,分数可能被泄漏抬高。随机节点划分不能自动代表新图、未来关系或新机构上的泛化。[3] Inductive Representation Learning on Large Graphs
6. 图实验需要结构与系统双重复核
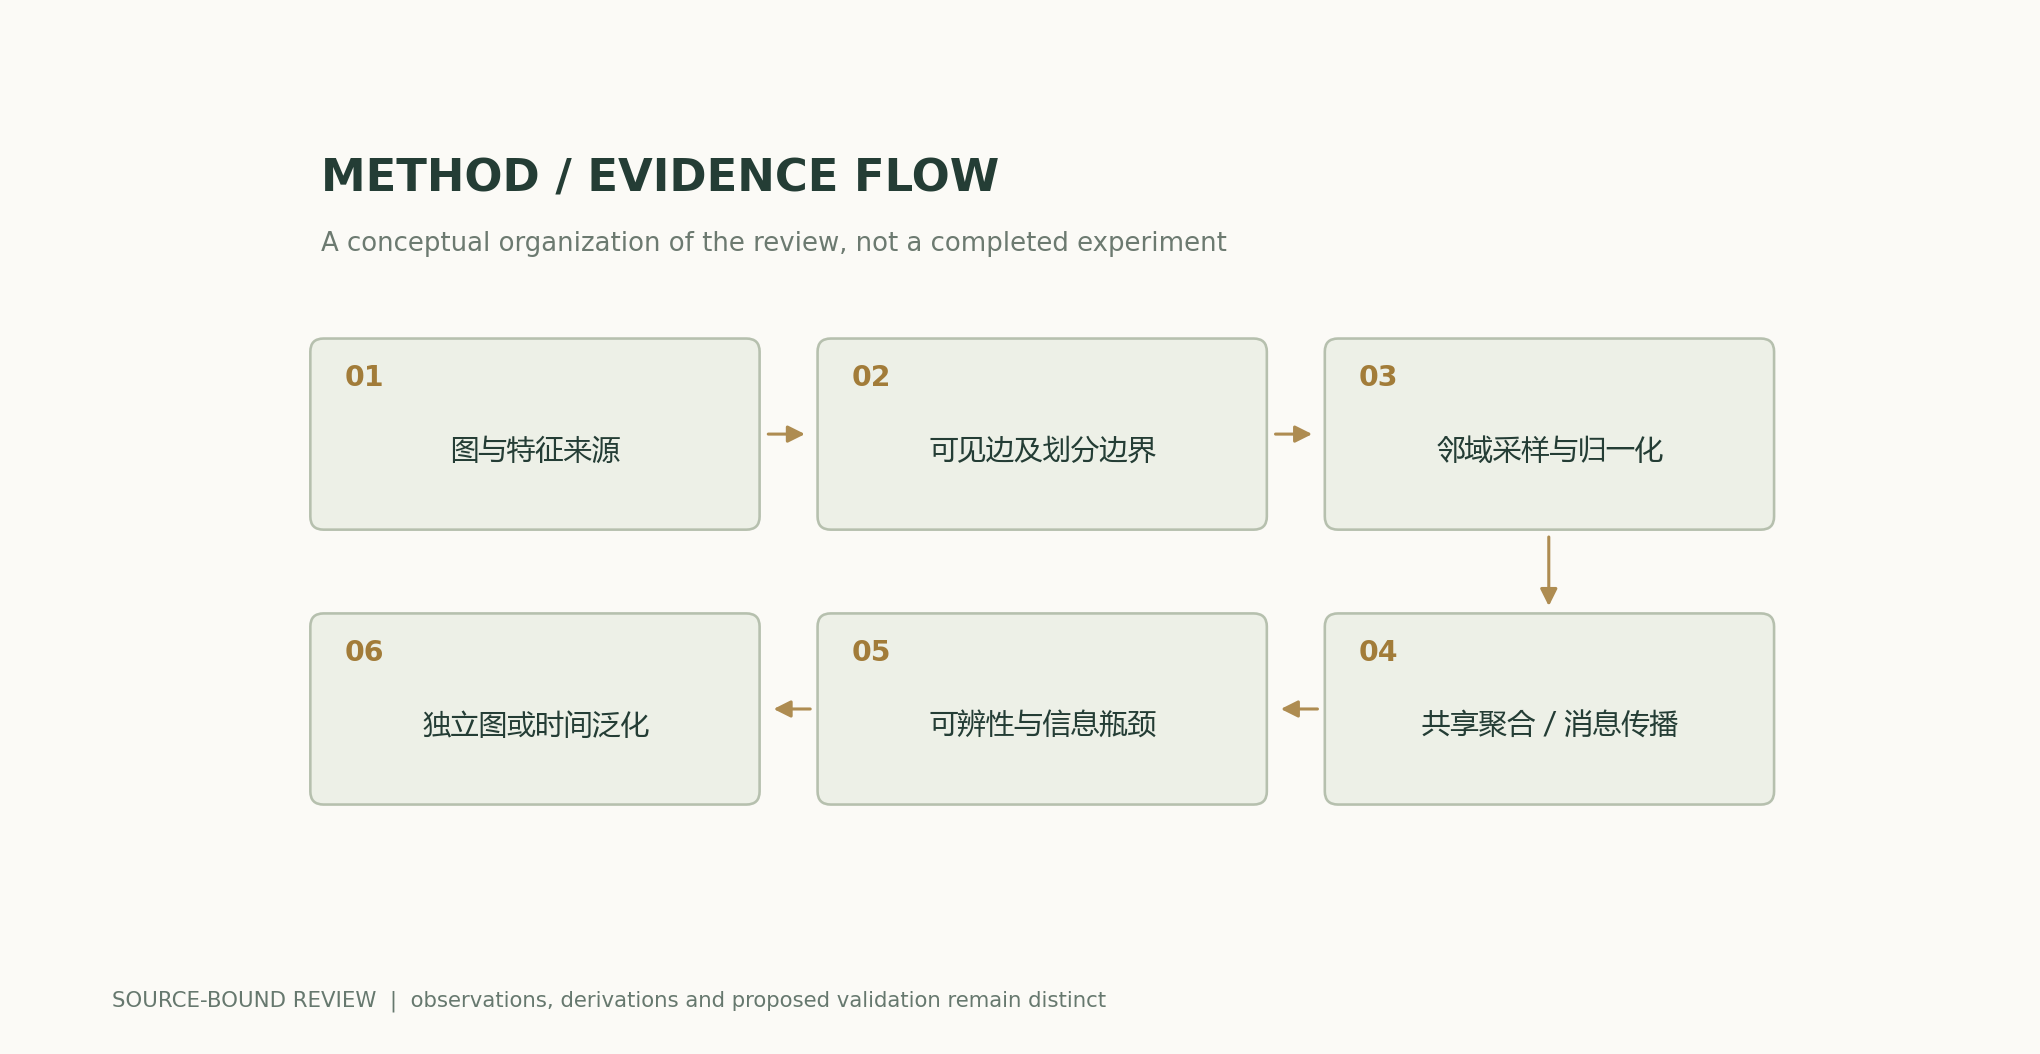
保存图版本、去重、自环、边方向、特征来源及划分,按图家族或时间隔离相关样本。报告多个种子、类别分层及对简单特征基线的增益。大图采样还需测覆盖、通信和内存,并区分采样近似与全邻域结果。本文只计算传播算子,不声称训练了新的图模型或取得基准成绩。[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
数式と導出
(1) GCN式对称归一化示意;方向、权重、自环和度定义应与实现一致。
LaTeX
H^{\prime}=\sigma(\tilde D^{-1/2}\tilde A\tilde D^{-1/2}HW),\quad\tilde A=A+I(2) GIN式求和聚合;可辨性分析有函数类条件,不是实际训练的万能保证。
LaTeX
h_v^{\prime}=\operatorname{MLP}\left((1+\epsilon)h_v+\sum_{u\in N(v)}h_u\right)(3) 本篇图使用六节点路径和这个行随机算子,区别于上面的对称归一化,避免混淆。
LaTeX
x^{(k)}=P^kx^{(0)},\quad P=D^{-1}(A+I)手法と根拠の流れ
解析図と数値例
再計算できる例題
初始总体方差为0.333333,10次该算子传播后约0.012679。非线性、残差和训练权重会改变行为,不能由此推断实际分类质量。
手法の比較
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 归一化传播 | 保存方向、自环与度规则 | 同名架构可能采用不同算子 |
| 均值与求和 | 构造多重集合可辨性对照 | 结构不可辨不靠更多训练解决 |
| 深层传播 | 分测趋同和远程信息需求 | 过平滑与过挤压不可混同 |
| 图划分 | 明确传导/归纳和时间可见性 | 随机节点分割可能泄漏 |
検証プロトコル
- 冻结图、特征来源、边方向、自环与去重版本。
- 明确传导或归纳访问边界,按时间或图家族划分。
- 用重编号和小图手算核对聚合输出。
- 比较简单特征基线、不同聚合器、深度和残差,分离结构因素。
- 使用局部/远程任务与多种子,报告分层质量及失败图。
- 大图下联合测采样覆盖、峰值内存和时间,保留全邻域参考。
適用範囲と限界
- 路径图传播没有训练权重。
- 方差下降不是所有GNN的定理。
- 表达上界不保证优化成功。
- 传导成绩不能自动外推归纳任务。
一次資料と主張の対応
- Semi-Supervised Classification with Graph Convolutional Networks, · 2016-09-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- How Powerful are Graph Neural Networks?, , , · 2018-10-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Inductive Representation Learning on Large Graphs, , · 2017-06-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用とエクスポート
BibTeXRISCSL JSONTXTArticle JSON
著者・版・出典
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
表紙と図の出典 · データ・出典・仮定 · 公開とバージョンの記録
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1