
摘要
图文对比学习等方法能够建立可迁移的跨模态表示,但训练中的配对成功不等于对位置、数量、关系和因果内容都形成同样可靠的表征。本文补充对比损失的温度分析、负样本条件和信息压缩边界,并将检索对齐与密集视觉任务区分。解析图采用人为指定的相似度,只说明目标函数的行为;跨任务判断仍需要控制数据与评价接口的真实实验。[1] An Image is Worth 16x16 Words: Transformers for Image R[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
English abstract
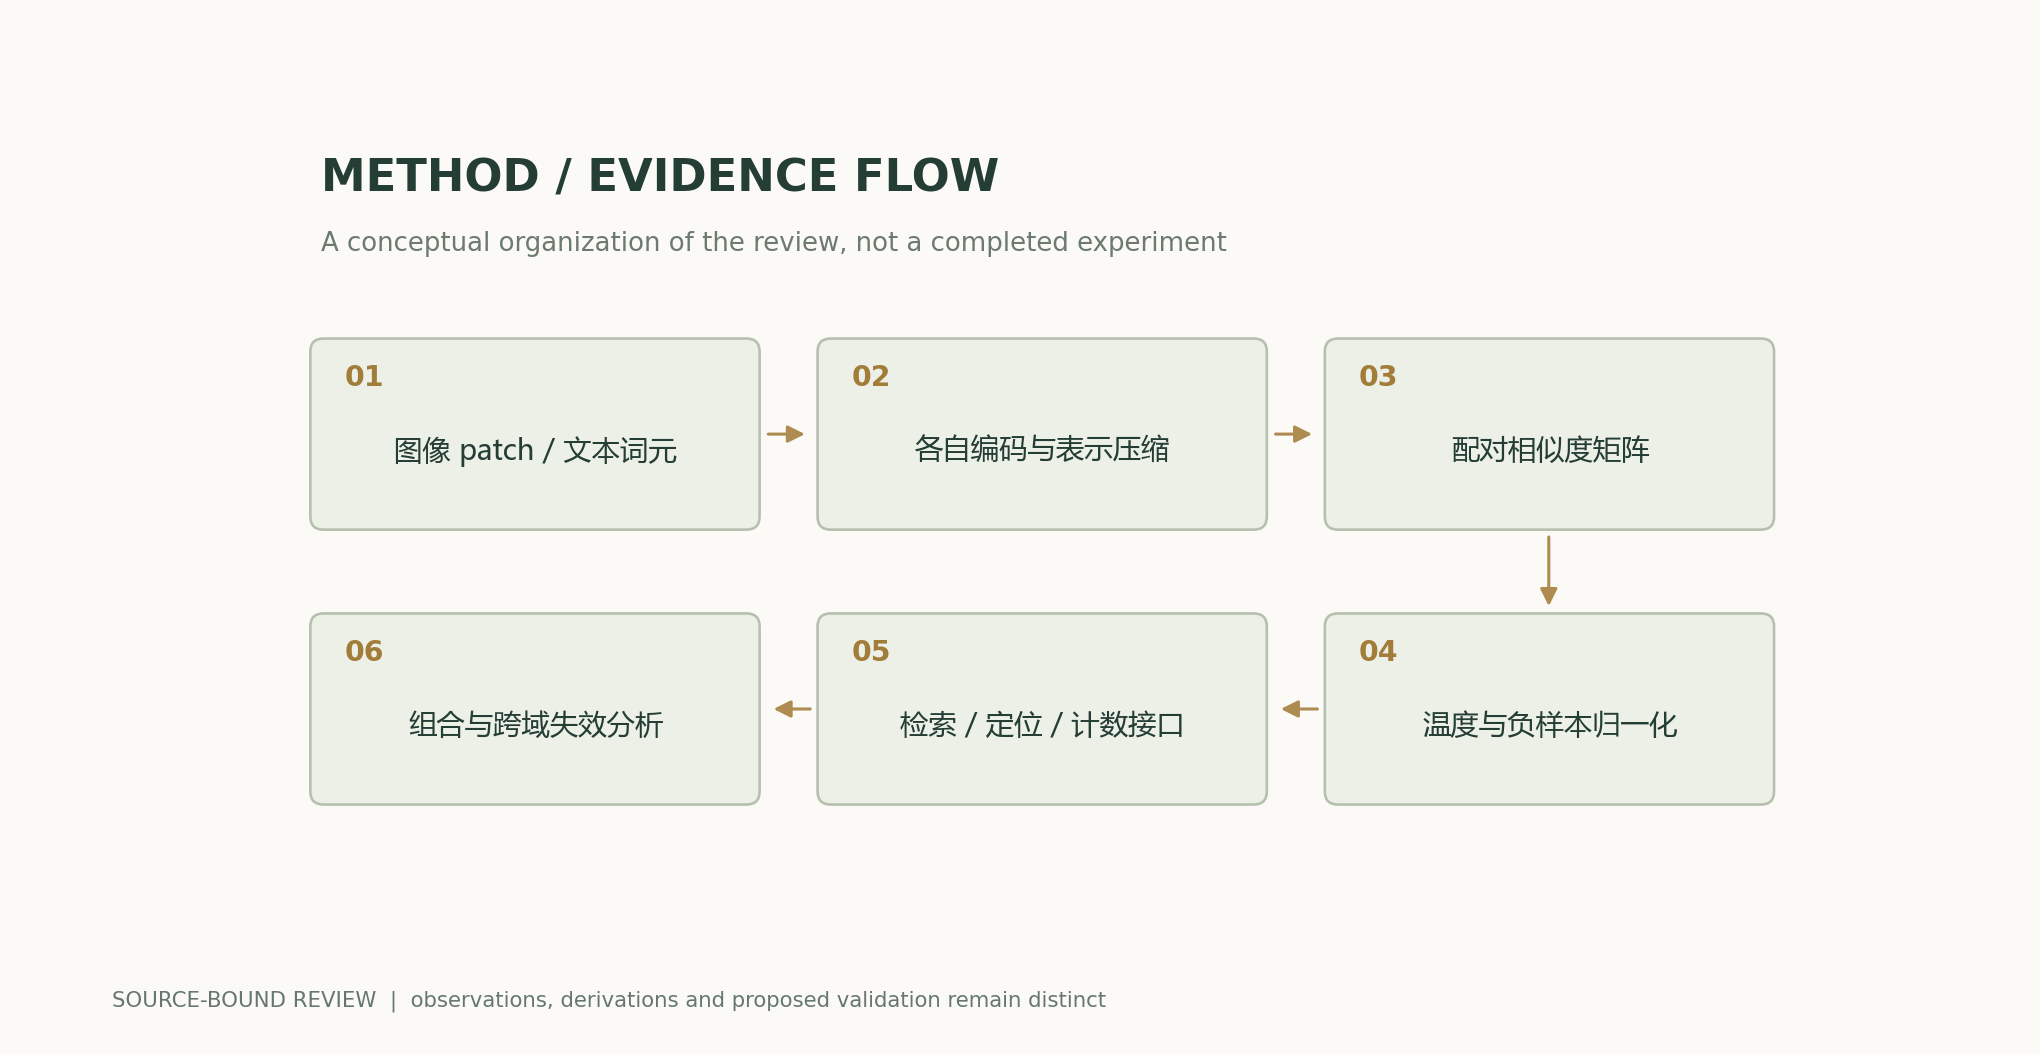
Multimodal representations are studied through their training objectives and task interfaces. A contrastive probability model illustrates how temperature and negatives change discrimination, while an information-bottleneck view separates broad alignment from fine spatial reasoning. The review proposes matched evaluations for retrieval, localization, counting and compositional understanding without treating them as interchangeable measures.
1. ViT 把图像组织为词元序列
ViT 将图像划分为块,映射为向量,再通过 Transformer 处理。论文的重要条件包括大规模预训练与后续迁移,并不等于“任何小数据集上,纯 Transformer 都必然优于卷积”。架构比较应保留预训练数据、增强方式与计算预算;否则数据投入差异会被误写为结构的单独贡献。[1] An Image is Worth 16x16 Words: Transformers for Image R
2. CLIP 用文本改变监督接口
CLIP 在图文配对数据上学习对比表示,把匹配的图像与文本拉近、与不匹配组合区分。论文报告的训练数据规模为 4 亿图文对。推理时,可将候选类别写成文本,用相似度进行零样本分类。这里“零样本”指没有针对该下游分类训练集做相应训练,不代表模型没有接触过相关概念。[2] Learning Transferable Visual Models From Natural Langua
3. 相似度分数取决于候选集合
若候选文本只包含两个类别,模型被迫在这两个描述之间选择,不能据此证明图片里一定属于其中之一。提示措辞、类别粒度和多对象场景会影响使用方式。本文建议同时保留候选文本、图像预处理和拒识规则,并分别评估识别、计数、关系与文字读取;不要用一个分类分数代替所有视觉任务。作者分析与复核建议 / Author analysis
4. Perceiver 用潜变量瓶颈处理输入
Perceiver 使用非对称注意力将高维输入汇聚到较小潜变量集合,再在潜变量中处理。它讨论的是输入规模与内部计算之间的组织关系,与 CLIP 的图文对比目标不是同一个维度。采用瓶颈会带来信息选择问题:重要细节是否保留,需要通过具体任务与分辨率条件检验。[3] Perceiver: General Perception with Iterative Attention
5. 分辨率与分块的解析关系
正方形图像边长H、块边长P且整除时,图像块数为。取,224像素边长产生196块,448产生784块;仅计图像块间完整配对,数量分别为38416与614656,增加16倍。这是另一项计数例子,不对应本版图2的温度曲线;它没有计分类词元、批量或通道,也不是实际FLOPs或显存测量。[1] An Image is Worth 16x16 Words: Transformers for Image R
6. 选择输入预算应遵循任务
读取小字与判断大轮廓,对信息保留的需求不同。本文建议先确定任务需要的最小视觉线索,再比较缩放、裁剪与分块策略。如果把高分辨率图像缩小到无法识别文字,再责备推理模块算错表格,就把输入丢失与推理错误混在了一起。评估中应保留原图与模型实际输入的对应关系。作者分析与复核建议 / Author analysis
7. 跨模态评估要追踪整条链路
一个系统可能使用图像编码器、投影器、语言模型和外部 OCR。应明确每个模块的版本与训练边界,记录哪些信息来自原图、哪些来自工具。若回答含有图中不存在的属性,应检查是感知、文本先验还是生成阶段引入;只有保留模块输入输出,错误才可能被定位。作者分析与复核建议 / Author analysis
对齐表示并不意味着对象逐一对齐
整张图片与一句文字的匹配目标,可以鼓励概念层面的对应,却不必提供像素级定位、对象绑定或完整空间关系。回答“红色物体在蓝色物体左边”需要的证据,与判断图片和“街道”一词相关并不相同。因此,在引用图文对齐研究时,应明确被证明的是哪种迁移任务,避免把相似度能力扩大为所有视觉推理能力。作者分析与复核建议 / Author analysis
8. 对比学习实际优化的是相对区分
对一个图像及一组文本候选,训练目标提高正确配对相对于其他候选的归一化概率。它约束的是批次或候选集合中的相对分数,而不是自然语言描述的全部真实性。若负样本主要在对象类别上不同,模型可以通过粗粒度类别线索完成任务,不必正确编码每个空间关系。因此要检查负样本构造、重复配对和语义近邻,而不能只从训练损失下降推断细粒度组合能力。[2] Learning Transferable Visual Models From Natural Langua
9. 温度改变了哪些样本主导梯度
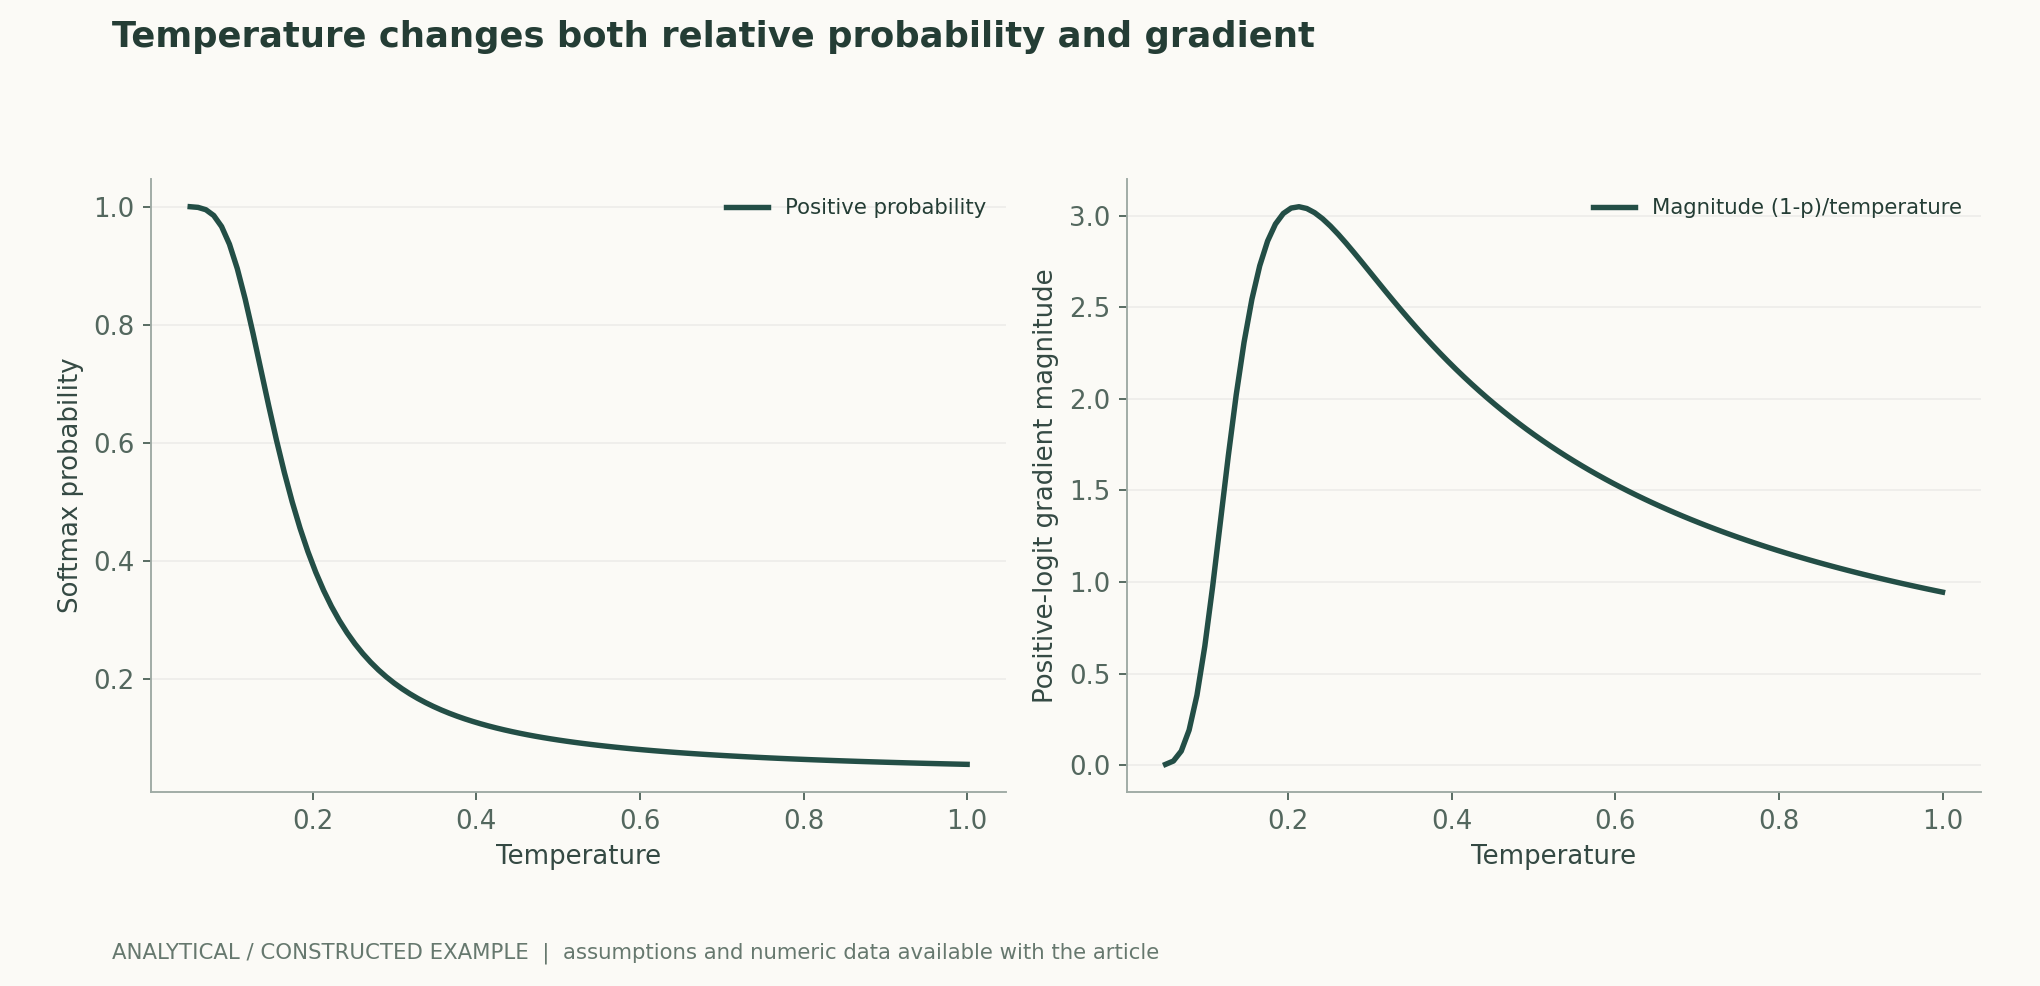
温度较小时,相似度差会被放大,高分负样本对归一化分母和梯度更重要;温度较大则分布更平滑。一个简单算例固定正相似度0.8、31个负相似度0.2,展示概率如何随温度变化。这些数值是教学设定,不是CLIP测量。真实训练中相似度、批量、负样本分布和温度会共同变化,不能用这一单变量曲线解释整个模型的训练动态。[2] Learning Transferable Visual Models From Natural Langua
10. 压缩表示与任务所需信息可能不匹配
把整张图压缩为有限向量,适合比较总体语义,却可能削弱精细位置、局部文字和多个相似对象的区别。视觉Transformer的patch划分与位置表示提供了结构化接口;Perceiver利用较小潜变量集合处理输入,讨论的是另一种计算组织。表示压缩是否损失任务所需信息,应在定位、计数或密集预测上检验。SAM一类可提示分割模型又采用不同目标和输出,不能仅用图文检索成绩比较它们。[1] An Image is Worth 16x16 Words: Transformers for Image R[3] Perceiver: General Perception with Iterative Attention[4] Segment Anything
11. 组合泛化需要系统的反事实对照
若训练里红色物体几乎总与某类背景一起出现,测试时更换背景或交换属性可能暴露捷径。可构造对象不变而颜色、数量、空间关系分别改变的配对任务,并控制文字长度和提示词。检索结果还应保留真实候选集合:在很容易的候选中命中,并不意味着在相似关系描述之间仍能区分。对不同语言和视觉域也应单列结果,避免总体均值隐藏系统性失效。[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
Ecuaciones y derivaciones
(1) s为图文相似度,τ为温度。正确配对概率依赖整个候选集合;候选数或负样本难度变化会改变这个量。
LaTeX
p_i=\frac{\exp(s_{ii}/\tau)}{\sum_j\exp(s_{ij}/\tau)},\qquad\mathcal L_i=-\log p_i(2) 梯度取决于当前概率与温度,而不是只取决于正配对分数。小温度对困难负样本的影响需要结合实际分数分布分析。
LaTeX
\frac{\partial\mathcal L_i}{\partial s_{ij}}=\frac{p_{ij}-\mathbf1\{j=i\}}{\tau}(3) 这是固定相似度的解析例子。它不能预测模型对计数、定位或任意真实数据集的成绩。
LaTeX
p_+=\frac{e^{0.8/\tau}}{e^{0.8/\tau}+31e^{0.2/\tau}}Método y cadena de evidencia
Figuras analíticas
Cálculo reproducible
固定正样本相似度0.8、31个负样本均0.2,温度0.1时正样本概率约0.929,温度1时约0.056。分数被归一化后的变化不证明表示或真实识别能力改变。
Comparación de métodos
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 图文检索 | 固定候选集合、近邻难度和语言 | 总体语义对齐不等于精确定位 |
| 空间与计数任务 | 仅改变一个属性或关系,保留反事实对照 | 类别捷径可能掩盖组合错误 |
| 输入压缩方案 | 比较相同输出任务及信息保留需求 | 较少潜变量不必然保留所有细节 |
| 可提示分割 | 明确点/框提示预算和分割真值 | 密集输出质量不能由检索分数替代 |
Protocolo de verificación
- 固定图像、文本和候选集合的版本,记录许可、重复配对、划分和提示方式。
- 分别评估检索、分类、局部定位、计数和关系判断,避免用单项成绩代表全部多模态理解。
- 在相同对象上只改变一个属性,制作背景与位置反事实对照并由人工核对题目一致性。
- 扫描候选数量与相似负样本难度,保存每个错误对应的候选文本和图像区域。
- 比较计算方案时固定任务接口、输入分辨率和质量目标,分列输入压缩与模型目标变化。
- 单列语言、文化和视觉域的表现,公开失败与无法判定项,不把平均分当作全域保证。
Alcance y limitaciones
- 固定分数曲线不是训练动态或真实模型结果。
- 配对数据相关性不保证语义因果理解。
- 不同多模态任务需要不同输出与真值。
- 没有新增视觉或语言跨域基准。
Fuentes primarias y afirmaciones
- An Image is Worth 16x16 Words: Transformers for Image Recognition at ScaleDosovitskiy et al. · 2020-10-22v2; architecture and scaling experiments
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer
- Perceiver: General Perception with Iterative AttentionJaegle et al. · 2021-03-04v2 abstract; latent bottleneck architecture
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citas y exportaciones
BibTeXRISCSL JSONTXTArticle JSON
Autor, versiones y fuentes
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Autoría, versiones y correcciones · /guides/multimodal-representations/v4/
Procedencia de portadas y figuras · Datos, fuentes y supuestos · Publicación y versiones
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1