
摘要
在线语言模型服务需要同时管理持续增长的KV状态、不同长度请求及设备计算。PagedAttention借鉴分页思想,将逻辑序列映射到非连续物理块,减少为最大长度预留带来的浪费,并支持合适条件下的块共享。本文对比固定预留与分页的确定性字节核算,分析块大小、前缀共享、写时复制和连续批处理之间的折中。图中序列长度均为构造输入,不代表真实流量或服务性能。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Fast Inference from Transformers via Speculative Decodi
English abstract
Paged KV-cache allocation is analyzed independently from attention arithmetic. We compute internal fragmentation for declared sequence lengths and page sizes, distinguish logical sharing from physical lifetime, and describe serving measurements under realistic arrival and output-length distributions. The calculations do not benchmark vLLM or claim a device speedup. Correct reclamation, copy-on-write and cancellation are part of the proposed evaluation.
1. KV是每个活动序列的持续状态
自回归解码要保留历史key与value,其容量随层数、序列长度、KV头数、头维度和精度增长。GQA或MQA会改变KV头数,因此不能只用模型总参数推算缓存。生成长度未知时,若按每个请求的最大长度预留连续空间,短请求会留下大量未使用容量。分页改变的是存储分配与索引组织,并不直接删除注意力需要读取的历史信息,也不改变模型的理论上下文上限。[1] Efficient Memory Management for Large Language Model Se
2. 逻辑块与物理块分离后如何计算碎片
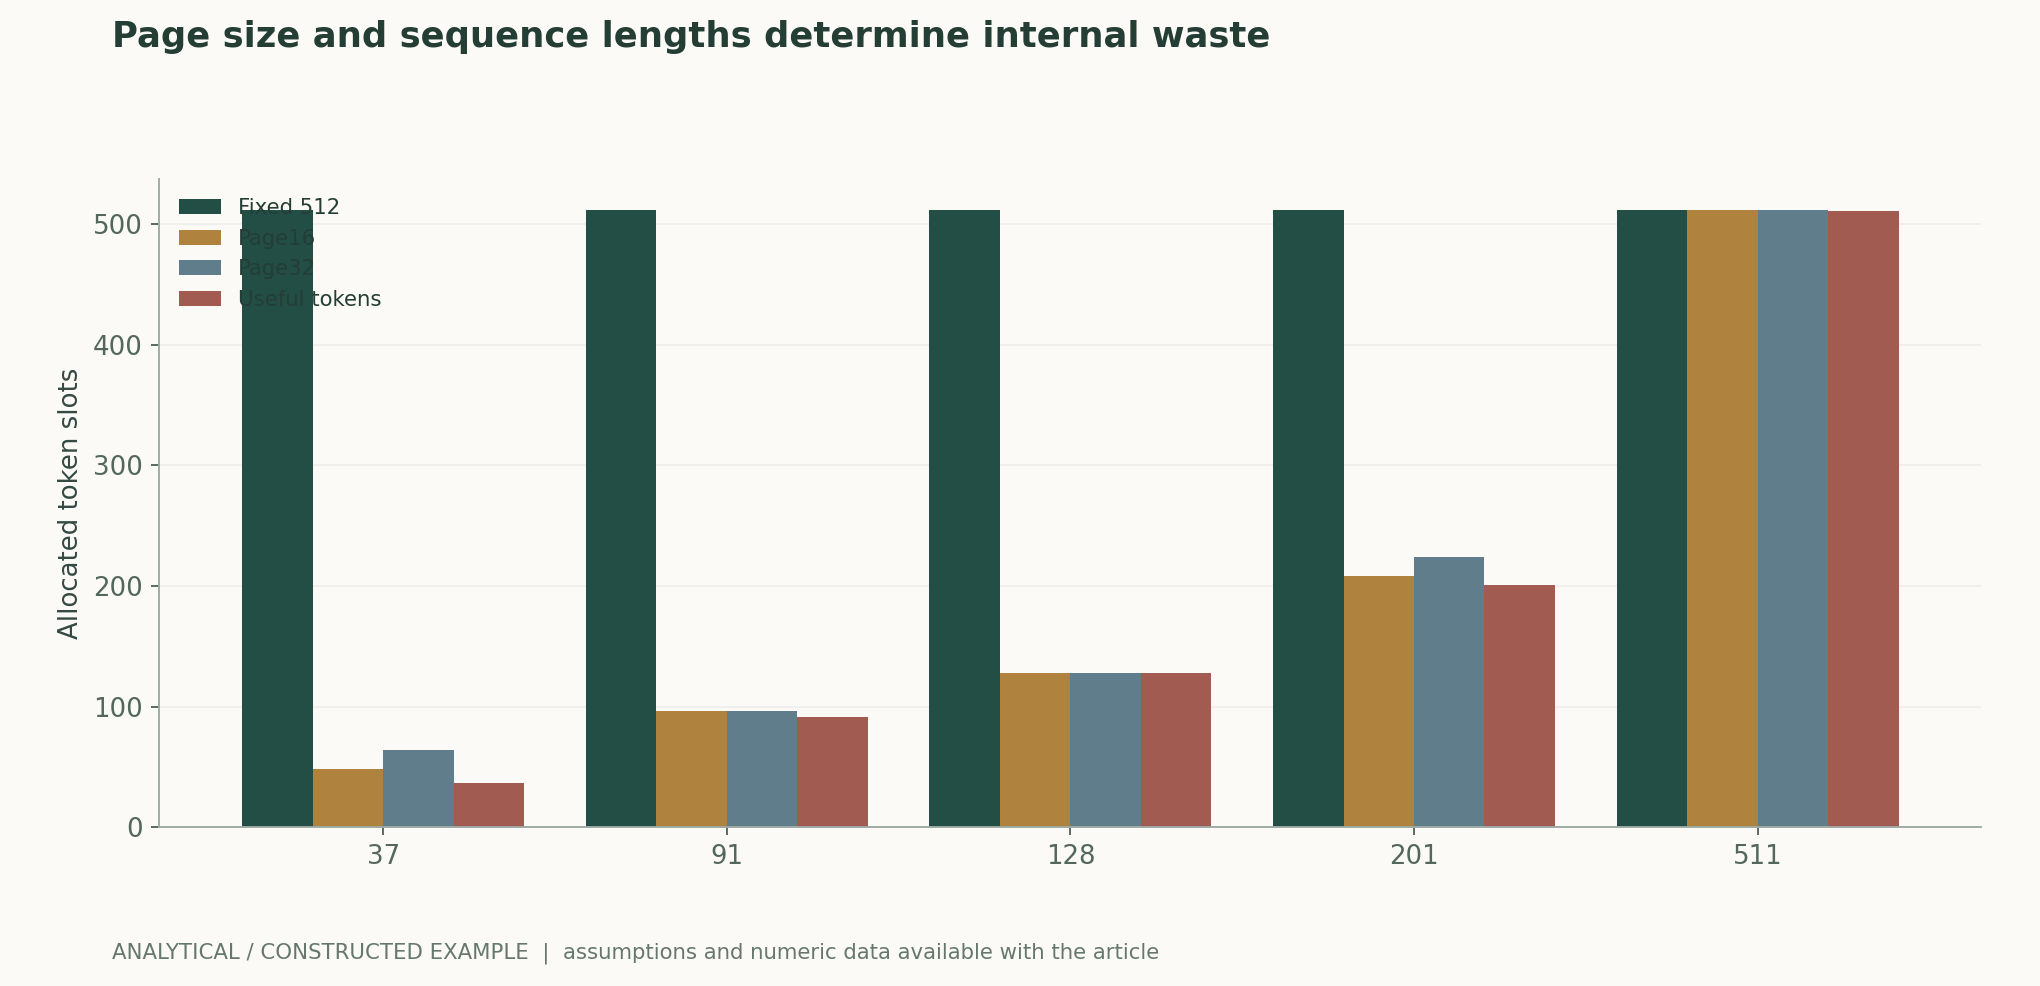
长度n、每块B个token的序列需要ceil(n/B)块,最后一块最多浪费B−1个位置。相比按最大长度M预留,多个请求可以更紧凑地使用同一个块池;收益取决于长度分布而非只取决于B。小块减少尾部浪费,但增加块表、寻址和管理成本。本篇用37、91、128、201、511五个长度比较16与32位置块,精确列出已分配与有效位置;未计设备内核、块表和对齐额外字节。[1] Efficient Memory Management for Large Language Model Se
3. 前缀共享需要严格的内容与寿命条件
具有相同模型、token前缀与相关运行条件的分支,可以在合适实现中共享已计算的物理块。共享计数必须与请求寿命一致;当分支要修改共享的未满块时,写时复制可以防止相互覆盖。取消、超时、重试和分支合并都可能触发回收。若使用不完整的键或过早回收,会把资源优化变成输出错误甚至跨请求数据问题。因此正确性测试应验证内容版本、引用计数和地址不可复用窗口,而非只检查内存减少。[1] Efficient Memory Management for Large Language Model Se
4. 连续批处理改变了请求之间的等待
服务可在每一步加入新请求、移除完成请求,提升设备利用率,但预填充和解码的资源需求不同。长预填充可能延迟正在解码的请求,较大的批量也可能提高吞吐而恶化单请求延迟。应明确调度优先级、抢占与KV迁移规则,报告首token、每token、端到端和尾延迟。若只在所有请求同时到达的离线批量上测量,就无法代表真实到达过程和服务目标。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. 分页与IO优化作用在不同层面
FlashAttention通过块化组织注意力计算,减少高带宽内存与片上存储之间的读写;KV分页关注服务阶段的状态分配和访问。两种机制可以组合,但组合收益需要实际内核支持。推测解码还会产生暂存和回滚的KV位置,进一步影响分配。评估应把算子优化、缓存分配和调度分别消融,避免把整个服务栈的差异归给单个分页算法。[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] Efficient Memory Management for Large Language Model Se[3] Fast Inference from Transformers via Speculative Decodi
6. 合理验收要同时限制质量和服务目标
固定权重与采样后,应首先确认分页、共享和回收没有改变输出语义,再在固定到达分布下比较吞吐与尾延迟。内存利用率应区分有效KV、尾块碎片、块表、工作区及保留池。故障测试还需覆盖OOM、取消和抢占恢复。本文只完成公式核算,不能由碎片减少推导“加速若干倍”;真实收益取决于工作负载、内核、设备和服务目标。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
Equations and derivations
(1) b为每标量字节;乘2对应key和value。不含块表、工作区、padding及其他模型状态。
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{KV}}d_hb(2) A是分配的位置,W是末块内部碎片;固定长度预留则是M−n。
LaTeX
A_B(n)=B\lceil n/B\rceil,\qquad W_B(n)=A_B(n)-n(3) 只计算位置利用率,没有包含块表、共享与调度;不能直接作为设备利用率。
LaTeX
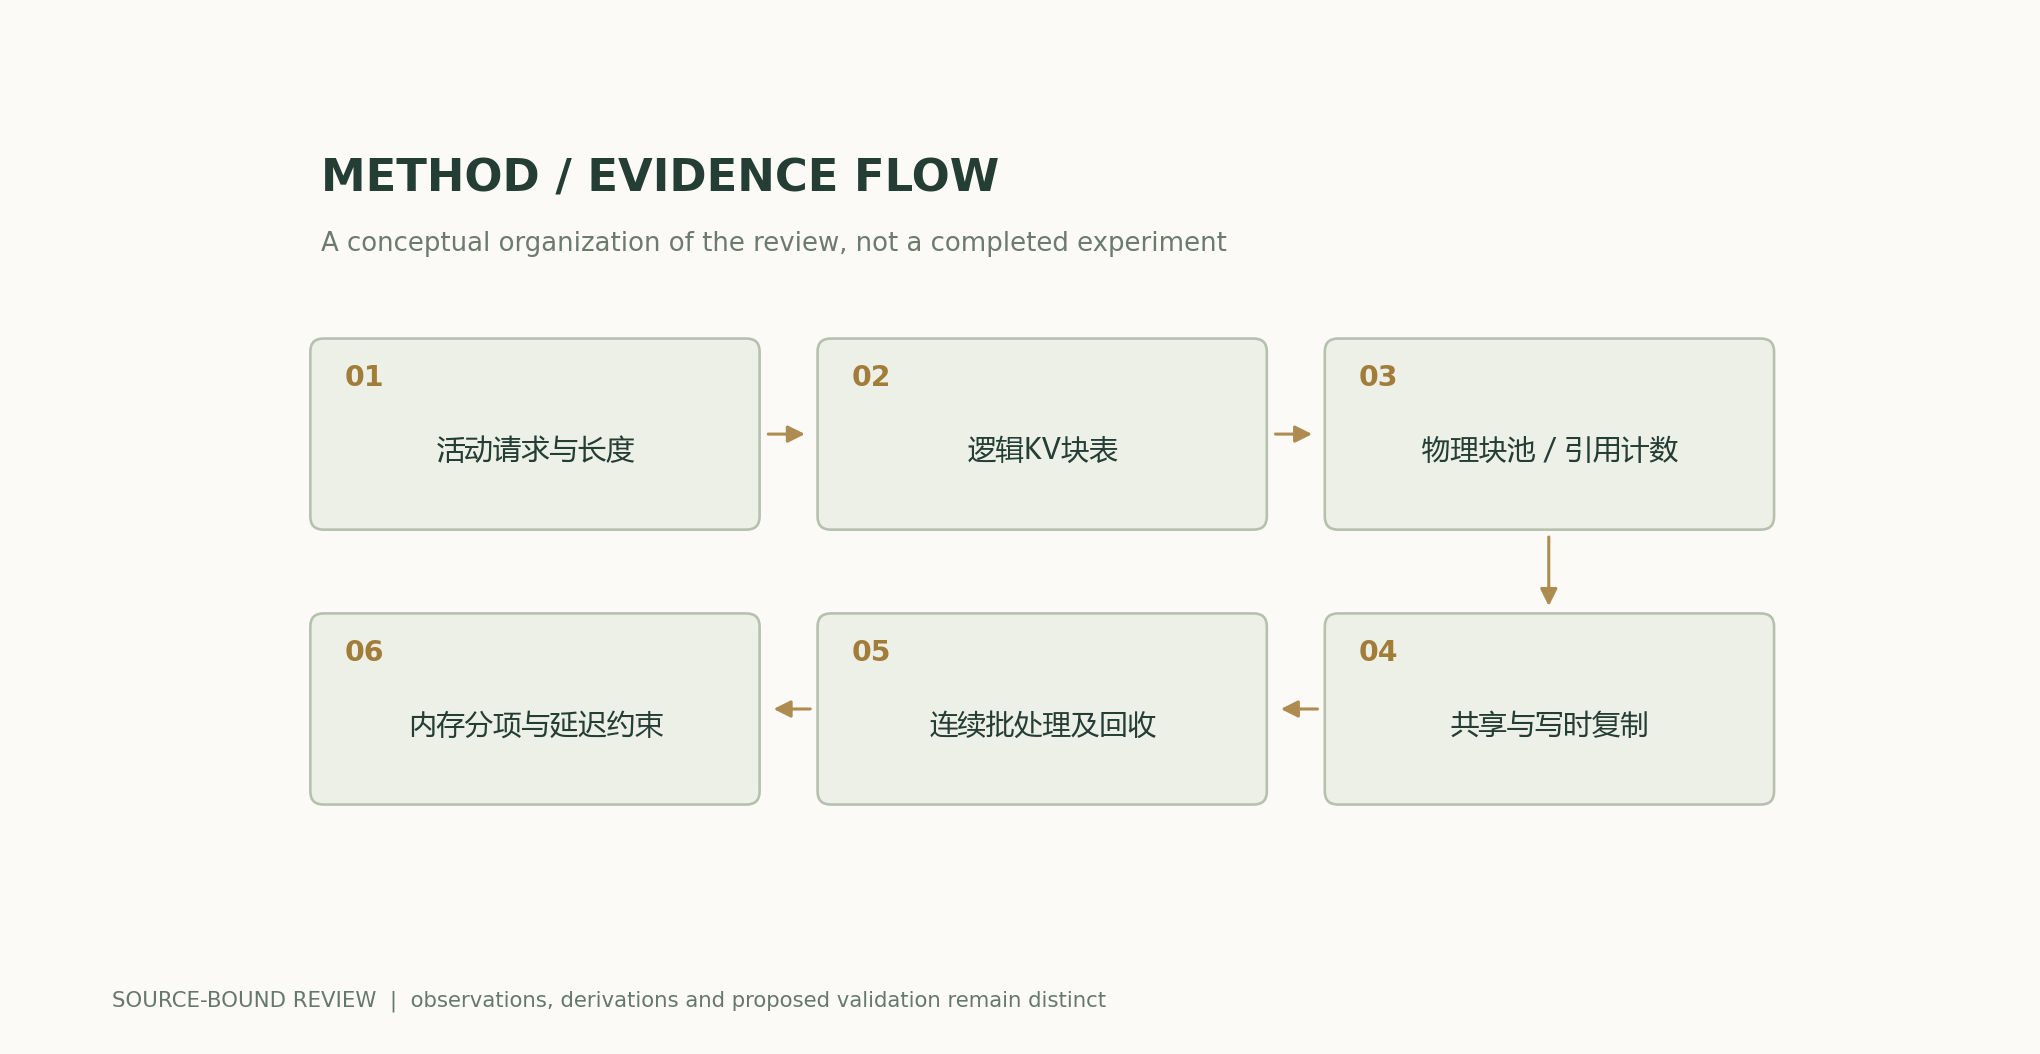
U=\frac{\sum_i n_i}{\sum_i B\lceil n_i/B\rceil}Method and evidence flow
Analytical figures
Worked calculation
五条序列有效位置合计968;固定512预留需2560,16位置分页需992,32位置分页需1024。位置利用率约37.81%、97.58%、94.53%,不是设备利用率或吞吐。
Method comparison
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 固定最大长度预留 | 按相同活动请求集合计数 | 长度差异越大,空闲预留可能越多 |
| KV分页 | 保存块大小、有效位置和块表字节 | 小块减少碎片但增加管理成本 |
| 前缀共享 | 验证模型、token、配置和引用寿命 | 共享键错误或回收过早会改变输出 |
| 在线调度 | 固定到达过程并测尾延迟 | 离线吞吐不能代表服务体验 |
Verification protocol
- 固定权重、KV头数、精度和采样规则,核对连续KV基线输出。
- 保存真实或明确构造的输入/输出长度与到达过程,不混合两类证据。
- 扫描块大小并统计有效KV、末块碎片、块表与保留池。
- 测试共享、写时复制、分支、取消、抢占和回收,检查输出隔离。
- 分别消融算子、分页和调度,记录首token、每token与尾延迟。
- 在相同延迟目标和质量下比较可承载请求,保留OOM与超时样本。
Scope and limitations
- 长度样本为构造输入。
- 位置利用率不等于设备利用率。
- 未进行vLLM或硬件吞吐测试。
- 共享与回收正确性需要实现级验证。
Primary sources and claim mapping
- Efficient Memory Management for Large Language Model Serving with PagedAttention, , , , , , , , · 2023-09-12Abstract; 原文方法、理论和实验章节见作者原始论文链接
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citations and exports
BibTeXRISCSL JSONTXTArticle JSON
Author, versions and sources
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Cover and figure provenance · Data, sources and assumptions · Publication and version record
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1