
摘要
偏好训练能够改变语言模型的回答行为,但训练信号可能只是质量或安全目标的代理。本文在既有RLHF与DPO研究基础上,推导带参考策略约束的理想最优策略,说明偏好对如何连接到策略概率比,并分析奖励改进为何不能自动证明真实效用提升。复核方案将偏好标注、答案长度、抽样与域外行为分开控制;解析图只展示代理目标与真实目标可能分离的构造情形。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is [3] Language Models (Mostly) Know What They Know
English abstract
Preference optimization is examined through the distinction between a learned preference signal and the objective it is meant to approximate. A KL-regularized policy objective explains the reference-model log-ratio used in direct preference optimization. The review identifies length, annotator mixture and selection effects as separate experimental factors and proposes held-out evaluations that cannot be replaced by reward improvement.
1. 人类反馈改变了训练信号
InstructGPT 的研究流程先利用示范进行监督微调,再收集输出排序、学习奖励模型,并以强化学习优化策略。它回答的是“怎样让模型更符合所收集反馈中的意图”。标注者如何选择、提示来自哪里、任务如何覆盖,都会影响目标;不能把某一数据分布的偏好直接描述为所有人的统一价值。[1] Training language models to follow instructions with hu
2. DPO 的简化建立在明确假设上
DPO 在其偏好模型与 KL 约束目标设定下,利用奖励和策略之间的关系,把优化改写为直接基于成对偏好的损失。它省去单独拟合奖励模型和相应的强化学习训练循环,并不等于可以省去偏好数据、参考策略或验证。方法形式更简洁,也不会自动消除错误标注与分布偏差。[2] Direct Preference Optimization: Your Language Model is
3. 参考策略为什么重要
将目标策略与参考策略的相对对数概率进行比较,限制了“提高偏好答案概率”这件事的含义。参考模型提供一个基准,正则强度控制偏离的代价。不同数据、参数与实现会改变实际权衡。本文不把某个超参数值推荐为通用最优值,也不比较未经统一训练条件核对的模型分数。[2] Direct Preference Optimization: Your Language Model is
4. 用损失曲线理解目标,而非宣称效果
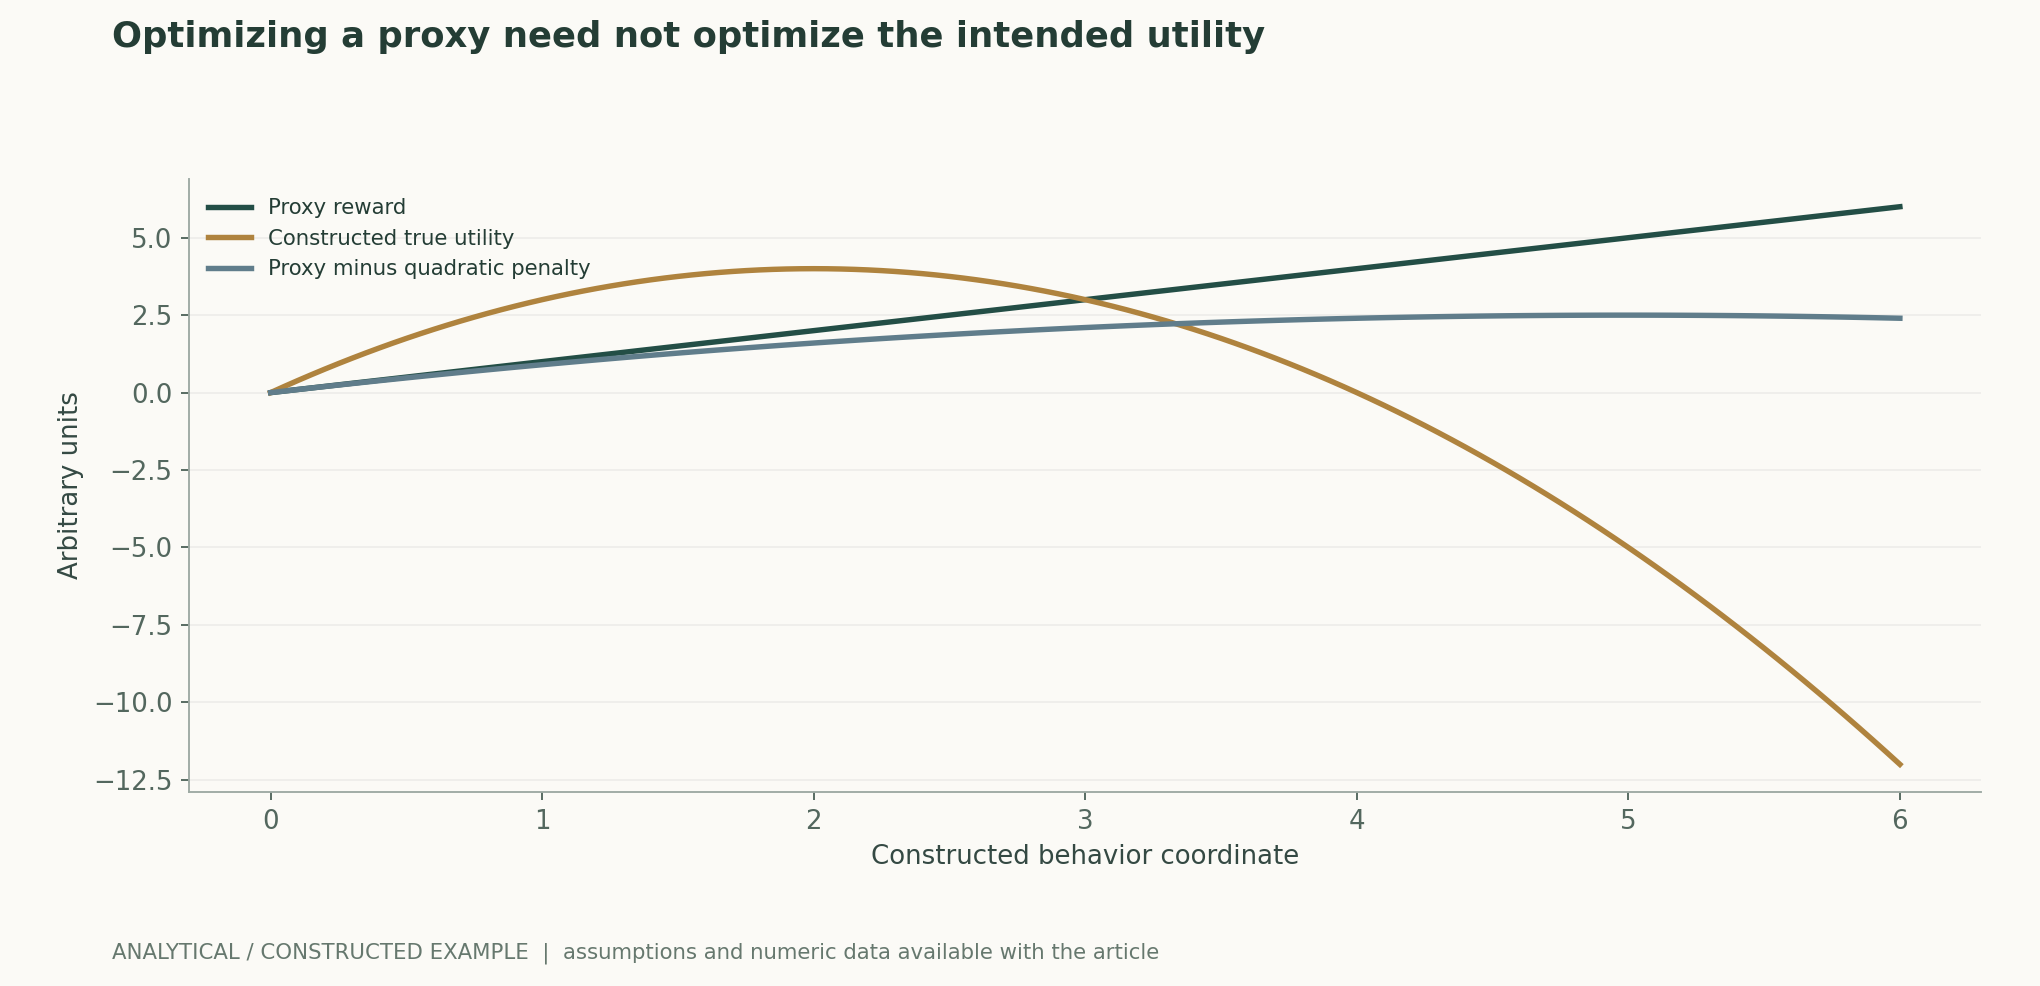
DPO型逻辑损失可写作其中m表示偏好方向的相对对数概率差。m增大时损失下降,但不因此保证回答更真实;若数据奖励讨好或自信表述,优化也可能强化这些特征。本版图2采用独立的代理效用反例,区分代理评分与目标效用;图中没有训练日志或真实偏好测量。[2] Direct Preference Optimization: Your Language Model is
5. 置信与真实正确率也需分别校准
Kadavath 等人研究模型对答案有效性和可回答性的自我评估,在某些任务格式上得到有希望的结果,也记录了跨新任务校准的困难。因此,模型说“我有把握”,仍然需要与真实正确率对照。偏好优化是否改变这种对应关系,应作为独立评估问题,不能从更高偏好胜率直接推出。[3] Language Models (Mostly) Know What They Know
6. 比较两种方法应控制哪些变量
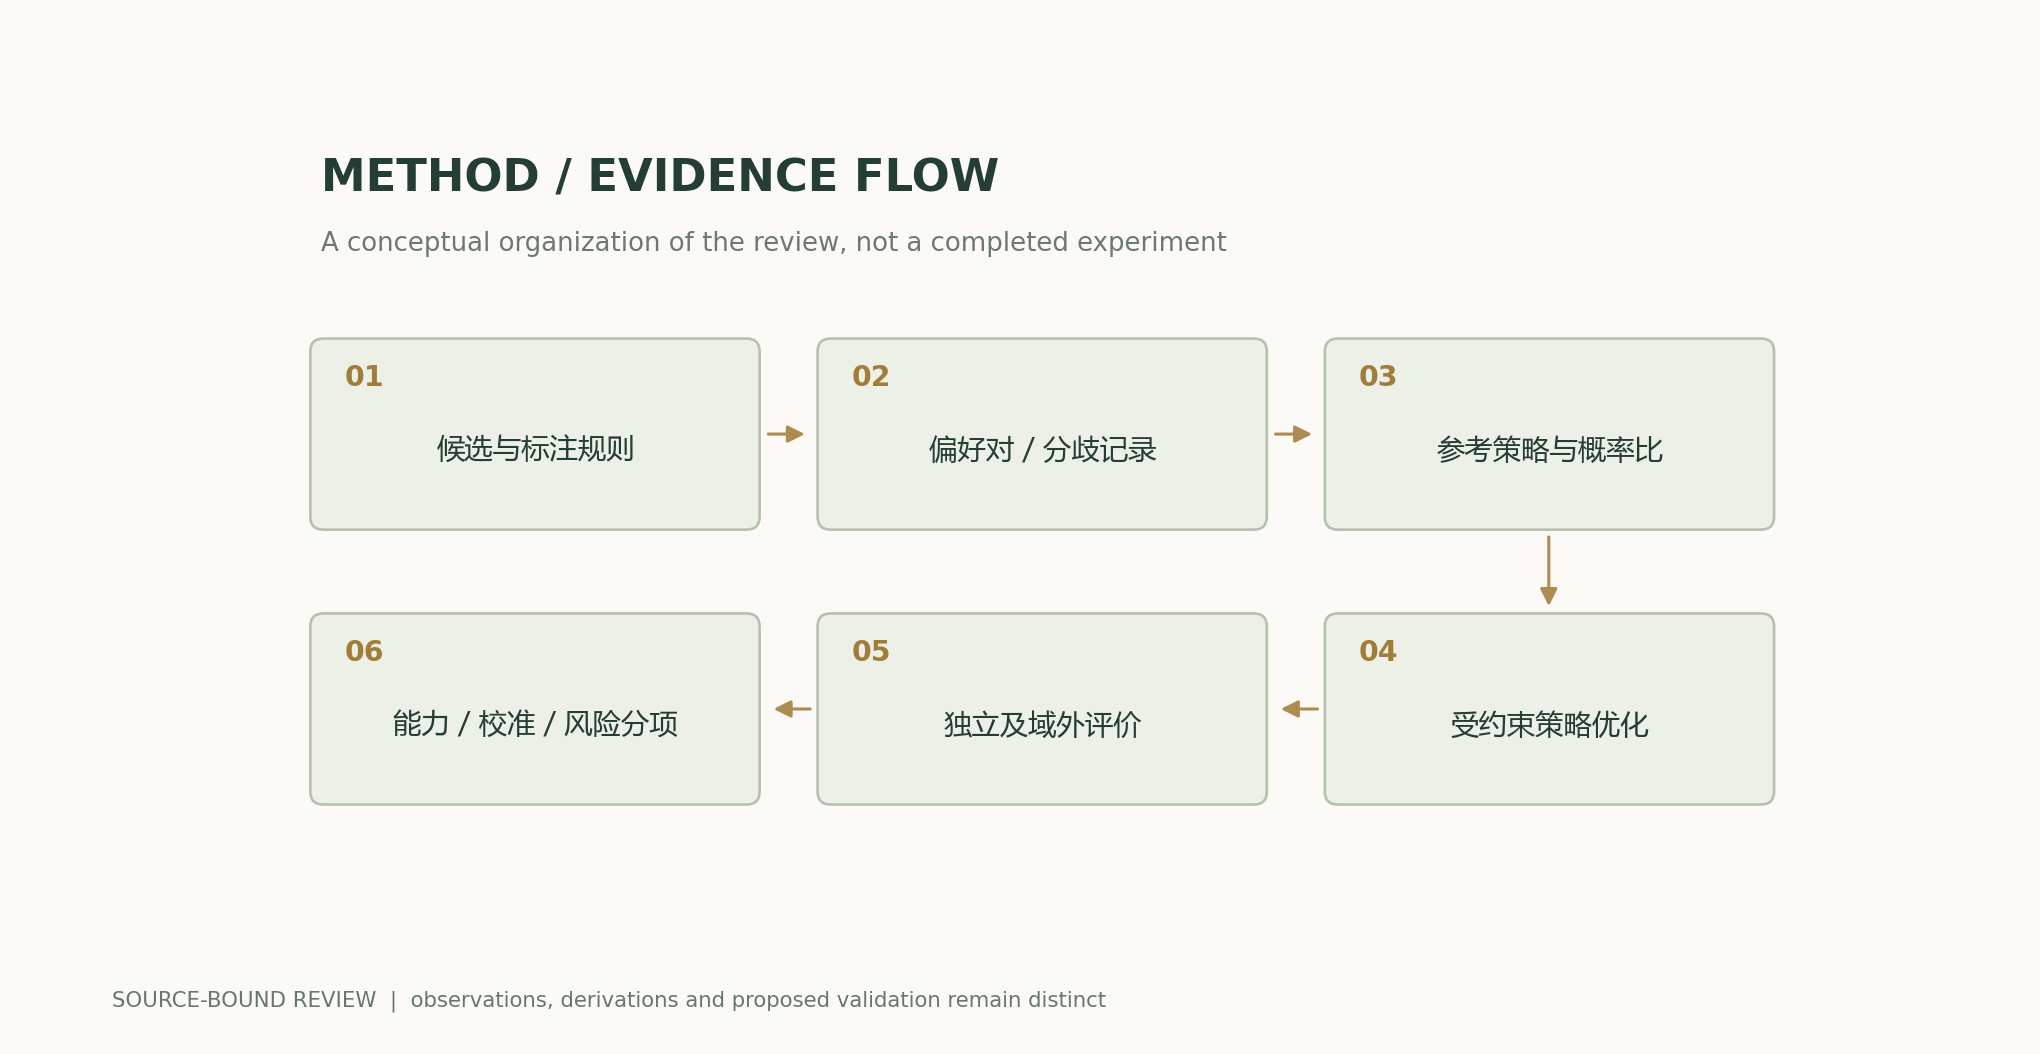
本文建议固定基础模型、数据划分与成对偏好,记录提示格式、参考模型、训练预算、评估者和抽样策略。同时分别测量指令遵循、事实正确性、校准、长度偏差和有害输出。若评估者偏爱更长回答,而两种方法的输出长度明显不同,应报告这一混杂,而不是只给一个总胜率。作者分析与复核建议 / Author analysis
7. 把分歧作为数据而非噪声
对于价值判断或表达风格,标注者可能合理地不同意。保留分歧比例、任务类别与标注指南,有助于理解策略学到了谁的偏好。事实判断则应尽量关联外部证据。把“这是我更喜欢的回答”与“这项陈述已被证据支持”分开记录,可以让后续更正和数据改进有明确对象。作者分析与复核建议 / Author analysis
偏好数据还需要时间与群体语境
某些回答在一个时期、一个地区或一类用户中更受欢迎,但相同排序未必适用于另一情境。数据记录应允许按任务类别与标注群体检查差异,尤其要区分事实纠错、表达风格和价值判断。若训练数据与评估数据由相同偏好模板生成,较高分数可能首先说明匹配了模板,而不是已经验证更广泛的用户效用。作者分析与复核建议 / Author analysis
8. KL约束目标的闭式关系
对固定输入x,在策略分布上最大化期望奖励,同时惩罚相对参考策略的KL散度。用拉格朗日乘子约束概率和为一,可以得到最优策略与参考概率乘 exp(r/β) 成比例。重排后,奖励可以写成策略与参考策略的对数比,再加一个只依赖输入的归一化项。比较同一输入下两个答案时,这一项会抵消。该关系解释DPO目标的理论联系,却依赖固定奖励、支持集和理想优化条件;有限样本与参数化模型不保证达到闭式最优。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
9. 偏好数据并不是没有测量误差的真值
标注者对有帮助、简洁、礼貌、正确和风险的权衡可能不同;偏好对的收集方式又决定哪些答案会进入比较。若一组候选平均更长,偏好模型可能学到长度线索而不是真正的内容质量。应记录标注指南、争议率、候选生成策略与重复样本处理,并保留独立评估集。训练偏好上的胜率属于该分布的结果,不能直接外推到所有语言、任务或人群。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
10. 代理被优化得更高并不总是更好
一旦策略开始适应评估器的可见特征,评分上升可以伴随回答真实性、校准或领域外行为下降。本文的构造曲线只用于说明这种逻辑可能性,不是某个模型出现奖励黑客的实证。可靠测试应更换独立评估方式,加入对事实、拒答边界和不确定性表述的分项观察,并检查奖励分布是否超出训练样本范围。训练评估器同时承担唯一验收器,会让闭环只证明优化了自身评分。[1] Training language models to follow instructions with hu[3] Language Models (Mostly) Know What They Know
11. 参考约束与能力保持需要联合测量
增大或减小约束系数会改变策略远离参考模型的代价,但并不存在对所有任务都适用的单一值。很小的改变也可能影响罕见高风险行为,而整体分布距离较大也不必然对应更差答案。应同时报告原始任务能力、偏好评价、长度与拒答率,并分层查看不同任务的变化。知识蒸馏和偏好训练的目标不同:前者通常匹配教师分布,后者利用相对偏好;不能把同一种损失下降解释成相同的能力迁移。[2] Direct Preference Optimization: Your Language Model is [4] Distilling the Knowledge in a Neural Network
核心公式与推导
(1) β>0控制相对参考策略的偏离代价。奖励r是一个给定的代理;数学优化不证明它等于实际人类效用或安全目标。
LaTeX
\max_\pi\ \mathbb E_{y\sim\pi(\cdot\mid x)}r(x,y)-\beta D_{\mathrm{KL}}\!\left(\pi(\cdot\mid x)\Vert\pi_0(\cdot\mid x)\right)(2) 这是固定输入、固定奖励和合适支持集下的理想最优分布。参数化策略与有限训练数据可能只能近似这一关系。
LaTeX
\pi_\star(y\mid x)=\frac{\pi_0(y\mid x)e^{r(x,y)/\beta}}{Z(x)}(3) y_w与y_l是同一输入下的偏好答案与非偏好答案。目标拟合偏好对,并不单独提供事实正确、校准或风险控制的保证。
LaTeX
\mathcal L_{\rm DPO}=-\log\sigma\!\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_0(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_0(y_l\mid x)}\right]\right)方法与证据流程
解析图与数值示例
可复算例题
构造的真实效用在x=2取最大;代理减惩罚在x=5取最大,此处真实效用反而为−5。它只提供反例,不估计RLHF或DPO的真实退化幅度。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 训练奖励提升 | 独立评估器及域外任务,保留真实输入输出 | 代理评分提高不必然提升实际效用 |
| 偏好胜率比较 | 匹配长度、采样预算、候选与标注指南 | 候选筛选差异会改变胜率 |
| 参考策略约束 | 报告β、分布偏离和原始能力保持 | 整体KL不能定位罕见风险行为 |
| 能力与不确定性 | 分别测事实题、不可回答题和拒答边界 | 礼貌或流畅不能替代真实性 |
复核与实验方案
- 固定参考模型、偏好数据版本与候选生成策略,记录去重、长度分布和标注分歧。
- 划分不重叠的训练偏好、同分布验证与域外验证;同一问题的变体不得跨集合泄漏。
- 扫描约束系数,保存策略与参考模型的对数概率变化,而不只保存最终胜率。
- 在长度与解码预算匹配的条件下,由独立评价方式比较回答,随机化答案顺序。
- 单列事实正确、校准、拒答和基础任务能力,检查总体改善是否掩盖局部退化。
- 对失败样本保留输入、目标版本和判断依据;修改标注或优化方案后重新评价,不能直接继承旧通过状态。
适用范围与局限
- 偏好信号受标注群体和候选分布影响。
- 图中效用曲线是构造例子而非模型实验。
- 闭式推导不等于有限参数模型训练保证。
- 没有新增人类偏好研究或安全认证。
一手来源与主张对应
- Training language models to follow instructions with human feedbackOuyang et al. · 2022-03-04v1; method and limitations
- Direct Preference Optimization: Your Language Model is Secretly a Reward ModelRafailov et al. · 2023-05-29v3; sections 3-5
- Language Models (Mostly) Know What They KnowKadavath et al. · 2022-07-11v4 abstract
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/preference-alignment/v4/
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1