
摘要
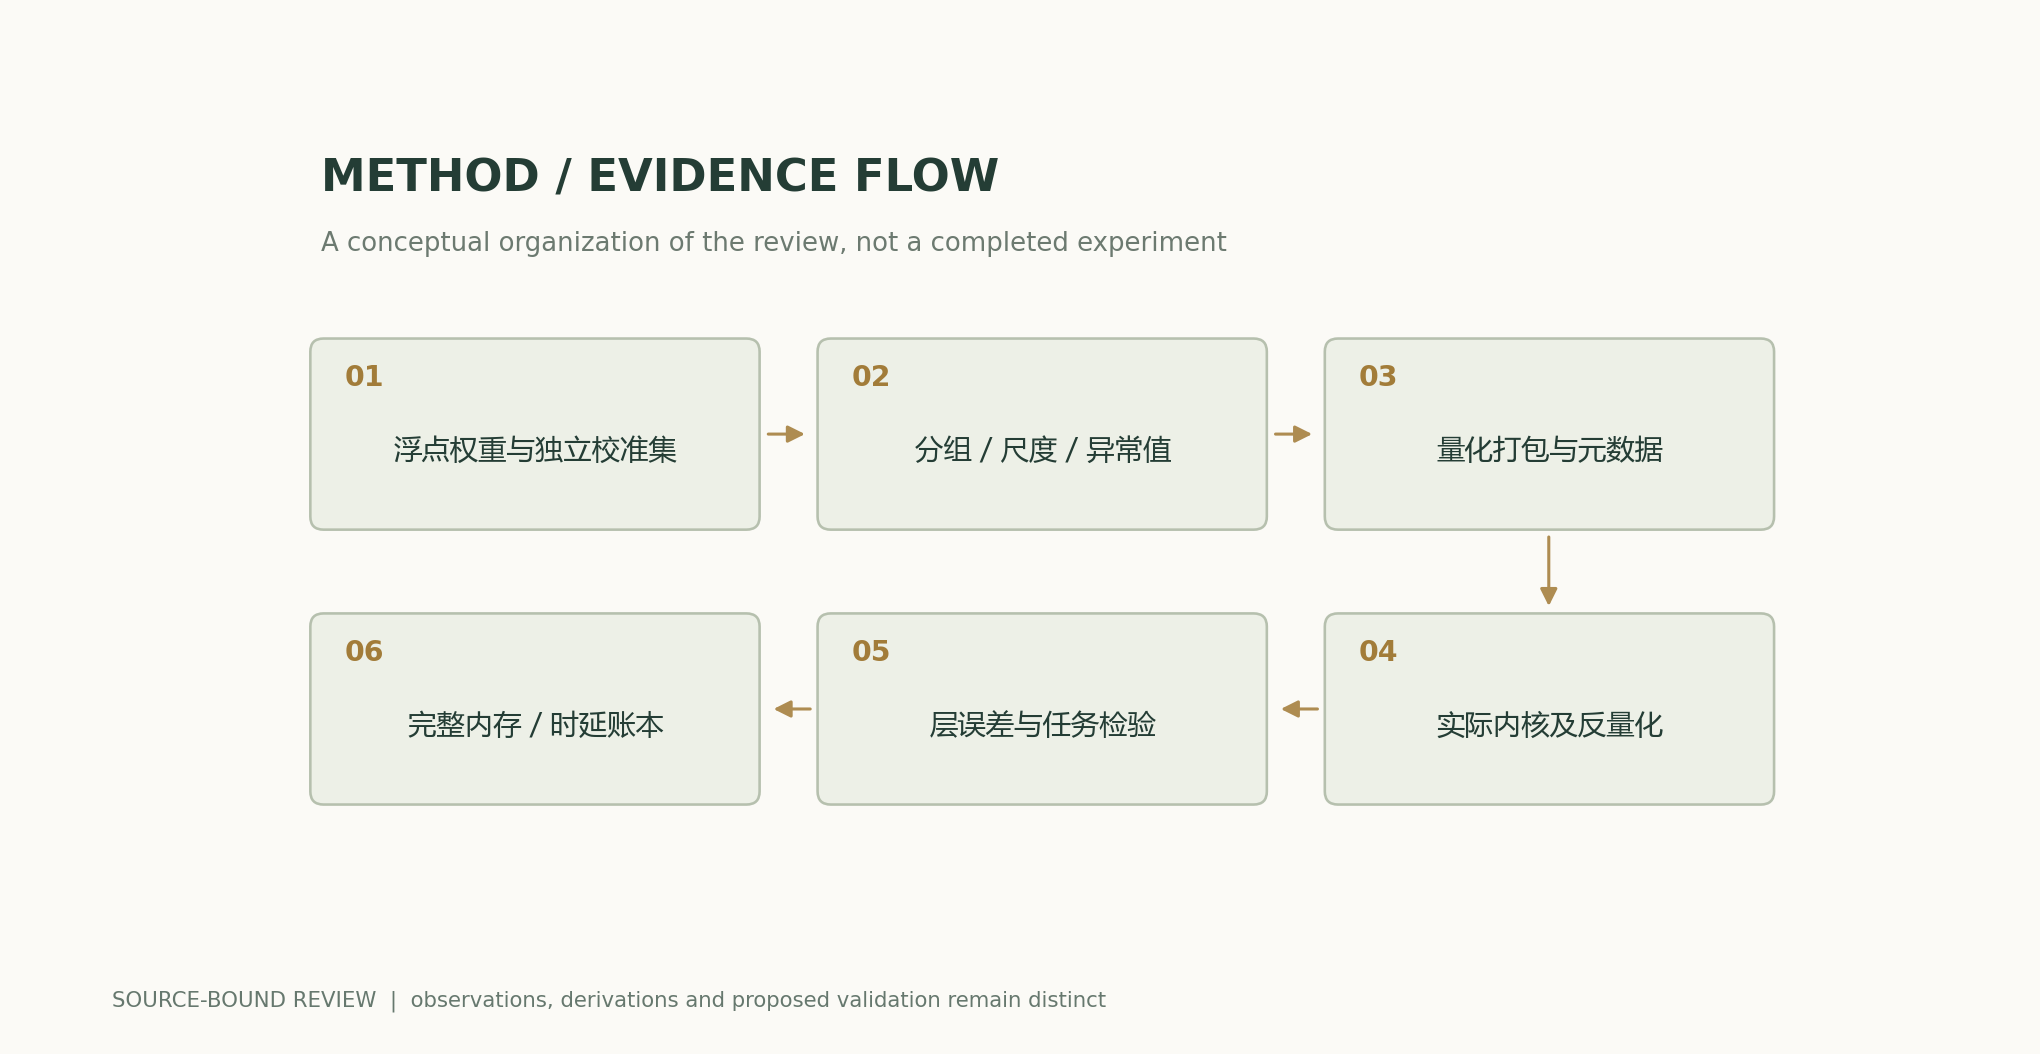
“4位模型”不是一个足以复现实验的完整描述:权重、激活和KV缓存可能采用不同精度,分组尺度、零点与异常值处理也会改变结果。本文从标量量化误差出发,解释为何相同权重误差对模型输出的影响依赖输入分布,进一步讨论GPTQ、AWQ与SmoothQuant所针对的不同环节。配图仅核算原始权重存储和限定假设下的误差,不报告未经测量的加速比或任务质量。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
English abstract
Low-bit inference is analyzed through quantization error, calibration and memory accounting. Weight-only compression, activation quantization and KV-cache precision are distinct interventions. Analytical plots report raw storage and a uniform-error approximation, not measured task accuracy or speed. We describe tests for calibration shift, outliers, metadata overhead and actual device kernels.
1. 一个量化格式包含的不只有位宽
均匀仿射量化把实数映射到有限整数范围,再使用尺度和零点重建。实际格式还需说明有符号范围、分组方向、组大小、尺度精度、舍入规则与截断方法。分组越细,通常越能适应局部数值范围,同时需要更多元数据。相同4位标签因此可能对应不同有效字节数和误差。权重的打包布局与硬件内核也影响能否直接计算;压缩文件小不证明运行时无需反量化缓冲。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
2. 权重误差通过输入协方差放大
在线性层中,权重扰动ΔW造成输出误差ΔWx,其平方期望与输入的二阶统计有关。某些方向的权重误差虽小,却可能因输入在该方向幅度大而产生明显输出变化。GPTQ利用校准输入相关信息近似处理层重建问题;AWQ强调激活感知的权重处理。它们并非证明所有输入上误差都小,而是在给定校准语境中进行近似。评估必须包含校准集之外的长度、任务和语种,检查统计失配。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
3. 激活异常值改变了量化难度
激活中少数大值可能迫使量化范围变宽,使多数普通值的分辨率下降。SmoothQuant通过相邻线性运算的等价缩放,在权重与激活之间迁移量化难度;等价变换本身不消除重新量化误差。应记录缩放参数和校准方式,并检查长输入及异常分布。仅对权重进行低位存储,与同时低位计算激活是不同方案,不能用前者的质量结论证明后者。[3] SmoothQuant: Accurate and Efficient Post-Training Quant
4. 内存节省需要完整分账
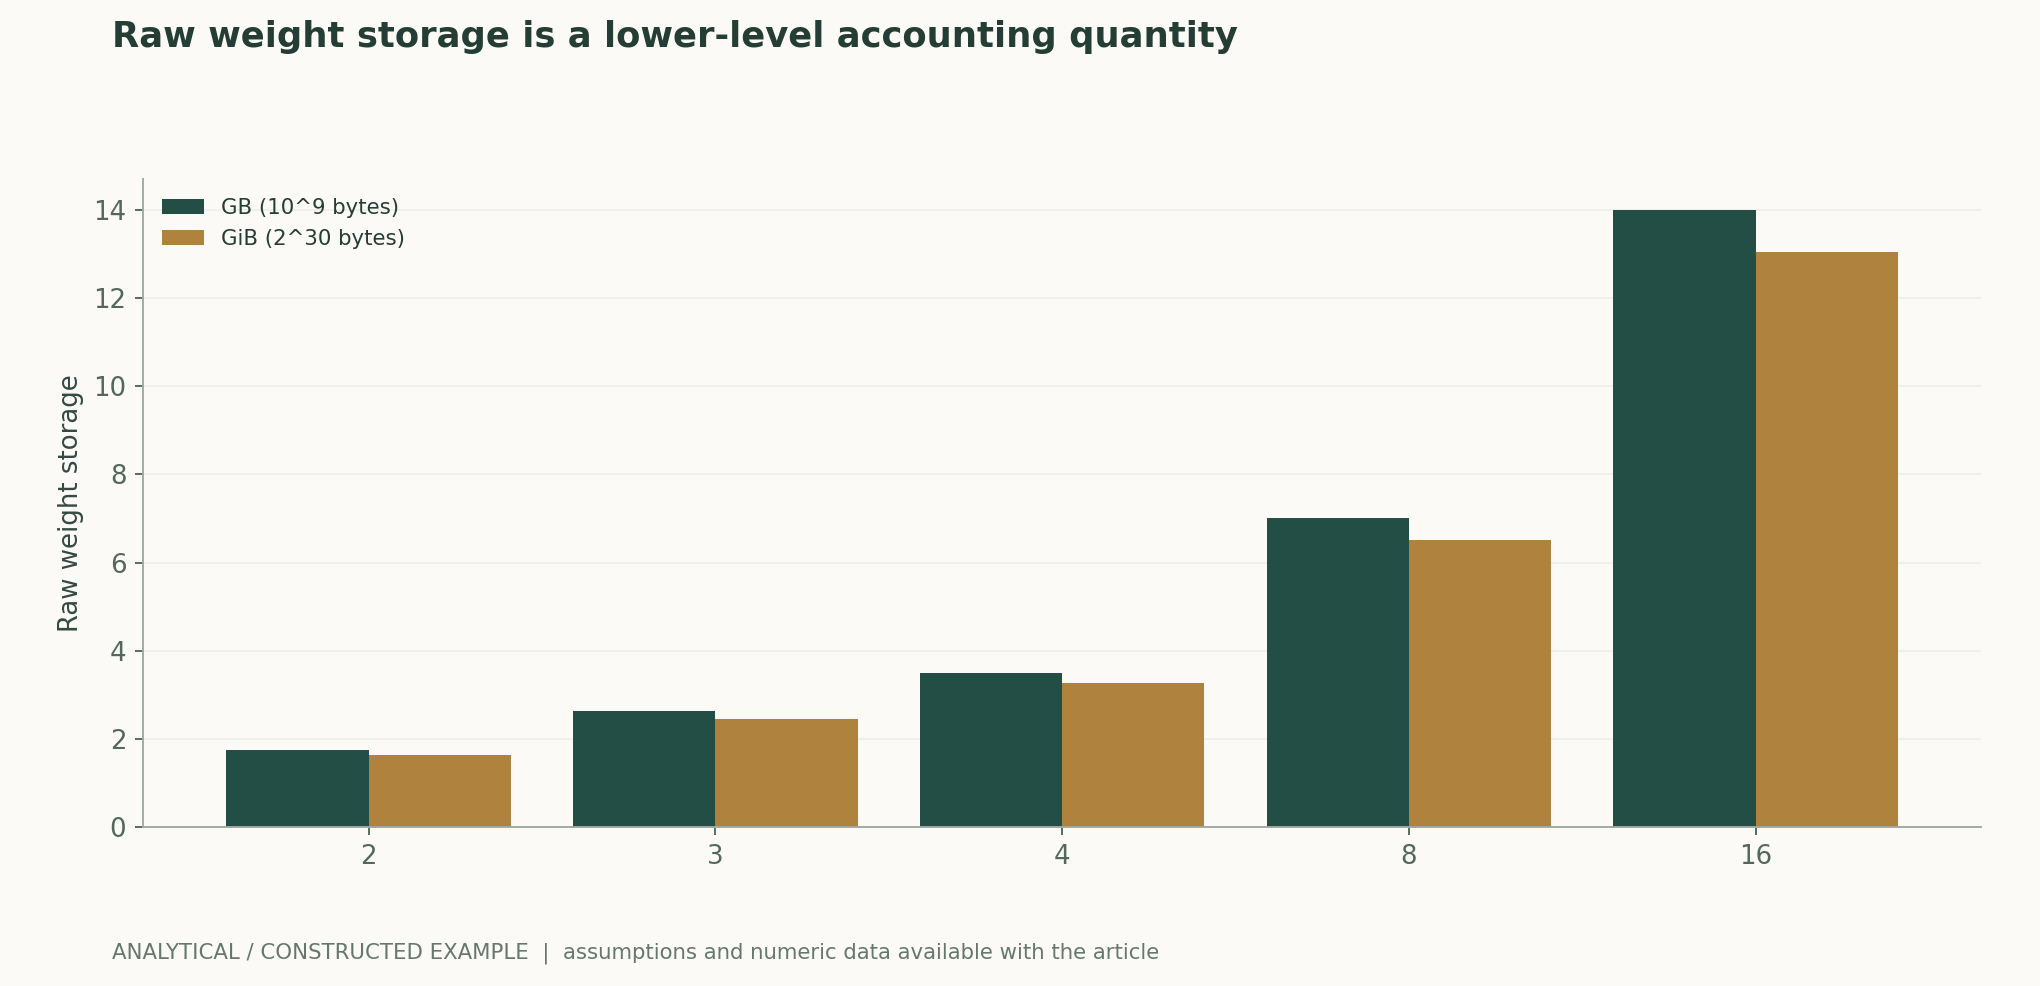
原始权重存储可以由参数数和位宽精确计算,但运行时还包括尺度、零点、未量化层、工作区、激活和KV缓存。长上下文可能让KV成为主导,减少权重位宽后总显存比例也不一定继续按比例降低。图中7B参数只是7×10^9个标量的计数示例;GB与GiB分别报告,避免单位混淆。任何峰值内存结论仍需在真实设备和批量条件下测量。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
5. 校准与验证必须严格分离
校准样本用于选择尺度或近似输入统计,验证样本用于估计未见分布的质量。若不断根据测试集调整组大小和异常值阈值,就已经把测试集用于开发。建议冻结一份独立校准集,预先规定任务和长度分层,保存失败样例及浮点基线输出。对安全或事实性任务,还应检查低频错误,而非只比较一个平均困惑度。多个量化配置筛选后的最终报告应说明搜索预算。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
6. 速度收益依赖可执行内核
低位存储可能缓解带宽压力,却也可能增加解包、反量化和格式转换成本。小批量解码、大批量预填充和不同硬件的瓶颈不同,速度排序可能变化。实验应拆分加载、预填充、逐token解码和端到端延迟,并保存批量、长度、精度及内核版本。本文的字节核算只能说明存储下界,均匀噪声近似只能解释分辨率;二者均不能替代设备实测或任务质量检查。[1] GPTQ: Accurate Post-Training Quantization for Generativ[3] SmoothQuant: Accurate and Efficient Post-Training Quant
Ecuaciones y derivaciones
(1) s是尺度,z是零点;分组、舍入和截断规则必须显式说明。
LaTeX
\hat w=s\left[\operatorname{clip}(\operatorname{round}(w/s)+z,q_{\min},q_{\max})-z\right](2) 固定权重误差时的精确二阶关系,说明输入统计会改变输出误差。
LaTeX
\mathbb E\|\Delta W x\|_2^2=\operatorname{tr}(\Delta W\,\mathbb E[xx^\top]\,\Delta W^\top)(3) 第一式不含元数据;第二式需要未饱和、误差近似均匀等假设,不能套用于任意模型权重。
LaTeX
M_{\mathrm{raw}}=Nb/8,\qquad \operatorname{Var}(e)\approx\Delta^2/12Método y cadena de evidencia
Figuras analíticas
Cálculo reproducible
7×10^9个权重按4位理想打包为3.5 GB,约3.260 GiB。分组尺度、未量化层、KV及工作区尚未计入,不能称为完整部署显存。
Comparación de métodos
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 权重量化 | 说明分组、尺度、未量化层和布局 | 文件大小不等于运行峰值显存 |
| 激活量化 | 独立测异常值与校准分布变化 | 权重低位结果不能外推到激活 |
| 误差估计 | 同时测层重建与任务质量 | 平均权重MSE忽略输入方向 |
| 性能测量 | 固定硬件、内核、批量和长度 | 字节数下降不保证等比例加速 |
Protocolo de verificación
- 冻结浮点基线、分词器和独立校准/验证划分,记录来源与哈希。
- 完整记录权重、激活、KV精度和分组参数,列出所有浮点保留层。
- 统计实际文件字节、尺度元数据、反量化工作区与设备峰值内存。
- 分别测层输出误差、困惑度、任务成功和低频失败,不以一种指标替代全部。
- 在不同长度、语种及输入分布下检验校准迁移,保存最差分层。
- 在固定内核和硬件上独立重复预填充/解码计时,报告质量约束下的收益。
Alcance y limitaciones
- 没有真实模型量化或设备加速实测。
- 均匀误差近似不适用于任意权重分布。
- 原始权重字节不包含KV和工作区。
- 校准集外质量需单独验证。
Fuentes primarias y afirmaciones
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, , , · 2022-10-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, , , , , , , , , · 2023-06-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, , , , , · 2022-11-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citas y exportaciones
BibTeXRISCSL JSONTXTArticle JSON
Autor, versiones y fuentes
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Procedencia de portadas y figuras · Datos, fuentes y supuestos · Publicación y versiones
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1