
摘要
检索增强生成提供了一条将模型输出连接到外部材料的技术路径,但存在检索并未覆盖关键证据、证据相互冲突、回答未受材料约束以及引用不能支持结论等多种失效。本文沿着检索、上下文组织、生成和归因四个阶段讨论这些问题,将整体成功率分解为可单独干预的条件事件,并给出带金标准证据、干扰证据和位置扰动的复核方案。新增解析例子用于解释误差传播,不是对任何当前产品准确率的测量。[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
English abstract
Retrieval-augmented generation is analyzed as a chain of conditional events rather than an automatic factuality guarantee. The review separates candidate coverage, evidence sufficiency, answer consistency and citation attribution; derives an explicit success decomposition; and designs controlled interventions that isolate retrieval failure from generation failure. The numerical plots use declared probability assumptions, not measured retrieval benchmarks.
1. 参数记忆与外部文档如何分工
Lewis 等人的 RAG 研究把生成模型与可检索的非参数文档存储结合。RAG-Sequence 和 RAG-Token 对检索文档如何参与生成采用不同建模方式。这个机制允许模型利用外部文本,但检索库的内容、覆盖范围和版本仍决定可用证据的边界;模型并不会因接入检索而自动获得完整世界知识。[1] Retrieval-Augmented Generation for Knowledge-Intensive
2. DPR 优化的是检索环节
DPR 用双编码器将问题与段落表示为向量,并按相似度寻找候选文本。它使检索不只依赖字面匹配,但向量相近也可能只是主题接近。系统仍需区分:段落提到了同一个实体,还是确实回答了同一问题;内容在语义上相关,还是在时间、地区与条件上适用。[2] Dense Passage Retrieval for Open-Domain Question Answer
3. 怎样诚实地重绘论文结果
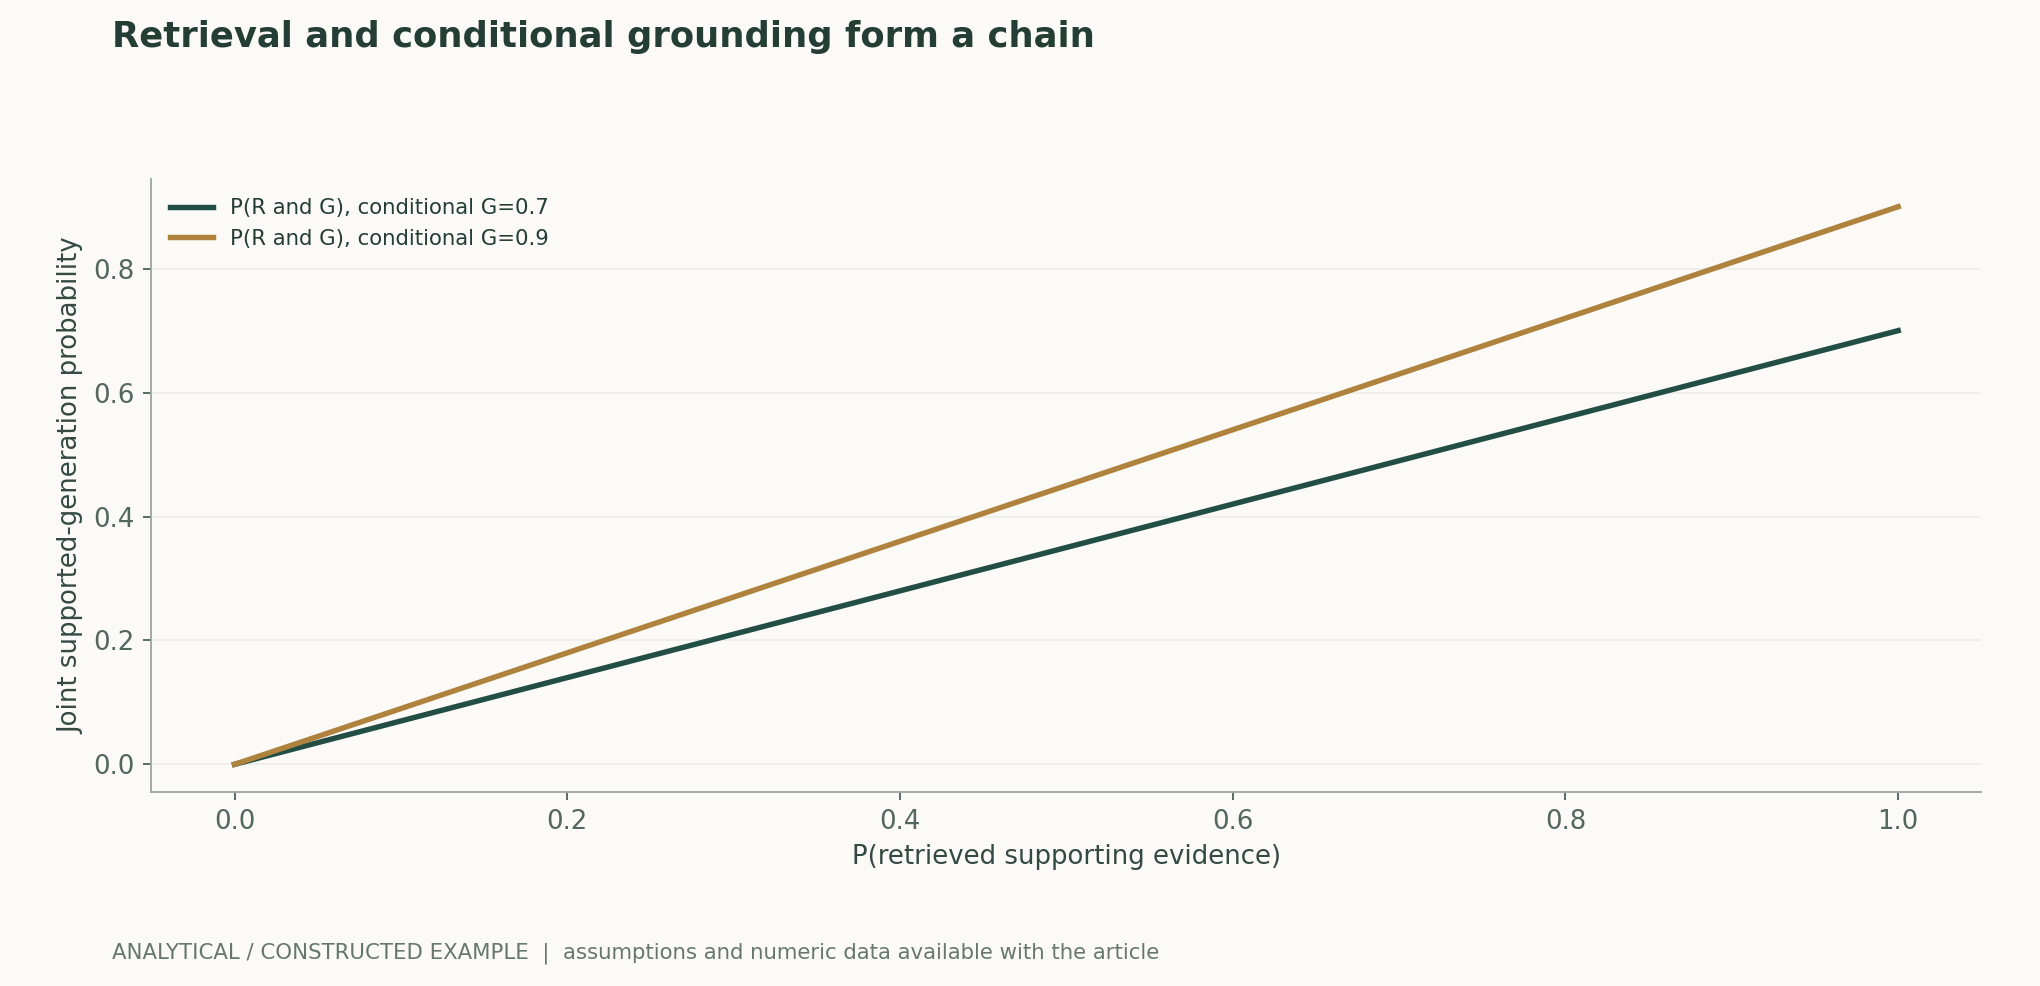
RAG原文表1在Natural Questions测试中报告DPR、RAG-Token、RAG-Sequence的exact match为41.5、44.1、44.5。这是同一历史表格中所列系统的比较,训练与组件差异同时存在,不能把分数差全部归给单个模块的因果收益。旧版曾重绘该表;本版图2改为支持证据链的解析计算,不再把这三个历史分数画作当前实验。[1] Retrieval-Augmented Generation for Knowledge-Intensive
4. 把证据放进上下文仍会失败
Lost in the Middle 在多文档问答与键值检索任务中观察到,相关信息的位置会影响被研究模型的表现。该发现提醒我们,输入窗口能装下文档,与模型能稳定利用每处信息,是两回事。它并没有证明之后所有模型都以相同幅度退化;新的模型、提示与任务需要重新测量。[3] Lost in the Middle: How Language Models Use Long Contex
5. 引用链接与逻辑支持要分开验
一条回答可能把正确链接放在错误结论后面,也可能把限定条件较窄的结果扩展到所有情况。本文建议为每个关键事实保存“主张—证据片段位置—来源版本”的映射,并检查证据是否真正蕴含结论。对于比较、日期和数字,应核对分母、单位与适用条件;对于推断,应在正文显式标为分析。作者分析与复核建议 / Author analysis
6. 一个可执行的评估拆分
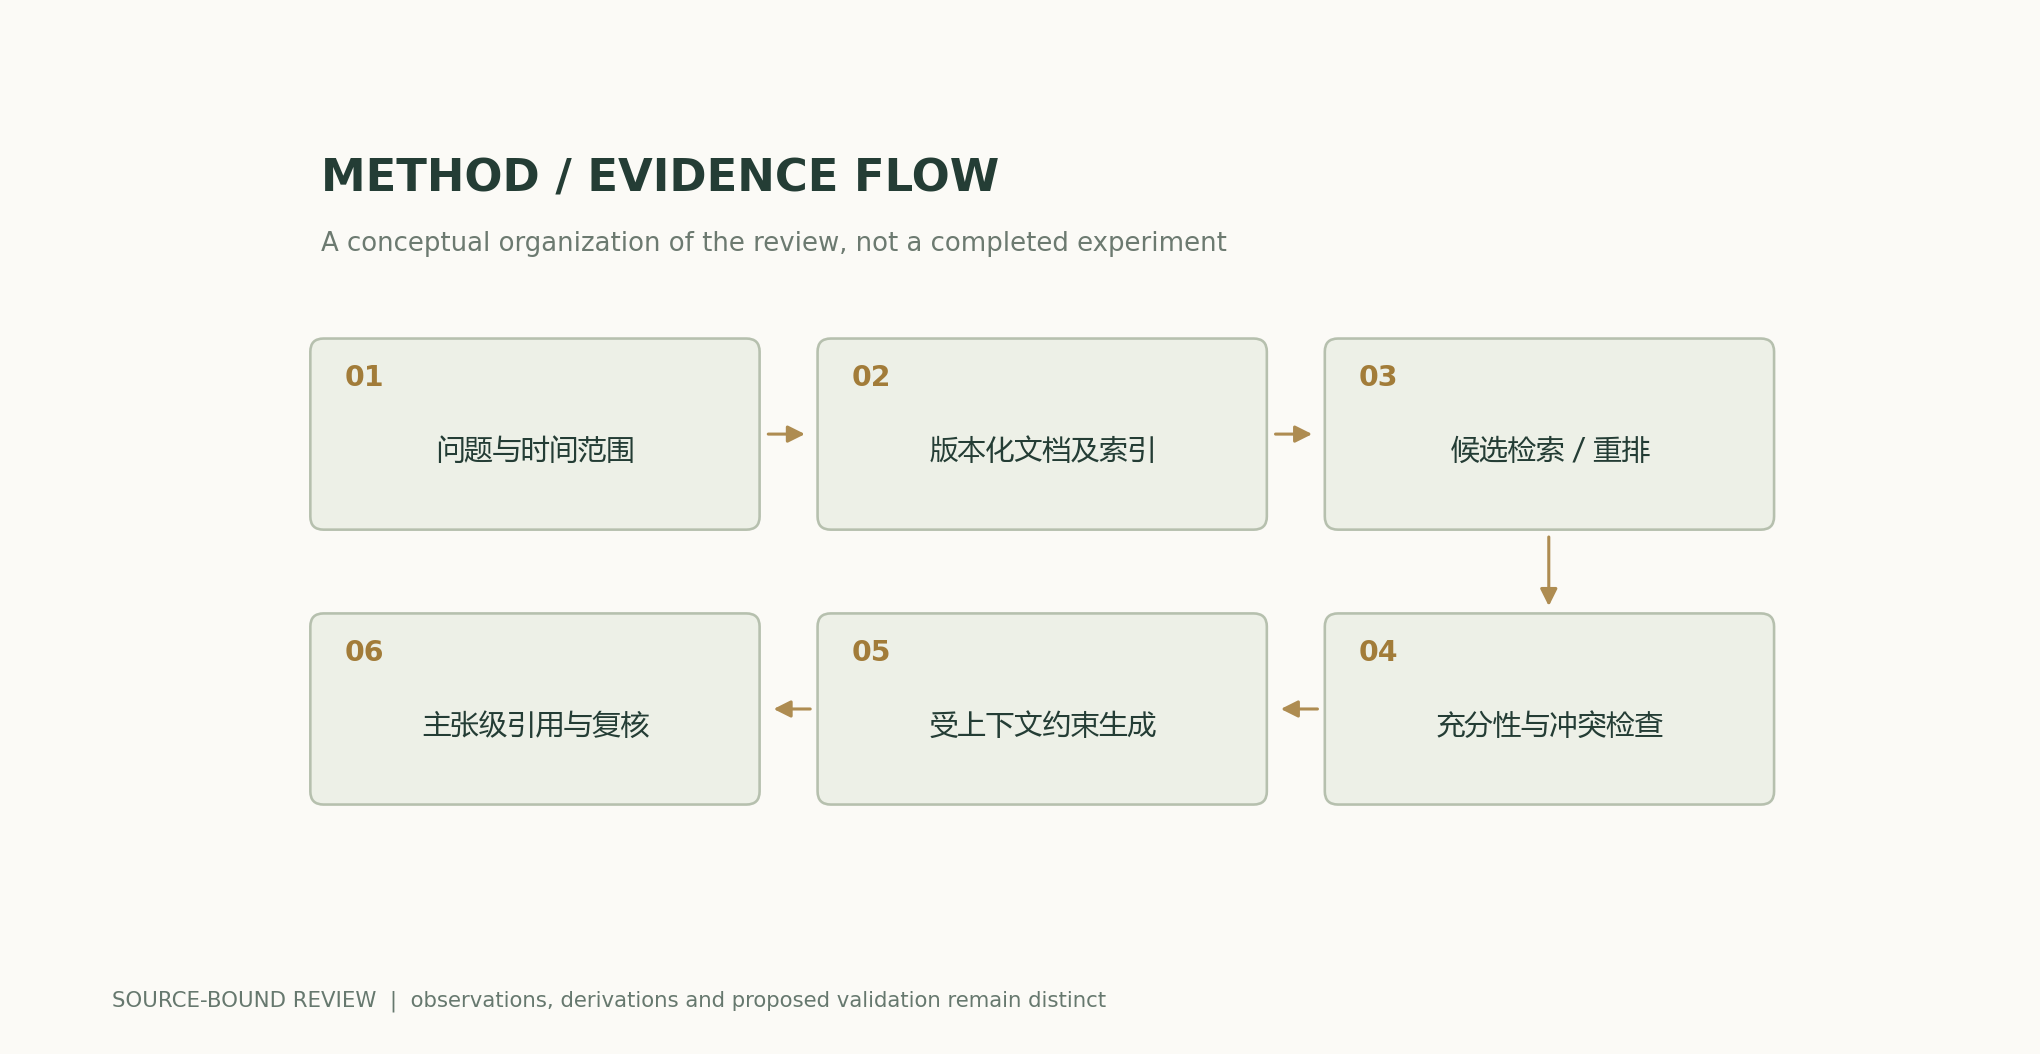
先构造包含可回答与不可回答问题的集合,保留权威答案与证据位置。分别统计候选证据召回、最终答案正确性、引用指向正确性和主张支持率,并单独观察拒答。不要把这几类指标合成一个没有定义的“准确率”。如果评估者只看语言流畅度,系统可能在证据缺失时获得过高评分。作者分析与复核建议 / Author analysis
7. 更新与冲突如何记录
当来源修订、撤稿或不同机构口径冲突时,应先保存访问时间与具体版本,再说明采用哪一口径及原因。检索结果只是一条发现线索,原文核对才是可追溯事实的基础。对于尚未确认的信息,正确输出可能是说明缺口或暂缓结论,而不是从几个互相转载的网页中凑出表面共识。作者分析与复核建议 / Author analysis
给“支持”一个可操作的定义
以“某方法在某数据集上优于基线”为例,合格证据至少应说明方法版本、数据划分、基线和评分指标。如果原文只测了英文测试集,导读不能删掉语言条件;如果数值来自开发集,不能改写成独立测试集表现。来源支持的范围越精确,后续读者就越容易发现真实分歧,而不是争论几个含义不同的“效果更好”。作者分析与复核建议 / Author analysis
8. 成功率应写成条件事件,而不是随意相乘
设 R 表示检索结果包含充分证据,G 表示在该证据集合上生成正确且受支持的结论。联合成功率是 P(R)P(G|R),无需假设 R 与 G 独立。只有把第二项明确为条件成功率,相乘才有意义。若漏检时模型仍可能依赖参数记忆答对,最终答案正确率还包含 P(正确|非R)P(非R),不能直接等同于有证据成功率。评价应同时记录答案是否正确与是否有充分可归因证据,避免把偶然答对算成检索链可靠。[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer
9. 引文正确、相关和充分是三种不同判断
一条引用可能真实存在且讨论相同主题,却没有支持紧邻主张。句子级归因至少要检查来源是否可访问、定位段落是否包含支持信息、适用条件是否被正文保留,以及多个来源是否覆盖了联合主张的全部部分。相互矛盾的材料应显式呈现冲突,而不是通过只挑一段顺耳文字消除。系统应保存文档版本、检索片段和生成时实际可见的上下文;仅保留最终链接无法重建当时的证据条件。[1] Retrieval-Augmented Generation for Knowledge-Intensive [3] Lost in the Middle: How Language Models Use Long Contex
10. 用替换实验定位失效部件
保持问题和生成器不变,分别提供金标准充分证据、当前检索结果、只含干扰项的集合与空上下文。金标准下仍失败说明问题不止在召回;当前检索失败而金标准成功,则说明检索或上下文选择值得优先检查。还应在同一证据集合内移动关键段落位置,避免把长度增加与证据位置变化混为一谈。这个实验是待执行设计,只有记录了真实输入、模型版本和输出,才可以报告各阶段的实测差异。[2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
11. 索引更新也是可复现性的一部分
检索结果会随抓取、切分、去重、嵌入模型和近邻索引的变化而改变。相同问题在相同语言模型上得到不同答案,未必代表生成器发生变化。完整复核需要索引快照或可重建清单、切块规则、文档时间与排序配置;还应记录文档删除和更正如何传播。对时间敏感问题,可访问性与事实有效日期也必须分别保存。去重降低重复曝光,却不能替代来源质量和冲突判断。[4] Deduplicating Training Data Makes Language Models Bette[1] Retrieval-Augmented Generation for Knowledge-Intensive
Ecuaciones y derivaciones
(1) R 指充分证据进入上下文,G 指在该条件下得到正确且有支持的回答。图中条件概率人为设定,用于展示检索改进可能受到下游瓶颈限制。
LaTeX
P(R\cap G)=P(R)\,P(G\mid R)(2) A 仅表示答案正确。参数记忆或猜测可能使没有检索证据的回答也答对,所以最终正确率不是证据链完整性的替代指标。
LaTeX
P(A)=P(A\mid R)P(R)+P(A\mid \neg R)P(\neg R)(3) 计数单元应预先规定,复合主张需要拆分并记录标注分歧。分母和标注指南变化时,这个比率不能直接跨实验比较。
LaTeX
\mathrm{Coverage}=\frac{\#\{\text{有充分证据支持的可核查主张}\}}{\#\{\text{全部可核查主张}\}}Método y cadena de evidencia
Figuras analíticas
Cálculo reproducible
若支持证据检索率为0.8,且检索成功后的有依据生成率为0.9,联合率为0.72。这不等于全部答案准确率;无证据时猜对或有证据时错误须另计。
Comparación de métodos
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 只测最终答案 | 同时记录证据充分性与生成输入 | 无证据答对可能掩盖漏检 |
| 只测 Recall@k | 固定语料、相关性标注和充分证据定义 | 召回相关段落不保证支持完整结论 |
| 只数引用链接 | 按主张核对版本、定位及适用条件 | 链接存在不代表归因成立 |
| 长上下文增强 | 固定证据集合并扰动位置和干扰项 | 读入更多文本可能同时引入更多冲突 |
Protocolo de verificación
- 保存文档集合与索引快照,记录嵌入模型、切分、去重、近邻搜索和重排配置,限定数据截止时间。
- 对每个问题标注必要证据和不能省略的适用条件;不同标注者的分歧单独留档。
- 分别使用金标准、真实检索、干扰和空上下文,保持生成器与采样预算一致。
- 将相同关键证据放在上下文不同位置,并控制总长度,区分位置效应与信息量变化。
- 分开评价答案正确、支持充分、引用定位和冲突披露,不把多个维度压成一个不透明分数。
- 对更正或删除一份来源的情况复跑同一请求,确认失效证据不会由旧索引或缓存继续悄悄提供。
Alcance y limitaciones
- 充分证据的标注存在任务与领域依赖。
- 概率曲线仅为条件事件的解析说明。
- 检索系统不自动验证原始来源真实。
- 没有新增检索基准或模型对比成绩。
Fuentes primarias y afirmaciones
- Retrieval-Augmented Generation for Knowledge-Intensive NLP TasksLewis et al. · 2020-05-22v4; section 2 and Table 1
- Dense Passage Retrieval for Open-Domain Question AnsweringKarpukhin et al. · 2020-11EMNLP 2020 abstract and paper
- Lost in the Middle: How Language Models Use Long ContextsLiu et al. · 2023-07-06v3 abstract; multi-document QA and key-value retrieval
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citas y exportaciones
BibTeXRISCSL JSONTXTArticle JSON
Autor, versiones y fuentes
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Autoría, versiones y correcciones · /guides/rag-evidence-chain/v4/
Procedencia de portadas y figuras · Datos, fuentes y supuestos · Publicación y versiones
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1