
Resumen
La mayoría de las posiciones de una secuencia no codifican proteínas directamente, pero pueden modificar procesos biológicos mediante la expresión, el empalme y el entorno de la cromatina. Enformer y AlphaGenome representan una estrategia de modelización que vincula secuencias de largo alcance con múltiples tipos de observaciones moleculares. Este artículo compara tres cuestiones distintas —predecir pistas observadas, estimar cambios alélicos y demostrar mecanismos causales— y deriva relaciones analíticas para la regulación saturante, las interacciones entre pares de variantes y el error de medición. Proponemos un esquema de validación con loci, tejidos e intervenciones como niveles independientes, para evitar confundir la correlación entre genes con la exactitud de los efectos alélicos dentro de un mismo gen. No se utilizaron genomas personales ni se ofrecen interpretaciones clínicas de variantes concretas.[1] Advancing regulatory variant effect prediction with Alp[2] Effective gene expression prediction from sequence by i
Traducción del resumen original en inglés
Los modelos de secuencia a función integran el contexto regulador distal y múltiples ensayos genómicos, pero la predicción de pistas y la interpretación causal de variantes siguen siendo tareas distintas. Comparamos Enformer con AlphaGenome y derivamos contrastes para variantes individuales y pares no aditivos. Un ejemplo de regulación saturante muestra cómo la actividad basal modifica los tamaños de efecto aparentes, mientras que un modelo de error de medición separa la reproducibilidad de los límites superiores de predicción. Las figuras utilizan supuestos analíticos explícitos, no datos de genotipos humanos ni de pacientes.
1. El contexto de largo alcance modifica el ámbito regulador que puede observar el modelo
Enformer mejora la predicción desde el ADN hasta las pistas de expresión y cromatina mediante la integración de información distal; sus comparaciones abarcan la extensión de la entrada y las distancias de los potenciadores que pueden integrarse. AlphaGenome combina además salidas de alta resolución de múltiples modalidades. Lo importante aquí no es que «cuanto más larga sea la entrada, mejor», sino si la información necesaria para la tarea se encuentra en la ventana disponible, si la red la integra realmente y si llega a la salida con resolución suficiente. Entradas de igual longitud pueden corresponder a campos receptivos efectivos distintos; una misma variante también puede producir efectos diferentes mediante el empalme local y la regulación distal, que no pueden sustituirse por una única puntuación global de las pistas.[2] Effective gene expression prediction from sequence by i[1] Advancing regulatory variant effect prediction with Alp
2. El aprendizaje de múltiples pistas integra experimentos heterogéneos en una representación compartida
El artículo original de AlphaGenome describe 11 clases de modalidades y miles de pistas humanas y de ratón que abarcan observaciones de expresión, empalme y cromatina. Esta predicción conjunta proporciona una representación compartida para el análisis condicional, pero los experimentos difieren en ruido de medición, origen tisular y unidades interpretables. Este artículo recomienda guardar las muestras, la normalización, la resolución y la concordancia entre réplicas de cada pista en un diccionario de tareas. Un buen rendimiento en numerosas pistas fáciles de predecir no permite inferir una fiabilidad equivalente para tejidos poco representados o eventos de empalme específicos; la evaluación debe conservar las distribuciones dentro de cada modalidad en vez de resumirlas en un único promedio.[1] Advancing regulatory variant effect prediction with Alp
3. Los contrastes alélicos plantean exigencias mayores que el ajuste de pistas
Un modelo de secuencia puede recibir por separado las secuencias de referencia y alternativa y, después, comparar las predicciones para una ventana de salida o un gen. Estos contrastes ayudan a formular hipótesis mecanísticas, pero los errores pueden amplificarse al calcular las diferencias o parecer cancelarse debido a sesgos compartidos. Una correlación elevada de la expresión entre genes suele deberse a diferencias basales entre ellos y no equivale a ordenar correctamente múltiples variantes de un mismo gen. El análisis de eQTL de Enformer también aborda las dificultades de validación causadas por el desequilibrio de ligamiento. Por ello, separamos las pistas basales, los contrastes alélicos dentro del mismo gen, la dirección del efecto y la calibración de su tamaño en cuatro criterios de evaluación independientes.[2] Effective gene expression prediction from sequence by i[1] Advancing regulatory variant effect prediction with Alp
4. Derivación de este artículo: un mismo incremento regulador tiene efectos distintos según el nivel basal
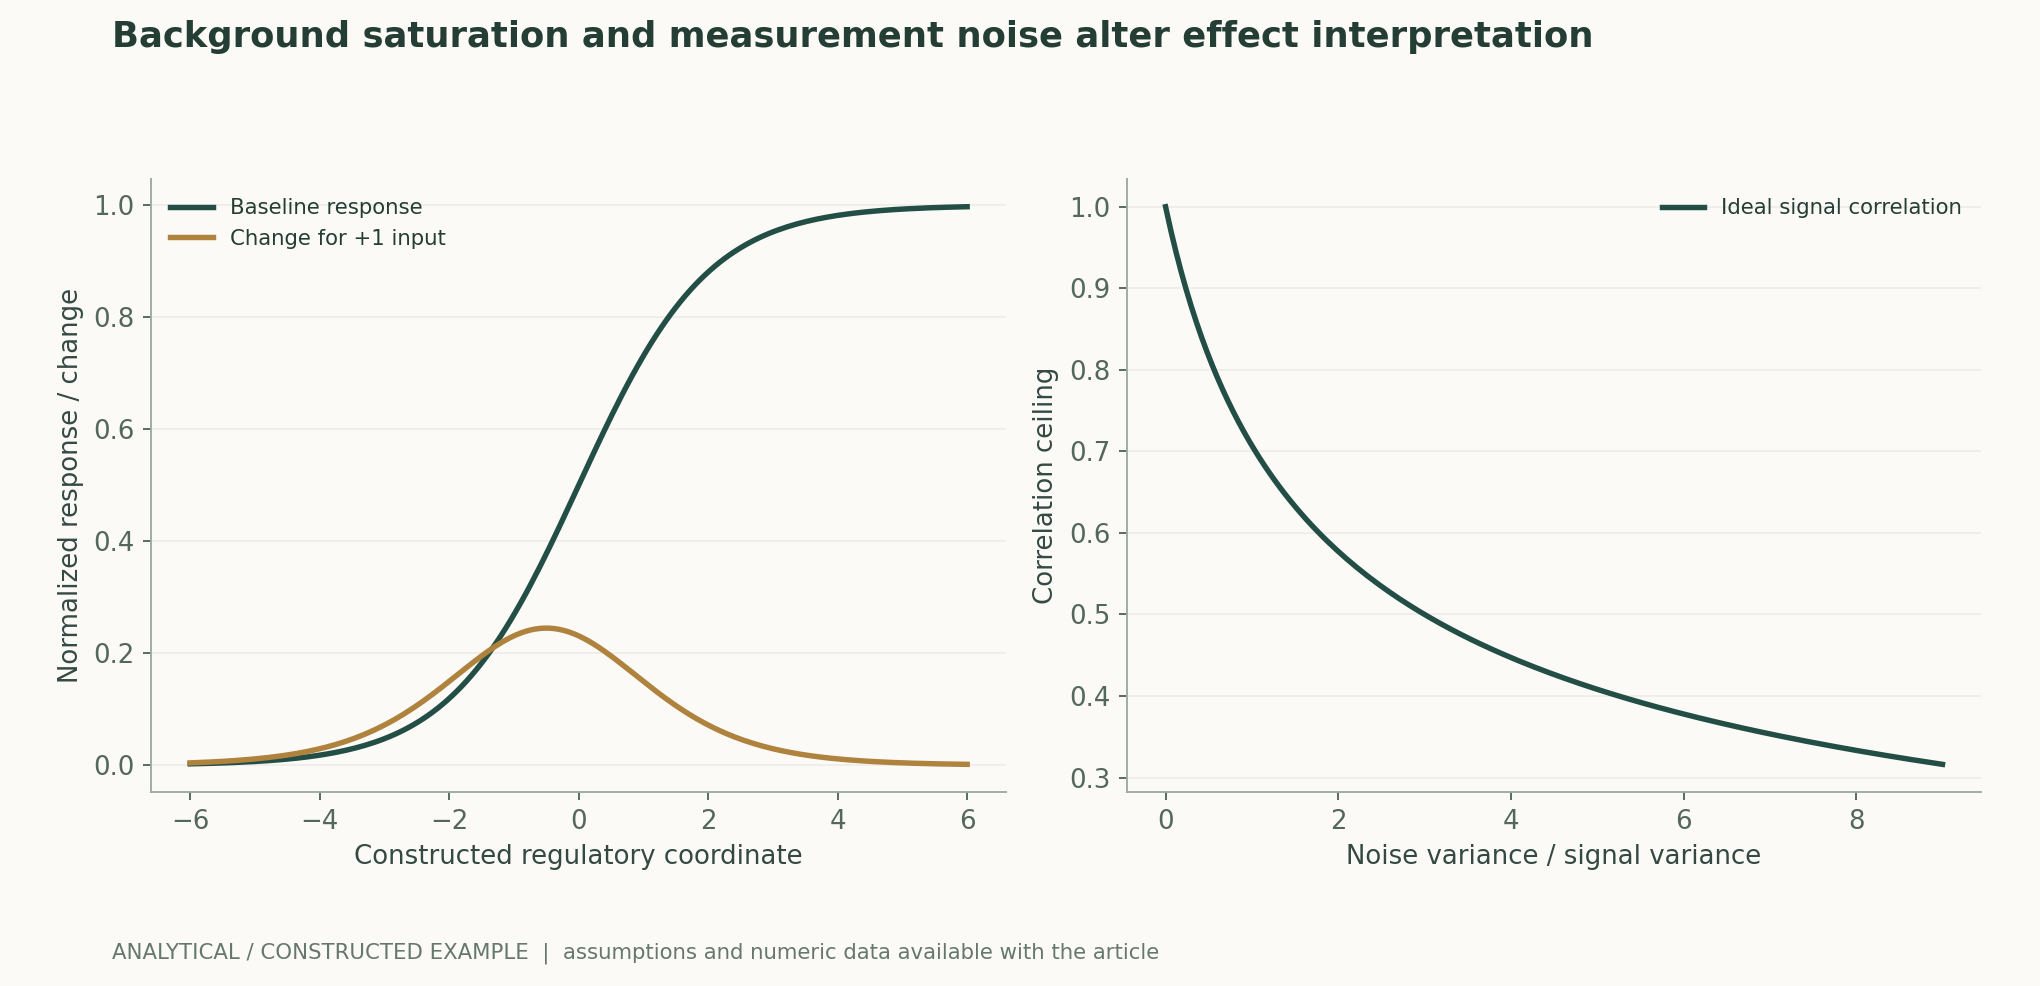
Supongamos que una variable reguladora z, utilizada únicamente con fines analíticos, determina una salida normalizada mediante una función sigmoide, y que una variante aumenta z en 1. Con el nivel basal z=0, la salida pasa de 0.5 a aproximadamente 0.731, con una diferencia de 0.231; con el nivel basal z=3, pasa de aproximadamente 0.953 a 0.982, con una diferencia de solo unos 0.029. Esta dependencia del contexto debida a la saturación demuestra que no puede aislarse la contribución local de un locus de su contexto tisular o de secuencia para tratarla como un efecto fijo universal. El ejemplo no ajusta parámetros biológicos; solo demuestra que contribuciones iguales en la entrada no garantizan cambios iguales en la escala de observación. La figura muestra tanto la diferencia absoluta como la derivada local para facilitar el examen del origen de la no linealidad.作者分析与复核建议 / Author analysis
5. Derivación de este artículo: los pares de variantes requieren evaluar el término no aditivo
Al construir una secuencia de referencia, una sustitución individual A, una sustitución individual B y una sustitución doble AB, la doble diferencia permite aislar el término de interacción respecto de la escala de salida elegida. Incluso sin una interacción explícita dentro del modelo, una salida no lineal puede producir una doble diferencia distinta de cero, por lo que cualquier afirmación de «descubrimiento de una interacción» debe especificar la escala de medición. A la inversa, una interacción nula en la salida tampoco demuestra que los mecanismos moleculares sean independientes. Este artículo recomienda conservar conjuntamente las pistas originales, los valores normalizados y los contrastes, sin escoger a posteriori la escala de transformación más significativa. La inferencia mecanística propiamente dicha exige además intervenciones capaces de descartar vías alternativas, no solo observar la respuesta del modelo.作者分析与复核建议 / Author analysis
6. Asociación, intervención y transferibilidad no pueden compartir una misma etiqueta
La investigación sobre representaciones causales subraya que los patrones estables en distribuciones observacionales no determinan automáticamente los resultados de las intervenciones. En las tareas genómicas, el ligamiento, la composición celular y el estado tisular pueden modificar las relaciones observadas. Este artículo denomina «perturbaciones internas del modelo» a las sustituciones computacionales de secuencia; solo las mediciones producidas por intervenciones externas constituyen el respaldo experimental correspondiente. Si un locus modifica la expresión en un tejido, transferir el resultado a otro exige considerar también si se conserva el contexto regulador. Los modelos pueden reducir el conjunto de hipótesis que merece la pena evaluar, pero no demostrar una vía causal basándose únicamente en la atención, los gradientes o las deleciones virtuales.[3] Towards Causal Representation Learning[2] Effective gene expression prediction from sequence by i
7. Derivación de este artículo: las mediciones repetidas aportan una referencia para la correlación predictiva
Supongamos que la observación y es la señal verdadera s más un ruido independiente de media cero y que el predictor recupera s exactamente. Entonces, la correlación entre la predicción e y es la raíz cuadrada de la proporción de varianza total atribuible a la señal. Esta relación ideal muestra que la fiabilidad de las observaciones de las distintas pistas afecta a la correlación alcanzable; también indica que no basta con invocar un límite superior teórico para justificar un modelo de bajo rendimiento. La independencia del ruido, la estabilidad de la varianza y la recuperación de la señal verdadera son supuestos fuertes. En la práctica, debe estimarse la fiabilidad a partir de réplicas y después examinarla por estratos de tejido y locus; la figura solo modifica la varianza de ruido supuesta y no simula ningún experimento ni modelo real.作者分析与复核建议 / Author analysis
8. Las particiones de prueba deben evitar la fuga de información por homología, proximidad y origen de las muestras
El genoma contiene secuencias repetitivas, genes homólogos, regiones reguladoras adyacentes y orígenes celulares similares, por lo que una partición aleatoria de ventanas puede hacer que entrenamiento y prueba compartan mucha información. Este artículo propone tres niveles de reserva: loci reservados para evaluar la extrapolación de secuencias, tejidos o muestras reservados para evaluar la transferencia entre condiciones y una reserva temporal para evaluar experimentos nuevos. La normalización, la selección de características y los umbrales deben determinarse únicamente en los conjuntos de entrenamiento o validación. Para comparar modelos, deben utilizarse las mismas muestras y el mismo conjunto de loci, calculando los intervalos mediante agrupación por loci independientes; considerar millones de bases adyacentes como muestras independientes produce una significación estadística excesivamente precisa.作者分析与复核建议 / Author analysis
9. Una agenda de investigación que merece ponerse a prueba
Un siguiente paso más valioso consiste en probar si el aprendizaje multimodal conjunto mejora los efectos alélicos entre tejidos, y no solo el ajuste de pistas. Pueden especificarse de antemano loci nuevos, variantes individuales y variantes combinadas, y evaluar por separado la dirección, la magnitud y la coherencia entre modalidades; las observaciones externas se obtendrían después de congelar el modelo. Si el modelo conjunto solo supera a los demás en expresión basal, pero no mejora los contrastes, la conclusión debe limitarse a la representación y la predicción de pistas. Si distintas modalidades arrojan efectos contradictorios, también deben conservarse esas discrepancias y buscar explicaciones tisulares, de medición o mecanísticas, en vez de elegir una pista que respalde la hipótesis original.作者分析与复核建议 / Author analysis
Suplemento técnico A · De la convolución local a la integración de información distal
Las capas convolucionales amplían progresivamente el campo receptivo local, mientras que la atención puede intercambiar directamente información distal entre representaciones ya comprimidas. Sus compromisos afectan a la resolución, el intervalo de distancias y el coste computacional: reducir la resolución demasiado pronto puede hacer perder detalles del empalme local o de los motivos de secuencia, mientras que conservar toda la resolución por base incrementa el coste del procesamiento de largo alcance. Este artículo recomienda enmascarar por separado el contexto proximal y distal de una misma variante, manteniendo fijas la ventana y la normalización, y observar los cambios en la predicción. Esto evalúa de qué información depende el modelo, pero no demuestra que esas regiones de secuencia tengan necesariamente efectos causales en tejidos reales; el propio enmascaramiento puede generar secuencias ajenas a la distribución de entrenamiento.[2] Effective gene expression prediction from sequence by i[1] Advancing regulatory variant effect prediction with Alp
Suplemento técnico B · El error del contraste depende de la correlación entre ambas predicciones
Sean er y ea los errores de predicción de las secuencias de referencia y alternativa, respectivamente. El error del contraste alélico es ea−er, y su varianza incluye la covarianza entre ambos errores. Los sesgos compartidos pueden cancelarse en el contraste, mientras que el ruido no correlacionado puede acumularse. Por tanto, no existe una proporción fija entre el error de las pistas y el error de los contrastes. Este artículo propone conservar tanto las predicciones absolutas como las comparaciones pareadas en experimentos independientes, para comprobar si errores basales elevados coexisten con contrastes útiles, y viceversa. Al comparar modelos, una única correlación de pistas absolutas no permite inferir una mejor priorización de variantes; se requieren evaluación y calibración directas de los criterios basados en contrastes.作者分析与复核建议 / Author analysis
Suplemento técnico C · La concordancia de dirección puede coexistir con magnitudes muy erróneas
Si todos los efectos verdaderos de las variantes son positivos y el modelo siempre devuelve valores positivos diminutos, la exactitud de la dirección puede ser alta aunque los tamaños de efecto apenas tengan capacidad de discriminación práctica. A la inversa, en casos próximos a cero y con mucho ruido de medición, el signo puede invertirse fácilmente aunque el modelo ya esté cerca del límite medible. Este artículo recomienda definir previamente regiones de efecto relevante e informar conjuntamente del signo, el orden, la magnitud y los intervalos indeterminados. Al seleccionar casos de efecto fuerte, el umbral debe fijarse en el conjunto de validación; elegir después de la prueba un subconjunto con direcciones concordantes cambia la pregunta respondida e introduce sesgo de selección.作者分析与复核建议 / Author analysis
Suplemento técnico D · Complementariedad de los datos de ligamiento y de intervención
Las asociaciones poblacionales permiten aprovechar numerosas variantes naturales, pero afrontan señales compartidas entre loci correlacionados; las intervenciones controladas se aproximan más a modificar una posición concreta, aunque también están limitadas por el contexto y las condiciones de medición. Este artículo sostiene que ambos enfoques deben considerarse restricciones complementarias: primero se utiliza el modelo para proponer hipótesis distinguibles sobre loci y tejidos, y después se examinan en datos adecuadamente independientes. Si distintas evidencias apuntan a objetivos diferentes, debe conservarse esa discrepancia y revisar el ensamblaje, el tejido, el haplotipo y las definiciones de las etiquetas. Reducir todas las fuentes a una puntuación compuesta elimina información sobre los conflictos, aunque estos pueden revelar precisamente condiciones reguladoras que el modelo aún no ha captado.作者分析与复核建议 / Author analysis
10. Conclusión: convertir la capacidad de procesar secuencias largas en conocimiento biológico acumulativo
Los modelos de secuencia están comprimiendo regularidades estadísticas de numerosos experimentos heterogéneos en funciones consultables, cuyo valor reside en aportar hipótesis sistemáticas sobre los mecanismos reguladores. Este artículo propone ampliar las salidas desde «una puntuación de variante» a contrastes condicionales trazables: qué contexto de secuencia, qué tejido, qué medición y qué escala de efecto. Las evidencias de los estudios originales deben conservarse por separado de los análisis de este artículo, y los resultados negativos también deben vincularse a las versiones correctas. Solo cuando las predicciones del modelo resistan pruebas con nuevas muestras, tejidos e intervenciones podrán los avances técnicos de la modelización de largo alcance convertirse en conocimiento mecanístico fiable, sin quedarse en demostraciones de correlación a gran escala.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Contraste alélico interno del modelo para un tejido o una pista t especificados; deben definirse tanto la ventana de salida como la escala.
LaTeX
\Delta_v^{(t)}=f_t(x_{\mathrm{alt}})-f_t(x_{\mathrm{ref}})(2) Término no aditivo de un par respecto de la escala seleccionada; no demuestra directamente una interacción causal entre mecanismos moleculares.
LaTeX
\epsilon_{AB}=f(x_{AB})-f(x_A)-f(x_B)+f(x_0)(3) Función analítica utilizada en este artículo para explicar la saturación basal; no es un modelo de regulación génica ajustado a datos.
LaTeX
f(z)=\frac1{1+e^{-z}},\qquad f'(z)=f(z)[1-f(z)](4) Correlación ideal con la señal bajo el supuesto de ruido de medición independiente y de media cero; el límite superior real debe estimarse con experimentos replicados.
LaTeX
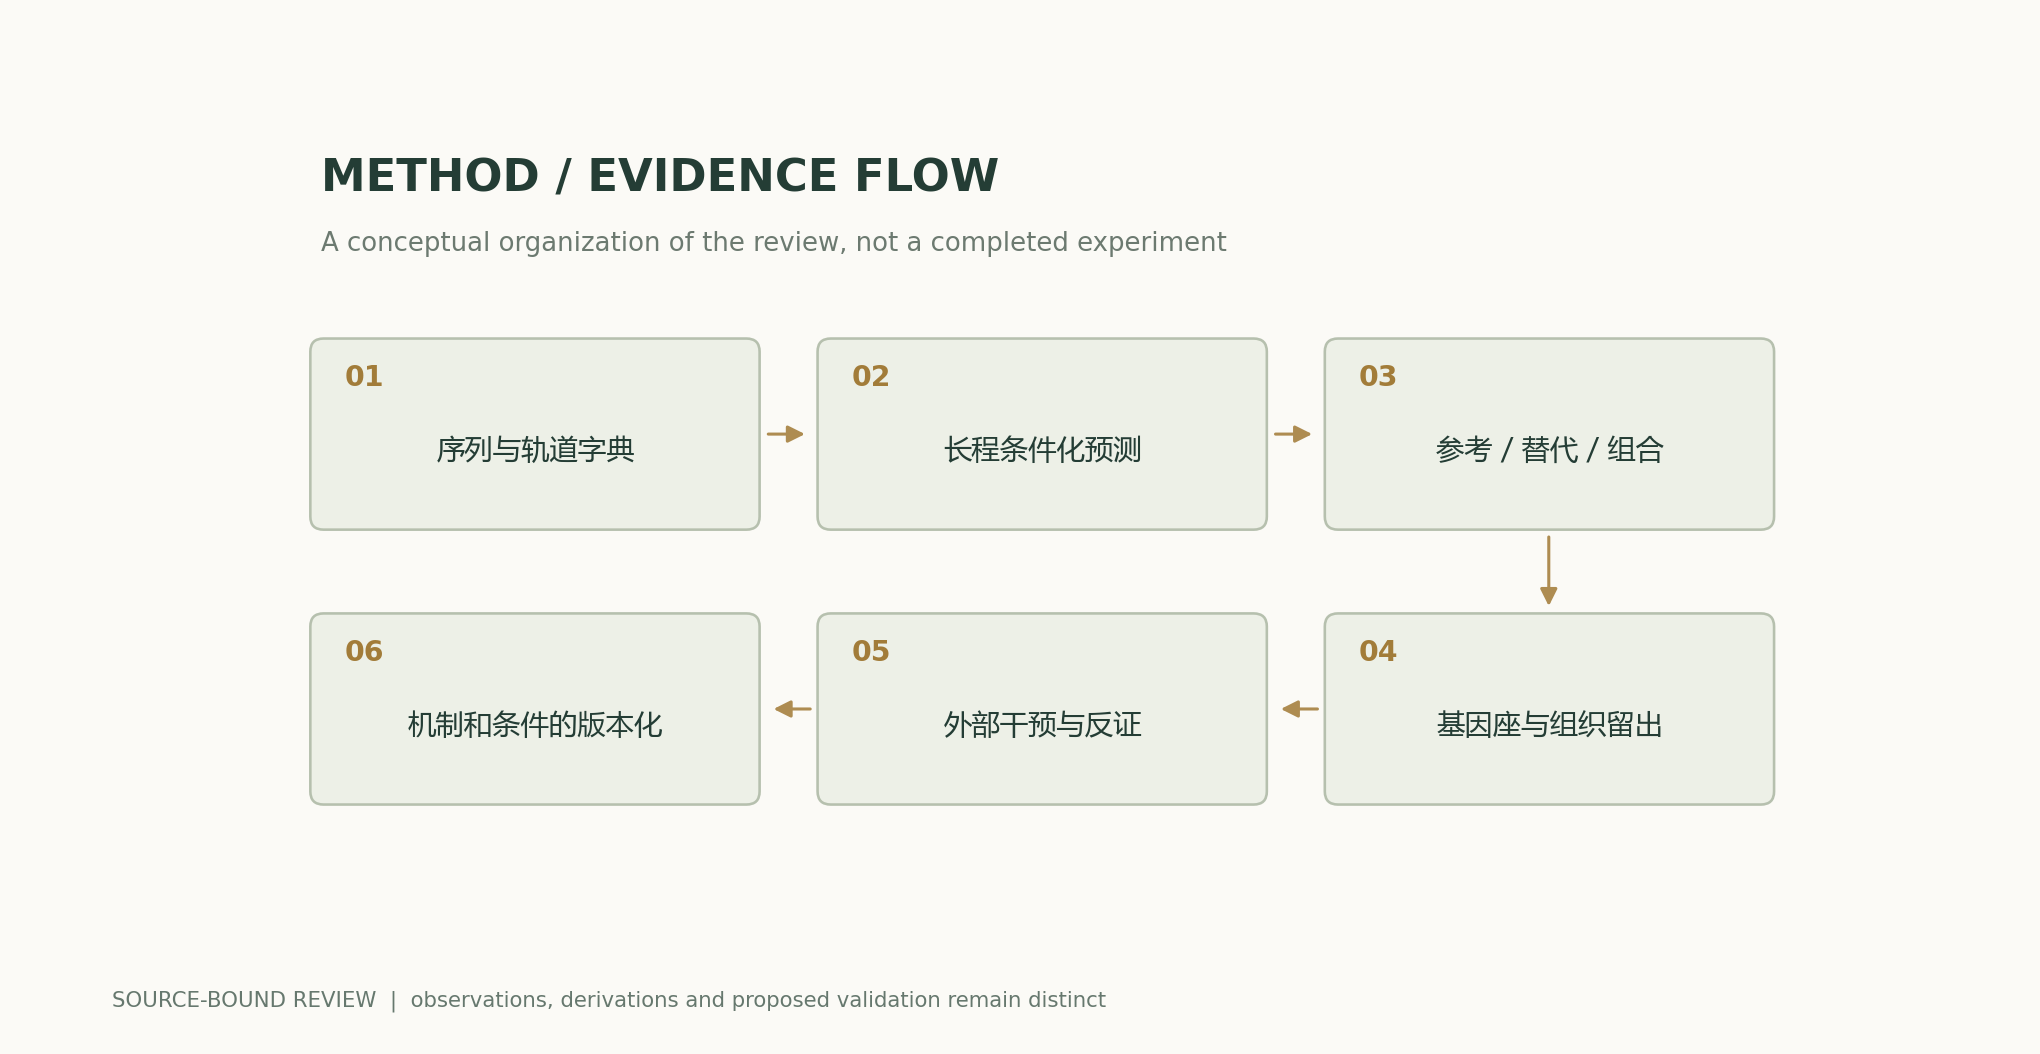
\operatorname{Corr}(s,s+\eta)=\sqrt{\frac{\sigma_s^2}{\sigma_s^2+\sigma_\eta^2}}Flujo de métodos y evidencias
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto reproducible mediante recálculo
Con el nivel basal z=0, el incremento es 0.231059, y con z=3, aproximadamente 0.029440; cuando la varianza del ruido iguala la de la señal, la correlación ideal es sqrt(1/2)≈0.707107.
Comparación de métodos
| Nivel de predicción | Elementos que deben compararse | Principales factores de confusión |
|---|---|---|
| De secuencia a pista | Observaciones del mismo experimento y con la misma resolución | Normalización, ruido de medición y composición tisular |
| Expresión entre genes | Genes distintos en una muestra fija | Diferencias basales entre genes |
| Cambio alélico | Secuencias de referencia y alternativa en el mismo contexto | Error del contraste y ligamiento |
| Cambios combinados | Referencia / A / B / AB | Escala no lineal y dependencia del contexto |
| Transferencia entre tejidos | El mismo locus en distintos tejidos o estados | Cambios en el entorno regulador |
| Mecanismo causal | Intervención externa prerregistrada | Vías alternativas y especificidad de la intervención |
Plan de verificación y experimentación
- Congelar el ensamblaje de referencia, las secuencias, la representación de las variantes, el modelo y el diccionario de pistas.
- Comprobar la orientación de la hebra, las coordenadas, los alelos de referencia y los bordes de las ventanas; rechazar entradas incompatibles.
- Separar entrenamiento y prueba por locus, región homóloga, tejido y origen de las muestras.
- Evaluar de manera independiente las pistas, la dirección de los contrastes, los tamaños de efecto y las interacciones combinadas.
- Utilizar únicamente datos de entrenamiento para determinar la normalización, la selección de genes o ventanas y las reglas de ajuste de parámetros.
- Informar de los intervalos utilizando loci independientes como agrupaciones estadísticas, desglosados por tejido y modalidad.
- Registrar por separado las perturbaciones internas del modelo y las mediciones de intervenciones externas, y definir de antemano las condiciones de refutación.
- Publicar resúmenes de las fuentes y las entradas, el código de cálculo y los resultados negativos; no utilizar las predicciones para diagnosticar variantes personales.
Ámbito de aplicación y limitaciones
- La sigmoide analítica y el modelo de ruido no se ajustaron con datos genómicos reales.
- En este artículo no se ejecutaron AlphaGenome ni Enformer, ni se realizaron nuevos experimentos moleculares.
- Predecir múltiples pistas no equivale a haber observado todas las posibles vías causales.
- Supuestos como la independencia del ruido o un contexto fijo pueden no cumplirse en tejidos reales.
- La interpretación de investigaciones y el juicio clínico individual son tareas diferentes.
Evidencias de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Predicción conjunta de 11 clases de modalidades y múltiples pistas humanas y de ratón. | Cada modalidad, tejido y tarea relativa a variantes requiere una validación independiente. | Avances en la predicción de los efectos de variantes reguladoras con AlphaGenomeResumen; salidas del modelo y evaluaciones comparativas |
| La integración de información distal mejora múltiples tareas de secuencia a pista y tareas relativas a variantes. | La correlación entre genes no equivale automáticamente a efectos alélicos ni a identificación causal. | Predicción eficaz de la expresión génica a partir de la secuencia mediante la integración de interacciones de largo alcanceResultados; análisis de eQTL |
Preguntas de investigación que merecen ponerse a prueba
- ¿La combinación de modalidades aporta una mejora independiente en los contrastes alélicos de tejidos nuevos?
- ¿Cómo modifica la escala del efecto la evaluación de las interacciones entre variantes combinadas?
- Con la misma fiabilidad de medición, ¿en qué intervalos de distancia persisten errores sistemáticos?
Fuentes primarias y afirmaciones correspondientes
- Advancing regulatory variant effect prediction with AlphaGenomeAvsec et al. · 2026-01-28Abstract; sequence-to-track prediction, 11 modalities and variant-effect benchmark scope.
- Effective gene expression prediction from sequence by integrating long-range interactionsAvsec et al. · 2021Results: long-range regulation; eQTL linkage disequilibrium and task-specific validation.
- Towards Causal Representation LearningBernhard Schölkopf, Francesco Locatello, Stefan Bauer, Nan Rosemary Ke, Nal Kalchbrenner, Anirudh Goyal, Yoshua Bengio · 2021-02-22Abstract and sections on interventions, independent mechanisms and causal representations
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación documentada y análisis originales redactados por Codex (IA). Los experimentos de los artículos originales corresponden a sus equipos de investigación; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de revisión independiente por pares de este artículo ni de registros de experimentos originales de modelos, clínicos o físicos.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se conservan las fuentes de cada sección y la distinción entre las evidencias de los estudios originales y los análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas especifican individualmente los supuestos y las definiciones de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c