
摘要
合成数据可以降低部分标注成本,也可能重复教师错误、缩窄覆盖或污染评估。本文将生成、筛选、去重和训练视为共同决定有效数据分布的流程,推导罕见事件在筛选后至少出现一次的概率,并讨论该独立采样模型的局限。配图不是模型退化实验;真实效果必须通过独立真实数据和固定训练预算验证。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
English abstract
Synthetic data pipelines are evaluated as sampling-and-selection systems. We distinguish correctness, coverage and dependence, derive rare-event retention under an explicit independent-sampling model, and describe contamination-safe controls. The coverage curves are analytical scenarios, not empirical model-collapse results. Real held-out data and provenance are required to assess a generated corpus.
1. 数据量不是有效信息量
生成一百万条文本并不意味着得到一百万个独立学习信号。相似提示、同一教师、重复模板和近似答案会造成强相关。质量还应分别定义为事实正确、任务相关、语言可用和覆盖目标群体;一个统一分数可能掩盖不同失败。Self-Instruct提供一种由模型生成指令并筛选的具体路径,但任何新场景仍需验证其生成和过滤规则,不能把方法名称当作质量保证。[2] Self-Instruct: Aligning Language Models with Self-Gener
2. 筛选器同时改变错误与覆盖
过滤可能减少明显错误,也可能优先保留常见、容易判定或与教师偏好一致的内容。罕见但正确样本若更容易被误拒,会在后续训练中进一步稀缺。应分别估计不同类别的保留率,而不是只报告总体通过率。筛选器与生成器若共享盲点,还可能互相认可错误。人工复核需要按风险和长尾分层抽样,不能只看最容易通过的一批。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener
3. 长尾覆盖可以先做概率核算
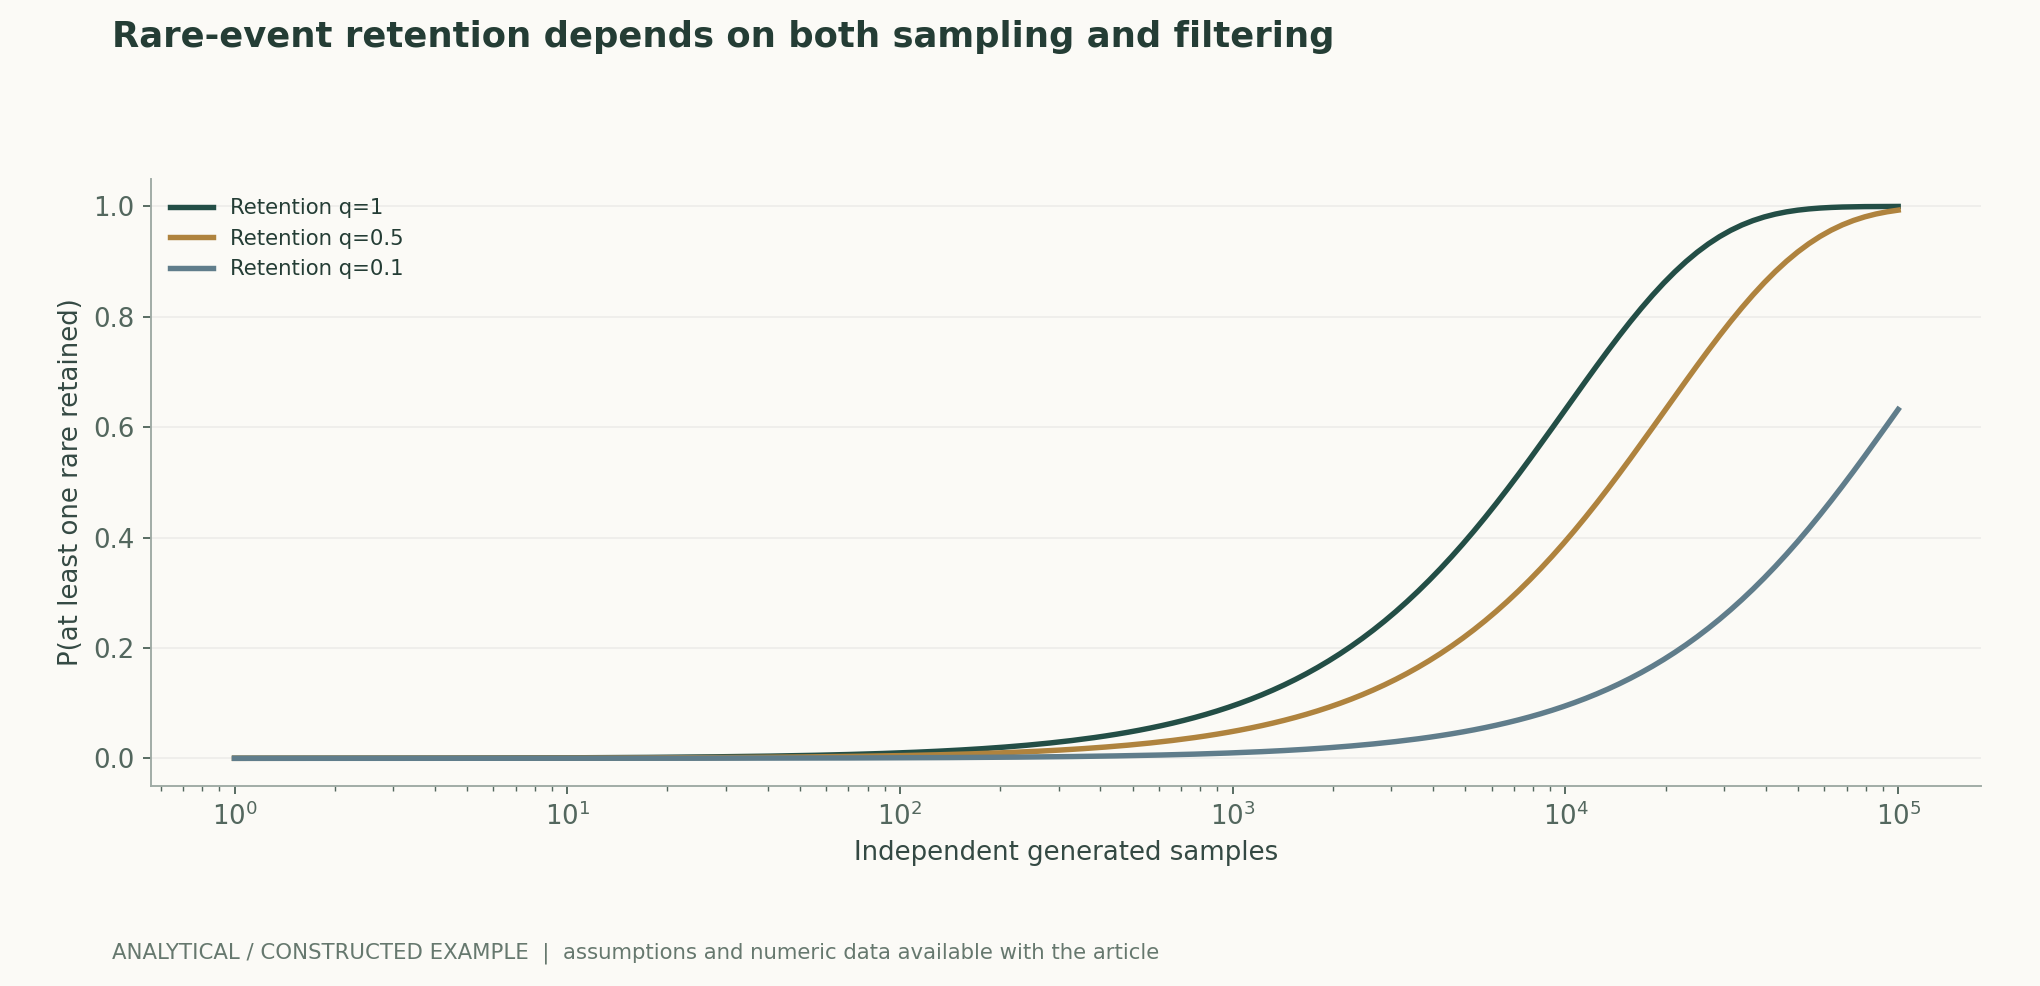
假设某事件原本概率p、被筛选保留概率q,且n次生成独立,则至少保留一次的概率为1−(1−pq)^n。这个公式清楚展示:更多采样与更好的长尾保留可以相互补偿,但一次出现不代表足够学习。现实样本相关、教师支持集有限或事件根本不会被生成时,独立模型会过于乐观。图中p=0.0001,q取1、0.5、0.1,仅用于解释这一条件关系。[1] Textbooks Are All You Need
4. 递归使用生成数据需要保留真实锚点
关于递归生成训练的研究讨论了分布尾部丢失和误差积累的风险;其结论依赖模型、数据混合和训练条件,不能简化为所有合成数据必然有害。关键是记录每条样本的来源代际、真实数据比例、筛选和重采样规则,并在固定真实测试集上追踪分层质量。若不断用当前模型生成并由同类模型评价,可能形成缺乏外部真值的闭环。[1] Textbooks Are All You Need
5. 去重和污染检查应在家族层面进行
同一原始题目的改写、翻译和教师解释可能跨越训练与测试划分。仅比较字符串哈希会漏掉语义变体,过强语义过滤又可能误删合法相似问题。应保存样本家族、生成提示与来源链接,在划分前聚合相关变体,并对相似匹配做人工复核。训练数据去重研究提示重复数据会影响记忆与评估解释;合成流程应把这些检查前置。[3] Deduplicating Training Data Makes Language Models Bette[2] Self-Instruct: Aligning Language Models with Self-Gener
6. 验收需要匹配预算与独立真实评价
比较合成数据方案时,固定基础模型和总训练token,分开改变生成策略、过滤器与真实/合成混合比。报告生成成本、人工复核成本、重复率和各类覆盖,避免只报最终训练分数。测试应包含真实未见输入、罕见情况和教师错误集。本文的覆盖图只是一项设计前核算,不是语料质量认证,也没有证明任何混合比最优。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
Equations and derivations
(1) 独立同分布采样及恒定保留率假设;一次出现不是足够训练的保证。
LaTeX
P(\text{至少保留一次})=1-(1-pq)^n(2) 示例p=10的负4次方;真实p和q需通过分层审计估计。
LaTeX
\mathbb E[N_{\mathrm{rare}}]=npq(3) a(x)为样本被接受的概率,说明过滤器改变了整个分布,而不只是移除错误。
LaTeX
P_{\mathrm{kept}}(x)\propto P_{\mathrm{gen}}(x)\,a(x)Method and evidence flow
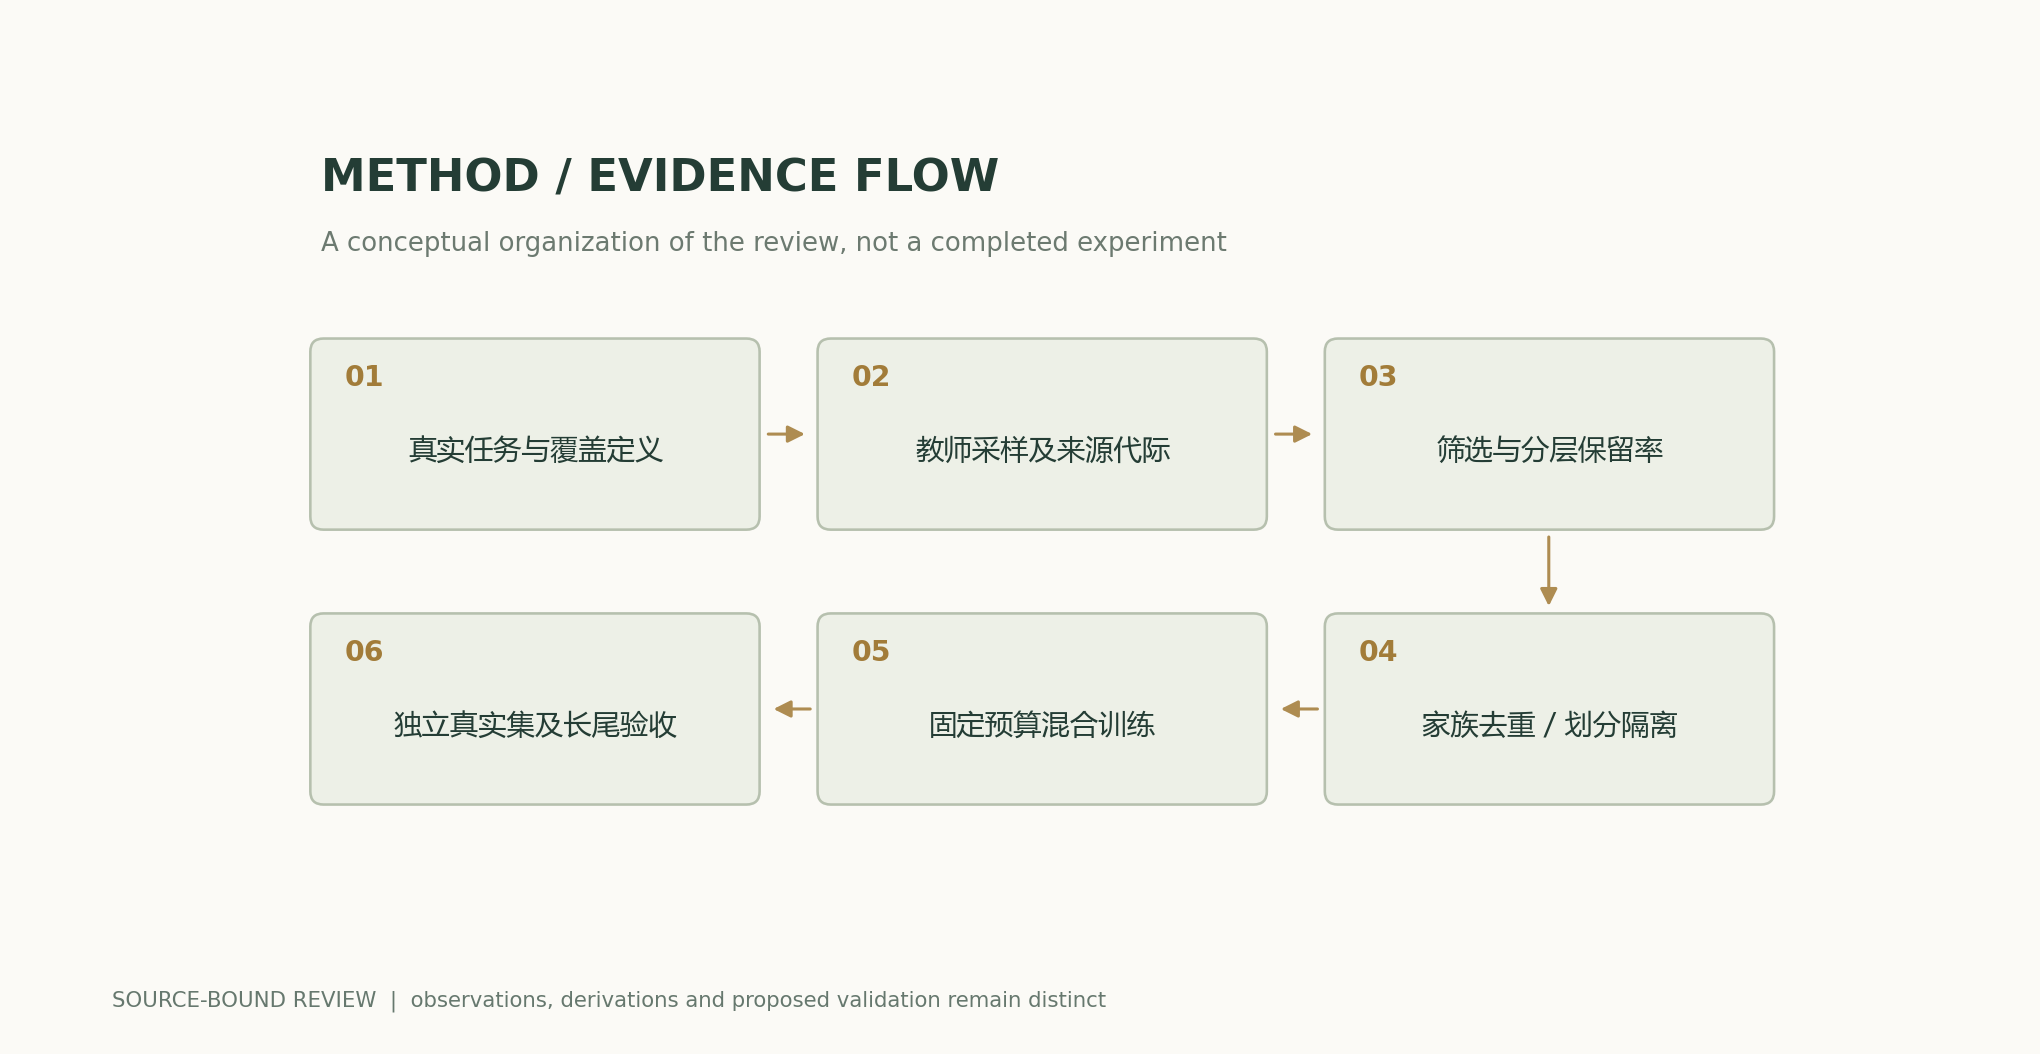
Analytical figures
Worked calculation
n=10000时,q=1的至少一次保留率约0.632,q=0.1时约0.095。相关生成或教师缺少该模式会让独立模型过于乐观。
Method comparison
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 生成数量 | 同时报告重复、家族和覆盖 | 更多样本不保证更多独立信息 |
| 质量过滤 | 按类别测精确率与保留率 | 总体通过率掩盖长尾误拒 |
| 递归训练 | 保存代际与真实数据锚点 | 不能外推所有合成数据必然退化 |
| 评价集 | 保持独立真实来源与家族隔离 | 教师评价自己生成的样本可能循环 |
Verification protocol
- 预先定义目标任务和质量维度,固定独立真实测试集。
- 记录生成模型、提示、采样、来源代际及每次过滤动作。
- 按家族划分并执行精确/近似去重,抽查语义匹配的误报漏报。
- 按常见与罕见类别审计正确性、保留率和独立性。
- 固定训练token与基础模型,消融过滤器和真实/合成混合比。
- 公开生成、复核与训练成本,报告教师失败集及长尾质量。
Scope and limitations
- 覆盖模型假设采样独立。
- 没有新语料训练或退化实验。
- 一次长尾出现不保证学会。
- 过滤质量与覆盖可能相互冲突。
Primary sources and claim mapping
- Textbooks Are All You Need, , , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled Textbooks Are All You Need, by Suriya Gunasekar and 18 other authors · 2023-06-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Self-Instruct: Aligning Language Models with Self-Generated Instructions, , , , , , · 2022-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citations and exports
BibTeXRISCSL JSONTXTArticle JSON
Author, versions and sources
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Cover and figure provenance · Data, sources and assumptions · Publication and version record
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1