
摘要
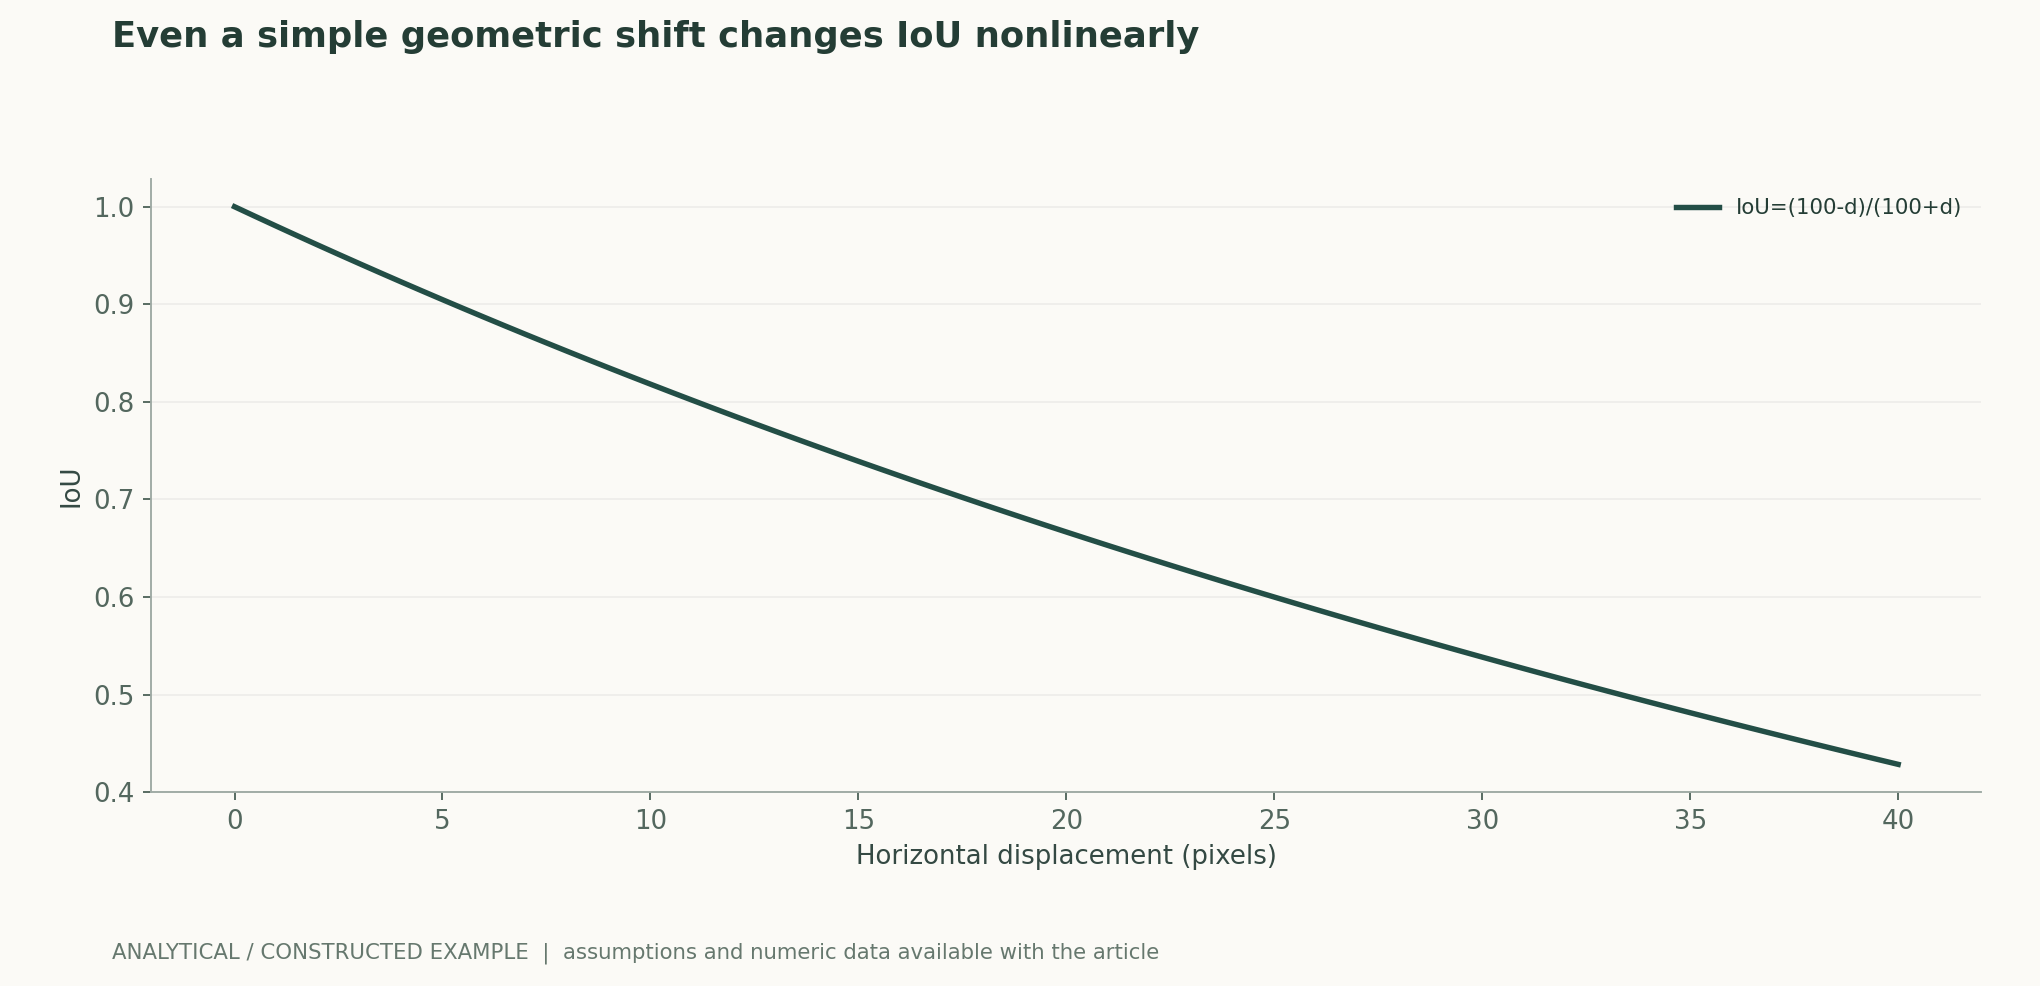
可提示分割通过点、框等输入指定目标,但提示方式、对象层级和人工交互预算都会影响结果。本文分析SAM的图像编码与掩码解码接口,以及SAM 2的视频记忆语境,区分空间重叠、时间一致性和语义正确性。图示为矩形平移后的解析IoU,不是任何SAM模型的测试成绩。[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos[3] Learning Transferable Visual Models From Natural Langua
English abstract
Promptable segmentation is evaluated as an interactive system with a specified object and prompt budget. We distinguish mask ambiguity, confidence prediction, temporal memory and semantic recognition. A translated-rectangle example derives IoU sensitivity without running SAM. Domain transfer and video consistency require independent labeled evaluation.
1. 提示定义了任务而不只是输入格式
一个点可能指向物体整体、某个部件或纹理区域,多种掩码都可能合理。应先规定对象定义与标注政策,再说明点、框或文本如何生成。人工选择最有利提示与固定自动提示的成本不同。可提示模型的测试需要把交互次数、纠错和失败都计入,而不能只报告从多个候选中事后挑出的最好掩码。[1] Segment Anything
2. 编码复用与轻量解码有工程条件
图像编码可在多个提示间复用,再由提示与掩码解码器生成结果;复用键必须绑定图像、预处理和模型版本。缩放、裁切及坐标变换错误可能让提示位置偏移。时延应拆分首次编码与后续交互,同时记录内存。若只测热缓存解码,不应把结果写成首次加载到输出的总延迟。[1] Segment Anything
3. 多掩码与质量分数不是外部真值
模型可能输出多个候选与质量估计,以应对歧义。预测分数需要独立校准,不能代替与标注比较;选最高分候选和使用真值选最佳候选是不同评估协议。还应检查小物体、细长边界、遮挡和相似相邻对象,平均IoU可能掩盖关键失败。对象范围不一致时,低重叠也可能来自标注歧义而非纯粹视觉错误。[1] Segment Anything
4. 视频一致性可能稳定地跟错对象
SAM 2将可提示分割扩展到视频语境,记忆有助于跨帧传播,同时也可能延续早期误差。时间平滑和轨迹连贯不保证身份或边界正确,遮挡、重新出现与相似物体交换需要专门测试。应记录何时允许新提示、谁提供提示以及纠错次数,并把记忆重置和新镜头场景纳入验收。[2] SAM 2: Segment Anything in Images and Videos
5. 分割与语义识别的证据不同
掩码指出哪些像素属于目标区域,不必然给出正确的物种、病理或材料类别。CLIP式表示关注图文对应,也不自动提供精确像素边界。将二者组合时需分别验证定位与语义,特别是专业领域。公开自然图像上的强表现不能直接视为医学、遥感或显微图像的可用证明,应使用合法领域标注并明确误差代价。[3] Learning Transferable Visual Models From Natural Langua[1] Segment Anything
6. 复核应固定提示预算和数据划分
按图像来源或视频序列隔离划分,防止相邻帧泄漏;预先确定提示生成和候选选择规则。报告IoU、边界质量、对象丢失和交互成本,按尺寸、遮挡及领域分层。本文矩形例子仅证明边界位移与IoU的关系,不能替代实际复杂形状和模型评估。真实部署还需要版本化缓存、失败回退与人工纠错路径。[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos
核心公式与推导
(1) M为预测、G为标注;空集合与歧义标注应另定规则。
LaTeX
\operatorname{IoU}=\frac{|M\cap G|}{|M\cup G|}=\frac{TP}{TP+FP+FN}(2) 两个等大矩形仅水平平移d、垂直完全重叠时成立,图取w=100、高60。
LaTeX
\operatorname{IoU}(d)=\frac{w-d}{w+d},\qquad0\le d\le w(3) 复用编码的后续交互和首次处理应分别计时;本文未进行模型时延实测。
LaTeX
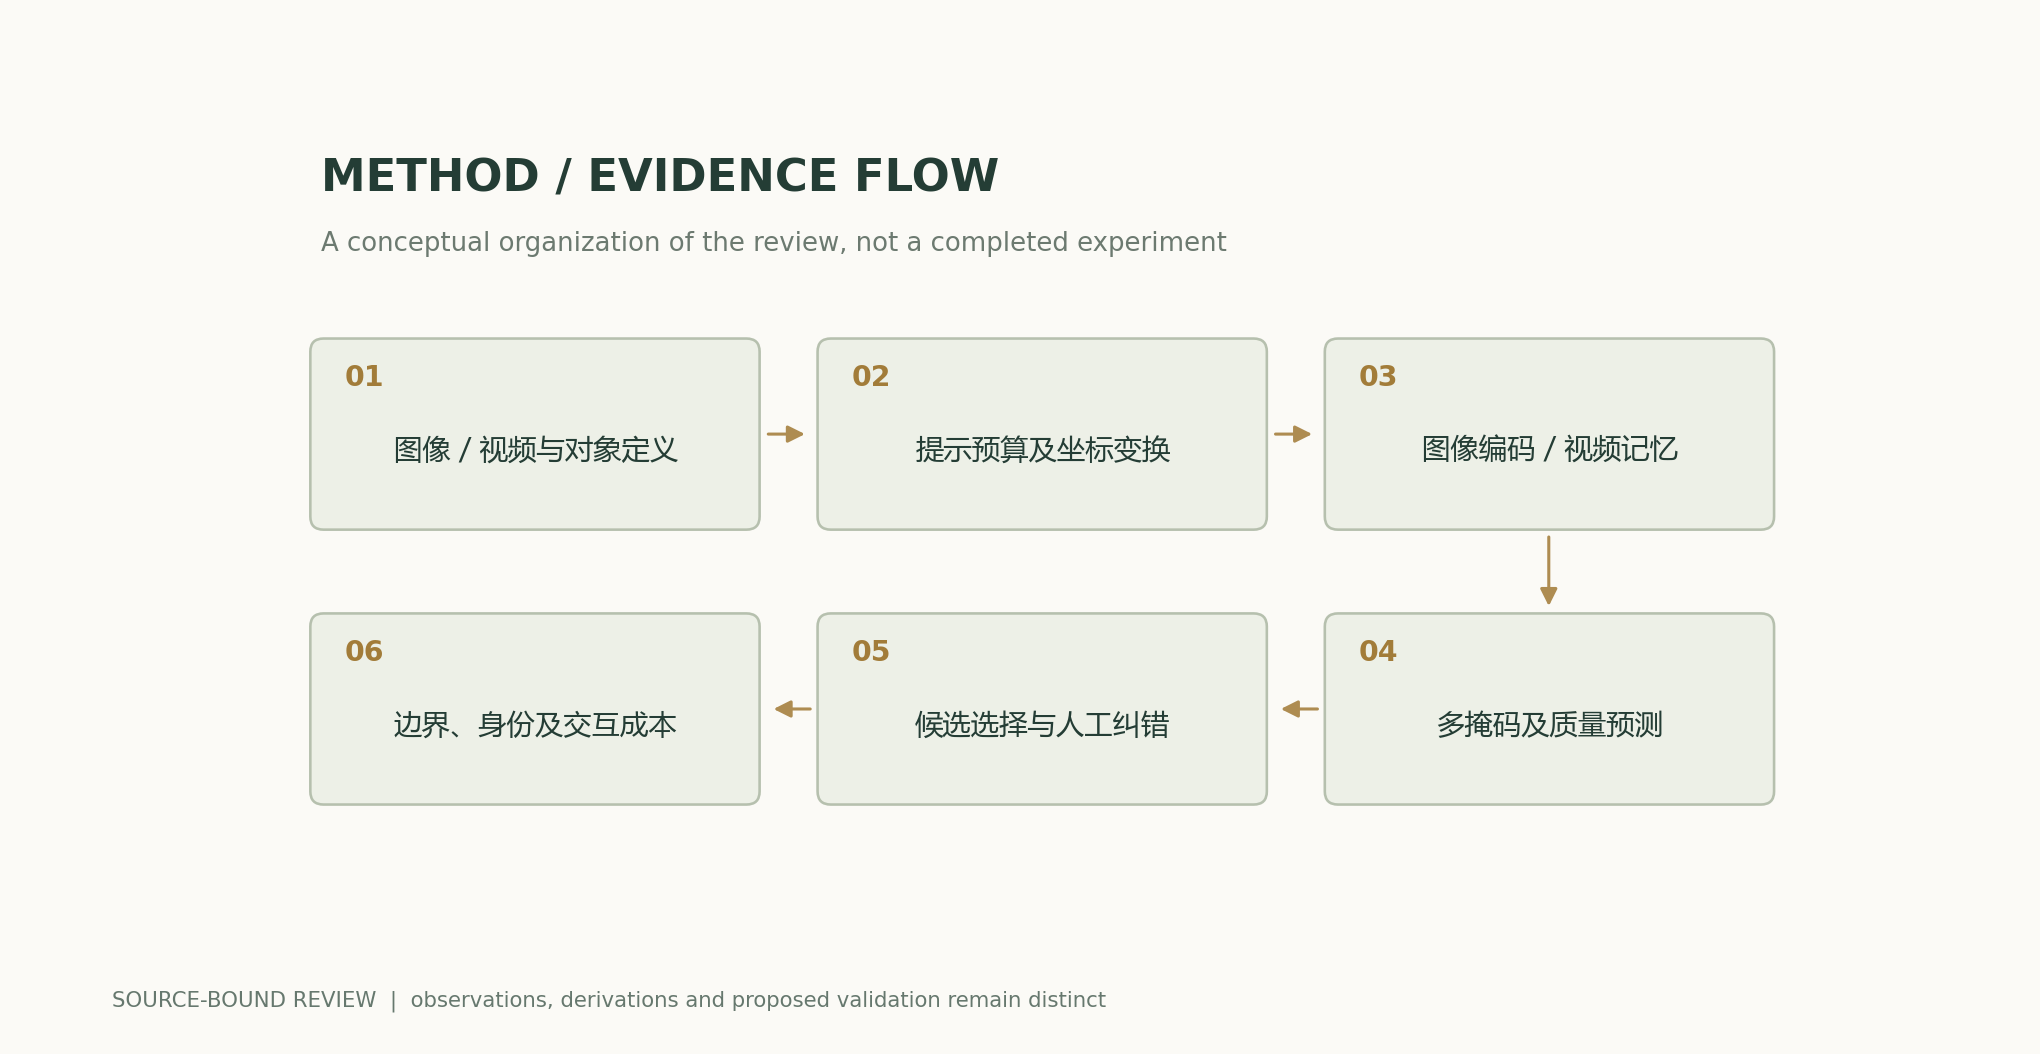
\tau_{\mathrm{interaction}}=\tau_{\mathrm{prompt}}+\tau_{\mathrm{decode}},\quad\tau_{\mathrm{first}}=\tau_{\mathrm{encode}}+\tau_{\mathrm{interaction}}方法与证据流程
解析图与数值示例
可复算例题
水平移动10像素时IoU=90/110≈0.818;移动25像素时为75/125=0.6。复杂边界与标注歧义不能由这个矩形模型完全描述。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 提示协议 | 固定点/框来源、交互次数和对象定义 | 人工事后选择会抬高结果 |
| 候选质量 | 区分预测选择与真值最佳选择 | 预测分数不是标注 |
| 视频记忆 | 测遮挡、重现、换镜和纠错 | 时间一致可能持续跟错对象 |
| 领域迁移 | 独立领域标注与风险分层 | 自然图像成绩不能直接外推 |
复核与实验方案
- 冻结模型、预处理、对象定义与合法标注版本。
- 按来源/视频划分,防止相邻帧或同图变体泄漏。
- 预先固定提示与候选选择预算,记录所有纠错。
- 测试小目标、边界、遮挡、相似对象、重现和新镜头。
- 联合报告重叠、边界、身份丢失、交互次数及分层失败。
- 分别测首次编码与缓存交互成本,核对缓存版本和坐标变换。
适用范围与局限
- 矩形IoU不是SAM成绩。
- 时间一致不证明身份正确。
- 领域迁移需要独立标注。
- 提示和候选预算影响比较。
一手来源与主张对应
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SAM 2: Segment Anything in Images and Videos, , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled SAM 2: Segment Anything in Images and Videos, by Nikhila Ravi and 17 other authors · 2024-08-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer