
要旨
ツールの接続により、言語モデルは外部システムに影響を及ぼせるようになる一方、権限、再試行、時間的順序、結果に関する不確実性も生じる。本稿では、エージェントの過程を明確な事前条件と事後条件を持つ状態遷移として記述し、タイムアウト後に直ちに失敗とみなして再試行してはならない理由と、タスクの成功を外部状態に照らして確認する必要がある理由を論じる。条件付き信頼性の解析、冪等性と結果照合のプロトコルを補足し、拒否、遅延、応答確認の喪失、並行変更を含む評価行列を提案する。論文に記載されたタスクベンチマークの結果は原著者に帰属する。本サイトでは、自律エージェントの新たな実運用実験を実施していない。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[2] Toolformer: Language Models Can Teach Themselves to Use[3] WebArena: A Realistic Web Environment for Building Auto
原文の英語要旨の日本語訳
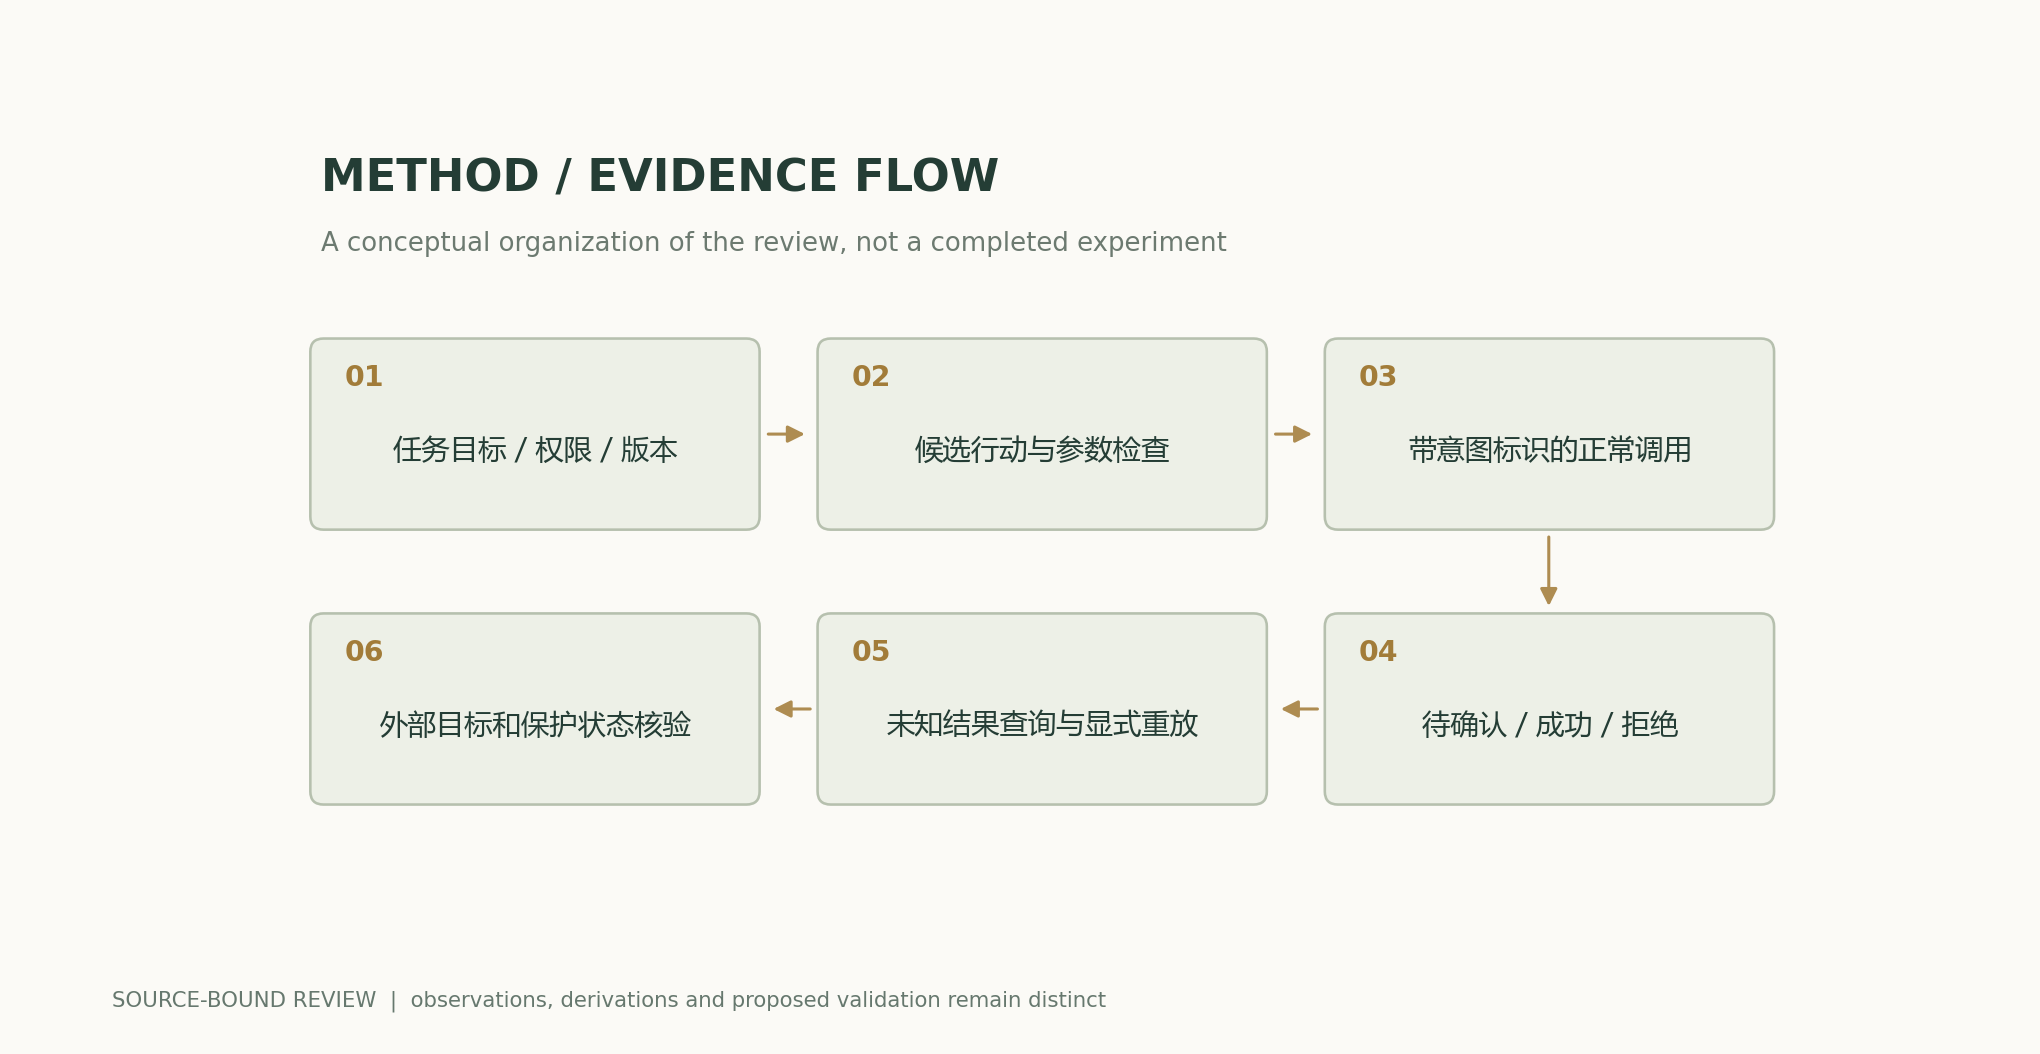
ツール使用型エージェントを分散意思決定システムとして解析する。本レビューでは、提案された行動、実行を許可された操作、外部で確認された結果を区別し、単純な連鎖信頼性モデルを導出するとともに、不確かな応答に対して冪等性と照合がどのように対処するかを規定する。タスクの成功は、エージェント自身の説明ではなく、外部状態に照らして確認しなければならない。ワークフロー図は工学的解析であり、自律的な運用の証拠ではない。
1. ReActは更新可能な観察ループを導入する
ReActは推論と行動を交互に構成し、外部からの観察が次のステップに影響できるようにする。完全な計画を一度に生成する方法と比較すると、この構造は環境の変化を確認し、行動を調整する機会を設ける。ただし、観察の欠落、ページの誤読、誤った前提を自動的に解消するわけではない。システムがツールの返す実際の結果を確認しなければ、このループは失敗を連続して説明するだけにもなりうる。[1] ReAct: Synergizing Reasoning and Acting in Language Mod
2. Toolformerは呼び出しのタイミングと方法を学習する
Toolformerは、自己教師ありの方法で訓練資料に有用なAPI呼び出しを選択し、モデルにツール使用行動を学習させることを研究している。対象はツール呼び出し能力の学習であり、本番環境の完全な権限制度ではない。正しいAPIパラメータを生成できること、アカウントの認可を得ること、副作用を確認すること、再試行を処理することは、それぞれ異なる層の条件である。運用システムは、引き続きモデルの外側でこれらの境界を制御する必要がある。[2] Toolformer: Language Models Can Teach Themselves to Use
3. WebArenaは目標状態によってタスクを検証する
WebArenaは実行可能なウェブサイト環境と多数のステップにわたるタスクを提供し、機能的な結果がユーザーの意図を満たすかどうかに評価の重点を置く。操作経路の文章表現が異なっていても、同じ有効な終端状態に到達する場合がある。逆に、行動の説明が例と似ていても、データが保存されていない場合がある。論文の過去のベースラインは、そのモデル、環境、時点に固有のものであり、本稿ではこれらの結果から現在のブラウザエージェントの能力を推定しない。[3] WebArena: A Realistic Web Environment for Building Auto
4. 長いタスクに回復機構が必要な理由
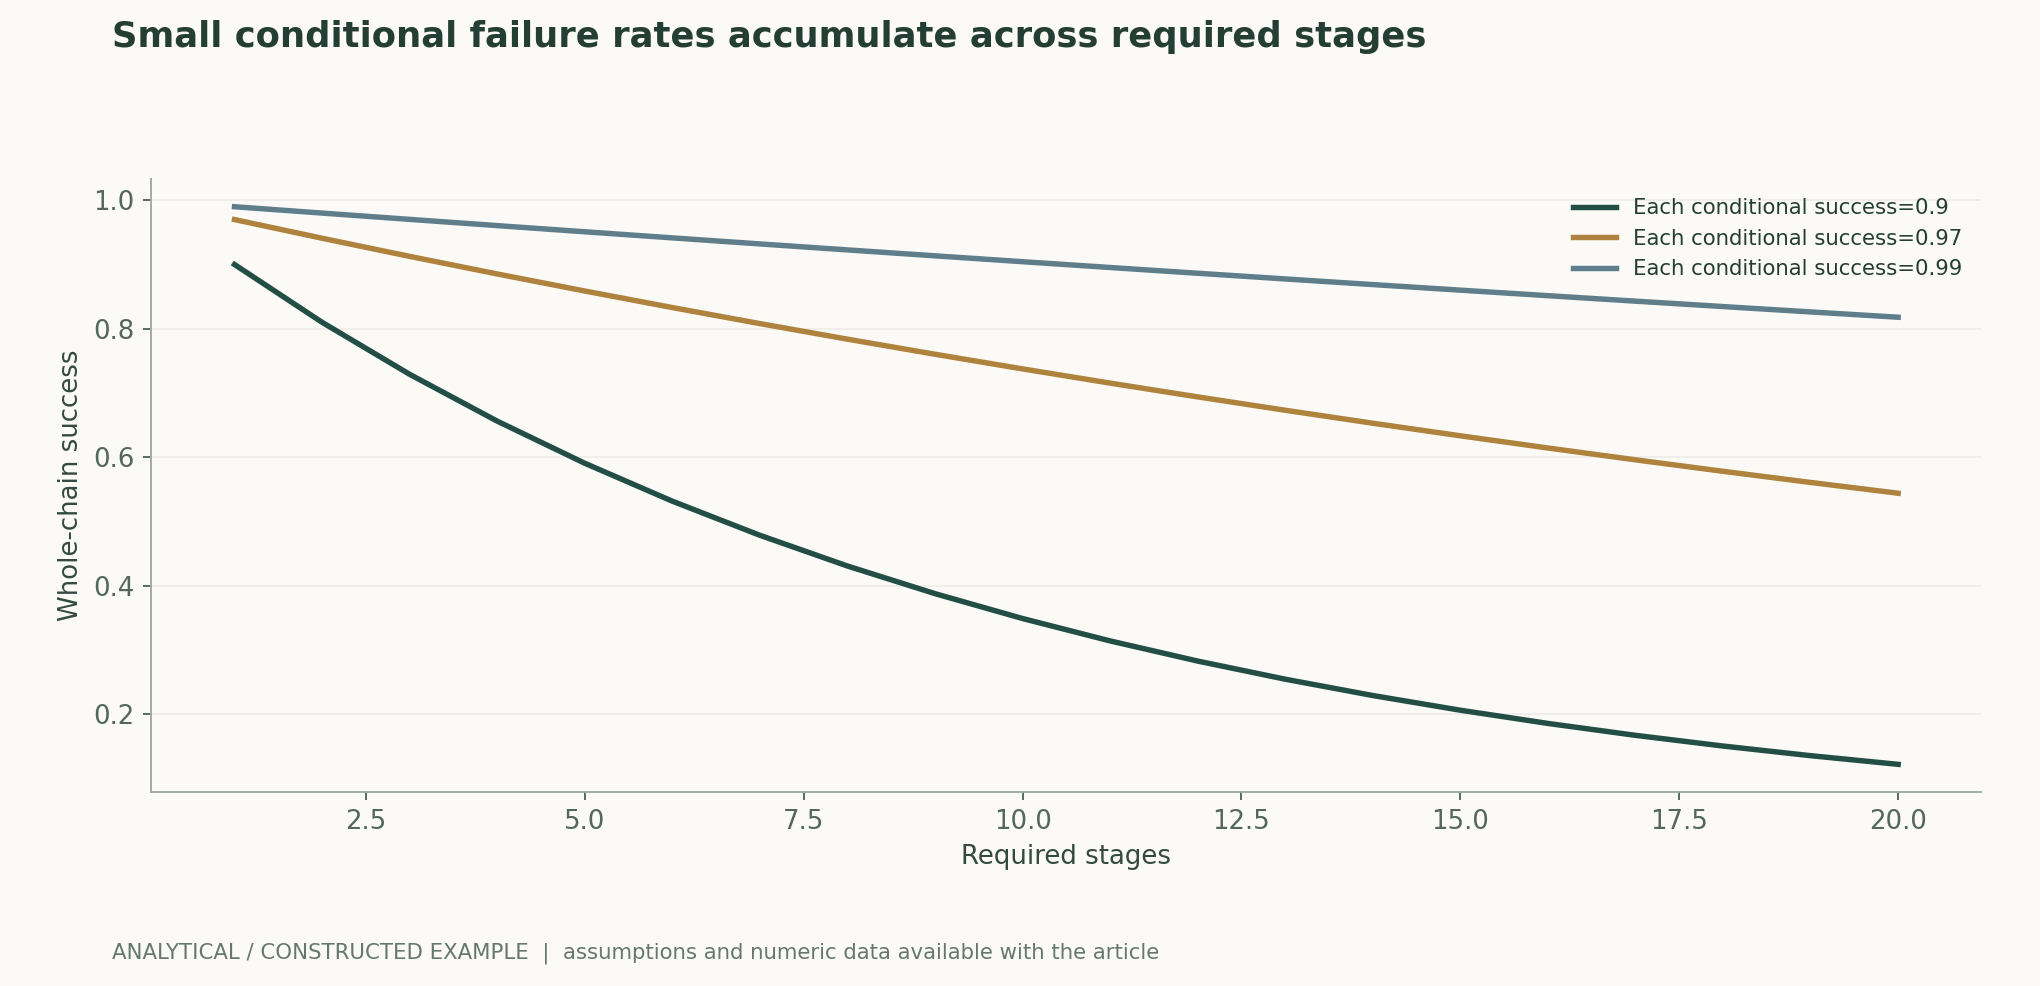
それ以前の全ステップが成功したという条件の下で、各ステップの成功確率が一定のpであり、いずれかのステップの失敗によってタスク全体が失敗すると仮定すると、nステップすべてが成功する確率はpのn乗となる。本版の図2は、p=0.90、0.97、0.99を用いて条件付き確率の連鎖積を示す。実際のシステムにおける再試行、相関した障害、回復行動、分岐は、これらの条件付き確率を変化させるため、曲線から実際の成功率を直接推定することはできない。この図は、単一ステップだけでなく、タスク全体を測定すべきことを示唆する。作者分析与复核建议 / Author analysis
5. 観察と外部コンテンツを意思決定にどう取り込むべきか
本稿では、ユーザーの目標、システム権限、外部資料を分離して保存することを推奨する。ウェブページ、文書、ツール出力は観察対象であり、その中に「元の要件を無視せよ」と書かれていても、それによってタスクの認可を変更してはならない。アカウントの変更、メッセージ送信、公開については、実行層が既存の権限と明示されたタスク範囲に基づいて判断すべきであり、ページの文章をユーザーからの新たな指示として扱ってはならない。これはシステム設計上の提言である。作者分析与复核建议 / Author analysis
6. 再試行では副作用を考慮しなければならない
読み取りの失敗後に再試行することと、すでに成功している可能性のある書き込みの後に再試行することでは、意味が異なる。送信操作には冪等性識別子、または照合可能な結果状態が必要である。タイムアウトによって結果が不明になった場合、まず実際の状態を問い合わせるべきである。「呼び出しが成功を返さなかった」という理由だけで「操作は行われなかった」と推論すると、コンテンツや取引の重複が生じうる。ツールのインターフェースは、失敗、成功、結果不明を区別して表現すべきである。作者分析与复核建议 / Author analysis
7. 受け入れ検証で確認すべき証拠
タスクの記録には、少なくとも初期状態、目標状態、許可された行動、停止条件、受け入れ検証方法を明記する。成功はエージェントの自己申告だけで判断せず、独立した読み取り、保存後の再読み取り、または環境内の実行可能な判定によって確認すべきである。タイムアウト、回復回数、人間の介入も報告する必要がある。重要なステップを人間が修正しなければならない場合、完全自動の成功ではなく、人間とエージェントの協働による完了として記録すべきである。[3] WebArena: A Realistic Web Environment for Building Auto
状態の確認と言語による確認を混同してはならない
ウェブサイトのタスクでは、ページに「保存中」と表示される状態と、データが永続化された状態は異なる。信頼できる受け入れ検証では、保存後の新たな読み取りによって目標値を確認できる必要があり、必要に応じてバージョンやトランザクション識別子を調べる。不可逆な行動については、実行前の確認と実行後の再読み取りはそれぞれ異なる役割を持ち、互いに代替できない。妥当に見える行動が数回連続していても、最終状態の証拠がなければ、タスク完了を証明するには不十分である。作者分析与复核建议 / Author analysis
8. 行動、実行許可、結果には異なる状態が必要である
モデルがツール呼び出しを出力したことは、意図が提案されたことしか意味しない。権限サービスが要求を受け付けたことは、その時点の実行許可条件を通過したことを意味する。完了の証拠となるのは、最終的な外部状態が目標と一致することである。状態機械は、少なくとも未送信、送信済み未確認、成功確認済み、拒否確認済み、人間による処理が必要、を区別すべきである。各遷移を実行主体、パラメータの要約、対象バージョンに結び付け、後続ステップが別のオブジェクトへの応答確認を今回の結果として扱うことを防ぐ。自然言語による「完了」が業務状態を直接駆動すべきではない。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[2] Toolformer: Language Models Can Teach Themselves to Use
9. タイムアウトが生むのは結果不明の状態である
サーバーがトランザクションをコミットした後に応答が失われた場合、クライアントから見えるタイムアウトは、サーバーがまだ操作を実行していない場合のタイムアウトとまったく同じに見える可能性がある。無条件に新しい要求を生成すると、副作用が重複しうる。冪等性キーは同じ意図とパラメータに結び付け、結果をサーバー側で保存する必要がある。同じキーでパラメータが変更された場合は、上書きではなく拒否すべきである。状態が不明な場合は、まず対象バージョンまたは操作の応答確認を問い合わせ、その後、同一キーで明示的に再実行するかどうかを判断する。これは分散システムの設計原則であり、モデルへのプロンプトに「繰り返さないこと」と記すだけでは代替できない。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[3] WebArena: A Realistic Web Environment for Building Auto
10. 複数段階のタスクで弱点がどのように累積するか
各段階の条件付き成功確率がいずれもpで、各段階が独立であれば、Lステップすべてが成功する確率はp^Lである。実際のツール処理フローは通常、独立ではない。初期の状態誤りが後続の入力を変え、共有ログインやネットワークが共通の障害をもたらすためである。したがって、この式は解析上の参照にすぎず、より一般的な表現では一連の条件付き確率を用いるべきである。評価では、最終結果を観察するとともに、各段階の失敗分類を保存し、計画の誤り、パラメータの誤り、権限による拒否、外部サービスの異常を区別する必要がある。[3] WebArena: A Realistic Web Environment for Building Auto[2] Toolformer: Language Models Can Teach Themselves to Use
11. 結果の評価には外部状態と予算が必要である
ウェブエージェントは正しいボタンをクリックしても、実際には送信していない場合がある。また、変更すべきでない別のフィールドを変更する場合もある。受け入れ検証では、インターフェースの成功通知だけを基準とせず、タスクで指定された状態と保護対象の状態を照合すべきである。ツール呼び出し回数、モデルのリソース消費、遅延、人間の介入も記録する必要がある。システム層でのデコード高速化は、ある段階を短縮できても、状態機械や業務検証の誤りを修正しない。方式を比較する際は、モデルの意思決定、ツールプロトコル、実行システムの寄与をそれぞれ分けて帰属させるべきである。[3] WebArena: A Realistic Web Environment for Building Auto[4] Fast Inference from Transformers via Speculative Decodi
主要な数式と導出
(1) 一般的な連鎖分解は独立性を必要としない。各ステップの成功確率が固定され、各ステップが独立である場合に限り、pのL乗に簡略化できる。
LaTeX
P(S_1,\ldots,S_L)=\prod_{i=1}^{L}P(S_i\mid S_1,\ldots,S_{i-1})(2) 冪等性識別子は、明確な実行主体と意図の要約に関連付けるべきである。これはプロトコル上の制約であり、内容のハッシュによって行動の実際の完了を証明するものではない。
LaTeX
\mathrm{IntentID}\longmapsto H(\mathrm{actor},\mathrm{target},\mathrm{version},\mathrm{parameters})(3) タスク評価では、目標とする変更と、変更が許されない状態の両方を考慮する。両者の検査規則は実行前に定めるべきである。
LaTeX
\mathrm{Success}=\mathrm{TargetSatisfied}\ \land\ \mathrm{ProtectedStatePreserved}方法と証拠のフロー
解析図と数値例
再計算可能な例題
それ以前の成功を条件とする各ステップの成功確率がすべて0.97である場合、20ステップからなる連鎖全体の成功率は約0.544となる。回復、再試行、外部状態によってこれらの条件付き確率は変わりうるため、この数値から実際のエージェント製品の性能を推定することはできない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と説明 |
|---|---|---|
| モデルによる完了の自己申告 | 外部システムの状態、対象バージョン、操作の応答確認 | 自己申告は実際の実行の証拠にはならない |
| タイムアウト後の再試行 | 元の意図識別子を保持し、まず照会してから同一キーで再実行する | 新しいキーでの再送は副作用を重複させる可能性がある |
| 長い連鎖の成功率 | 段階ごとの条件付き失敗と共通障害の分類 | p^Lは実際の相関構造の代わりにはならない |
| タスクベンチマーク | 目標状態と保護対象状態をともに検証し、予算を考慮する | 成功ボタンや少数の例だけでは、一般的な信頼性を証明できない |
検証と実験の計画
- タスク目標、変更を禁止する状態、許可するツール、最小限の権限をあらかじめ定義し、外部ウェブページの内容をシステム指示として扱わない。
- 各書き込み行動について、意図識別子、パラメータの要約、対象バージョンを設定する。同一キーで異なるパラメータを使用した場合は、明示的に拒否する。
- コミット前の失敗、コミット後の応答確認の喪失、応答遅延を注入し、結果不明の状態が自動的に成功または失敗と宣言されず、照合待ちとして保持されることを確認する。
- 二つの実行主体が同時に対象を変更する場合のバージョン競合を検証し、応答が後から到着する古い行動が新しい状態を上書きしないようにする。
- タスク終了時に外部結果を独立して読み取り、保護対象状態を照合する。拒否、人間の介入、部分的完了の記録を保持する。
- 成功率を集計する際は、ツール呼び出し回数、モデルのリソース消費、遅延、タスク難度別の層別結果も併記し、選別された成功軌跡だけを提示することを避ける。
適用範囲と限界
- ツールの結果は、外部システムと権限条件の影響を受ける。
- 独立した段階の曲線は、解析上の参照にすぎない。
- 冪等性にはサーバー側のプロトコルによる支援が必要である。
- 実際の外部環境におけるエージェント採用や自律的運用に関する新たな実績は示していない。
一次資料と主張の対応
- ReAct: Synergizing Reasoning and Acting in Language ModelsYao et al. · 2022-10-06v3; method and experiments
- Toolformer: Language Models Can Teach Themselves to Use ToolsSchick et al. · 2023-02-09abstract; training tool-use behavior
- WebArena: A Realistic Web Environment for Building Autonomous AgentsZhou et al. · 2023-07-25v4; abstract, benchmark and functional evaluation
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、列挙された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿について独立した査読または独自のモデル実験を行った記録はない。
リーダーの性能改訂:直近のHEAD要求が200を返し、ETagが同じである場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学的な図解は分離している。科学図は公開された数式と明示的な仮定から計算し、原著論文の結果はすべて帰属を明記している。
著者、バージョン、訂正履歴 · /guides/agents-tools-and-outcomes/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770