
摘要
工具接入使语言模型能够影响外部系统,也引入了权限、重试、时序和结果不确定性。本文将Agent过程写成有明确前后条件的状态转换,讨论超时后为什么不能直接当作失败重试,以及任务成功为何必须回到外部状态核对。我们补充条件式可靠性分析、幂等与结果对账协议,并提出包含拒绝、延迟、丢回执和并发修改的评价矩阵。论文中的任务基准结果属于原作者;本站没有新增自主Agent线上实验。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[2] Toolformer: Language Models Can Teach Themselves to Use[3] WebArena: A Realistic Web Environment for Building Auto
English abstract
Tool-using agents are analyzed as distributed decision systems. The review distinguishes proposed actions, admitted operations and externally confirmed outcomes; derives a simple chain-reliability model; and specifies how idempotency and reconciliation handle uncertain responses. Task success must be checked against external state rather than an agent's own narration. The workflow diagrams are engineering analyses, not evidence of autonomous deployment.
1. ReAct 引入可更新的观察循环
ReAct 将推理与动作交替组织,使外部观察能够影响下一步。和一次生成完整计划相比,这种结构为检查环境变化与调整行动提供了位置。它并不自动解决观察缺失、误读页面或错误前提;如果系统没有检查工具返回的实际结果,循环也可能只是对失败进行连续叙述。[1] ReAct: Synergizing Reasoning and Acting in Language Mod
2. Toolformer 学习何时与如何调用
Toolformer 研究通过自监督方式为训练材料选择有用的 API 调用,让模型学习工具使用行为。它针对的是工具调用能力的学习问题,不是生产环境的完整权限制度。能够生成正确 API 参数,与获得账户授权、确认副作用以及处理重试,是不同层面的条件。部署系统仍需在模型之外控制这些边界。[2] Toolformer: Language Models Can Teach Themselves to Use
3. WebArena 用目标状态检验任务
WebArena 提供可运行的网站环境与长程任务,把评估重点放在功能结果是否满足用户意图。两条操作路径即使文字不同,也可能达到同一有效终态;相反,动作描述与示例相似,却可能没有保存数据。论文中的历史基线属于其模型、环境与时间点,本文不用这些结果推断当前浏览器智能体的能力。[3] WebArena: A Realistic Web Environment for Building Auto
4. 长任务为什么需要恢复机制
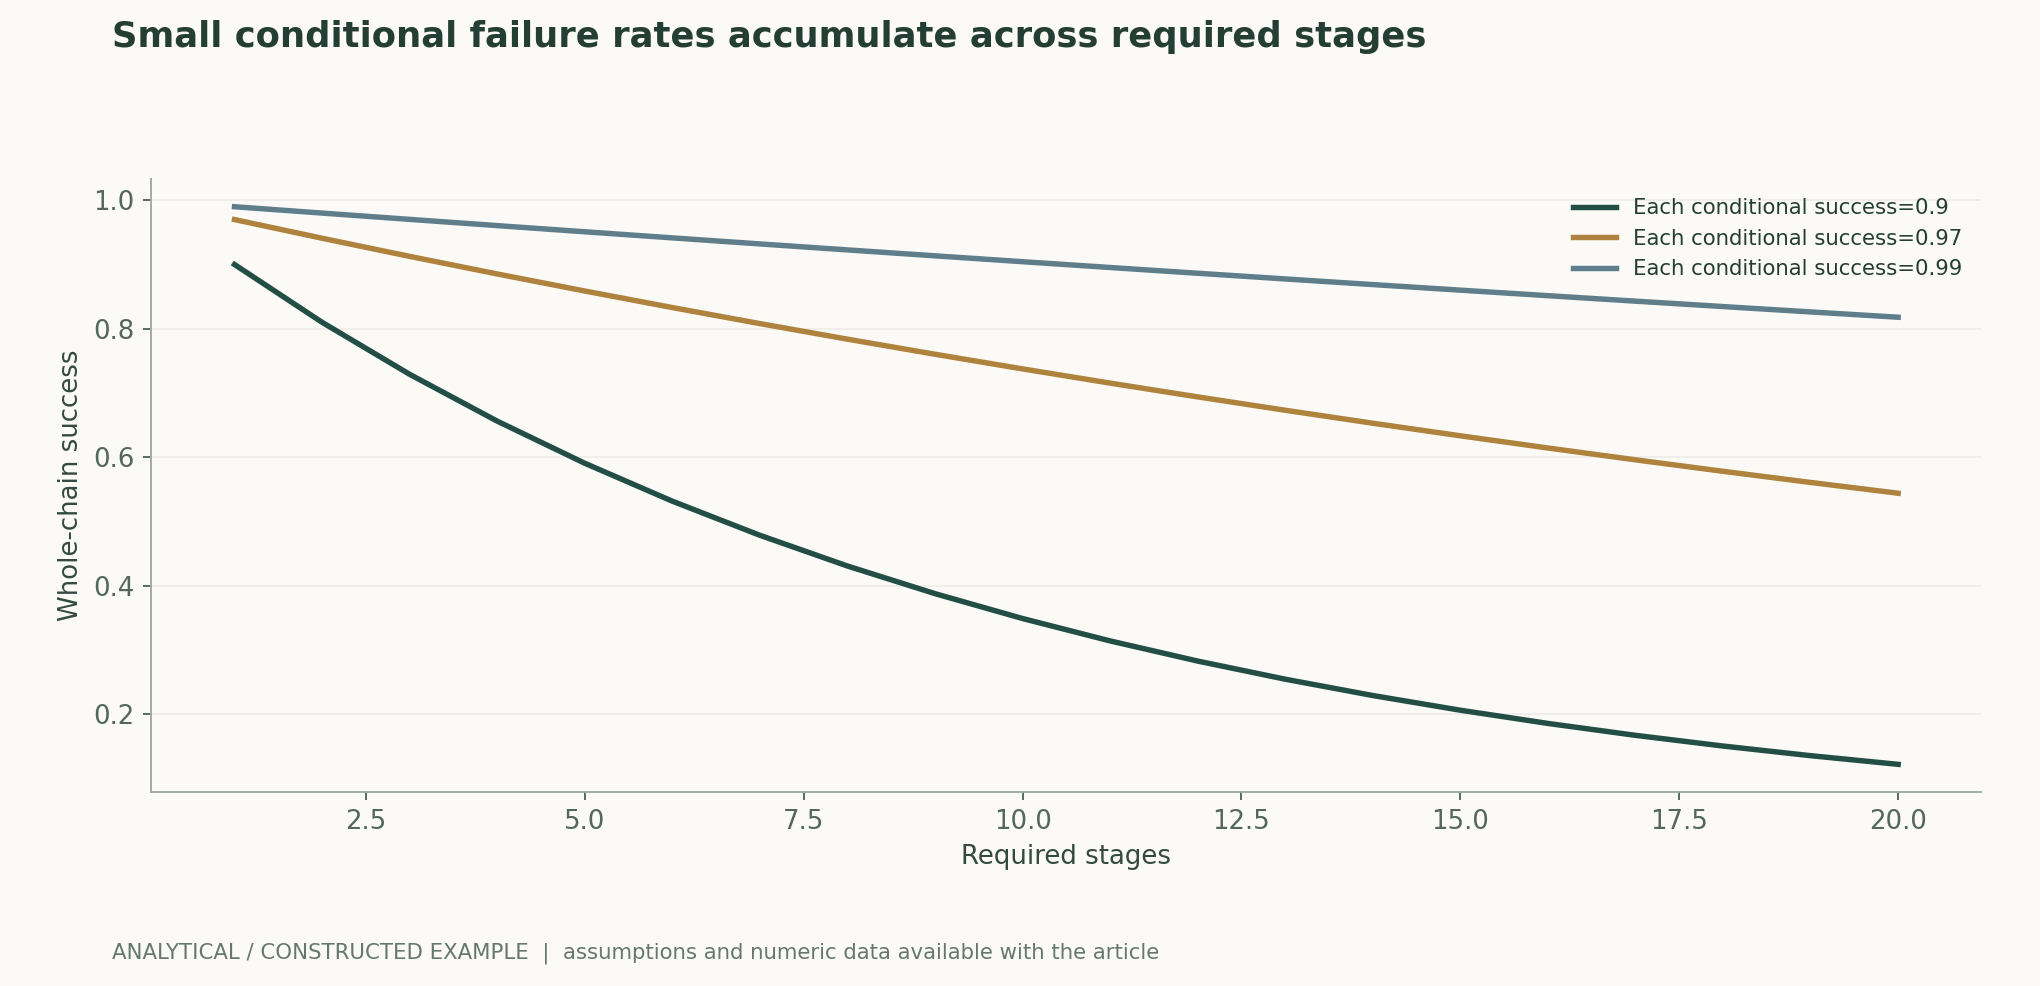
假设每一步在此前全部成功条件下的成功率恒为p,且任何一步失败都会使整个任务失败,则n步全成功概率为p的n次方。本版图2取p=0.90、0.97与0.99展示条件链乘积。真实系统的重试、相关故障、恢复动作和分支会改变这些条件概率,因此不能用曲线直接估计真实成功率;它提示应测量完整任务,而不只测单步。作者分析与复核建议 / Author analysis
5. 观察与外部内容应如何进入决策
本文建议把用户目标、系统权限与外部材料分开保存。网页、文档和工具输出属于观察对象;即使其中写着“忽略原要求”,也不能因此改变任务授权。对于账户修改、发信或发布,执行层应依据已有权限和明确任务范围决定,而不能把页面文本当成来自用户的新指令。这里是系统设计建议。作者分析与复核建议 / Author analysis
6. 重试必须考虑副作用
读取失败后重试,和已经可能成功的写入后重试,含义不同。提交动作需要幂等标识或可核对的结果状态;若超时导致结果未知,应先查询实际状态。只用“调用没有返回成功”推断“操作没有发生”,可能产生重复内容或重复交易。工具接口应将失败、成功与未知结果区分表达。作者分析与复核建议 / Author analysis
7. 验收应该看到哪些证据
一次任务记录至少说明起始状态、目标状态、允许动作、停止条件与验收方法。成功不能仅凭智能体自述,应由独立读取、保存后的回读或环境内的可执行判定确认。还应报告超时、恢复次数和人工介入。若必须让人修正关键一步,就应把它记录为人机协作完成,而不是全自动成功。[3] WebArena: A Realistic Web Environment for Building Auto
状态确认与语言确认不能混为一谈
在网站任务中,页面显示“正在保存”与数据已经持久化是不同状态。可靠验收应能从保存后的新读取看到目标值,必要时检查版本或事务标识。对于不可逆动作,执行前的确认与执行后的回读各有用途,不能互相替代。连续几次看似合理的动作,若没有最终状态证据,仍不足以证明任务已经完成。作者分析与复核建议 / Author analysis
8. 动作、准入和结果必须有不同状态
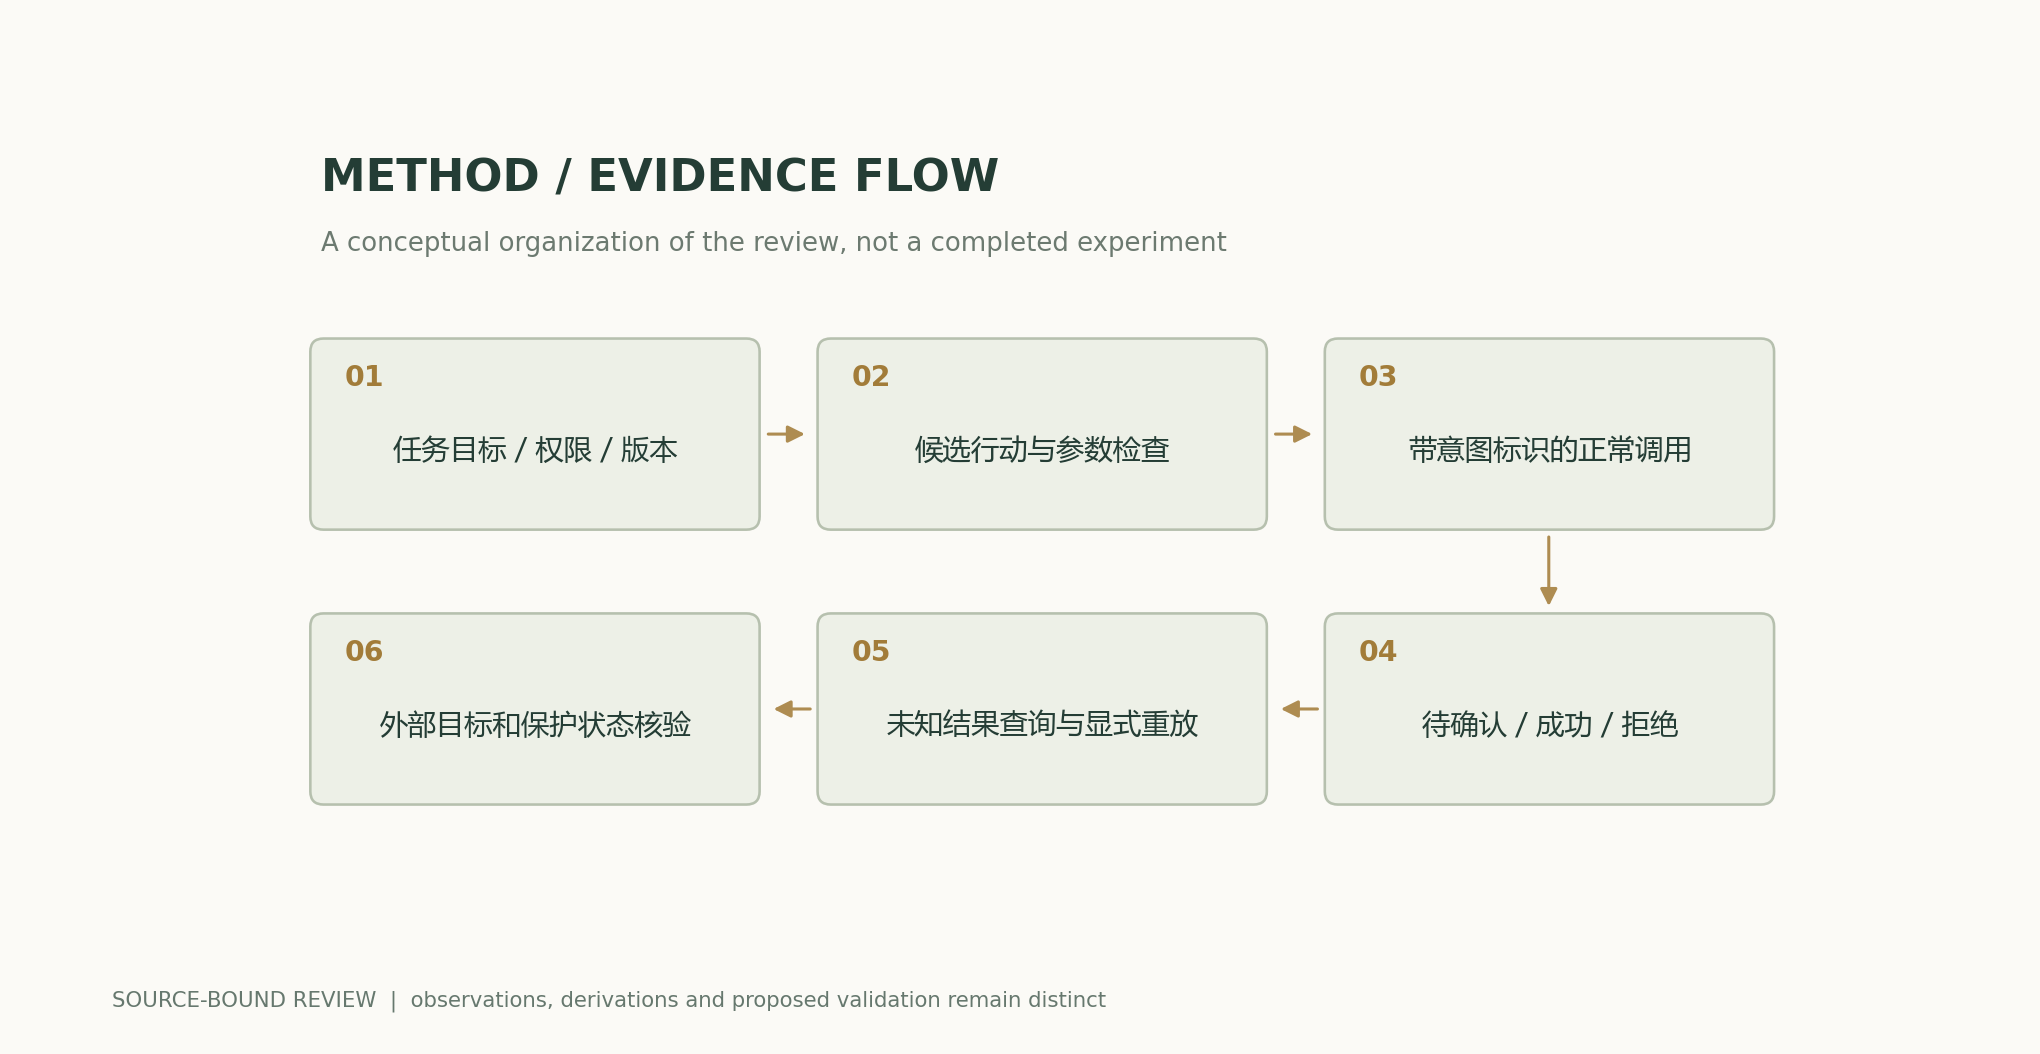
模型输出一个工具调用,只说明提出了意图;权限服务接受请求,说明它通过当时的准入;最终外部状态符合目标,才构成完成证据。状态机至少应区别未发送、已发送未确认、确认成功、确认拒绝和需要人工处理。每次转换绑定主体、参数摘要和目标版本,避免后续步骤把另一个对象的回执当作本次结果。自然语言中的“已完成”不应直接驱动业务状态。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[2] Toolformer: Language Models Can Teach Themselves to Use
9. 超时产生的是未知结果
当服务端已提交事务而响应丢失时,客户端看到的超时与服务端尚未执行时的超时可能完全相同。盲目生成新请求可能造成重复副作用。幂等键需要绑定同一意图和参数,并由服务端保存结果;如果同键参数改变,应拒绝而不是覆盖。遇到未知状态先查询目标版本或操作回执,再决定是否显式同键重放。这里描述的是分布式系统设计原则,不能由模型提示词中的“不要重复”替代。[1] ReAct: Synergizing Reasoning and Acting in Language Mod[3] WebArena: A Realistic Web Environment for Building Auto
10. 多步骤任务的弱环节如何累积
如果各阶段条件成功率均为p且独立,L步全部成功的概率为p^L。实际工具流程通常不独立:早期状态错误会改变后续输入,共用登录或网络又会引入共同失败。因此该公式只是解析参照,更一般的表达应使用一连串条件概率。评价时既要观察最终结果,也要保存每个阶段的失败类别,区分规划错误、参数错误、权限拒绝和外部服务异常。[3] WebArena: A Realistic Web Environment for Building Auto[2] Toolformer: Language Models Can Teach Themselves to Use
11. 结果评价需要外部状态与预算
网页Agent可能点击了正确按钮,却未真正提交;也可能改变了不该改变的其他字段。验收应核对任务指定状态及受保护状态,而不是仅以界面出现成功提示为准。还需要记录工具调用次数、模型消耗、时延和人工介入。系统层的解码加速可以缩短某一阶段,却不修复状态机或业务校验错误;比较方案时应分别归因模型决策、工具协议和运行系统的贡献。[3] WebArena: A Realistic Web Environment for Building Auto[4] Fast Inference from Transformers via Speculative Decodi
核心公式与推导
(1) 一般链式分解不要求独立。只有在每一步成功率都固定且独立时,才可简化为p的L次方。
LaTeX
P(S_1,\ldots,S_L)=\prod_{i=1}^{L}P(S_i\mid S_1,\ldots,S_{i-1})(2) 幂等标识应关联明确的执行主体和意图摘要;这是一种协议约束,不是凭内容哈希证明实际完成动作。
LaTeX
\mathrm{IntentID}\longmapsto H(\mathrm{actor},\mathrm{target},\mathrm{version},\mathrm{parameters})(3) 任务评价同时考虑目标变化和不允许变化的状态。两者的检查规则应在运行前确定。
LaTeX
\mathrm{Success}=\mathrm{TargetSatisfied}\ \land\ \mathrm{ProtectedStatePreserved}方法与证据流程
解析图与数值示例
可复算例题
若每一步在此前成功条件下成功率均0.97,20步全链成功率约0.544。恢复、重试与外部状态可改变这些条件概率,不能用此数估计真实Agent产品。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 模型自述完成 | 外部系统状态、目标版本与操作回执 | 自述不构成实际执行证据 |
| 超时后重试 | 保留原意图标识,先查询再同键重放 | 新键重发可能重复副作用 |
| 长链成功率 | 逐阶段条件失败与共同故障分类 | p^L不能替代真实相关结构 |
| 任务基准 | 同时核验目标和受保护状态,计入预算 | 成功按钮或少量样例不能证明普遍可靠 |
复核与实验方案
- 预先定义任务目标、禁止改变的状态、允许工具和最小权限,不把外部网页内容当作系统指令。
- 为每个写动作建立意图标识、参数摘要和目标版本;对同键不同参数设置明确拒绝。
- 注入提交前失败、提交后丢回执和延迟响应,确认未知结果保持待核对而非自动宣布成功或失败。
- 在两个执行者同时修改目标时检验版本冲突,避免后返回的旧动作覆盖新状态。
- 任务结束独立读取外部结果,并核对受保护状态;保留拒绝、人工介入和部分完成记录。
- 汇总成功率时同时列出工具次数、模型消耗、时延及任务难度分层,避免只展示挑选后的成功轨迹。
适用范围与局限
- 工具结果受外部系统和权限条件影响。
- 独立阶段曲线只是解析参照。
- 幂等性需要服务端协议支持。
- 没有新增真实外部Agent采用或自主部署成绩。
一手来源与主张对应
- ReAct: Synergizing Reasoning and Acting in Language ModelsYao et al. · 2022-10-06v3; method and experiments
- Toolformer: Language Models Can Teach Themselves to Use ToolsSchick et al. · 2023-02-09abstract; training tool-use behavior
- WebArena: A Realistic Web Environment for Building Autonomous AgentsZhou et al. · 2023-07-25v4; abstract, benchmark and functional evaluation
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/agents-tools-and-outcomes/v5/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770