
要旨
キャッシュの性能は、受け入れ、置換、ワークロードの履歴、ミスのコストに依存する。本レビューでは、TinyLFU、ARC、LeCaRを、構成したスキャン汚染の例および単純な人気度モデルと関連付ける。簡易的な頻度ゲートは、一度しか使われないオブジェクトの流れから小さなホットセットを保護する一方、通常のLRUキャッシュはそれを追い出す。解析図は、Zipf型の需要の下での固定キャッシュの理想的なヒット確率質量と、履歴頻度に対する指数的エージングの効果を示す。この分析では、これらの機構を、正しさに関する独立した責務である鮮度、認可、整合性から区別する。そこから得られる評価枠組みは、ヒット率を普遍的な目的とみなすのではなく、変化するワークロードの下で回避される有用な処理を測定する。
キャッシュには二つの選択判断がある
置換は、空き容量が必要になったときに、どの常駐項目を追い出すかを選択する。受け入れは、新たに要求された項目が、そもそも常駐項目を置き換えるべきかを選択する。すべてのミスで挿入を必須にすると、一度限りのスキャンによって価値あるワーキングセットが追い出されうる。
頻繁に再利用される四つの文書を保持するキャッシュを考える。その後、要求列が二十の異なる文書を一度ずつ参照してから、元の四つに戻る。LRUは自然に直近のスキャン項目を優先するため、ホットセットは失われる。頻度に基づく受け入れゲートは、スキャン項目を拒否し、ホットセットを保持できる。これは頻度が常に勝ることの証明ではない。真のワークロード変化によって、新しい項目に価値が生じる場合がある。設計上の課題は、一時的な新規性と新しいワーキングセットを十分速く見分けることである。
三つの研究アプローチ
TinyLFUは、頻度に基づく省スペースな受け入れ方策を開発し、置換機構と組み合わせる。ARCは、常駐情報と履歴情報を用いて、直近性と頻度の間のバランスを適応的に調整する。LeCaRは、学習の枠組みを用いて、基本的な置換動作の組み合わせを調整する。
これらの設計は、関連しつつも異なる判断を扱っており、公表された評価は特定のトレースとキャッシュサイズに関するものである。そこから普遍的な勝者を導くことはしない。むしろ、キャッシュ研究に向けた三つの問いを導く。受け入れを決める情報は何か、履歴はどれほど速く古くなるか、局所性が変化したときに方策はどう適応するか、という問いである。本記事の簡易実装は、三つのシステムのいずれよりも意図的に単純化されており、その旨を明記している。 [1], [2], [3]
スキャン汚染を示す決定論的な実例
付録では、四エントリのキャッシュに対し、ゼロから三までのキーを五回繰り返して要求し、ウォームアップを行う。次に二十の新しいキーを要求し、最後に四つのホットキーを再び参照する。通常のLRUではホットセットが失われている。候補の正確な観測頻度と、最後のアクセスが最も古い常駐項目の頻度を比較する簡易的な受け入れ方策は、一度限りのスキャンオブジェクトを拒否し、ホットなエントリを保持する。
この実例が示すのは、受け入れによってこのトレースの結果が変わりうることだけである。これはTinyLFU、ARC、LeCaRの実装ではなく、それらの相対的な性能を推定するものでもない。ワークロードを逆転させ、以前はコールドだったキーを繰り返し要求すれば、ゲートの適応上の問題が明らかになる。研究に両方のパターンを含めることで、ある方策に有利になるよう設計されたトレースだけでその方策を判断することを防げる。
理想的な静的キャッシュモデル
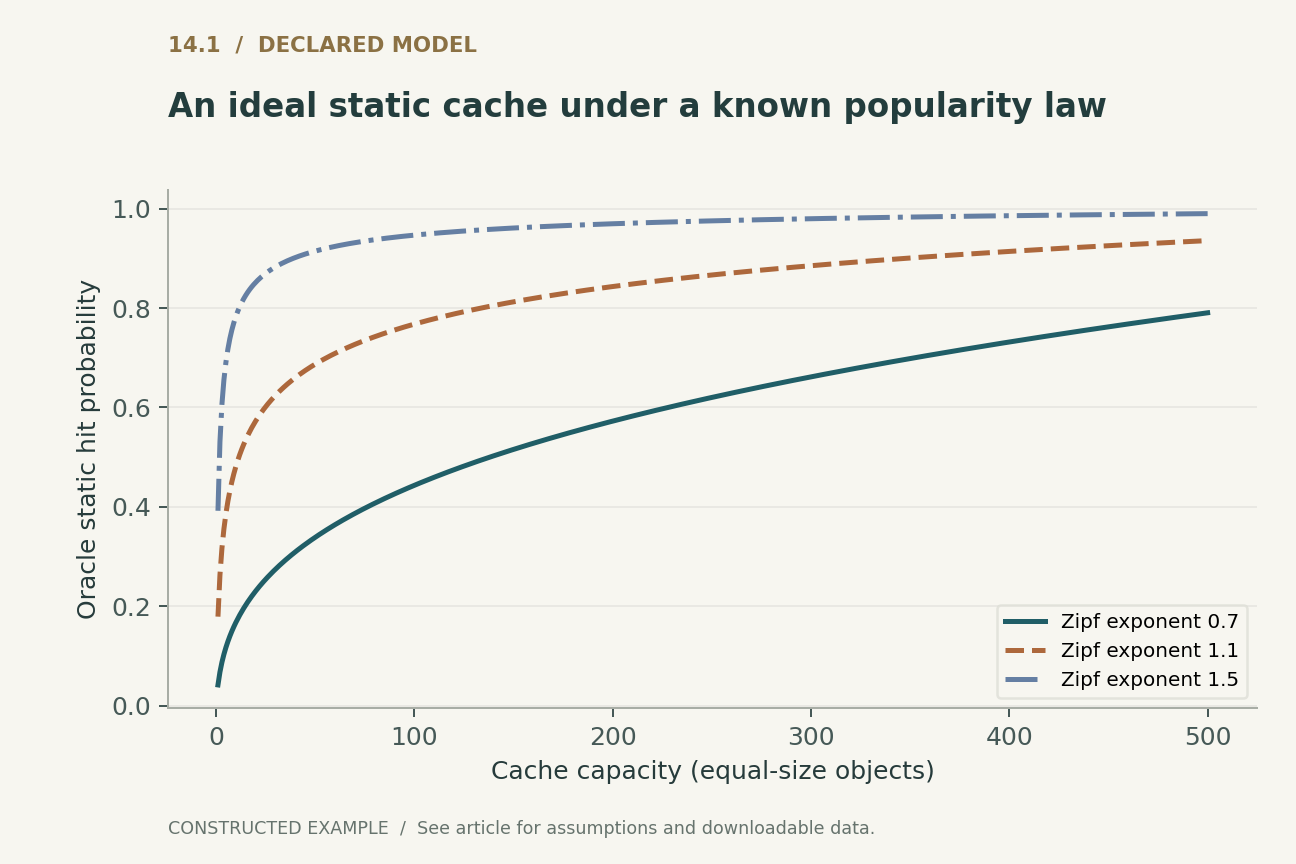
要求が、同じサイズのN個の項目に対して独立同分布であり、各ミスのコストが等しく、項目の確率が既知であると仮定する。容量Cの固定キャッシュは、確率が最も高いC個の項目を格納することでヒット確率を最大化する。その理想的なヒット確率質量は、それらの確率の総和である。
Zipf型分布では、確率は順位のマイナス・アルファ乗に比例し、N個の項目にわたる有限の正規化を行う。最初の図ではNを千に固定し、複数のアルファ値についてCを変化させる。この理想モデルでは、偏りが強いほど小さなキャッシュの価値が高まる。これは、明示した需要分布に対して完全な知識を仮定した静的な上界であり、LRUや適応方策の期待ヒット率ではない。学習、初回参照による強制ミス、更新、人気度の変化は含まない。
頻度には時計が必要である
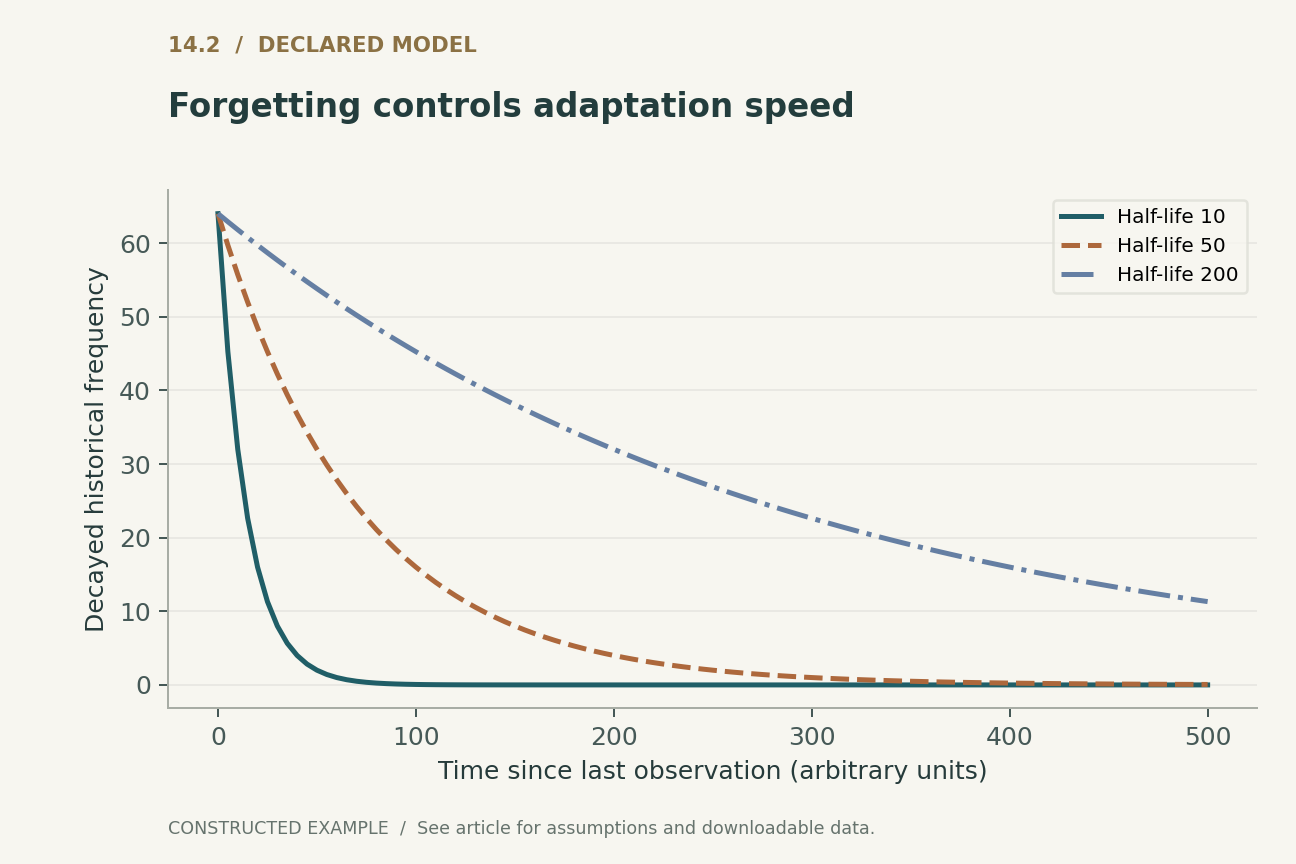
全期間にわたる正確な頻度カウントは、かつて人気だったオブジェクトが重要でなくなった後も、長く保持し続ける可能性がある。エージングは、その意味を「歴史的に頻繁」から「最近頻繁」へと変える。単純な指数減衰モデルでは、選択した時計に応じて、H時間単位ごと、またはH参照ごとにカウントが半分になる。
二番目の図は、履歴カウント64が複数の半減期の下でどう変化するかを示す。半減期が短いほど速く忘却するが、ノイズに過剰反応する可能性がある。半減期が長いほどスキャンに耐えるが、実際の変化への適応は遅くなる。実際の方策では、連続的な減衰ではなく、周期的なリセット、近似カウンタ、その他の機構を使う場合がある。この図は概念的な計数モデルであり、TinyLFUの実装を忠実にシミュレートしたものではない。適応パラメータを明示することで、そのトレードオフを検証可能にしている。
ヒット率が常に目的とは限らない
オブジェクトのサイズやミスのコストが異なる場合、ヒット数の最大化は経済的に誤りとなりうる。小さく安価なオブジェクトと、大規模で高価な計算は、節約できる処理に等しく寄与するわけではない。アプリケーションが重視するのは、転送バイト数、バックエンドのCPU使用量、エネルギー、期限超過などかもしれない。
より一般的な固定キャッシュの目的では、各項目の要求確率を回避できるコストで重み付けし、常駐項目の総サイズを制約する。得られる選択問題は、単にアクセス頻度が最も高いオブジェクトを選ぶ問題ではない。メタデータや検索のオーバーヘッドも含める必要がある。複雑な方策は、ヒット率を改善しながら、節約する以上のCPUを消費する可能性がある。妥当性を説明できる評価は、すべてのヒットが等価だと仮定せず、目的を明示し、実際に削減された資源を報告する。
鮮度は正しさに関する契約である
キャッシュされたオブジェクトは、人気があっても無効でありうる。更新、失効、認可の変更、版管理されたコンテンツには、保存値を再利用してよいかを決める規則が必要である。受け入れ方策と置換方策は、有効な候補のうち何をメモリに置くかを決めるものであり、有効性そのものを確立するものではない。
この区別は、科学コンテンツや非公開ワークスペースで重要となる。キャッシュされた公開論文は訂正後に版の確認が必要となりうる一方、非公開の草稿には現在の要求とアイデンティティに結び付いた認可が必要である。無効化機構は、キャッシュ方策が保持を望む場合でも、古いデータや認可されていないデータを返さないようにしなければならない。必要な検証を省いて高いヒット率を測定することは契約の変更であり、元の要件の下で正当な性能改善とはいえない。
メタデータが隠れたワーキングセットになりうる
頻度スケッチ、ゴーストリスト、タイムスタンプ、キー、アロケータのオーバーヘッドは、本来データの保持に使えるメモリを消費する。公平な比較には、これらの状態をすべて含める。公称のオブジェクト容量が同じ二つの方策でも、特にオブジェクトが小さい場合、総メモリ使用量は異なりうる。
評価には、並行キャッシュにおける同期コストも含めるべきである。全体で共有する直近性リストや頻度構造の更新は、競合を引き起こしうる。シャーディングはその競合を減らせる一方、置換の質やパーティション間の公平性を変える。単一スレッドのトレースシミュレータでは、これらのコストは予測できない。それでも、方策の挙動を切り分けるためには有用である。ただし、その結果と、マルチコアのサービスにおける実装ベンチマークとを報告上で区別する必要がある。
ヒストグラムが同じでもワークロードの順序は重要である
二つのトレースに含まれる各キーの要求数が完全に同じでも、局所性は順序に依存するため、キャッシュの挙動は異なりうる。繰り返しアクセスが集中するバーストと、同じ要求が長いスキャン全体に分散する場合は異なる。本番トレースの順序をシャッフルするベンチマークは、人気度の周辺分布を保ちながら、方策が活用しようとする性質を壊す可能性がある。
有用なテストマトリクスには、定常的な需要、一度限りのスキャン、急激なホットセット変化、緩やかなドリフト、バースト的な再利用を含める。方策が時間ベースの失効やエージングを用いる場合は、タイムスタンプを保持する。学習用・調整用トレースは評価用トレースから分離すべきである。方策がオンラインで適応するなら、最終的な定常状態だけでなく過渡期間も報告する。ユーザーが経験するのは移行そのものであり、方策が新しいワークロードを学習し終えた後の時点だけではない。
再現可能な比較プロトコル
まず、決定論的な実例と、古いホットセットがもはや役に立たない負の対照から始める。各方策を単純な参照実装と照合し、ウォームアップを明示的に考慮する。トレース研究では、トレースの来歴全体、前処理、オブジェクトサイズ、ミスのコスト、総メモリ予算を報告する。
次に、同一の有効性規則とバックエンドの挙動の下で、並行負荷に対する実装を評価する。回避できたバックエンド要求、CPUオーバーヘッド、メモリ割り当て圧力、スループット、テールレイテンシを記録する。本稿では、そのような本番ベンチマークは実施していない。ローカルで得られた結果は、受け入れの統制された実証と二つの解析モデルであり、後続の実装研究が解釈可能な参照点として使える。
結論:データの有効性を保証する契約の下で節約できる処理を最適化する
キャッシングは、有効性、受け入れ、置換、適応に関する判断の体系である。優れた方策は、他の部分を解決せずに一部を改善しうる。スキャンの実例は、すべてのミスを受け入れることが無駄になりうる理由を示す。人気度とエージングのモデルは、単一の履歴期間がすべてのワークロードに適するわけではない理由を示す。
厳密なキャッシュ研究では、有効性に関する契約を固定し、方策のメタデータと並行処理のコストを含め、アプリケーションにとって重要な処理を測定する。この枠組みは、目立つヒット率の数値よりも改善を他の状況へ適用しやすくし、性能最適化が鮮度やアクセス制御の保証をひそかに弱めることを防ぐ。
ローカルで実行済み · 限定された範囲
LRUのスキャン汚染と正確な頻度に基づく簡易受け入れモデル
上限のない正確なカウントと、等値では受け入れない厳密不等号による受け入れ比較を使用する。TinyLFU、ARC、LeCaRの実装ではない。
2件のアサーションが成功した。 これらの検査は、提示した例を検証するものであり、引用したシステムを検証するものではない。
記録された実例を確認する
{
  "post_scan_hits": {
    "LRU": 0,
    "toy_gate": 4
  },
  "new_hot_tail_hits": 4
}明示された解析モデル
四つの方程式と明示的な仮定
(1) N個の項目に対する有限のZipf型独立同分布要求モデル。プロットではN = 1000を用いる。
(2) サイズとコストが等しく、確率が最も高いC個の項目を保持する固定キャッシュの理想的なヒット確率。ウォームアップと適応は除く。
(3) 半減期H、初期カウントf0 = 64による、例示的な履歴の指数減衰。
(4) 項目サイズsi、回避できるミスのコストci、メモリMを用いた、静的な期待処理量の目的。一般にはヒット数の最大化と等価ではない。
構成した例 · 再現可能なデータ
定量的な論拠を検討する
これらの曲線は、明示したモデルから計算されている。引用した研究の観測結果ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるのか
| 判断 | 制御すること | 決定しないこと |
|---|---|---|
| 受け入れ | ミスが常駐データを置き換えるかどうか | 鮮度や許可 |
| 置換 | どの有効な常駐項目が領域を失うか | 将来の人気度の確実な予測 |
| Aging/adaptation | 履歴の影響がどれほど速く弱まるか | 普遍的に最適な応答時間 |
| 有効性 | 再利用が許されるかどうか | どの有効な項目が最も多くの処理を節約するか |
提案する検証プロトコル
これは提案された評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検査に記録している。
- ホットセットとスキャンの実例、およびそれと対照的なホットセット変化の対照条件を再現する。
- 方策のすべてのメタデータをメモリ予算に含める。
- トレースの順序、タイムスタンプ、オブジェクトサイズ、ミスのコストを保持する。
- 調整用トレースと評価用トレースを分離し、適応期間を含める。
- 各変種で鮮度と認可の挙動を同一に保つ。
- ヒット率だけでなく、回避できたバックエンド処理と並行実装のコストを測定する。
一次資料が明らかにしていること
Gil Einziger, Roy Friedman, Ben Manes · 2017 [1]
貢献。 TinyLFUは、最近の頻度情報を用いて受け入れを判断し、置換方策と組み合わせることができる。
適用限界。 報告された利点は、ワークロードと構成に依存する。
資料内の該当箇所。 要旨と受け入れ方策の設計。
Nimrod Megiddo, Dharmendra S. Modha · 2003 [2]
貢献。 ARCは、履歴情報を用いて直近性と頻度のバランスを適応的に調整する。
適用限界。 実証範囲の広さは、普遍的な最適性の定理ではない。
資料内の該当箇所。 USENIXの要旨と適応方策の説明。
Giuseppe Vietri, Liana V. Rodriguez, Wendy A. Martinez et al. · 2018 [3]
貢献。 LeCaRは、学習の枠組みを適用して基本的な置換動作を組み合わせる。
適用限界。 評価したトレースと資源予算が、報告された比較を規定する。
資料内の該当箇所。 USENIX HotStorageの要旨。
本分析の限界
- 簡易的な受け入れゲートは、TinyLFU、ARC、LeCaRではない。
- 静的な人気度モデルは、独立同分布の要求、等しいサイズ、等しいミスのコスト、既知の確率を仮定する。
- 減衰曲線は例示モデルであり、実装の詳細であると主張するものではない。
- 本番トレースや並行キャッシュ実装のベンチマークは行っていない。
選択した三つの基礎的な一次資料に焦点を絞った解析的レビューであり、独自の具体的な計算例を含む。2026までの文献を網羅的または体系的に調査したものではない。資料へのアクセスと版に関する注記は、参考文献とともに記録している。
結論を変えうる問い
- どのミスのコスト、オブジェクトサイズ、有効性検査が、ヒットの実際の価値を決めるのか。
- 一度限りのスキャンに脆弱にならずに、方策はどれほど速く適応する必要があるのか。
- メタデータと同期のオーバーヘッドは、節約したバックエンド処理を相殺するのか。
参考文献
- Gil Einziger, Roy Friedman, Ben Manes. TinyLFU: A Highly Efficient Cache Admission Policy. ACM Transactions on Storage (2017). 10.1145/3149371.
- Nimrod Megiddo, Dharmendra S. Modha. ARC: A Self-Tuning, Low Overhead Replacement Cache. USENIX FAST (2003). Primary source.
- Giuseppe Vietri, Liana V. Rodriguez, Wendy A. Martinez et al.. Driving Cache Replacement with ML-based LeCaR. USENIX HotStorage (2018). Primary source.
資料[1]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部。全文や補足資料の網羅的な精査ではない。
資料[2]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部。全文や補足資料の網羅的な精査ではない。
資料[3]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部。全文や補足資料の網羅的な精査ではない。
書誌的同一性は、Crossrefおよび出版社、著者、機関の一次記録と照合した。以下の資料アクセスと版に関する注記は、その範囲を示している。これは全文の網羅的な精査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示している。解析的な構成例と提案された評価設計は、本記事に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。稼働中の製品の測定値でも、再現した性能ベンチマークでもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。