
要旨
学習型索引はモデルを用いてレコードの位置を予測するが、予測精度とクエリの正しさは異なる性質である。本レビューは、構成した分布シフトを通じて、学習型索引の当初の提案、PGM-index、ALEXを関連付ける。等間隔のキーの順位を正確に予測するモデルでも、キー間隔が二次的に変化すると、順位範囲の四分の一に等しい最大順位誤差が生じる。実行可能な探索例により、古くなった誤差窓がなぜ失敗しうるのか、また、検証済みの境界やフォールバック探索がなぜ正しさを回復するのかを示す。分析では、経験的なモデル誤差と保証された誤差限界、静的探索と更新、検索速度とエンドツーエンドの保守コストを区別する。図は解析的に構成したものであり、学習型索引の実装を測定したものではない。
予測は探索戦略を変える
整列済み索引は、ある順序に従ってキーをどこで見つけるべきか、またはどこに挿入すべきかという意味論的な問いに答える。モデルはその位置を推定し、位置特定に必要な処理を減らせる。最終的な探索が正しい結果を確定するならば、推定は不完全であっても有用である。
この分離が、堅牢な学習型索引の基盤となる。平均順位誤差が小さいからといって、キーを確認せずに予測されたレコードを返すことは正当化されない。また、訓練集合上の最大誤差が、挿入や削除後の将来の状態に対する誤差限界を自動的に与えるわけでもない。システムは、予測をどのように補正し、不確実性にどのような限界を設け、その限界をどのように維持するかを決めなければならない。学習された構成要素を高速化手段としながら、従来の順序不変条件を正しさの根拠として維持できる。
選択した三つの設計
Kraskaらは索引構造を位置を予測できるモデルとして捉え、学習に基づく代替手法を検討している。FerraginaとVinciguerraによるPGM-indexの最終版論文は、最悪時の明示的な限界と更新への対応を備えた学習型構造を展開している。ALEXは、読み取りと更新が混在するワークロードに向け、学習モデルと適応的なストレージおよび索引技術を組み合わせている。
これらの論文は設計と保証が異なる。本稿では、初期プレプリントの題名や対象範囲に暗黙に依拠するのではなく、PGMの最終版論文を用いる。報告されている高速化を、新たなデータセットや計算機にそのまま当てはめることはしない。重要な比較は、各手法が予測を厳密な探索にどう結び付けるか、そして格納データの分布やクエリワークロードが変化した際にどのような処理が必要となるかである。 [1], [2], [3]
順位関数には境界での振る舞いの定義が必要である
整列済みの列に対し、順位をクエリ値より厳密に小さいキーの個数として定義する。この下限位置に基づく定義は、存在しないキーを扱え、重複値に対しても明確な答えを与える。存在するキーの位置のみで訓練されたモデルは、キーの間やデータ範囲外のクエリに対して、同じ保証を直接には与えない可能性がある。
正しい実装には、先頭と末尾のキー、重複値、空の構造に対する明示的な振る舞いが必要である。また、浮動小数点の予測値を、範囲内に収まる整数位置へ変換しなければならない。これらは些末な詳細ではない。予測値が数値的に近く見えても、一位置ずれた探索窓は真の下限位置を除外しうる。提案する試験で正しさの基準となるのは、モデル自身の順位推定ではなく、厳密な下限位置探索である。
誤差を厳密に求められる分布シフト
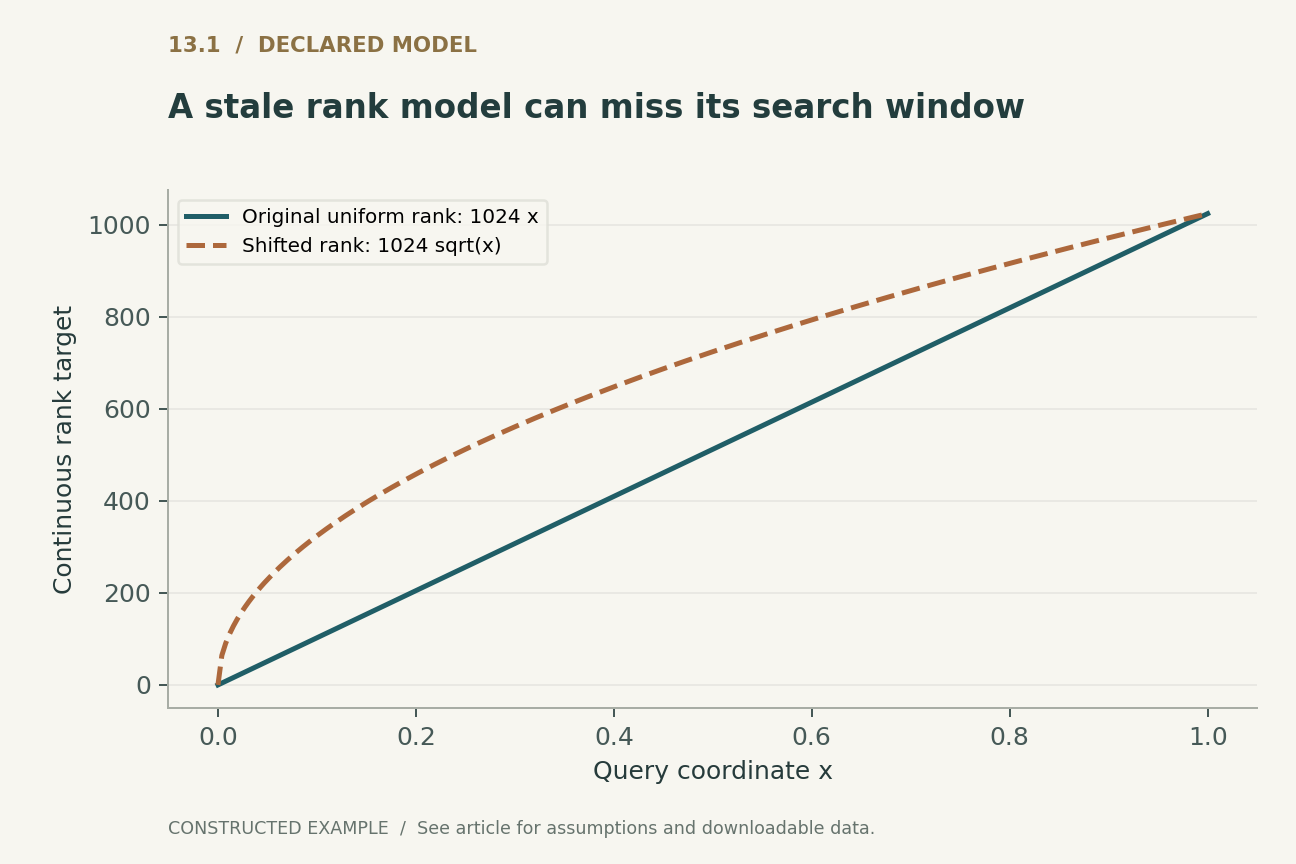
順位の範囲を零からN引く一までとする。正規化された等間隔のキーの順位は、おおむねN引く一にxを掛けた値となる。ここで、格納するキーの位置を、その正規化順位の二乗に変更する。対応する連続順位曲線はN引く一にxの平方根を掛けたものとなる一方、古い予測器は線形のままである。
誤差は、N引く一に、xの平方根からxを引いた値を掛けたものである。微分すると、xが四分の一のときに最大となり、その誤差はN引く一を四で割った値となる。Nが1,025ならば、最大誤差は256順位である。この構成した変化は、厳密に導出できるほど単純になるよう意図されている。現実のワークロードが二次的にドリフトするという主張ではない。保証を維持せずに、過去の小さな誤差窓を信頼することへの反例である。
古くなった探索窓は答えを除外しうる
古いモデルが予測位置の左右それぞれ四位置だけを探索すると仮定する。構成した最大誤差点の近傍では、真の順位は数百位置離れている。古くなった探索窓に限定された探索は、より優れた局所探索アルゴリズムを用いるだけでは、正しい下限位置を回復できない。
付録では、格納キーと追加のクエリを厳密な二分探索と照合する。未検証の狭い探索窓による失敗を記録し、候補が全体に対する下限位置の隣接条件を満たさない場合にフォールバックを適用する。この小さなアルゴリズムはPGMやALEXの実装ではない。ここで示す設計原則は、維持される保証証明によって答えが探索窓内にあることを保証するか、そうでなければ結果の検証と安全な退避経路が必要になるということである。
経験的誤差と保証された誤差は異なる役割を担う
訓練集合上の最大誤差は、当てはめたデータを記述でき、モデルと探索の意味論が関連するすべてのクエリの網羅を正当化するならば、静的な保証証明の根拠にもなりうる。しかし、将来の更新について、分布に依存しない保証を自動的に与えるものではない。統計的な信頼区間も、決定論的な探索限界とは異なる。
PGMの研究が重要なのは、最悪時の保証をデータ構造の設計に組み込んでいるためである。学習型システムは、どの限界が構造的なもので、どれが経験的な調整上の観測なのかを正確に明示すべきである。フォールバックが正しさを保つならば、モデルの劣化は誤答の問題ではなく性能の問題となりうる。これは有益な分離であるが、局所的保証が得られないすべての条件でフォールバックに到達することを試験する必要は残る。 [2]
更新はデータとコストの境界の両方を動かす
キーの挿入は後続の順位を変え、物理的移動、空隙管理、モデル調整、再構築を必要とする場合がある。削除も同様の保守上の問題を生む。そのため、検索時の誤差がきわめて良好なモデルであっても、その表現の維持に費用がかかるならば、書き込みの多いワークロードでは性能が低くなりうる。
ALEXは、適応的な更新動作を設計上の中心課題として扱う。他にも適用できる評価要件は、完全な操作の組合せを時間の経過に沿って測定することである。有利なデータセットを一括ロードし、読み取りだけを計時すると、適応型索引を有用に保つための処理が抜け落ちる。更新レイテンシの分布、書き込み増幅、メモリの余裕領域、再構築による停止時間、分布シフトの影響を報告すべきである。保守が非同期に行われる場合は、その資源消費と、新旧の表現が共存する間の正しさを支える規則も含める必要がある。 [3]
探索窓の大きさに対する局所的コストは対数的である
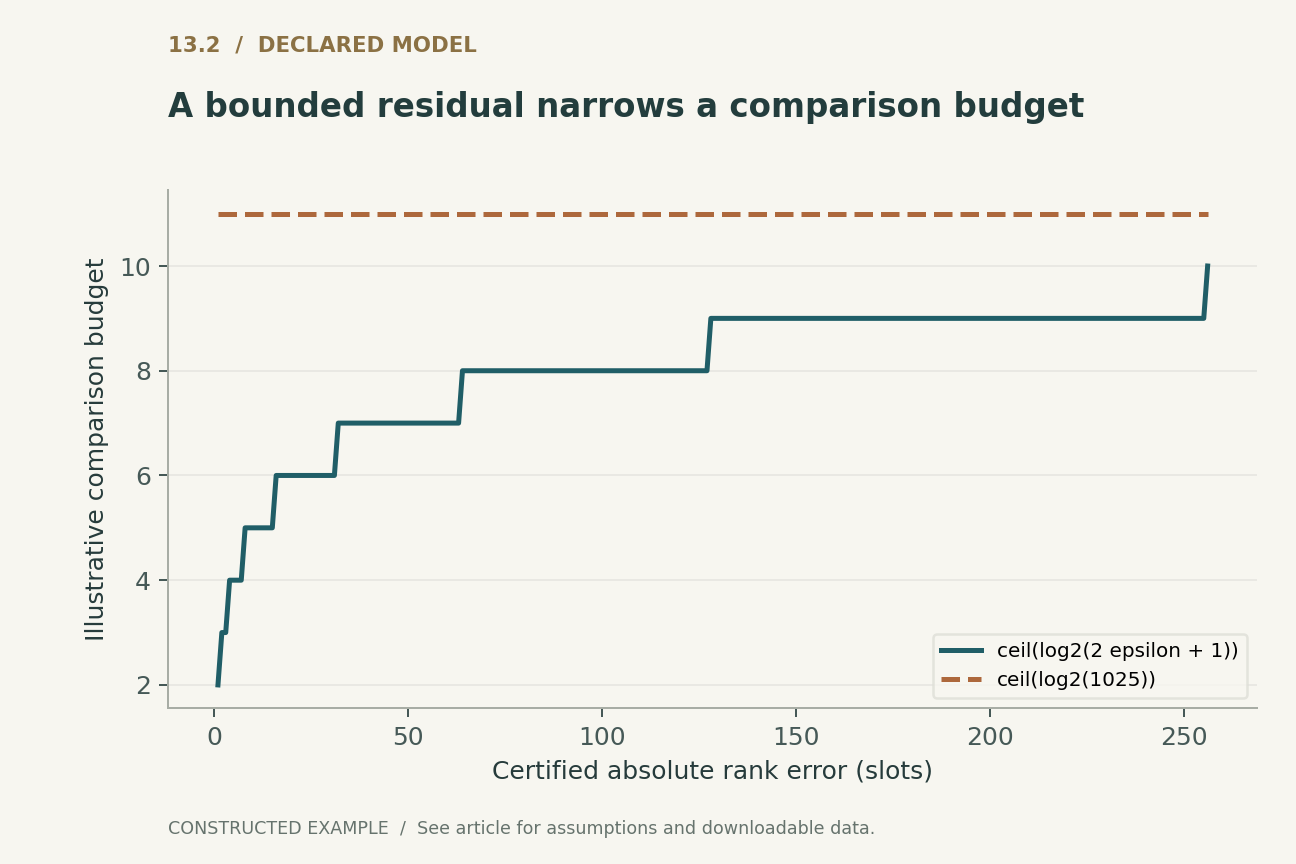
高々イプシロンの二倍に一を加えた個数の位置を含む検証済み区間では、二分探索型の局所手続きの比較回数の尺度は、その区間サイズの対数に比例する。二番目の図は、対数を切り上げた単純な回数をイプシロンに対して描き、配列全体に対応する尺度も併記している。
これは抽象的な比較回数であり、CPU時間の予測ではない。実際のハードウェアでは、モデル評価、キャッシュミス、分岐動作、ベクトル化、メモリ配置が支配的になりうる。小さな探索窓を得るために高価なモデルが必要ならば、窓を小さくしてもレイテンシが改善しない場合がある。逆に、多少広い探索窓でも、一つのキャッシュライン内に収まるならば低コストで済むことがある。性能の議論には、候補レコード数だけでなく、予測器と補正経路を含めなければならない。
データ分布とクエリ分布は異なる
索引は格納キーによく適合していても、難しい領域に集中したクエリ分布を処理する場合がある。存在しないキーへのクエリ、範囲走査、ホットスポットは、一様に標本抽出した成功検索とは異なるコストを持ちうる。また、更新が一方の裾に集中し、読み取りがもう一方を対象とすることもある。
したがって、提案するベンチマークでは、格納キーの分布をクエリ分布および更新分布から分離する。対応している場合の重複値、範囲外の照会、偏り、交互に現れるフェーズ、緩やかな変化や急激な変化を含める。正しさは再構築後だけでなく、全過程で確認すべきである。全体ではまれなフォールバックが、特定の利用者のワークロードやあるキー範囲では支配的になりうるため、平均的な挙動とテールの挙動の両方を報告すべきである。
再現可能な比較
すべての索引に対して、同じキー順序、ペイロードサイズ、操作の意味論、永続性要件を用いる。データ生成コードと乱数シードを保持し、扱いやすい規模のデータセット上で、すべての操作を厳密な参照実装と照合する。一括ロードと保守の処理を定常状態の検索性能とは別に測定し、そのうえで想定するライフサイクルにおける合計を報告する。
本稿の局所的な構成は、意図的に速度競争を避けている。厳密な順位誤差曲線を確立し、安全な補正境界を示すことが目的である。実際の性能に関する結論には、本稿では試していない実装、ハードウェア、ワークロードが必要となる。この区別により、予測誤差における数学的な優位性が、観測されたシステム上の優位性として示されることを防ぐ。
結論:モデルに予測させ、索引に検証させる
学習型索引が最も説得力を持つのは、近似を処理量の削減に用いながら、厳密なデータ構造の不変条件によって答えを決定する場合である。課題は単に関数を当てはめることではない。関数、格納キー、更新、探索境界の間の有効な関係を維持することである。
二次的シフトの証拠例は、かつて完全だった予測器が、ソフトウェアのバグなしに不正確になりうることを示す。維持された誤差限界や検証済みのフォールバックによって、結果として生じる問題を性能の領域にとどめられる。そのうえで厳密な評価では、最も有利な検索フェーズだけを報告するのではなく、ワークロードのライフサイクル全体を通じてこの分離を維持するコストを測定する。
ローカルで実行済み · 限定された範囲
分布シフトによる探索失敗と、厳密かつ検証済みのフォールバック
構成したキーと簡易的な順位予測器であり、PGM、RMI、ALEXの性能ベンチマークではない。
2060件のアサーションに合格した。 これらの検査が検証するのは提示した例であり、引用したシステムではない。
記録された証拠例を確認する
{
  "queries": 2051,
  "fallbacks": 2027,
  "stale_rank": 261,
  "true_rank": 512
}明示された解析モデル
四つの式と明示的な仮定
(1) 存在しないキーと重複値の意味論を含む、下限位置としての順位。
(2) xが[0,1]に属する場合の、等間隔および二次的なキー間隔に対する連続順位曲線。離散的な検索は別途検査する。
(3) 最大値はx = 1/4で生じる。N = 1025の場合、256順位となる。
(4) 保証された有界の探索窓に対する、二分探索の比較回数の例示的尺度。実時間レイテンシでも、すべての実装に対する厳密な回数でもない。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は明示したモデルから計算されている。引用した研究における観測値ではない。すべての図に数値データとベクトル版を付属させている。


どの証拠がどの問いに答えるのか
| 量 | 意味 | 意味しないこと |
|---|---|---|
| 平均予測誤差 | 当てはめた順位の典型的な精度 | 最悪時にも正しい探索窓 |
| 維持される決定論的な限界 | 保証された補正区間 | モデル評価コストの低さ |
| フォールバックの正しさ | 予測が誤っても厳密な答えが得られる | テールレイテンシの安定性 |
| 読み取りベンチマーク | そのクエリ分布に対するコスト | 更新や再構築の低コスト性 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検査の項に記録している。
- 下限位置、重複値、存在しないキーの意味論を厳密に定義する。
- 各有限例を、独立した二分探索オラクルと照合する。
- 古いモデルを更新せずに二次的な間隔シフトを適用し、失敗の証拠例を保存する。
- 局所探索の結果を受け入れる前に、維持されている限界または全体に対する隣接条件の検証を確認する。
- 挿入、削除、再構築、混合クエリ分布を試す。
- モデル、補正、フォールバック、保守、メモリのコストをまとめて測定する。
一次資料が確立していること
Tim Kraska, Alex Beutel, Ed H. Chi et al. · 2018 [1]
貢献。 学習型索引構造はモデルを用いて位置を予測し、従来の索引構成要素の代替を検討する。
適用範囲の限界。 報告された改善は、評価対象のデータセット、ハードウェア、設計に依存する。
資料内の該当箇所。 学習型索引の原論文と要旨。
Paolo Ferragina, Giorgio Vinciguerra · 2020 [2]
貢献。 PGM-indexの最終版論文は、最悪時の明示的な限界と動的な派生形を展開している。
適用範囲の限界。 引用対象はVLDB最終版の範囲であり、それ以前のプレプリントは題名が異なる。
資料内の該当箇所。 VLDB最終版論文の要旨と保証。
Jialin Ding, Umar Farooq Minhas, Jia Yu et al. · 2020 [3]
貢献。 ALEXは、更新ワークロードに向けて、予測と適応的なストレージ技術を組み合わせる。
適用範囲の限界。 更新性能は、想定する操作の組合せの下で測定しなければならない。
資料内の該当箇所。 著者原稿の要旨と適応型索引の設計。
本分析の限界
- 順位シフト曲線は構成した連続関数であり、経験的なワークロード分布ではない。
- 本稿の局所的なフォールバック例はPGM、RMI、ALEXではない。
- 比較回数はキャッシュ動作や実時間性能を予測しない。
- 現行の学習型索引の実装に対するベンチマークは行っていない。
選択した三つの基礎的な一次資料を対象とし、独自の具体的な計算例を伴う、焦点を絞った分析的レビューである。2026年までの文献を網羅する総説や系統的レビューではない。資料へのアクセス範囲と版に関する注記は参考文献に併記している。
結論を変えうる問い
- 各更新後に補正の限界を維持するものは何か。
- 分布シフト後、どのクエリ領域がフォールバックとテールレイテンシを支配するのか。
- モデル評価、余裕領域、再構築を算入しても、ライフサイクル全体でなお利点が得られるか。
参考文献
- Tim Kraska, Alex Beutel, Ed H. Chi et al.. The Case for Learned Index Structures. Proceedings of the 2018 International Conference on Management of Data (2018). 10.1145/3183713.3196909.
- Paolo Ferragina, Giorgio Vinciguerra. The PGM-index: a fully-dynamic compressed learned index with provable worst-case bounds. Proceedings of the VLDB Endowment (2020). 10.14778/3389133.3389135.
- Jialin Ding, Umar Farooq Minhas, Jia Yu et al.. ALEX: An Updatable Adaptive Learned Index. Proceedings of the 2020 ACM SIGMOD International Conference on Management of Data (2020). 10.1145/3318464.3389711.
資料[1]へのアクセス範囲。 一次記録、要旨、入手可能な本文の一部を対象とし、全文や補足資料を網羅的に監査したものではない。
資料[2]へのアクセス範囲。 一次記録、要旨、入手可能な本文の一部を対象とし、全文や補足資料を網羅的に監査したものではない。
版に関する注記。 VLDBの最終版論文を引用しており、それ以前のarXiv版は題名が異なる。
資料[3]へのアクセス範囲。 一次記録、要旨、入手可能な本文の一部を対象とし、全文や補足資料を網羅的に監査したものではない。
書誌情報の同一性は、Crossrefと、出版社、著者、所属機関の一次記録に照らして確認した。以下の資料へのアクセス範囲と版に関する注記が対象範囲を示す。これは全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は原研究の研究者を示す。解析的な構成と提案された評価設計は、本記事によるものである。
表紙はImageGenによる概念的なイラストである。技術図は、明示されたモデルまたは有限例から計算され、PythonとCSVを付属させている。導入済み製品の測定値でも、再現した性能ベンチマークでもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。