
要旨
ストリーミングスケッチは、正確な状態の保持を、確率的または漸近的な誤差保証を伴うコンパクトな要約に置き換える。これらの保証は、誤差の方向、ノルム、ランダム性、許容される更新の点で異なる。本レビューは、小規模な頻度要約の例を通じてCount-Min、CountSketch、HyperLogLogを比較する。非負の頻度の下でCount-Minの基本的な片側限界を導出し、固定クエリに対する保証と反復的または適応的な利用を区別するとともに、マージ可能性が重複に対して安全なマージを意味しない理由を説明する。二つの解析的な図は、Count-Minのメモリと精度のスケーリング、およびHyperLogLogのレジスタ数と誤差の漸近的関係を示す。付属プログラムは、構成した有限ストリーム上で過大推定と線形マージの挙動を検証するものであり、新たなベンチマークや漸近定数の実証的検証を主張するものではない。
近似は契約であるべきである
頻度推定は、一方向にのみ誤る場合も、どちらの方向にも誤る場合もあり、加法的なしきい値を超える確率が明示される場合もある。異なる値の数の推定器は、そもそも別の量を対象とする。これらの構造をすべて近似カウンタと呼ぶと、安全に利用するために必要な情報が見えにくくなる。
契約では、ストリームモデル、更新の符号、照会する量、ランダム性、誤差指標を特定すべきである。ストリームの総質量に比例する誤差は、高頻度項目には許容できても、まれな項目には役立たないことがある。カーディナリティの相対誤差はテレメトリに適していても、厳格な容量上限の遵守には不適切な場合がある。スケッチを利用するかどうかの判断は、メモリ削減率だけでなく、誤差が後段に及ぼす影響から始めるべきである。
三つの主要構造、それぞれ異なる保証
CormodeとMuthukrishnanのCount-Minスケッチは、ハッシュで割り当てる複数のカウンタと最小値による推定を用い、非負の頻度に対して有用な片側加法保証を与える。Charikar、Chen、Farach-ColtonのCountSketchは符号付きの寄与を用い、異なる頻度推定解析を可能にする。FlajoletらのHyperLogLogは、コンパクトなレジスタ統計量を用いて異なる値の個数を推定する。
ここでは、これらの完全な解析を再現することも、過去のベンチマーク値を比較することもしない。比較の目的は、各構造がストリームの異なる側面を要約していることを示す点にある。Count-Minの頻度表はカーディナリティ推定器の代替ではなく、符号付き推定値には、非負の衝突カウントの最小値と同じ片側の解釈は成り立たない。正しく利用するには、問いに対応する保証を選ぶ必要がある。 [1], [2], [3]
Count-Min推定とその決定論的側面
各行で、項目をハッシュによって一つのカウンタに割り当て、その更新重みを加える。項目の頻度を推定するには、各行で対応するカウンタを調べ、その最小値を取る。すべての最終頻度が非負であれば、照会される各カウンタは、その項目の真のカウントに非負の衝突質量を加えたものに等しい。したがって、正確な算術と適合する更新モデルを前提とすれば、推定値が真のカウントを下回ることはない。
この決定論的事実は、衝突質量が小さい確率とは別である。有限例を扱う付録では、意図的に単純化した固定ハッシュ族を用い、構成したストリームで過大推定を検証する。これらの例示用ハッシュが定理の独立性要件を満たすとは主張しない。最終頻度が負になりうる一般ターンスタイルストリームでは、衝突する寄与が加算されるだけでなく相殺されるため、片側性の議論が成立しなくなることがある。
確率的な限界はどこから導かれるか
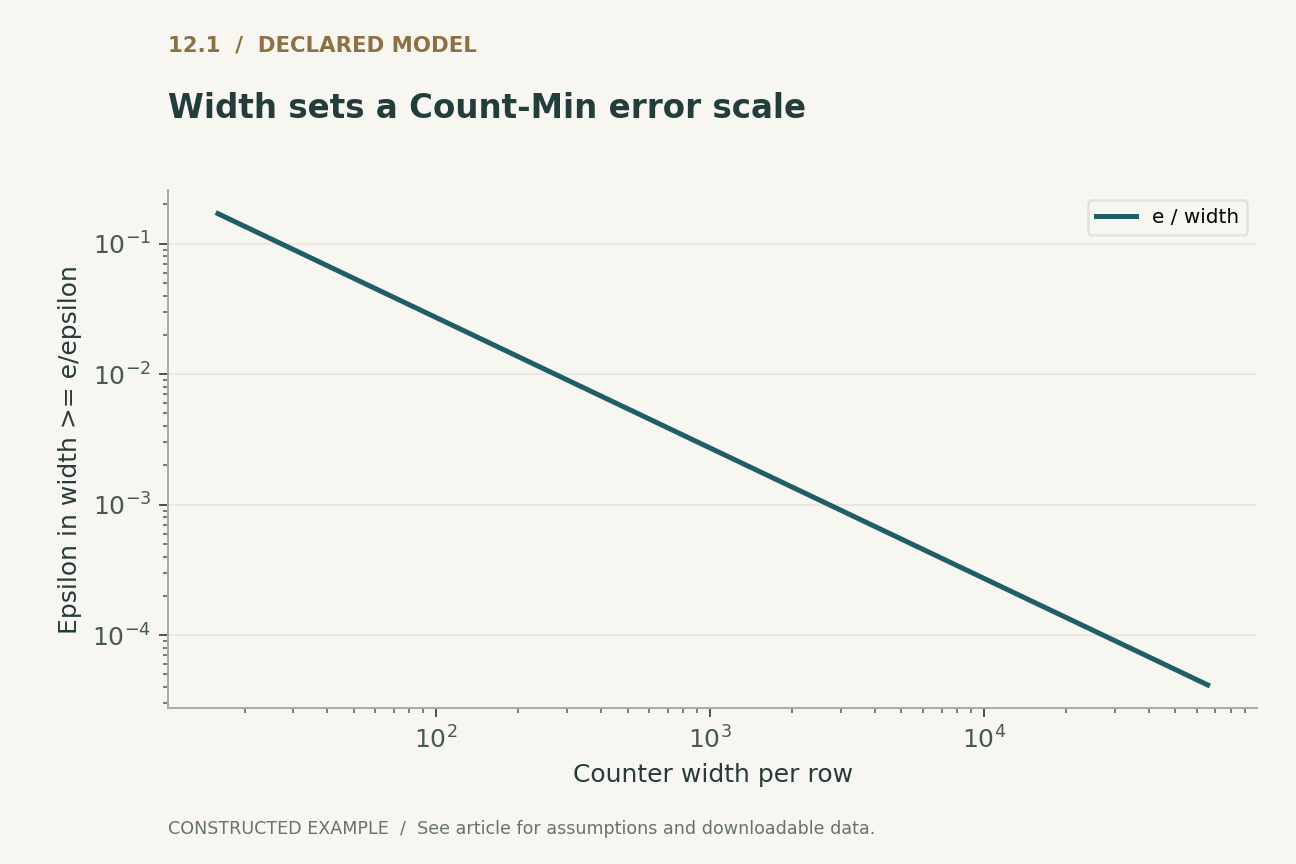
照会する項目を固定した場合、ハッシュ族が必要な衝突特性を満たしていれば、ある行の衝突質量の期待値は、L1総質量を行の幅で割った値以下である。幅がeをイプシロンで割った値以上なら、この期待値は、イプシロンとL1質量の積をeで割った値以下となる。したがってマルコフの不等式により、一つの行の衝突質量がイプシロンと質量の積を超える確率は、eの逆数以下に抑えられる。
行が独立であれば、すべての行がしきい値を超える確率はexpの引数を負のdとした値以下となる。ここでdは深さである。深さがデルタの逆数の自然対数以上であれば、最小値を取ることでよく知られた失敗確率の上限が得られる。この導出は、非負の質量、固定クエリ、適切なハッシュ、独立な行、カウンタのオーバーフローがないこと、というすべての依存条件を明らかにする。いずれかの前提を取り除けば、主張は変わる。
固定クエリに対する精度は、普遍的な適応的精度ではない
一つの固定クエリに対する保証は、すべての可能なクエリに同時に自動適用されるわけではない。あらかじめ定めた有限個のQ件のクエリ集合に対しては、和事象の上界を用い、クエリごとの失敗確率をより小さく割り当てることで、集合全体に望ましい上限を得られる。そのために行を追加する必要が生じる場合がある。
クエリや更新がスケッチの明らかにした情報に依存する場合、適応的な選択はより繊細な問題となる。固定入力に対する単純な解析で用いるランダム性の前提は、その相互作用をもはや記述していない可能性がある。敵対的なクライアントに推定値を公開するサービスは、教科書的な単一クエリの限界を、そのまま無制限の適応的保証として引用すべきではない。評価では、ストリームとクエリ集合がスケッチのランダムな選択と独立に固定されているか、またシードが公開か非公開かを明示しなければならない。
マージ可能性は線形性であり、冪等性ではない
同一の次元とハッシュ関数で構築した二つのCount-Min配列は、加算によってそれぞれの頻度ベクトルの和を要約できる。これは分散集約に有用である。しかし、同じシャードを二度加えると、その寄与は倍になる。マージは冪等ではないため、再試行を行う転送には、シャードの識別子、バージョン管理、または他の重複防止機構が必要である。
HyperLogLogは、互換性のあるハッシュと表現の下で、レジスタの最大値に基づく別のマージ操作を用いる。この操作には異なる代数的性質がある。ここから得られる教訓は、マージ可能性が単一の普遍的挙動ではないということである。操作、互換性の制約、重複の意味論を明示する必要がある。分散パイプラインは、数学的に正しいスケッチを用いていても、マージに対して誤った配送の前提を適用すれば、不正確な集約結果を生成しうる。
カーディナリティ誤差には有効な領域がある
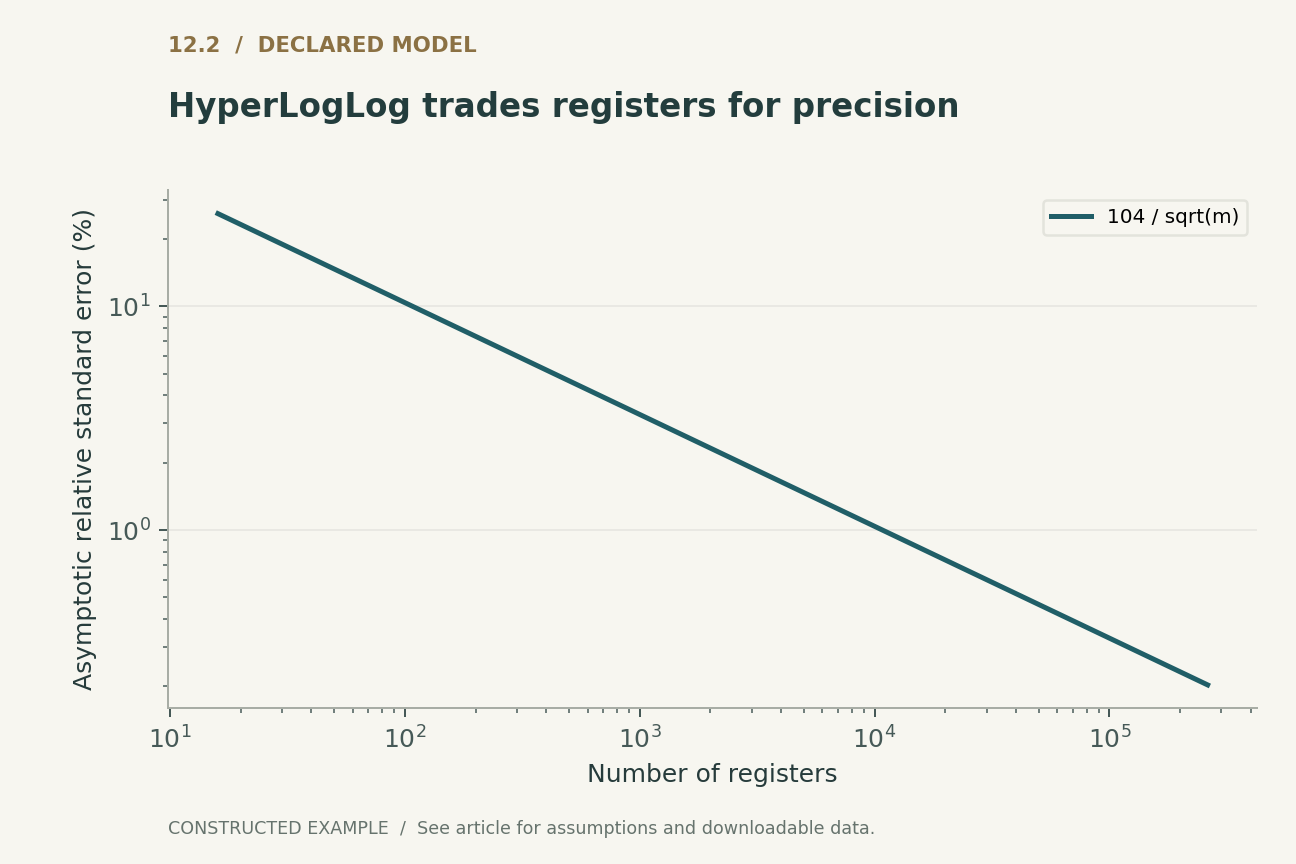
HyperLogLogでよく知られた相対標準誤差の近似は、その漸近的設定において、およそ1.04をレジスタ数の平方根で割った値である。二つ目の図は、小さい二の累乗の個数からより大きな配列までのレジスタ数について、この式を描いている。これは漸近式として明示されており、あらゆるカーディナリティとハッシュ実装に対する保証ではない。
小カーディナリティ補正、有限のハッシュ幅、レジスタ表現、推定器の変種は、実際の挙動に影響する。また、相対標準誤差それ自体は、決定論的な最大誤差でも信頼区間でもない。レジスタ数が16,384のとき、この式は約0.8125パーセントとなる。特定の裾確率を必要とする運用では、この標準偏差を絶対的な限界として扱うのではなく、適切な分布解析または較正された証拠を用いなければならない。 [2]
カウンタのビット幅とオーバーフローもモデルに含まれる
理論上コンパクトなスケッチでも、カウンタが飽和したり周回したりすると破綻しうる。飽和は推定器の挙動を変え、剰余演算による周回は片側の過大推定性を壊しうる。重み付き更新と長い保持期間があると、異なるキーの数がそれほど多くなくても、これは実務上の懸念となる。
メモリ予算には、カウンタのビット幅、シード、メタデータ、高頻度項目の候補を特定するためのあらゆる構造を含めるべきである。頻度スケッチだけで、推定値の大きなキーを必ず列挙できるわけではない。それは与えられたキーに対するクエリに答えるものである。アプリケーションが高頻度項目のリストを必要とするなら、候補生成機構を精度とコストの双方に含めなければならない。そうしなければ、公表するメモリ使用量から、実際の問いに答えるために必要な構成要素が抜け落ちる。
意味のある評価は三つの誤差を区別する
スケッチに由来する測定誤差は、取り込み誤差およびクエリの不整合と分けて扱うべきである。レコードの欠落、シャードの重複、時間窓の不一致は、スケッチの確率的誤差より大きな影響を及ぼしうる。誤ったストリームに対する精密な推定器であっても、その結果は依然として誤っている。
提案するプロトコルは、小規模ストリームの厳密な参照系を保持し、互換性のあるマージとないマージを検証するとともに、重複配送とカウンタ境界の事例を含める。より大規模な実験では、明示したランダム化方式の下で、分布の偏り、総質量、まれな項目の頻度、カーディナリティ、更新の符号を変化させるべきである。主張がランダム化ハッシュに依存する場合は、独立なシードにわたる分布を報告する必要がある。一つの好都合なシードや一つの都合のよいZipf分布だけでは、想定するワークロード全体での広範な精度を確立できない。
結論:前提条件をパイプラインに引き継ぐ
ストリーミングスケッチは、正確な状態を明示的な近似に置き換えることで、大規模な測定を実用的にする。その価値は、誤差の記述を導出した際の条件を維持できるかどうかに依存する。更新モデル、クエリの選択、ハッシュの独立性、算術、マージプロトコルは、いずれも結果の一部である。
有限例は、有用な片側性と、加法的マージにおける重複の危険性の双方を示す。解析曲線は、運用時の測定値を装うことなく、メモリが公称精度をどのように変えるかを説明する。妥当性を説明できるシステムは、こうした数学的契約を用いて取り込み経路とクエリ経路を設計し、実行可能な限り、測定パイプライン全体を厳密な参照系と照合して検証する。
ローカルで実行済み · 範囲限定
Count-Minの簡単な例における挿入、マージ、および符号付きストリームの反例
明示的な固定ハッシュを使用する。確率的なハッシュ保証やHyperLogLogの実装は主張しない。
13件のアサーションに合格した。 これらの検証は、提示した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認する
{
  "positive_updates": [
    [
      0,
      3
    ],
    [
      1,
      2
    ],
    [
      4,
      5
    ],
    [
      2,
      7
    ],
    [
      7,
      1
    ]
  ],
  "signed_estimate": -2,
  "true_frequency": 3
}明示した解析モデル
四つの方程式、明示的な前提条件
(1) 互換性のある行ハッシュと正確なカウンタによるCount-Min推定。
(2) 非負の頻度と必要なランダムハッシュの前提の下での固定クエリに対する限界。下限は正確な算術の下で決定論的に成り立つ。
(3) 記載した限界を得るために十分なCount-Minの幅と深さ。カウンタ総数はwdである。
(4) 古典的なHyperLogLog解析におけるm個のレジスタに対する漸近相対標準誤差。普遍的な最大誤差保証ではない。
構成例 · 再現可能なデータ
定量的な議論を検討する
これらの曲線は、明示したモデルから計算したものである。引用した研究の観測値ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるか
| 構造 | 答える問い | 重要な適用限界 |
|---|---|---|
| Count-Min | 与えられたキーの頻度 | 非負頻度とハッシュの前提条件。加法的マージによる重複計上 |
| CountSketch | 符号付き頻度推定 | 異なる誤差ノルムと両側の挙動 |
| HyperLogLog | 異なる値の個数 | 漸近領域と互換性のあるハッシュ |
| 分散集約 | 定義されたストリームの要約 | 具体的にどのシャード、バージョン、窓が含まれるか |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の節に記録している。
- 有限ストリームに対する厳密な参照系を構築し、照会したすべてのキーを比較する。
- 非負頻度における過大推定と、一般ターンスタイルの陰性対照を別々に検証する。
- 同一のハッシュ設定を持つ、互いに素なシャードの線形マージを検証する。
- 重複した加法的マージが答えを変えることを示す。
- カウンタのオーバーフロー、互換性のないシード、候補キーの列挙要件を検証する。
- 精度について実証的に主張する場合は、複数の独立したシードとワークロードの条件を用いる。
一次資料が確立していること
Graham Cormode, S. Muthukrishnan · 2005 [1]
貢献。 Count-Minは、有用な加法誤差解析を伴うコンパクトな頻度要約を提供する。
適用限界。 片側の解釈には、非負の頻度と適切なハッシュが必要である。
資料内の該当箇所。 著者公開の原稿、第3節および第4.1節、定理1。出版版に関する注記を保持。
Philippe Flajolet, Éric Fusy, Olivier Gandouet et al. · 2007 [2]
貢献。 HyperLogLogは、コンパクトなカーディナリティ推定と、そのレジスタ数に基づく誤差スケーリングを解析する。
適用限界。 小さい範囲での挙動と実用上の変種には、それぞれ固有の扱いが必要である。
資料内の該当箇所。 出版社の記録と古典的なカーディナリティ推定解析。
Moses Charikar, Kevin Chen, Martin Farach-Colton · 2002 [3]
貢献。 CountSketchは、符号付きハッシュ要約を用いて頻度を推定する。
適用限界。 その保証は、Count-Minの非負の衝突に対する限界とは異なる。
資料内の該当箇所。 要旨と頻度要約の構成。
本解析の限界
- 固定した例示用ハッシュ族が、確率的な定理の条件を満たすものとして提示されているわけではない。
- HyperLogLogの図は漸近式であり、実装のベンチマークではない。
- 一般的な適応的頑健性と、ターンスタイルのすべての変種の網羅は対象外である。
- Count-Minの資料の書誌的同一性は確認したが、本セッションでは原文全文を取得していない。
選定した三つの基礎的な一次資料を対象とする、独自の計算例を伴う焦点を絞った解析的レビューである。2026年までの文献を網羅的または体系的に調査したものではない。資料へのアクセスとバージョンに関する注記は参考文献とともに記録している。
結論を変えうる問い
- 実際のストリームは、選択した限界の更新とランダム性に関する前提を満たしているか。
- シャードの重複配送が、公称の近似誤差を圧倒する可能性はあるか。
- アプリケーションが必要とするのは、固定クエリの推定、同時保証、適応的頑健性のいずれか。
参考文献
- Graham Cormode, S. Muthukrishnan. An improved data stream summary: the count-min sketch and its applications. Journal of Algorithms (2005). 10.1016/j.jalgor.2003.12.001.
- Philippe Flajolet, Éric Fusy, Olivier Gandouet et al.. HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm. Discrete Mathematics & Theoretical Computer Science (2007). 10.46298/dmtcs.3545.
- Moses Charikar, Kevin Chen, Martin Farach-Colton. Finding Frequent Items in Data Streams. Lecture Notes in Computer Science; Automata, Languages and Programming (2002). 10.1007/3-540-45465-9_59.
資料[1]へのアクセス。 著者公開の原稿を取得し、サイズ設定規則と定理1を含む第3節および第4.1節を確認した。アクセス可能な原稿の日付は2003年十二月であり、参考文献は2005年の学術誌掲載版を特定している。
バージョンに関する注記。 リンク先の著者原稿は、2005年の学術誌掲載版より前のものである。本稿は、対応するCount-Minの構成と、非負頻度における固定クエリの限界を用いる。バージョン間の差異を完全に監査したとは主張しない。
資料[2]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部。全文や補足資料の網羅的監査ではない。
資料[3]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部。全文や補足資料の網羅的監査ではない。
書誌的同一性は、Crossrefと、出版社、著者、または機関の一次記録に照らして確認した。以下の資料アクセスおよびバージョンに関する注記は、その範囲を記述するものであり、全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示している。解析上の構成と提案する評価設計は、本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術的な図は、明示したモデルまたは有限例から計算し、PythonとCSVを添付している。運用中の製品の測定値でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。