
摘要
流式摘要以紧凑的摘要替代精确状态,并提供概率性或渐近性的误差保证。这些保证在方向、范数、随机性和允许的更新方面各不相同。本综述通过一个小型频率摘要示例,比较 Count-Min、CountSketch 和 HyperLogLog。文章推导了非负频率条件下 Count-Min 的基本单侧界,区分固定查询保证与重复或自适应使用,并解释为何可合并性并不意味着合并能够安全地处理重复。两幅解析图展示了 Count-Min 的内存—准确性缩放关系,以及 HyperLogLog 的寄存器数与误差之间的渐近关系。随附程序在一个构造的有限数据流上检验高估性质与线性合并行为;它并不声称提供了新的基准测试,也不声称对渐近常数进行了实证验证。
近似应当是一份契约
频率估计可能仅朝一个方向出错,也可能朝任一方向出错,还可能以明确给出的概率超过某个加性阈值。不同值计数估计器所处理的则是完全不同的量。将这些结构统称为近似计数器,会掩盖安全使用它们所需的信息。
契约应明确数据流模型、更新符号、查询量、随机性和误差度量。与数据流总质量成正比的误差,对高频项或许可以接受,对稀有项却可能毫无用处。相对基数误差或许适合遥测,却不适合用于实施严格的容量上限。是否使用摘要,应首先考虑误差对下游的影响,而不应只看内存缩减比例。
三种主要结构,各有不同保证
Cormode 和 Muthukrishnan 的 Count-Min 摘要使用多个哈希计数器,并以最小值作为估计,从而为非负频率提供有用的单侧加性保证。Charikar、Chen 和 Farach-Colton 的 CountSketch 使用带符号的贡献,并支持不同的频率估计分析。Flajolet 及其同事的 HyperLogLog 则使用紧凑的寄存器统计量来估计不同值的基数。
本文不复述这些方法的完整分析,也不比较其历史基准测试数值。比较的目的是说明,这些结构概括的是数据流的不同方面。Count-Min 频率表不能替代基数估计器,带符号估计也不具有非负碰撞计数最小值所具有的单侧解释。正确使用要求选择与问题相匹配的保证。 [1], [2], [3]
Count-Min 估计及其确定性一面
对每一行,将一个项通过哈希映射到一个计数器,并加上其更新权重。要估计某个项的频率,就检查它在各行对应的计数器,并取最小值。当所有最终频率均非负时,每个被查询的计数器都等于该项的真实计数加上非负的碰撞质量。因此,在精确算术和兼容更新模型的假设下,估计值不可能低于真实计数。
这一确定性事实与碰撞质量较小的概率是分开的。有限示例附录刻意使用一个简单的固定哈希族,并在构造的数据流上检验高估性质。它并不声称这些示意性哈希满足定理要求的独立性。允许最终频率为负的一般 turnstile 数据流可能使单侧论证失效,因为发生碰撞的贡献可能相互抵消,而不只是相加。
概率界从何而来
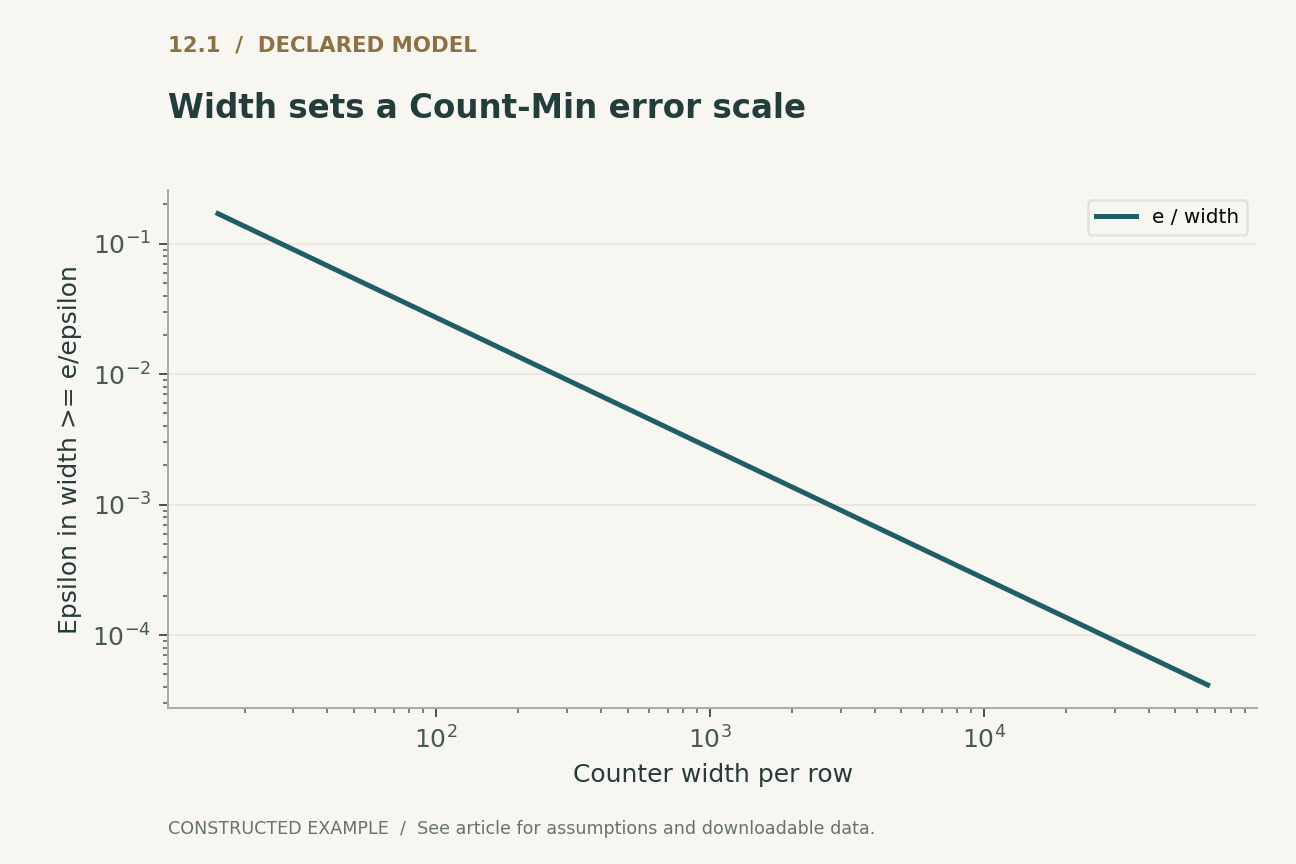
对于一个固定的被查询项,当哈希族具有所需的碰撞性质时,某一行的期望碰撞质量至多为 L1 总质量除以该行宽度。当宽度至少为 e 除以 epsilon 时,该期望至多为 epsilon 乘以 L1 质量再除以 e。随后,马尔可夫不等式将某一行的碰撞质量超过 epsilon 乘以总质量的概率限制为至多 e 的倒数。
当各行相互独立时,所有行均超过阈值的概率至多为 exp(−d),其中 d 为深度。当深度至少为 delta 的倒数的自然对数时,取最小值便得到熟知的失败概率上界。推导揭示了全部依赖条件:非负质量、固定查询、适当的哈希、独立的各行,以及计数器不溢出。去掉任何一个假设,结论都会改变。
固定查询的准确性不等于普遍的自适应准确性
对一个固定查询的保证,并不会自动同时适用于所有可能的查询。对于预先确定、包含 Q 个查询的有限集合,可以利用并集界为每个查询分配更小的失败概率,从而获得所需的集合层面上界。这可能需要增加行数。
当查询或更新依赖摘要所透露的信息时,自适应选择就更为微妙。简单固定输入分析中采用的随机性假设,可能不再能够描述这种交互。向对抗性客户端提供估计值的服务,不应直接将教科书中的单查询界援引为不受限制的自适应保证。评估必须说明,数据流和查询集合是否独立于摘要的随机选择而固定,以及种子是公开的还是私有的。
可合并性体现的是线性,而非幂等性
以相同维度和哈希函数构建的两个 Count-Min 数组可以相加,以概括其频率向量之和。这对分布式聚合很有用。然而,将同一分片加入两次会使其贡献翻倍。合并并非幂等操作,因此会重试的传输机制需要分片标识、版本控制或其他防重复机制。
HyperLogLog 使用另一种合并操作:在哈希与表示兼容的条件下,对寄存器取最大值。这种操作具有不同的代数性质。由此可见,可合并性并不对应一种普遍一致的行为:必须明确操作本身、兼容性约束以及重复的语义。分布式流水线即使使用数学上正确的摘要,若将错误的投递假设应用于合并,仍可能产生错误的聚合结果。
基数误差有其适用范围
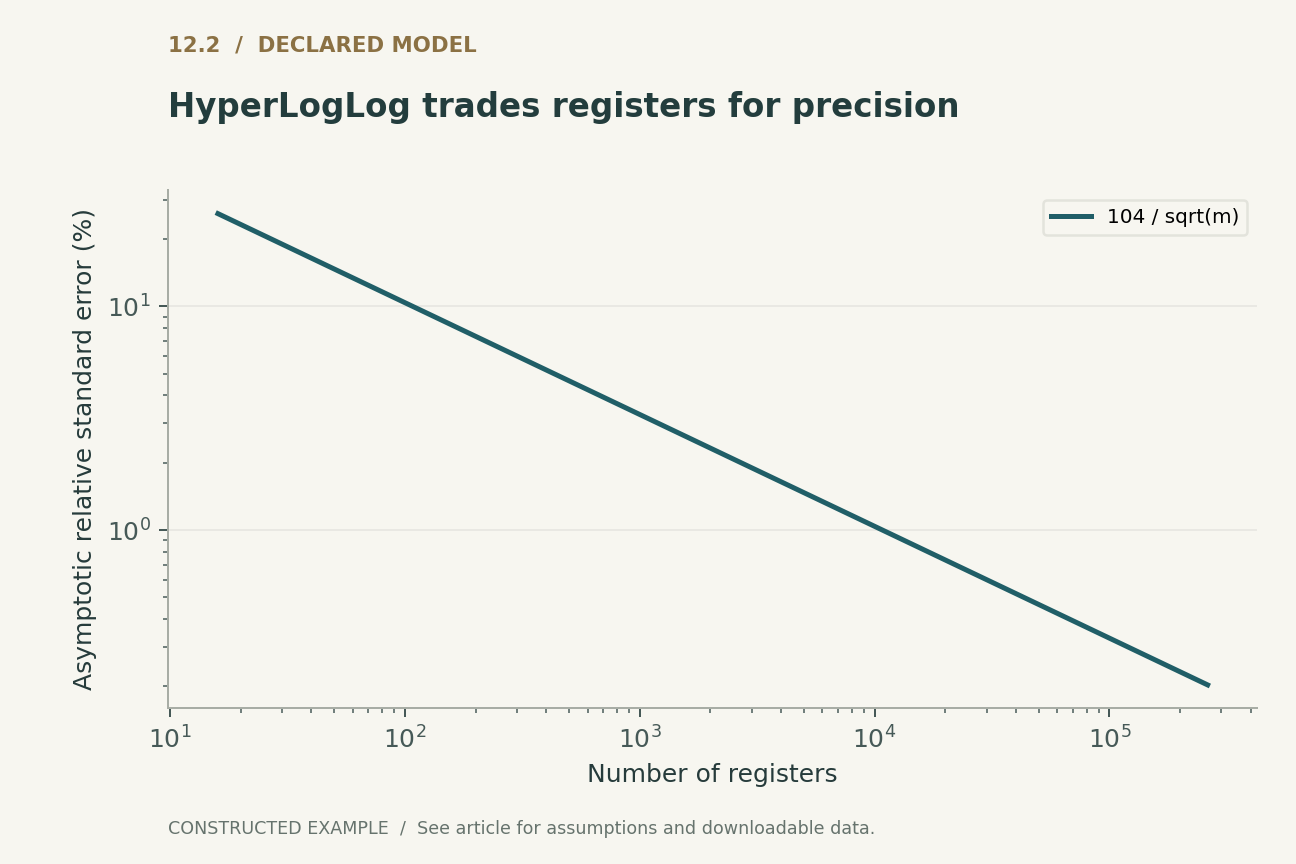
在其渐近条件下,HyperLogLog 常见的相对标准误差近似为 1.04 除以寄存器数量的平方根。第二幅图针对从较小的二的幂次个寄存器到更大规模数组的寄存器数量,绘制了这一表达式。该图被标注为渐近公式,而非对每一种基数和哈希实现的保证。
小基数修正、有限哈希位宽、寄存器表示和估计器变体都会影响实际行为。相对标准误差本身也不是确定性的最大误差或置信区间。当寄存器数为 16,384 时,该公式给出约百分之 0.8125。若部署要求特定的尾部概率,就必须使用适当的分布分析或经校准的证据,而不能把这一标准差当作绝对界限。 [2]
计数器位宽与溢出属于模型的一部分
理论上紧凑的摘要,仍可能因计数器饱和或回绕而失效。饱和会改变估计器的行为,而模运算回绕则可能破坏单侧高估性质。即使不同键的数量不多,加权更新和较长的保留时间窗口也会使这一问题成为实际隐患。
内存预算应包括计数器位宽、种子、元数据,以及用于识别候选高频项的所有结构。频率摘要本身并不一定能枚举估计值较大的键;它回答的是外部提供给它的键的查询。如果应用需要一份高频项列表,就必须在准确性和成本中都计入候选生成机制。否则,公布的内存占用就遗漏了回答实际问题所必需的组件。
有意义的评估应区分三类误差
应将摘要产生的测量误差与摄取误差、查询不匹配区分开来。记录缺失、分片重复或时间窗口不一致,可能比摘要的概率误差影响更大。对错误数据流进行精确估计,结果仍然是错的。
所提方案保留一个针对小型数据流的精确参考实现,测试兼容和不兼容的合并,并纳入重复投递及计数器边界情形。更大规模的实验应在明确声明的随机化方案下,改变分布偏斜程度、总质量、稀有项频率、基数和更新符号。当结论依赖随机化哈希时,应报告跨独立种子的分布。一个有利的种子或一个便利的 Zipf 分布,并不能确立对目标工作负载的广泛准确性。
结论:将假设贯穿于处理流水线
流式摘要通过以明确的近似替代精确状态,使大规模测量变得可行。其价值取决于能否保留推导误差陈述时所依据的条件。更新模型、查询选择、哈希独立性、算术和合并协议,都是结果的一部分。
有限示例既展示了有用的单侧性质,也揭示了加法合并中的重复风险。解析曲线解释了内存如何改变标称准确性,而不将自身冒充为部署测量结果。一个有充分依据的系统会利用这些数学契约设计摄取和查询路径,并在可行时,将完整测量流水线与精确参考实现对照测试。
已在本地执行 · 范围有限
简化 Count-Min 示例中的插入、合并与带符号数据流反例
使用明确给定的固定哈希;不声称提供概率性哈希保证,也不声称实现了 HyperLogLog。
13 项断言通过。 这些检验验证的是所提供的示例,而非所引用的系统。
查看记录的验证见证
{
  "positive_updates": [
    [
      0,
      3
    ],
    [
      1,
      2
    ],
    [
      4,
      5
    ],
    [
      2,
      7
    ],
    [
      7,
      1
    ]
  ],
  "signed_estimate": -2,
  "true_frequency": 3
}明确声明的解析模型
四个方程,明确的假设
(1) 采用兼容的行哈希和精确计数器的 Count-Min 估计。
(2) 在非负频率和所需随机哈希假设下的固定查询界;在精确算术下,下界具有确定性。
(3) 足以满足所述界的 Count-Min 宽度和深度;计数器总数为 wd。
(4) 经典 HyperLogLog 分析中 m 个寄存器对应的渐近相对标准误差;并非普遍的最大误差保证。
构造示例 · 可复现数据
审视定量论证
这些曲线根据明确声明的模型计算得出,并非来自所引用研究的观测结果。每幅图均附有数值数据和矢量版本。


哪类证据回答哪类问题?
| 结构 | 回答的问题 | 重要边界 |
|---|---|---|
| Count-Min | 给定键的频率 | 非负频率与哈希假设;加法合并会重复计入 |
| CountSketch | 带符号频率估计 | 不同的误差范数与双侧行为 |
| HyperLogLog | 不同值的数量 | 渐近适用范围与兼容哈希 |
| 分布式聚合 | 对明确定义的数据流的摘要 | 具体包含哪些分片、版本和窗口 |
拟议的验证方案
这是一项拟议的评估设计。未进行生产系统或硬件基准测试。另行执行的有限模型记录在可执行检验中。
- 为有限数据流构建精确参考实现,并比较每个被查询的键。
- 分别检验非负频率下的高估性质和一般 turnstile 模型的阴性对照。
- 验证具有相同哈希配置的互不重叠分片的线性合并。
- 展示重复的加法合并会改变答案。
- 测试计数器溢出、不兼容种子以及候选键枚举要求。
- 任何关于准确性的实证主张,都应使用多个独立种子和多种工作负载条件。
一手来源确立了什么
Graham Cormode, S. Muthukrishnan · 2005 [1]
贡献。 Count-Min 提供紧凑的频率摘要,并附有有用的加性误差分析。
边界。 单侧解释要求频率非负且哈希适当。
来源定位。 作者托管的手稿,第 3 节和第 4.1 节,定理 1;保留出版版本说明。
Philippe Flajolet, Éric Fusy, Olivier Gandouet et al. · 2007 [2]
贡献。 HyperLogLog 分析了紧凑的基数估计,以及其误差随寄存器数变化的缩放关系。
边界。 小范围行为和实际变体需要各自专门处理。
来源定位。 出版商记录与经典基数估计分析。
Moses Charikar, Kevin Chen, Martin Farach-Colton · 2002 [3]
贡献。 CountSketch 使用带符号的哈希摘要估计频率。
边界。 其保证不同于 Count-Min 的非负碰撞界。
来源定位。 摘要与频率摘要的构造。
本分析的局限
- 本文并未将固定的示意性哈希族表述为满足概率定理的哈希族。
- HyperLogLog 图展示的是渐近公式,而非实现基准测试。
- 一般性的自适应稳健性以及对所有 turnstile 变体的覆盖均不在本文范围内。
- 已核实 Count-Min 来源的书目信息;本次会话未获取完整原文。
这是一篇聚焦于三项选定奠基性一手来源的分析性综述,并附有原创演算示例。它并非对截至 2026 年文献的穷尽性或系统性调查。来源访问和版本说明与参考文献一并记录。
可能改变结论的问题
- 实际数据流是否满足所选界的更新假设与随机性假设?
- 分片重复投递是否可能压过标称近似误差?
- 应用需要的是固定查询估计、同时保证,还是自适应稳健性?
参考文献
- Graham Cormode, S. Muthukrishnan. An improved data stream summary: the count-min sketch and its applications. Journal of Algorithms (2005). 10.1016/j.jalgor.2003.12.001.
- Philippe Flajolet, Éric Fusy, Olivier Gandouet et al.. HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm. Discrete Mathematics & Theoretical Computer Science (2007). 10.46298/dmtcs.3545.
- Moses Charikar, Kevin Chen, Martin Farach-Colton. Finding Frequent Items in Data Streams. Lecture Notes in Computer Science; Automata, Languages and Programming (2002). 10.1007/3-540-45465-9_59.
来源 [1] 访问情况。 已获取作者托管的手稿;查阅了第 3 节和第 4.1 节,包括尺寸设定规则与定理 1。可访问手稿的日期为 2003 年十二月;参考文献标识的是 2005 年的期刊出版版本。
版本说明。 链接的作者手稿早于 2005 年的期刊出版版本。本文采用相对应的 Count-Min 构造和非负频率下的固定查询界;并不声称已对版本差异进行完整审计。
来源 [2] 访问情况。 一手记录、摘要及部分可访问正文;并非对全文或补充材料的穷尽性审计。
来源 [3] 访问情况。 一手记录、摘要及部分可访问正文;并非对全文或补充材料的穷尽性审计。
书目信息已与 Crossref 以及出版商、作者或机构的一手记录核对。下方的来源访问和版本说明界定了覆盖范围;这并非穷尽性的全文审计。
作者身份与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;解析构造与拟议的评估设计归属于本文。
封面是由 ImageGen 生成的概念插图。技术图根据明确声明的模型或有限示例计算而得,并提供 Python 和 CSV。它们不是已部署产品的测量结果,也不是复现的性能基准测试。
这份本地草稿没有独立同行评审或期刊接收记录。范围受限的可执行示例检验所述的小型模型;它们并非对所引用系统的形式化验证。