
摘要
学习型索引利用模型预测记录的位置,但预测精度与查询正确性是不同的性质。本综述通过一个构造的分布偏移,将最初的学习型索引提案、PGM-index 与 ALEX 联系起来。一个能够精确预测等间距键的秩的模型,在键间距发生二次变化后,会产生相当于秩范围四分之一的最大秩误差。一个可执行搜索示例展示了过时的误差窗口为何可能失效,以及经过验证的边界或回退搜索为何能够恢复正确性。分析区分了经验模型误差与有保证的界、静态搜索与更新,以及查找速度与端到端维护成本。图表是分析性构造,而非对学习型索引实现的测量。
预测改变搜索策略
有序索引回答的是一个语义问题:按照某种排序,应该在哪里找到或插入一个键?模型可以估计该位置,减少定位所需的工作。只要最终搜索能够确立正确结果,即使估计并不完美,它仍然有用。
这种分离是稳健学习型索引的基础。较低的平均秩误差并不能证明可以不检查键就返回预测的记录。训练集上的最大误差也不会自动约束插入或删除后的未来状态。系统必须决定如何修正预测、如何界定不确定性,以及如何维护这些界。学习型组件可以充当加速器,而传统的排序不变量仍然是正确性的来源。
三种选定设计
Kraska 及其同事将索引结构视为能够预测位置的模型,并探索学习型替代方案。Ferragina 与 Vinciguerra 的 PGM-index 最终版论文提出了一种具有明确最坏情况界限并支持更新的学习型结构。ALEX 将学习模型与自适应存储和索引技术结合,用于读写更新混合的工作负载。
这些论文在设计与保证方面有所不同。本文使用 PGM 最终版论文,而不是不加说明地依赖其早期预印本的标题和范围。我们不会将任何已报告的加速效果直接移用于新的数据集或机器。相关的比较在于各方法如何将预测与精确搜索联系起来,以及当存储分布或查询工作负载变化时需要完成哪些工作。 [1], [2], [3]
秩函数必须定义边界行为
对于有序序列,将秩定义为严格小于查询值的键的数量。这种下界位置定义能够处理不存在的键,并为重复值给出明确答案。仅用已有键的位置训练的模型,可能无法直接为键之间或数据范围之外的查询提供相同保证。
正确的实现需要明确规定首键、末键、重复值以及空结构下的行为。浮点预测值也必须转换为范围内的整数位置。这些并非无关紧要的细节:即使预测值在数值上看起来很接近,偏差一个位置的窗口也可能排除真正的下界位置。拟议测试中的正确性判定基准是精确的下界位置搜索,而不是模型自身的秩估计。
具有精确误差的分布偏移
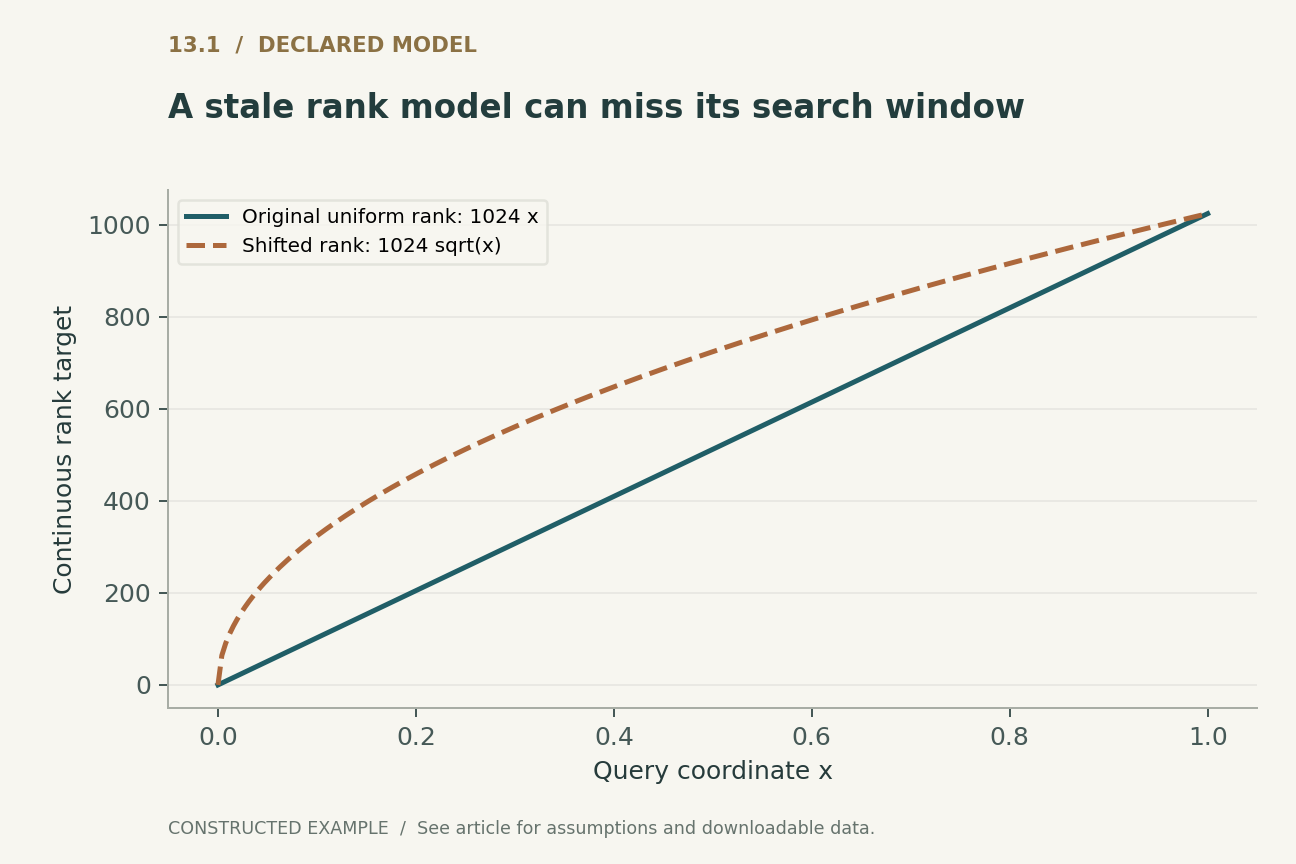
设秩范围为零到 N 减一。归一化且等间距的键,其秩近似为(N 减一)乘以 x。现在,将存储键的位置改为其归一化秩的平方。相应的连续秩曲线变为(N 减一)乘以 x 的平方根,而旧预测器仍保持线性。
误差为(N 减一)乘以(x 的平方根与 x 之差)。求导可得,最大值出现在 x 等于四分之一处,此时误差为(N 减一)除以四。当 N 等于 1,025 时,最大误差为 256 个秩位置。这种构造的变化被刻意设计得足够简单,以便精确推导。它并不是声称实际工作负载会以二次形式漂移,而是一个反例,说明不应在未维护保证的情况下信任旧的小误差窗口。
过时的窗口可能排除答案
假设旧模型只搜索预测位置左右各四个位置。在构造的最大误差点附近,真实秩相距数百个位置。局限于过时窗口中的搜索,无法仅凭更好的局部搜索算法恢复正确的下界位置。
附录将存储键和额外查询与精确二分搜索进行核对。它记录未经验证的窄窗口所产生的失败,然后在候选位置不满足全局下界位置相邻条件时应用回退搜索。这个小型算法不是 PGM 或 ALEX 的实现。它展示了一项设计原则:要么由持续维护的证书保证答案位于窗口内,要么就需要验证结果并提供安全的退出路径。
经验误差与有保证的误差承担不同作用
训练集上的最大误差可以描述拟合数据;如果模型与搜索语义能够论证对所有相关查询的覆盖,它也可以支持静态证书。但它并不会自动成为关于未来更新的、与分布无关的承诺。统计置信区间也不同于确定性的搜索界限。
PGM 工作的相关性在于,它将最坏情况保证纳入了数据结构设计。学习型系统应明确说明哪些界是结构性的,哪些只是用于调优的经验观察。如果回退机制能够保持正确性,模型退化就可能成为性能问题,而非答案错误问题。这种分离很有价值,但仍需测试:在所有局部保证不可用的情况下,是否都能进入回退路径。 [2]
更新同时改变数据与成本边界
插入一个键会改变后续秩,并可能需要物理移动、空隙管理、模型调整或重建。删除也会带来类似的维护问题。因此,如果维护其表示的成本很高,即使模型的查找误差表现优异,也可能在写密集型工作负载中表现不佳。
ALEX 将自适应更新行为作为核心设计问题。可推广的评估要求是随时间测量完整的操作组合。批量加载一个有利的数据集并只测量读取时间,会遗漏保持自适应索引有用所需的工作。应报告更新延迟分布、写放大、内存预留空闲量、重建停顿,以及分布偏移的影响。如果维护异步执行,还应包括其资源消耗,以及新旧表示共存期间的正确性规则。 [3]
搜索窗口大小对应对数级局部成本
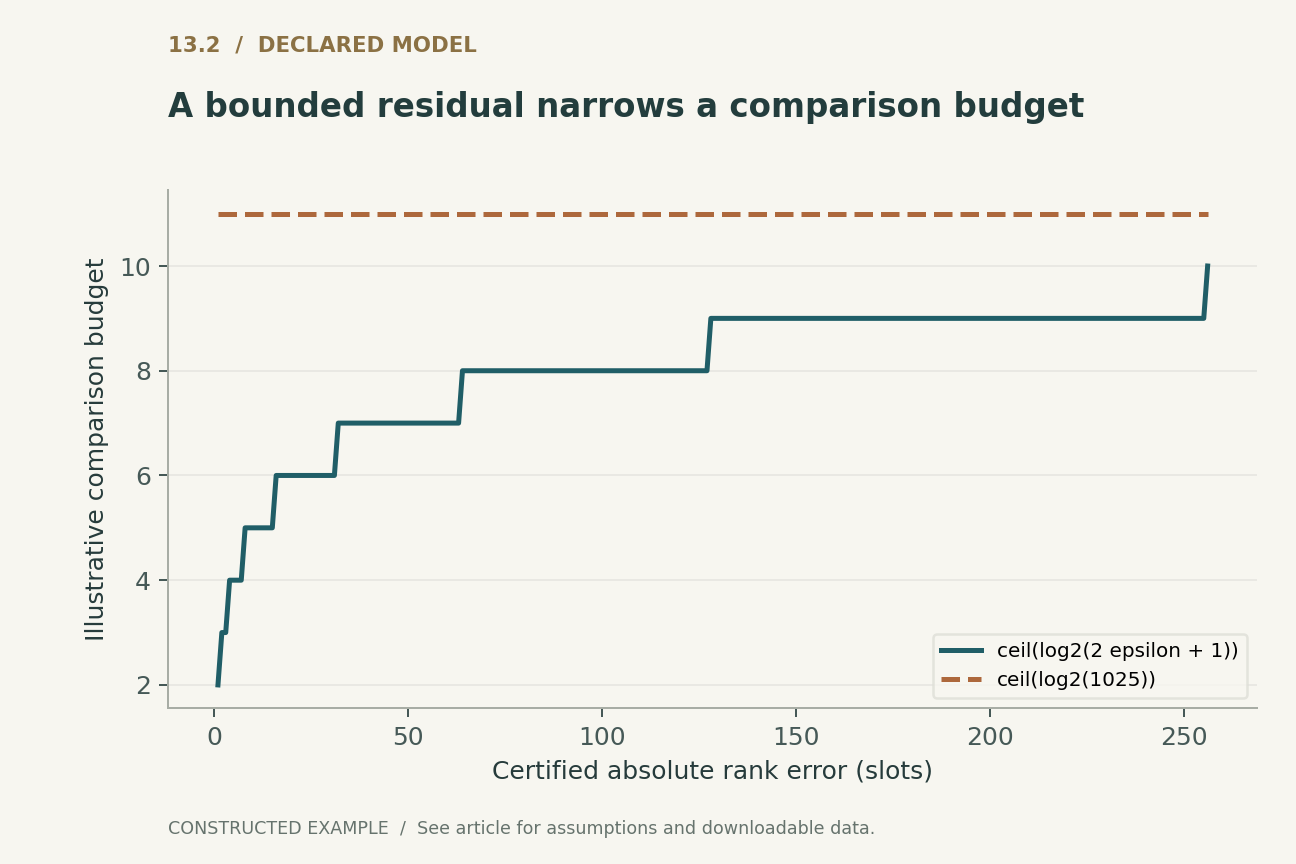
对于一个经过验证、至多包含二倍 epsilon 加一数量的位置的区间,二分搜索式局部过程的比较次数尺度与该区间大小的对数成正比。第二幅图绘制了随 epsilon 变化的简单对数向上取整计数,并同时给出整个数组对应的尺度。
这是抽象的比较次数,而不是对 CPU 时间的预测。在实际硬件上,模型求值、缓存未命中、分支行为、向量化和内存布局都可能占主导地位。如果获得更小窗口需要代价高昂的模型,它可能无法改善延迟。反过来,略宽的窗口如果仍位于同一条缓存行中,成本也可能很低。性能论证必须包含预测器和修正路径,而不能只考虑候选记录的数量。
数据分布与查询分布并不相同
索引可以很好地拟合存储键,却服务于一个集中在困难区域的查询分布。不存在键的查询、范围扫描和热点的成本,可能不同于均匀抽样的成功查找。更新也可能集中在分布的一侧尾部,而读取针对另一侧。
因此,拟议基准将存储键分布与查询和更新分布分开。它包括在受支持时使用重复值、范围外探测、偏斜、交替阶段,以及渐进或突发变化。应在全过程中检查正确性,而不只是重建之后。结果应同时报告平均行为和尾部行为,因为总体上很少发生的回退,可能主导某个用户的工作负载或某一键范围。
可复现的比较
对所有索引使用相同的键顺序、载荷大小、操作语义和持久性要求。保留数据生成代码与随机种子,并在规模可控的数据集上,将每个操作与精确参考实现进行核对。将批量加载和维护工作与稳态查找性能分开测量,然后报告它们在预期生命周期内的总成本。
本地构造有意避免速度竞赛。它确立精确的秩误差曲线,并展示安全的修正边界。真正的性能结论需要本文并未实际测试的实现、硬件与工作负载。这一区分可以避免将预测误差上的数学优势表述为已观察到的系统优势。
结论:让模型预测,让索引验证
当近似用于减少工作量,而精确的数据结构不变量决定答案时,学习型索引最具说服力。挑战不只是拟合一个函数,而是保持函数、存储键、更新与搜索边界之间的有效关系。
二次偏移见证示例表明,一个曾经完美的预测器,即使没有任何软件缺陷,也可能变得不准确。持续维护的界或经过验证的回退机制,可以使由此产生的问题仍局限于性能领域。随后,严格评估应测量在完整工作负载生命周期中维持这种分离的成本,而不是只报告最有利的查找阶段。
本地执行 · 范围有限
分布偏移导致的搜索失败与精确且经过验证的回退
构造的键与简化的秩预测器;不是 PGM、RMI 或 ALEX 的性能基准。
2060 项断言通过。 这些检查验证的是所提供的示例,而不是引用的系统。
查看记录的见证示例
{
  "queries": 2051,
  "fallbacks": 2027,
  "stale_rank": 261,
  "true_rank": 512
}明确声明的分析模型
四个方程,明确的假设
(1) 下界位置的秩,包括不存在键与重复值的语义。
(2) x 位于 [0,1] 内时,等间距与二次键间距的连续秩曲线。离散查找另行检查。
(3) 最大值出现在 x = 1/4;N = 1025 时为 256 个秩位置。
(4) 针对具有保证的有界窗口,示意二分搜索比较次数的尺度;并非实际经过时间的延迟,也不是每种实现的精确计数。
构造示例 · 可复现数据
查看定量论证
这些曲线根据明确声明的模型计算得出,并非引用研究中的观测结果。每幅图都包含数值数据和矢量版本。


哪些证据回答哪些问题?
| 量 | 含义 | 不能推出的结论 |
|---|---|---|
| 平均预测误差 | 拟合秩的典型精度 | 最坏情况下仍正确的搜索窗口 |
| 持续维护的确定性界 | 具有保证的修正区间 | 较低的模型求值成本 |
| 回退正确性 | 错误预测仍能得到精确答案 | 稳定的尾延迟 |
| 读取基准 | 该查询分布下的成本 | 低成本的更新或重建 |
拟议验证方案
这是一项拟议的评估设计。未执行生产系统或硬件基准。另行执行的有限模型记录在可执行检查中。
- 精确定义下界位置、重复值和不存在键的语义。
- 将每个有限示例与独立的二分搜索判定基准核对。
- 在不更新旧模型的情况下应用二次间距偏移,并保留失败见证示例。
- 接受局部搜索结果之前,核实持续维护的界或全局相邻条件验证。
- 测试插入、删除、重建及混合查询分布。
- 综合测量模型、修正、回退、维护和内存成本。
一手来源确立了什么
Tim Kraska, Alex Beutel, Ed H. Chi et al. · 2018 [1]
贡献。 学习型索引结构利用模型预测位置,并探索传统索引组件的替代方案。
边界。 所报告的收益取决于评估所用的数据集、硬件和设计。
来源定位。 最初的学习型索引论文及其摘要。
Paolo Ferragina, Giorgio Vinciguerra · 2020 [2]
贡献。 PGM-index 最终版论文提出了明确的最坏情况界限与动态变体。
边界。 引用范围以 VLDB 最终版为准;早期预印本标题不同。
来源定位。 VLDB 最终版论文的摘要与保证。
Jialin Ding, Umar Farooq Minhas, Jia Yu et al. · 2020 [3]
贡献。 ALEX 将预测与自适应存储技术结合,用于更新工作负载。
边界。 必须在预期的操作组合下测量更新性能。
来源定位。 作者手稿的摘要与自适应索引设计。
本分析的局限
- 秩偏移曲线是构造的连续函数,而非经验工作负载分布。
- 本地回退示例不是 PGM、RMI 或 ALEX。
- 比较次数无法预测缓存行为或实际时间性能。
- 未对任何现有学习型索引实现进行基准测试。
这是一篇聚焦于三项选定的奠基性一手来源、并包含原创推演示例的分析性综述,并非截至 2026 年文献的穷尽性或系统性综述。来源访问范围与版本说明随参考文献一同记录。
可能改变结论的问题
- 每次更新后,是什么在维护修正界?
- 分布偏移后,哪个查询区域主导回退与尾延迟?
- 计入模型求值、预留空间和重建之后,完整生命周期是否仍然受益?
参考文献
- Tim Kraska, Alex Beutel, Ed H. Chi et al.. The Case for Learned Index Structures. Proceedings of the 2018 International Conference on Management of Data (2018). 10.1145/3183713.3196909.
- Paolo Ferragina, Giorgio Vinciguerra. The PGM-index: a fully-dynamic compressed learned index with provable worst-case bounds. Proceedings of the VLDB Endowment (2020). 10.14778/3389133.3389135.
- Jialin Ding, Umar Farooq Minhas, Jia Yu et al.. ALEX: An Updatable Adaptive Learned Index. Proceedings of the 2020 ACM SIGMOD International Conference on Management of Data (2020). 10.1145/3318464.3389711.
来源 [1] 的访问范围。 一手记录、摘要及部分可获取正文;并非对全文或补充材料的穷尽性审查。
来源 [2] 的访问范围。 一手记录、摘要及部分可获取正文;并非对全文或补充材料的穷尽性审查。
版本说明。 引用的是 VLDB 最终版论文;早期 arXiv 版本的标题不同。
来源 [3] 的访问范围。 一手记录、摘要及部分可获取正文;并非对全文或补充材料的穷尽性审查。
文献身份信息已与 Crossref 及出版方、作者或机构的一手记录核对。下方的来源访问与版本说明界定了核查范围;这并非穷尽性的全文审查。
作者与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析性构造与拟议评估设计归属于本文。
封面是由 ImageGen 生成的概念插图。技术图表根据明确声明的模型或有限示例计算,并提供 Python 与 CSV。它们不是对已部署产品的测量,也不是复现的性能基准。
本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查所述小型模型;它们不是对引用系统的形式化验证。