
Resumen
Los índices aprendidos utilizan modelos para predecir dónde se encuentran los registros, pero la precisión de la predicción y la corrección de las consultas son propiedades diferentes. Esta revisión conecta la propuesta original de índices aprendidos, el índice PGM y ALEX mediante un cambio de distribución construido. Un modelo que predice exactamente los rangos de claves espaciadas uniformemente incurre en un error máximo de rango igual a una cuarta parte de la amplitud de los rangos tras un cambio cuadrático del espaciado. Un ejemplo de búsqueda ejecutable demuestra por qué una ventana de error desactualizada puede fallar y por qué un límite verificado o una búsqueda de respaldo restablece la corrección. El análisis distingue el error empírico del modelo de las cotas certificadas, la búsqueda estática de las actualizaciones y la velocidad de consulta del coste de mantenimiento de extremo a extremo. Las figuras son construcciones analíticas, no mediciones de una implementación de índices aprendidos.
La predicción cambia la estrategia de búsqueda
Un índice ordenado responde a una pregunta semántica: ¿dónde debería encontrarse o insertarse una clave de acuerdo con un orden? Un modelo puede estimar esa posición y reducir el trabajo necesario para localizarla. La estimación resulta útil incluso cuando es imperfecta, siempre que la búsqueda final establezca el resultado correcto.
Esta separación es el fundamento de un índice aprendido robusto. Un error medio de rango bajo no justifica devolver un registro predicho sin comprobar la clave. Tampoco el error máximo del conjunto de entrenamiento acota automáticamente los estados futuros tras una inserción o eliminación. El sistema debe decidir cómo se corrigen las predicciones, cómo se acota la incertidumbre y cómo se mantienen esas cotas. Un componente aprendido puede actuar como acelerador mientras un invariante convencional de ordenación sigue siendo la fuente de corrección.
Tres diseños seleccionados
Kraska y sus colaboradores plantean las estructuras de índices como modelos capaces de predecir posiciones y exploran alternativas aprendidas. El artículo definitivo sobre el índice PGM, de Ferragina y Vinciguerra, desarrolla una estructura aprendida con cotas explícitas para el peor caso y soporte para actualizaciones. ALEX combina modelos aprendidos con técnicas adaptativas de almacenamiento e indexación para cargas de trabajo mixtas de lectura y actualización.
Los artículos difieren en diseño y garantías. Aquí se utiliza el artículo definitivo de PGM, en lugar de apoyarse tácitamente en el título y el alcance de su prepublicación anterior. No trasladamos ninguna aceleración comunicada a un nuevo conjunto de datos o equipo. La comparación pertinente es cómo conecta cada enfoque la predicción con la búsqueda exacta y qué trabajo requiere cuando cambia la distribución almacenada o la carga de consultas. [1], [2], [3]
Una función de rango debe definir el comportamiento en los límites
Para una secuencia ordenada, se define el rango como el número de claves estrictamente menores que la consulta. Esta definición de límite inferior contempla las claves ausentes y ofrece una respuesta clara para los valores duplicados. Un modelo entrenado únicamente con posiciones de claves presentes puede no proporcionar directamente la misma garantía para consultas entre claves o fuera del intervalo de datos.
Una implementación correcta necesita un comportamiento explícito en la primera y la última clave, para los duplicados y para una estructura vacía. Las predicciones en coma flotante también deben convertirse en posiciones enteras acotadas. No son detalles secundarios: una ventana desplazada una posición puede excluir el verdadero límite inferior aunque la predicción parezca numéricamente cercana. El oráculo de corrección de las pruebas propuestas es una búsqueda exacta del límite inferior, no la propia estimación de rango del modelo.
Un cambio de distribución con un error exacto
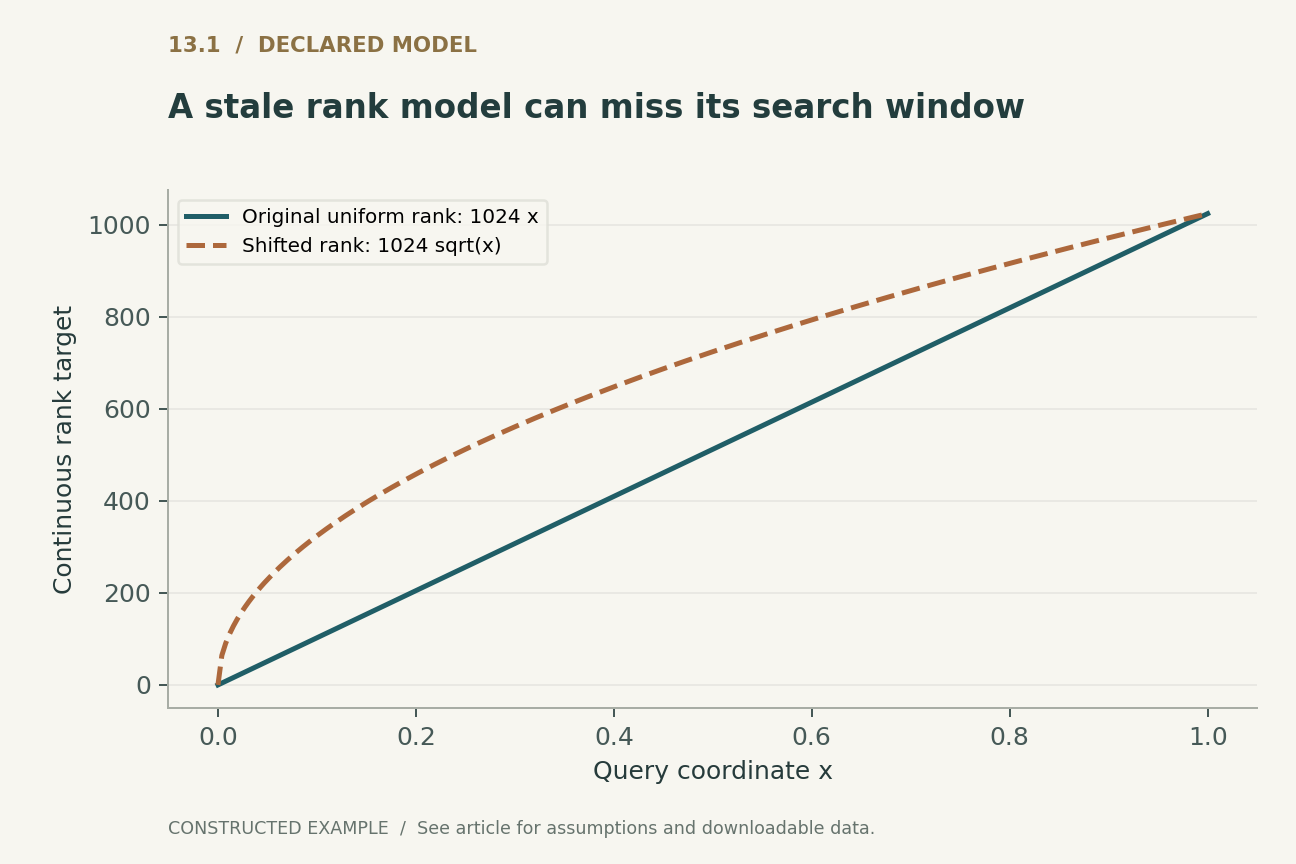
Sea el intervalo de rangos desde cero hasta N menos uno. Las claves normalizadas y espaciadas uniformemente tienen un rango aproximadamente igual a N menos uno multiplicado por x. Ahora se cambian las posiciones de las claves almacenadas por el cuadrado de su rango normalizado. La curva continua de rango correspondiente pasa a ser N menos uno multiplicado por la raíz cuadrada de x, mientras el predictor antiguo sigue siendo lineal.
El error es N menos uno multiplicado por la diferencia entre la raíz cuadrada de x y x. La derivación da un máximo en x igual a un cuarto, donde el error es N menos uno dividido entre cuatro. Para N igual a 1,025, el máximo es de 256 rangos. Este cambio construido es deliberadamente lo bastante sencillo como para derivarlo de forma exacta. No afirma que las cargas reales deriven de forma cuadrática; es un contraejemplo a la confianza en una ventana de error antigua y pequeña sin mantener su garantía.
Una ventana desactualizada puede excluir la respuesta
Supongamos que el modelo antiguo solo busca cuatro posiciones a cada lado de su predicción. Cerca del punto construido de error máximo, el rango verdadero se encuentra a cientos de posiciones. Una búsqueda confinada a la ventana desactualizada no puede recuperar el límite inferior correcto simplemente mediante un algoritmo de búsqueda local mejor.
El apéndice comprueba las claves almacenadas y consultas adicionales frente a una búsqueda binaria exacta. Registra los fallos de la ventana estrecha no validada y después aplica una búsqueda de respaldo cuando el candidato no satisface las condiciones globales de vecindad del límite inferior. Este pequeño algoritmo no es una implementación de PGM ni de ALEX. Demuestra un principio de diseño: o bien un certificado mantenido garantiza que la respuesta está dentro de la ventana, o bien el resultado necesita validación y una vía de salida segura.
El error empírico y el error certificado cumplen funciones distintas
Un máximo del conjunto de entrenamiento puede describir los datos ajustados y respaldar un certificado estático si el modelo y la semántica de búsqueda justifican la cobertura de todas las consultas pertinentes. No constituye automáticamente una promesa independiente de la distribución sobre futuras actualizaciones. Un intervalo de confianza estadístico también difiere de una cota determinista de búsqueda.
El trabajo sobre PGM es pertinente porque incorpora las garantías para el peor caso al diseño de la estructura de datos. Un sistema aprendido debería indicar exactamente qué cotas son estructurales y cuáles son observaciones empíricas de ajuste. Si una búsqueda de respaldo preserva la corrección, la degradación del modelo puede convertirse en un problema de rendimiento en vez de uno de respuestas incorrectas. Es una separación valiosa, pero sigue exigiendo comprobar que se alcanza la búsqueda de respaldo en todas las condiciones en las que no se dispone de la garantía local. [2]
Las actualizaciones desplazan tanto los datos como el límite de costes
Insertar una clave cambia los rangos posteriores y puede requerir movimiento físico, gestión de huecos, ajuste del modelo o reconstrucción. La eliminación plantea una cuestión de mantenimiento similar. Por tanto, un modelo con un excelente error de consulta puede rendir mal con una carga intensiva en escrituras si mantener su representación resulta costoso.
ALEX aborda el comportamiento adaptativo de las actualizaciones como una cuestión central de diseño. El requisito de evaluación transferible consiste en medir una mezcla completa de operaciones a lo largo del tiempo. Cargar masivamente un conjunto de datos favorable y cronometrar solo las lecturas omite el trabajo que mantiene útil un índice adaptativo. Deben comunicarse las distribuciones de latencia de actualización, la amplificación de escritura, la memoria libre reservada, las pausas de reconstrucción y el efecto del cambio de distribución. Si el mantenimiento se ejecuta de forma asíncrona, deben incluirse su consumo de recursos y las reglas de corrección mientras coexisten las representaciones antigua y nueva. [3]
El tamaño de la ventana de búsqueda tiene un coste local logarítmico
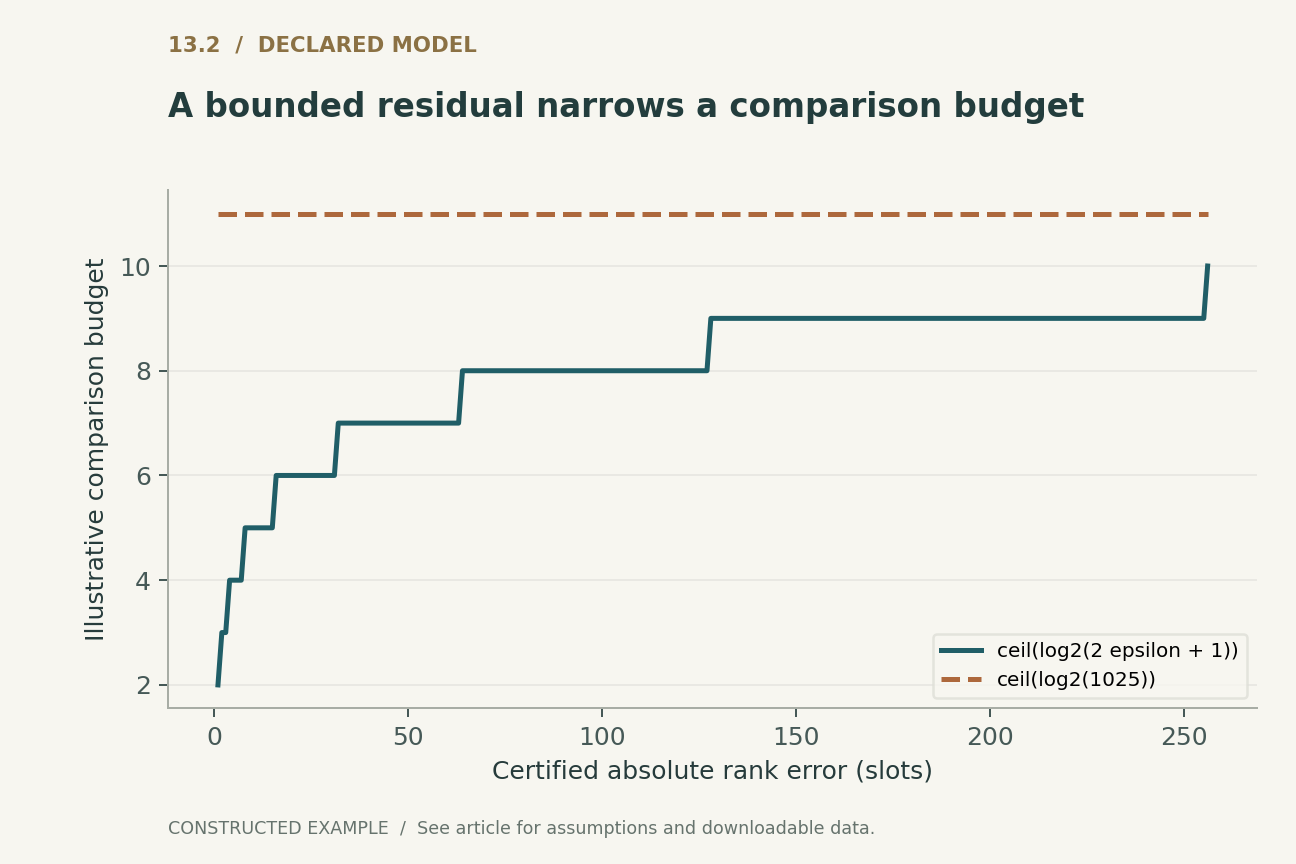
Para un intervalo validado que contiene como máximo dos épsilon más una posiciones, un procedimiento local de tipo búsqueda binaria tiene una escala de comparaciones proporcional al logaritmo del tamaño de ese intervalo. La segunda figura representa un recuento sencillo basado en el logaritmo redondeado hacia arriba en función de épsilon, junto con la escala correspondiente al arreglo completo.
Se trata de un recuento abstracto de comparaciones, no de una predicción del tiempo de CPU. La evaluación del modelo, los fallos de caché, el comportamiento de las bifurcaciones, la vectorización y la disposición de la memoria pueden dominar en el hardware real. Una ventana más pequeña puede no mejorar la latencia si obtenerla requiere un modelo costoso. A la inversa, una ventana ligeramente más amplia puede ser barata si permanece dentro de una sola línea de caché. El argumento sobre rendimiento debe incluir el predictor y la ruta de corrección, no solo el número de registros candidatos.
La distribución de los datos y la de las consultas son distintas
Un índice puede ajustarse bien a las claves almacenadas y, al mismo tiempo, atender una distribución de consultas concentrada en una región difícil. Las consultas de claves ausentes, los recorridos por rango y los puntos calientes pueden tener costes distintos de los de consultas exitosas muestreadas uniformemente. Las actualizaciones también pueden concentrarse en una cola mientras las lecturas se dirigen a la otra.
Por ello, la prueba de rendimiento propuesta separa la distribución de claves almacenadas de las distribuciones de consultas y actualizaciones. Incluye duplicados cuando se admiten, consultas fuera de rango, sesgo, fases alternantes y cambios graduales o abruptos. La corrección debería comprobarse durante todo el proceso, no solo después de reconstruir. El resultado debería informar tanto del comportamiento medio como del de cola, ya que una búsqueda de respaldo infrecuente en términos globales puede dominar la carga de un usuario concreto o un intervalo de claves.
Una comparación reproducible
Utilice la misma ordenación de claves, tamaño de carga útil, semántica de operaciones y requisitos de durabilidad para todos los índices. Conserve el código de generación de datos y las semillas aleatorias, y verifique cada operación frente a una referencia exacta en un conjunto de datos manejable. Mida el trabajo de carga masiva y mantenimiento por separado del rendimiento de consulta en régimen estable y después comunique su total para el ciclo de vida previsto.
La construcción local evita deliberadamente una competición de velocidad. Establece la curva exacta del error de rango y demuestra un límite seguro de corrección. Una conclusión real sobre rendimiento requeriría implementaciones, hardware y cargas de trabajo que aquí no se han probado. Esta distinción evita presentar una ventaja matemática en el error de predicción como una ventaja observada a nivel de sistemas.
Conclusión: que el modelo prediga y el índice verifique
Los índices aprendidos resultan más convincentes cuando se utiliza la aproximación para reducir el trabajo mientras los invariantes exactos de la estructura de datos determinan la respuesta. El reto no consiste solo en ajustar una función, sino en preservar una relación válida entre la función, las claves almacenadas, las actualizaciones y los límites de búsqueda.
El caso testigo del cambio cuadrático muestra cómo un predictor antes perfecto puede volverse impreciso sin ningún error de software. Una cota mantenida o una búsqueda de respaldo verificada puede mantener el problema resultante en el ámbito del rendimiento. Una evaluación rigurosa mide entonces el coste de mantener esa separación durante todo el ciclo de vida de la carga de trabajo, en lugar de informar únicamente de la fase de consulta más favorable.
Ejecutado localmente · Alcance acotado
Fallo por cambio de distribución y búsqueda de respaldo exacta y validada
Claves construidas y predictor de rango de juguete; no es una prueba de rendimiento de PGM, RMI ni ALEX.
Se superaron 2060 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el caso testigo registrado
{
  "queries": 2051,
  "fallbacks": 2027,
  "stale_rank": 261,
  "true_rank": 512
}
Descargar los 20 ejemplos ejecutablesLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Rango de límite inferior, incluida la semántica de claves ausentes y duplicados.
(2) Curvas continuas de rango para espaciado uniforme y espaciado cuadrático de claves con x en [0,1]. La consulta discreta se comprueba por separado.
(3) El máximo se alcanza en x = 1/4; N = 1025 da 256 rangos.
(4) Escala ilustrativa de comparaciones de búsqueda binaria para una ventana acotada certificada; no representa la latencia medida como tiempo transcurrido ni un recuento exacto para todas las implementaciones.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Magnitud | Significado | No implica |
|---|---|---|
| Error medio de predicción | Precisión típica del rango ajustado | Ventana de búsqueda correcta en el peor caso |
| Cota determinista mantenida | Un intervalo de corrección certificado | Bajo coste de evaluación del modelo |
| Corrección de la búsqueda de respaldo | Las predicciones erróneas siguen produciendo respuestas exactas | Latencia de cola estable |
| Prueba de rendimiento de lectura | Coste para su distribución de consultas | Actualizaciones o reconstrucción baratas |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Definir con exactitud la semántica del límite inferior, de los duplicados y de las claves ausentes.
- Comprobar cada ejemplo finito frente a un oráculo independiente de búsqueda binaria.
- Aplicar el cambio de espaciado cuadrático sin actualizar el modelo antiguo y conservar el caso testigo del fallo.
- Verificar las cotas mantenidas o la validación global de vecinos antes de aceptar los resultados de la búsqueda local.
- Probar inserciones, eliminaciones, reconstrucciones y distribuciones mixtas de consultas.
- Medir conjuntamente los costes del modelo, la corrección, la búsqueda de respaldo, el mantenimiento y la memoria.
Qué establecen las fuentes primarias
Tim Kraska, Alex Beutel, Ed H. Chi et al. · 2018 [1]
Contribución. Las estructuras de índices aprendidos utilizan modelos para predecir posiciones y explorar alternativas a los componentes convencionales de índices.
Límite. Las mejoras comunicadas dependen de los conjuntos de datos, el hardware y el diseño evaluados.
Localización en la fuente. Artículo original sobre índices aprendidos y su resumen.
Paolo Ferragina, Giorgio Vinciguerra · 2020 [2]
Contribución. El artículo definitivo sobre el índice PGM desarrolla cotas explícitas para el peor caso y variantes dinámicas.
Límite. El alcance citado corresponde a la versión definitiva de VLDB; el título de la prepublicación anterior es distinto.
Localización en la fuente. Resumen y garantías del artículo definitivo de VLDB.
Jialin Ding, Umar Farooq Minhas, Jia Yu et al. · 2020 [3]
Contribución. ALEX combina la predicción con técnicas adaptativas de almacenamiento para cargas de actualización.
Límite. El rendimiento de las actualizaciones debe medirse con la mezcla de operaciones prevista.
Localización en la fuente. Resumen del manuscrito de los autores y diseño del índice adaptativo.
Límites de este análisis
- Las curvas de cambio de rango son funciones continuas construidas, no distribuciones empíricas de cargas de trabajo.
- El ejemplo local de búsqueda de respaldo no es PGM, RMI ni ALEX.
- Los recuentos de comparaciones no predicen el comportamiento de la caché ni el rendimiento medido en tiempo transcurrido.
- No se sometió a pruebas de rendimiento ninguna implementación actual de índices aprendidos.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos originales desarrollados. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso y versiones de las fuentes se registran junto a la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué mantiene la cota de corrección después de cada actualización?
- ¿Qué región de consultas domina el recurso a la búsqueda de respaldo y la latencia de cola después del cambio de distribución?
- ¿Sigue beneficiándose el ciclo de vida completo al contabilizar la evaluación del modelo, el espacio libre reservado y la reconstrucción?
Referencias
- Tim Kraska, Alex Beutel, Ed H. Chi et al.. The Case for Learned Index Structures. Proceedings of the 2018 International Conference on Management of Data (2018). 10.1145/3183713.3196909.
- Paolo Ferragina, Giorgio Vinciguerra. The PGM-index: a fully-dynamic compressed learned index with provable worst-case bounds. Proceedings of the VLDB Endowment (2020). 10.14778/3389133.3389135.
- Jialin Ding, Umar Farooq Minhas, Jia Yu et al.. ALEX: An Updatable Adaptive Learned Index. Proceedings of the 2020 ACM SIGMOD International Conference on Management of Data (2020). 10.1145/3318464.3389711.
Acceso a la fuente [1]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Nota sobre la versión. Se cita el artículo definitivo de VLDB; el título anterior de arXiv es distinto.
Acceso a la fuente [3]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Las identidades bibliográficas se comprobaron con Crossref y con registros primarios de editoriales, autores o instituciones. Las notas siguientes sobre acceso y versiones de las fuentes describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Escrito y revisado técnicamente por el propio Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.