
Resumen
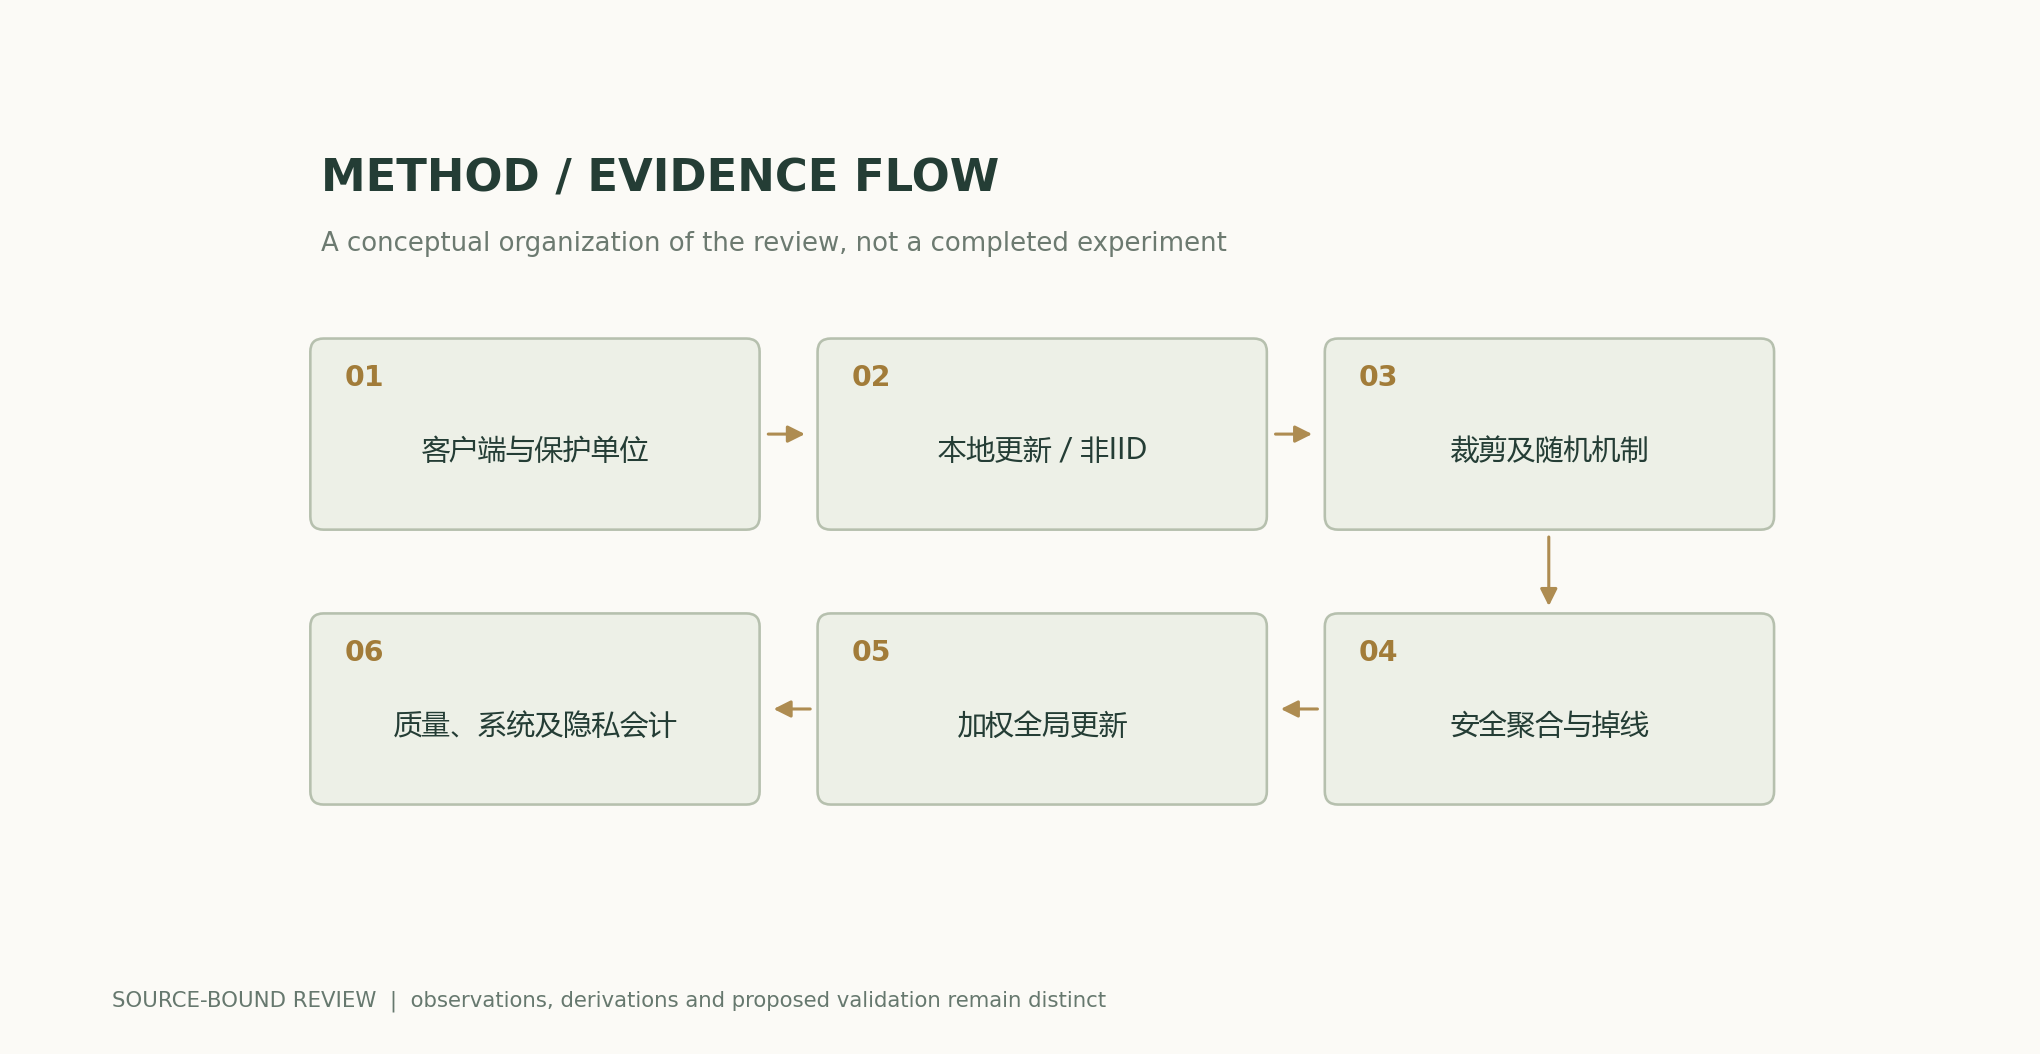
Mantener los datos de entrenamiento en los dispositivos puede reducir la recopilación centralizada de datos sin procesar, pero no oculta automáticamente la información contenida en las actualizaciones del modelo. Este artículo distingue el mecanismo de optimización de FedAvg, la protección que ofrece la agregación segura frente a la visibilidad de las actualizaciones individuales y la garantía probabilística de la privacidad diferencial, y analiza los efectos de los datos no independientes ni idénticamente distribuidos, el sesgo de participación y el recorte. Los gradientes de las figuras son completamente construidos; no se utilizaron datos personales ni se calculó ningún presupuesto de privacidad real.[1] Communication-Efficient Learning of Deep Networks from [2] Deep Learning with Differential Privacy[3] Practical Secure Aggregation for Federated Learning on
Traducción del resumen en inglés
El aprendizaje federado, la agregación segura y la privacidad diferencial abordan distintos canales de exposición. Derivamos el promedio ponderado y el recorte, y señalamos la necesidad de una unidad de privacidad, una definición de adyacencia y un mecanismo de contabilidad de privacidad. Los gráficos construidos de gradientes y recorte no contienen datos privados de clientes ni implican presupuesto de privacidad alguno. La participación no IID, las desconexiones y los costes del sistema forman parte de la evaluación.
1. La optimización federada cambia primero la ubicación de los datos y del cómputo
FedAvg hace que los clientes realicen actualizaciones locales y después las agrega con los pesos especificados. Ponderar por el número de muestras y asignar el mismo peso a cada cliente corresponden a objetivos distintos, mientras que los datos no IID y el entrenamiento local de varios pasos pueden causar deriva de los clientes. La disponibilidad de los dispositivos, la red y la frecuencia de participación también pueden hacer que los participantes reales difieran de la población objetivo. Por tanto, «los datos sin procesar no se suben» es solo una descripción del procedimiento y no puede sustituir al análisis del objetivo de optimización, la equidad y la privacidad.[1] Communication-Efficient Learning of Deep Networks from
2. Las actualizaciones aún pueden contener información sensible
Los gradientes o las diferencias entre modelos son funciones de los datos; que el servidor vea las actualizaciones no significa que no pueda ver señales relacionadas con los datos. Bajo las condiciones del protocolo, la agregación segura permite al servidor obtener un valor agregado en lugar de las actualizaciones individuales en texto claro, pero aun así deben especificarse el umbral de participación, la colusión y la gestión de las desconexiones. El propio resultado agregado puede revelar información sobre la población o sobre grupos pequeños, y el protocolo tampoco impide automáticamente que los clientes maliciosos envíen actualizaciones anómalas. La comunicación segura, la agregación robusta y la privacidad estadística deben validarse por separado.[3] Practical Secure Aggregation for Federated Learning on
3. El recorte controla cada contribución, pero introduce sesgo
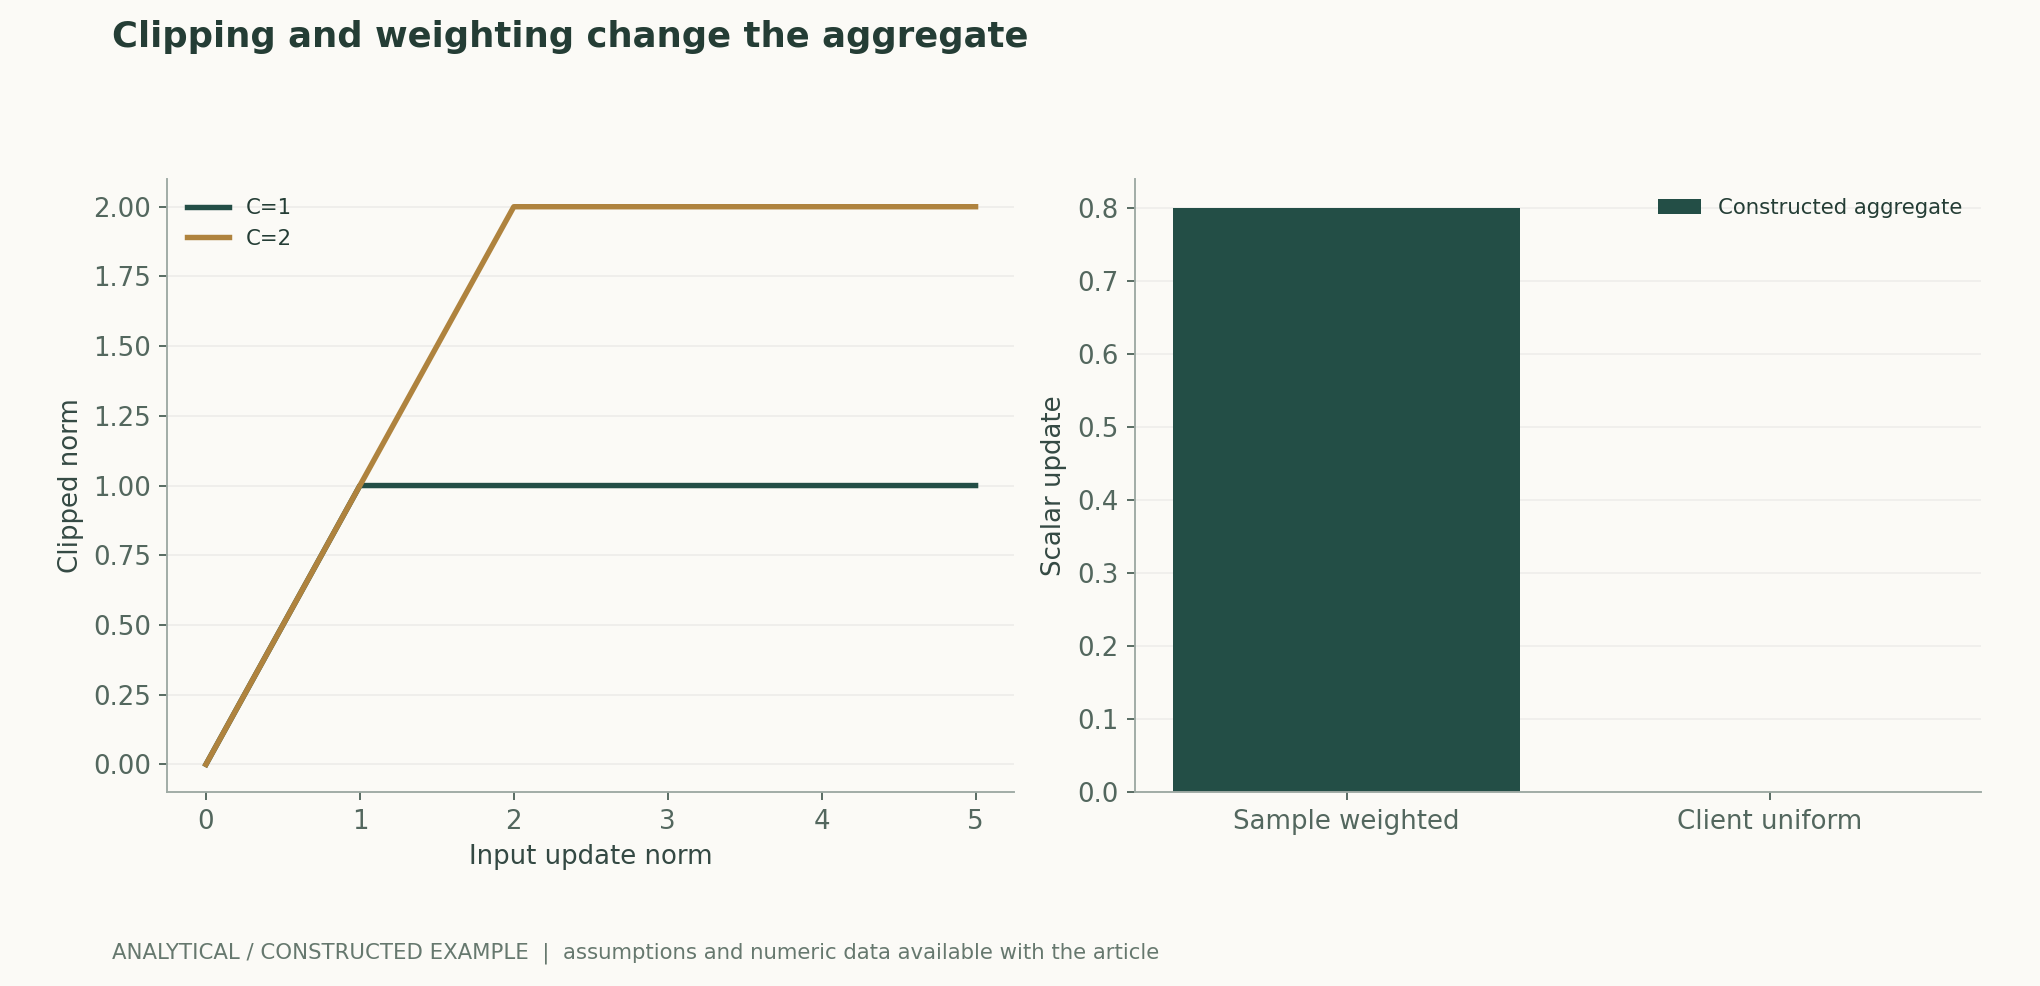
Limitar superiormente la norma de las actualizaciones a C permite acotar la sensibilidad y evitar que unas pocas actualizaciones grandes dominen sin límite; las actualizaciones que superan el umbral se reducen, por lo que cambian las distribuciones de dirección y magnitud. Las diferencias en el volumen de datos de los clientes y en la dificultad de las tareas pueden producir distintas proporciones de recorte. Las figuras solo muestran la norma de entrada y la norma tras el recorte min(r,C), junto con el resultado ponderado de dos clientes construidos; no representan la calidad de un entrenamiento real. La elección de C debe analizarse conjuntamente con la privacidad, la optimización y los efectos sobre los grupos.[2] Deep Learning with Differential Privacy[1] Communication-Efficient Learning of Deep Networks from
4. La privacidad diferencial exige definir la unidad de protección
La privacidad diferencial compara las probabilidades de salida en conjuntos de datos adyacentes. Proteger un registro, un usuario o un cliente completo impone requisitos distintos sobre la relación de adyacencia y la sensibilidad; el multiplicador de ruido no es, por sí mismo, ε. El muestreo, el número de rondas, el recorte, la distribución del ruido y el método de contabilidad determinan conjuntamente el presupuesto, y las publicaciones repetidas también acumulan costes de privacidad por composición. La privacidad diferencial central y la local tienen límites de confianza distintos; no basta con escribir «se añadió ruido, por lo tanto la privacidad está garantizada».[2] Deep Learning with Differential Privacy
5. Las desconexiones y la participación no IID son problemas de sistemas y de estadística
Excluir los dispositivos más lentos o inestables puede acelerar las rondas, pero modifica la cobertura de los datos. La agregación segura debe recuperar correctamente el agregado permitido incluso cuando hay desconexiones, mientras que la contabilidad de privacidad depende del mecanismo real de muestreo. Deben registrarse, en cada ronda, los números de clientes invitados, participantes, que completan la ronda e incluidos en la agregación, y examinar el sesgo mediante metadatos lícitos y reducidos al mínimo necesario. La latencia de cola, el volumen de comunicación, el consumo energético y la calidad del modelo deben comunicarse conjuntamente; el número de rondas no debe sustituir al coste.[1] Communication-Efficient Learning of Deep Networks from [3] Practical Secure Aggregation for Federated Learning on
6. Tres compromisos requieren tres conjuntos de evidencia
La corrección de la optimización se comprueba mediante una referencia centralizada y estudios de ablación no IID; la agregación segura, mediante pruebas de amenazas al protocolo y de desconexión; y la privacidad diferencial, mediante la especificación explícita de la adyacencia y del mecanismo, y el recálculo de la contabilidad. Superar cualquiera de estos conjuntos de pruebas no valida automáticamente los demás. Este artículo solo presenta mecanismos públicos y cálculos de juguete; no ha desplegado un sistema federado, tratado datos privados de clientes ni afirmado garantía alguna para un valor concreto de ε.[1] Communication-Efficient Learning of Deep Networks from [2] Deep Learning with Differential Privacy[3] Practical Secure Aggregation for Federated Learning on
Ecuaciones fundamentales y derivaciones
(1) Ilustración de la ponderación por número de muestras; el conjunto real de participantes y el número de pasos locales afectan al objetivo de optimización.
LaTeX
w_{t+1}=\sum_{k\in S_t}\frac{n_k}{\sum_{j\in S_t}n_j}w_{t+1}^{(k)}(2) Cuando g es cero, la salida se define como cero. El recorte limita la norma y también puede modificar la dirección de optimización y los efectos sobre los grupos.
LaTeX
\operatorname{clip}_C(g)=g\min\{1,C/\|g\|_2\}(3) Deben especificarse la relación de adyacencia entre D y D′ y el mecanismo completo; este artículo no calcula un presupuesto de privacidad real.
LaTeX
P(M(D)\in A)\le e^\epsilon P(M(D^{\prime})\in A)+\deltaFlujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Las actualizaciones de dos clientes son +1 y −1. Los pesos por muestras 0.9 y 0.1 dan como resultado 0.8, mientras que asignar el mismo peso a cada cliente da 0. El recorte solo limita la norma de las contribuciones; la privacidad diferencial requiere además ruido, muestreo y una contabilidad completa.
Comparación de métodos
| Método o evaluación | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Aprendizaje federado | Especificar las actualizaciones locales y los pesos de agregación | Mantener los datos localmente no significa que las actualizaciones no filtren información |
| Agregación segura | Enumerar las condiciones de colusión, umbral y desconexión | Ocultar las actualizaciones individuales no garantiza la privacidad de la salida global |
| Privacidad diferencial | Definir la unidad, la adyacencia y la contabilidad | El multiplicador de ruido no es ε |
| Costes del sistema | Medir el sesgo de participación, la comunicación y la latencia de cola | El número de rondas no representa el coste total del entrenamiento |
Plan de verificación y experimentación
- Definir la población participante, la unidad de privacidad y los límites de las amenazas, y confirmar la autorización para utilizar los datos.
- Fijar los pesos de agregación, el número de pasos locales y la partición no IID, y contrastar con la referencia centralizada.
- Registrar el umbral de recorte y las tasas de recorte por estratos, y examinar la calidad y los efectos sobre los grupos.
- Si se utiliza privacidad diferencial (DP), divulgar el muestreo, el ruido, el número de rondas y la contabilidad, y recalcular de forma independiente.
- Probar las desconexiones, los supuestos de colusión y la corrección de la agregación dentro del ámbito del protocolo.
- Comunicar conjuntamente la calidad del modelo, el sesgo de participación, la comunicación y el presupuesto de privacidad, sin sustituir un tipo de evidencia por otro.
Ámbito de aplicación y limitaciones
- Los gradientes de juguete no contienen datos reales de clientes.
- No se calculó ningún presupuesto real de ε.
- La agregación segura y la DP ofrecen protecciones diferentes.
- El sesgo de participación puede afectar a la optimización y a la contabilidad.
Correspondencia entre fuentes primarias y afirmaciones
- Communication-Efficient Learning of Deep Networks from Decentralized Data, , , , · 2016-02-17Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Deep Learning with Differential Privacy, , , , , , · 2016-07-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Practical Secure Aggregation for Federated Learning on User-Held Data, , , , , , , , · 2016-11-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag coincide. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de las ilustraciones científicas; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versión e historial de correcciones · /guides/federated-privacy/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770