
Resumen
Las redes neuronales de grafos propagan información mediante la agregación de vecindarios, pero la capacidad discriminativa del agregador, la mezcla producida por la propagación repetida y el procedimiento de partición del grafo determinan conjuntamente los resultados. Este artículo compara GCN, GIN y las ideas de muestreo de vecindarios, distingue el sobresuavizado de la sobrecompresión y calcula los cambios de varianza tras promediar repetidamente en un grafo camino de seis nodos. La figura adjunta no incluye parámetros entrenados ni representa la exactitud en tareas con grafos reales.[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
Traducción del resumen original en inglés
Las redes de grafos basadas en paso de mensajes se analizan mediante la agregación normalizada, el comportamiento ante permutaciones y la capacidad de distinguir multiconjuntos. Un cálculo sobre un camino de seis nodos ilustra el suavizado para un operador de propagación declarado. No constituye un teorema universal sobre el sobresuavizado ni una evaluación comparativa de modelos. Una evaluación creíble requiere particiones por grafos y temporales, la procedencia de las características y reglas de acceso inductivo.
1. La agregación de vecindarios debe respetar la renumeración de nodos
La numeración de los nodos, por lo general, no debería alterar el significado de un grafo; por tanto, las representaciones de los nodos deben transformarse de manera correspondiente al renumerarlos, mientras que las salidas a nivel de grafo deben permanecer invariantes. La propagación mediante una matriz de adyacencia normalizada y los parámetros compartidos pueden satisfacer este requisito estructural, pero los identificadores o la información sobre la partición incluidos en las características aún pueden introducir fugas de información. Los autobucles y la normalización por grado de GCN modifican la escala de propagación. Debe registrarse si el grafo es dirigido o ponderado, junto con las reglas de autobucles; no basta con describir la implementación como «se utilizó GCN».[1] Semi-Supervised Classification with Graph Convolutional
2. Es crucial que el agregador pueda distinguir multiconjuntos
La media, la suma y el máximo pueden producir resultados idénticos para vecindarios distintos; por ejemplo, la agregación por media confunde multiconjuntos diferentes con la misma media. GIN investigó la relación entre las redes de paso de mensajes y la capacidad de distinguir grafos. Sus conclusiones dependen de las clases de funciones y de los supuestos, y no deben interpretarse como una garantía de que cualquier GIN entrenada pueda distinguir todos los grafos. También debe separarse la indistinguibilidad estructural del fracaso del aprendizaje durante la optimización: aumentar el número de épocas de entrenamiento no puede reparar la pérdida de información inherente a un agregador fijo concreto.[2] How Powerful are Graph Neural Networks?
3. La mezcla repetida puede hacer que las representaciones converjan
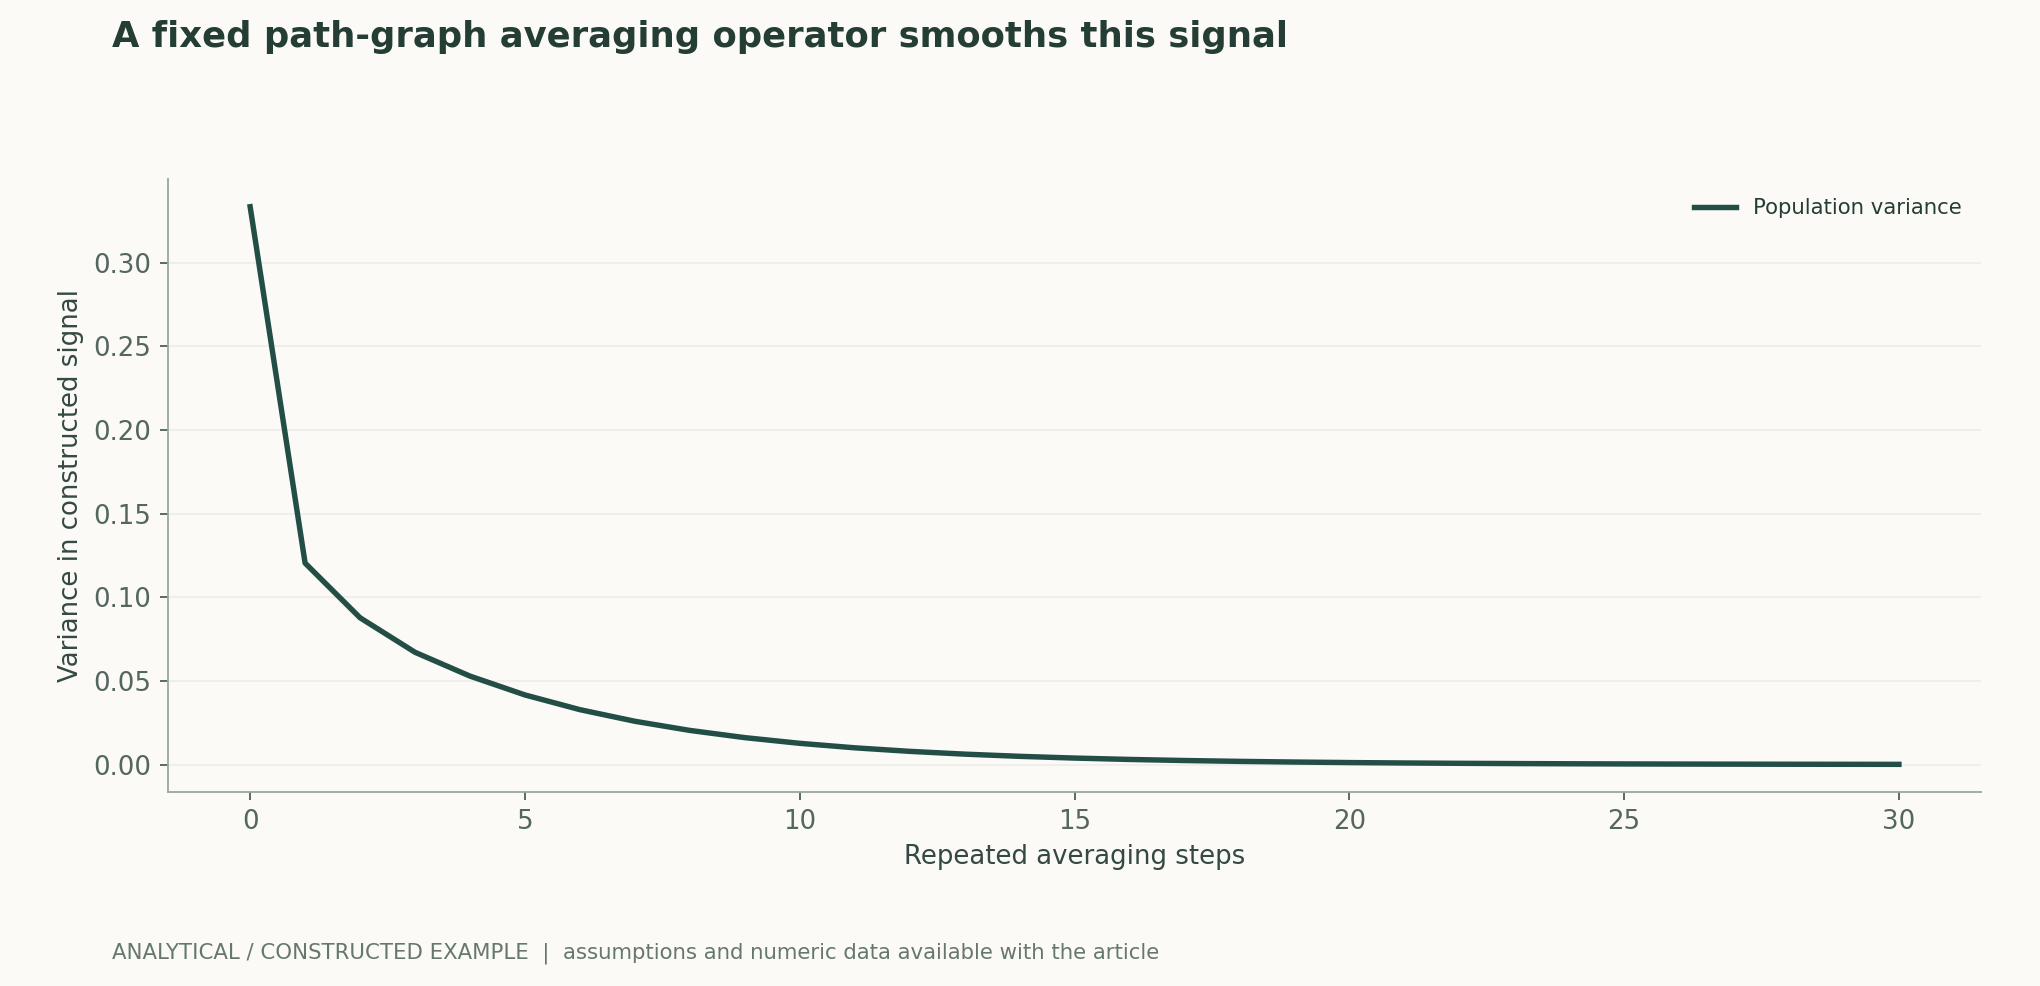
Bajo una propagación lineal fija, el promedio del vecindario mezcla gradualmente la información de los nodos; su comportamiento a largo plazo puede analizarse bajo condiciones específicas de conectividad y espectrales. Las redes reales incluyen no linealidades, conexiones residuales, normalización y pesos entrenados, por lo que una curva de varianza de un promedio simple no puede tratarse como un teorema para todas las GNN. Este artículo aplica normalización por filas a un camino de seis nodos tras añadir autobucles e itera directamente un vector de entrada fijo para mostrar la convergencia bajo este operador; no se midió la calidad de clasificación.[1] Semi-Supervised Classification with Graph Convolutional
4. El sobresuavizado y la sobrecompresión son cuellos de botella distintos
La convergencia de las representaciones pone el acento en la dificultad de distinguir nodos diferentes; la sobrecompresión pone el acento en la necesidad de comprimir grandes cantidades de información distante a través de una anchura limitada o de pocas aristas. Una tarea sobre grafos puede requerir únicamente información local o relaciones de largo alcance a través del grafo. Aumentar el número de capas amplía el campo receptivo y, al mismo tiempo, modifica la optimización y la mezcla de información. Deben diseñarse pruebas que separen los requisitos locales de los de largo alcance y realizar estudios de ablación independientes de la estructura, la anchura, las conexiones residuales y el muestreo; observar un rendimiento deficiente a mayor profundidad no basta para atribuirlo a una única causa.[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
5. La información accesible difiere entre la evaluación inductiva y la transductiva
Un entorno transductivo puede permitir que durante el entrenamiento se observe la estructura del grafo de los nodos de prueba no etiquetados, mientras que un entorno inductivo exige generalizar a nodos o grafos nuevos. GraphSAGE investigó representaciones inductivas mediante muestreo y agregación, pero la implementación debe especificar qué aristas y características son accesibles durante el entrenamiento. Si se incorporan al entrenamiento aristas de momentos posteriores o características derivadas de las etiquetas objetivo, las fugas de información pueden inflar las puntuaciones. Una partición aleatoria de nodos no representa automáticamente la generalización a grafos nuevos, relaciones futuras o instituciones nuevas.[3] Inductive Representation Learning on Large Graphs
6. Los experimentos con grafos requieren verificación tanto estructural como de sistemas
Deben conservarse la versión del grafo, la eliminación de duplicados, los autobucles, las direcciones de las aristas, la procedencia de las características y las particiones, y separar las muestras relacionadas según la familia de grafos o el tiempo. Deben presentarse resultados con varias semillas aleatorias, resultados estratificados por clase y mejoras frente a modelos de referencia sencillos basados en características. El muestreo en grafos grandes también requiere medir la cobertura, la comunicación y la memoria, y distinguir las aproximaciones por muestreo de los resultados con vecindarios completos. Este artículo solo calcula un operador de propagación; no afirma haber entrenado un nuevo modelo de grafos ni haber obtenido resultados en pruebas de referencia.[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
Ecuaciones fundamentales y derivaciones
(1) Ilustración de la normalización simétrica de tipo GCN; las definiciones de dirección, pesos, autobucles y grados deben coincidir con la implementación.
LaTeX
H^{\prime}=\sigma(\tilde D^{-1/2}\tilde A\tilde D^{-1/2}HW),\quad\tilde A=A+I(2) Agregación por suma de tipo GIN; el análisis de la capacidad discriminativa está sujeto a condiciones sobre la clase de funciones y no constituye una garantía universal para el entrenamiento real.
LaTeX
h_v^{\prime}=\operatorname{MLP}\left((1+\epsilon)h_v+\sum_{u\in N(v)}h_u\right)(3) La figura de este artículo utiliza un camino de seis nodos y este operador estocástico por filas, que difiere de la normalización simétrica anterior; se explicita esta distinción para evitar confusiones.
LaTeX
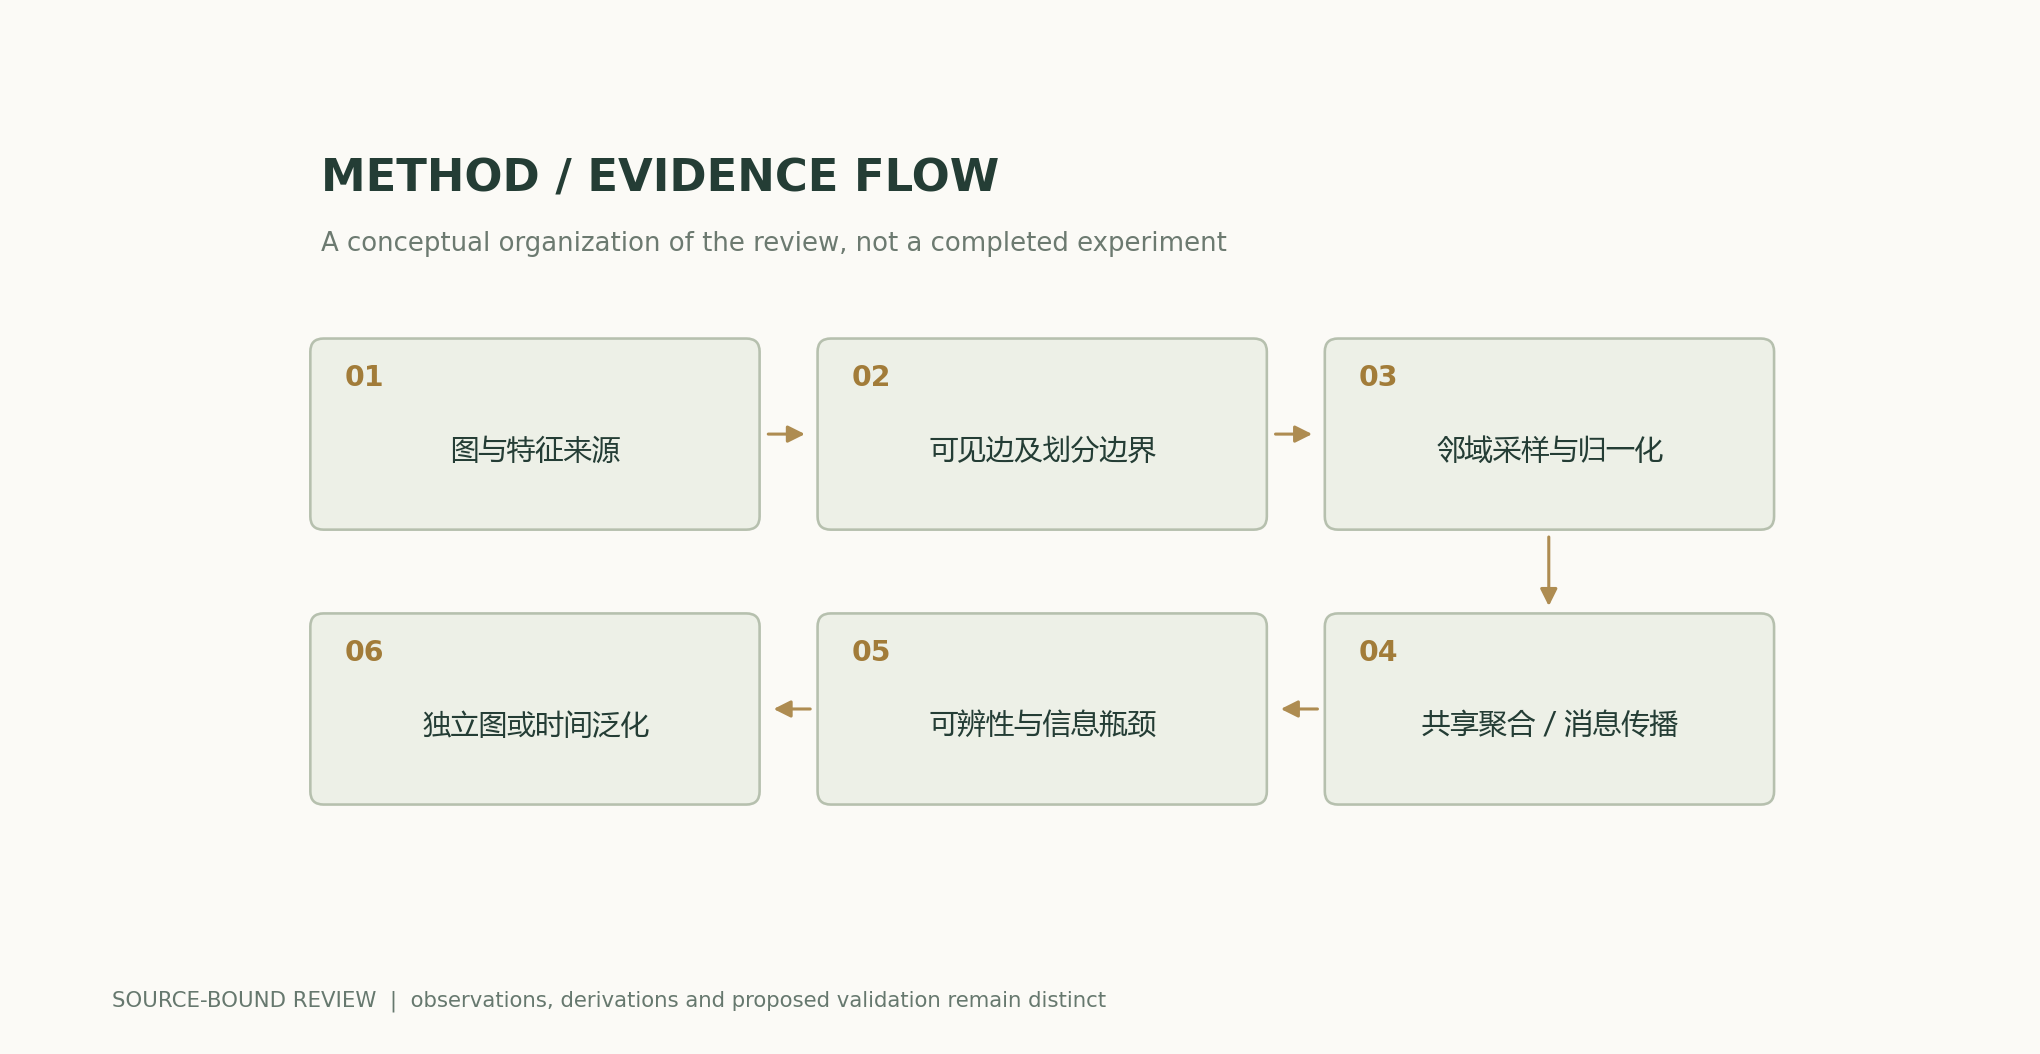
x^{(k)}=P^kx^{(0)},\quad P=D^{-1}(A+I)Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
La varianza poblacional inicial es 0.333333 y, tras 10 pasos de propagación con este operador, es aproximadamente 0.012679. Las no linealidades, las conexiones residuales y los pesos entrenados modifican el comportamiento; no puede inferirse de ello la calidad real de clasificación.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Propagación normalizada | Registrar las reglas de dirección, autobucles y grados | Las arquitecturas con el mismo nombre pueden utilizar operadores distintos |
| Media y suma | Diseñar comparaciones controladas de la capacidad de distinguir multiconjuntos | Un mayor entrenamiento no resuelve la indistinguibilidad estructural |
| Propagación profunda | Medir por separado la convergencia y los requisitos de información de largo alcance | No deben confundirse el sobresuavizado y la sobrecompresión |
| Partición de grafos | Especificar el acceso transductivo o inductivo y la visibilidad temporal | Las particiones aleatorias de nodos pueden introducir fugas de información |
Plan de verificación y experimentación
- Fijar las versiones del grafo, la procedencia de las características, las direcciones de las aristas, los autobucles y la eliminación de duplicados.
- Especificar los límites de acceso transductivo o inductivo y dividir según el tiempo o la familia de grafos.
- Verificar las salidas de agregación mediante la renumeración de nodos y cálculos manuales sobre grafos pequeños.
- Comparar modelos de referencia sencillos basados en características, distintos agregadores, profundidades y conexiones residuales para aislar los factores estructurales.
- Utilizar tareas locales y de largo alcance y varias semillas aleatorias; presentar la calidad estratificada y los grafos en los que falla el método.
- En grafos grandes, medir conjuntamente la cobertura del muestreo, el uso máximo de memoria y el tiempo, conservando una referencia con vecindarios completos.
Ámbito de aplicación y limitaciones
- La propagación sobre el grafo camino no tiene pesos entrenados.
- La disminución de la varianza no es un teorema para todas las GNN.
- Una cota superior de la expresividad no garantiza el éxito de la optimización.
- Las puntuaciones transductivas no pueden extrapolarse automáticamente a tareas inductivas.
Correspondencia entre fuentes primarias y afirmaciones
- Semi-Supervised Classification with Graph Convolutional Networks, · 2016-09-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- How Powerful are Graph Neural Networks?, , , · 2018-10-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Inductive Representation Learning on Large Graphs, , · 2017-06-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo en JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la literatura primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag coincide. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/graph-neural-networks/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770