
要旨
グラフニューラルネットワークは近傍集約を通じて情報を伝播するが、その結果は集約器の識別能力、反復伝播による混合、グラフの分割方法によって共同で決まる。本稿はGCN、GIN、近傍サンプリングの考え方を比較し、過平滑化と過圧縮を区別するとともに、六ノードのパスグラフを用いて反復平均化後の分散変化を計算する。掲載図には学習済みパラメータを用いておらず、実際のグラフタスクの正解率を示すものではない。[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
英語原文要旨の日本語訳
メッセージパッシング型グラフネットワークを、正規化された集約、置換に対する挙動、多重集合の識別能力の観点から分析する。六ノードのパスにおける計算は、明示された一つの伝播作用素による平滑化を例示する。これは過平滑化に関する普遍的な定理でも、モデルのベンチマークでもない。信頼できる評価には、グラフ単位の分割と時間に基づく分割、特徴量の由来、帰納的設定におけるアクセス規則が必要である。
1. 近傍集約はノードの番号変更に整合すべきである
ノードの番号は通常、グラフの意味を変えるべきではない。したがって、ノード表現は番号変更に応じて変換され、グラフ単位の出力は不変であるべきである。正規化隣接行列による伝播とパラメータの共有はこの構造的要件を満たしうるが、特徴量に含まれるIDや分割情報は依然として情報漏洩を引き起こす可能性がある。GCNにおける自己ループと次数正規化は伝播の尺度を変化させるため、有向か否か、重み付きか否か、自己ループの規則を記録すべきであり、「GCNを使用した」という記述だけで実装を説明することはできない。[1] Semi-Supervised Classification with Graph Convolutional
2. 集約器が多重集合を識別できるかが重要である
平均、和、最大値は、異なる近傍に対して同じ結果を生むことがある。例えば、平均集約は、平均が等しい異なる多重集合を区別できない。GINはメッセージパッシングネットワークとグラフの識別能力との関係を研究したが、その結論は関数クラスと仮定に依存しており、任意の学習済みGINがすべてのグラフを識別できると解釈してはならない。また、構造的に識別できないことと、最適化で学習できなかったことは区別すべきである。学習エポック数を増やしても、特定の固定された集約器に内在する情報損失は修復できない。[2] How Powerful are Graph Neural Networks?
3. 混合の反復により表現が同質化する可能性がある
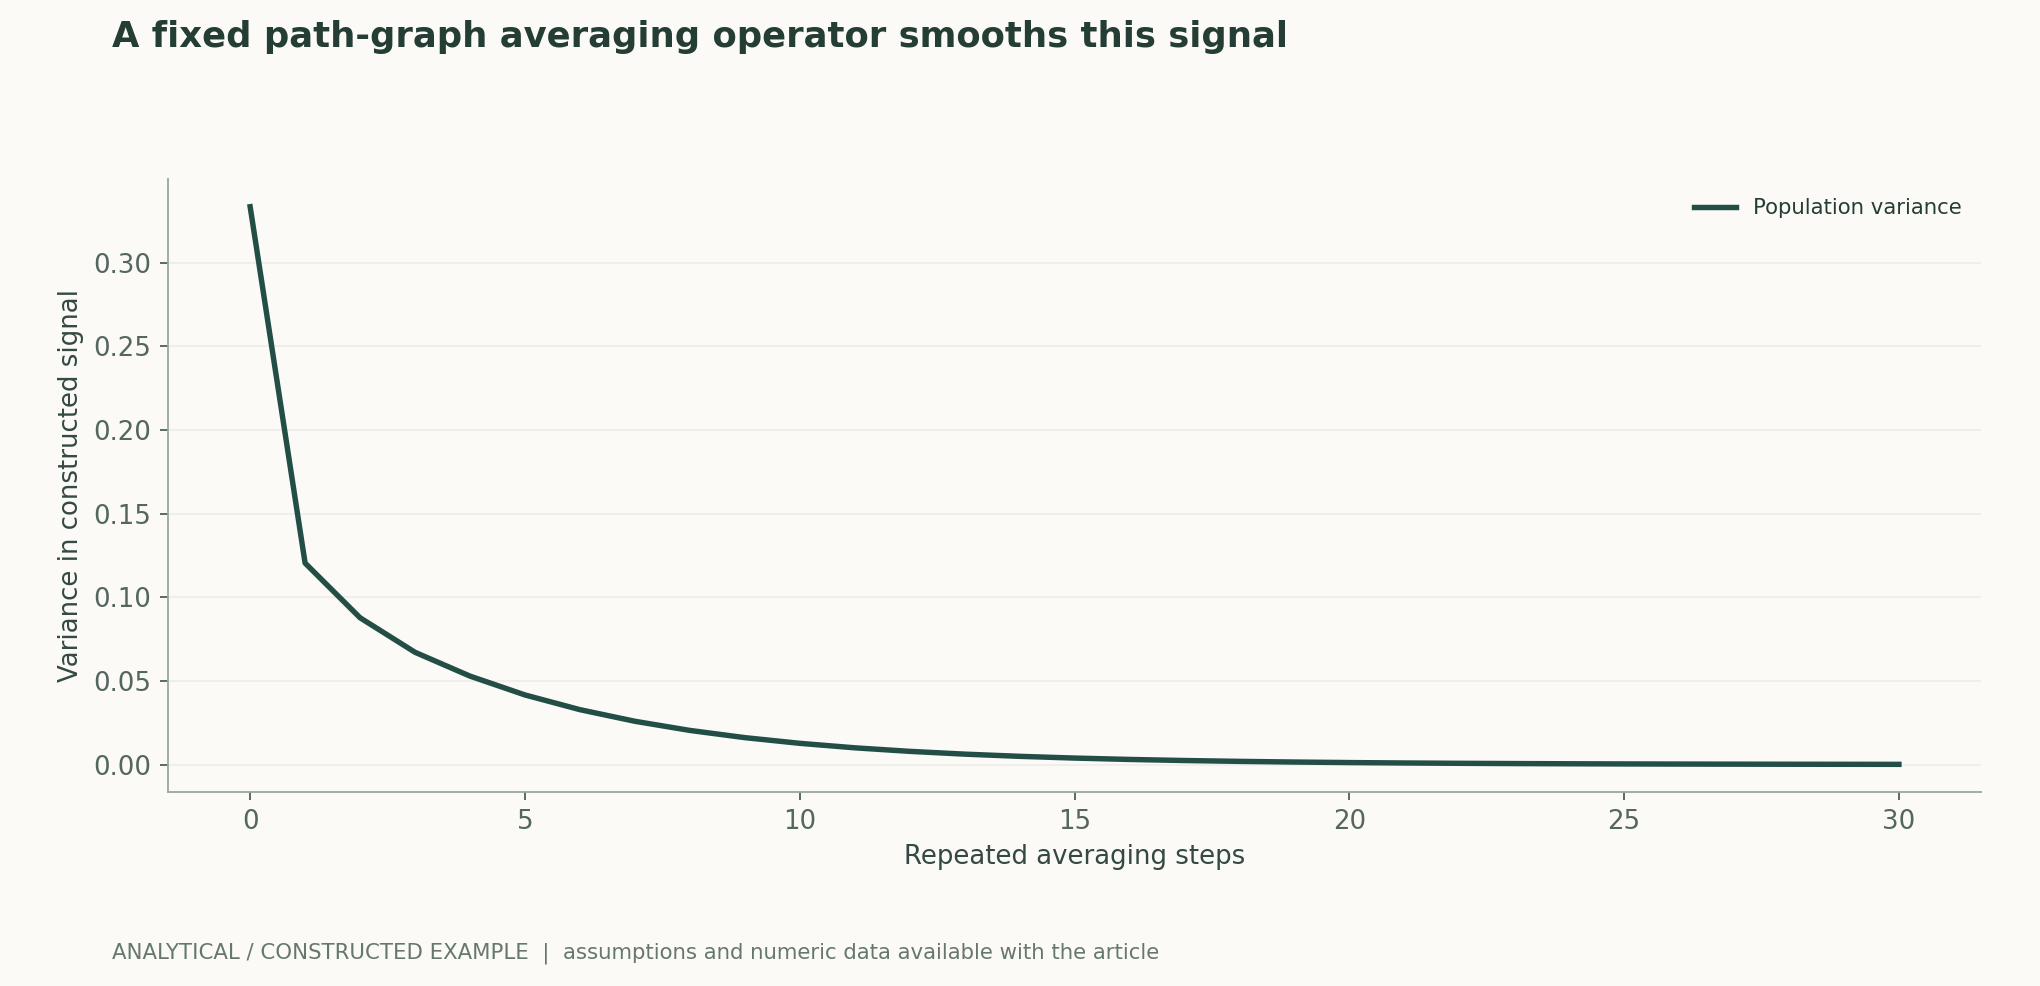
固定された線形伝播の下では、近傍平均化はノード情報を徐々に混合する。特定の連結性およびスペクトルに関する条件の下で、その長期的挙動を解析できる。実際のネットワークは非線形性、残差接続、正規化、学習済み重みを含むため、単純な平均化の分散曲線をすべてのGNNに関する定理とみなすことはできない。本稿では六ノードのパスに自己ループを追加した後、行正規化を適用し、固定された入力ベクトルに対して直接反復計算を行うことで、この作用素の下での同質化を示す。分類性能は測定していない。[1] Semi-Supervised Classification with Graph Convolutional
4. 過平滑化と過圧縮は異なるボトルネックである
表現の同質化は異なるノードを識別しにくくなる点に着目するのに対し、過圧縮は大量の遠方の情報が限られた幅や少数のエッジを通して圧縮されなければならない点に着目する。グラフタスクには局所情報だけで十分なものもあれば、グラフ全体にわたる長距離の関係を必要とするものもある。層数を増やすと受容野が拡大する一方で、最適化と情報混合も変化する。局所的要件と長距離の要件を分離できるテストを構築し、構造、幅、残差接続、サンプリングについてそれぞれアブレーションを行うべきであり、深いネットワークの性能が悪いという観察だけで単一の原因に帰してはならない。[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
5. 帰納的評価とトランスダクティブ評価では利用可能な情報が異なる
トランスダクティブな設定では、学習時にラベルのないテストノードのグラフ構造を参照できる場合があるのに対し、帰納的な設定では新しいノードや新しいグラフへの汎化が必要となる。GraphSAGEはサンプリングと集約による帰納的な表現方法を研究したが、実装では学習時にアクセスできるエッジと特徴量を明示しなければならない。後の時点のエッジや目的ラベルから派生した特徴量が学習に入り込むと、情報漏洩によってスコアがかさ上げされる可能性がある。ランダムなノード分割が、新しいグラフ、将来の関係、新しい機関への汎化を自動的に表すわけではない。[3] Inductive Representation Learning on Large Graphs
6. グラフ実験には構造とシステムの両面からの検証が必要である
グラフのバージョン、重複除去、自己ループ、エッジの方向、特徴量の由来、分割を保存し、関連するサンプルをグラフ族または時間に基づいて分離する。複数の乱数シードによる結果、クラス別の結果、単純な特徴量ベースのベースラインに対する改善を報告する。大規模グラフのサンプリングでは、カバレッジ、通信、メモリも測定し、サンプリング近似と全近傍を用いた結果を区別する必要がある。本稿は伝播作用素の計算のみを行い、新しいグラフモデルの学習やベンチマーク成績の達成を主張しない。[1] Semi-Supervised Classification with Graph Convolutional[2] How Powerful are Graph Neural Networks?[3] Inductive Representation Learning on Large Graphs
主要な数式と導出
(1) GCN型の対称正規化の模式例。方向、重み、自己ループ、次数の定義は実装と一致させるべきである。
LaTeX
H^{\prime}=\sigma(\tilde D^{-1/2}\tilde A\tilde D^{-1/2}HW),\quad\tilde A=A+I(2) GIN型の和による集約。識別能力の解析には関数クラスに関する条件があり、実際の学習に対する万能の保証ではない。
LaTeX
h_v^{\prime}=\operatorname{MLP}\left((1+\epsilon)h_v+\sum_{u\in N(v)}h_u\right)(3) 本稿の図は六ノードのパスとこの行確率的作用素を用いており、上記の対称正規化とは異なる。混同を避けるため、この違いを明示する。
LaTeX
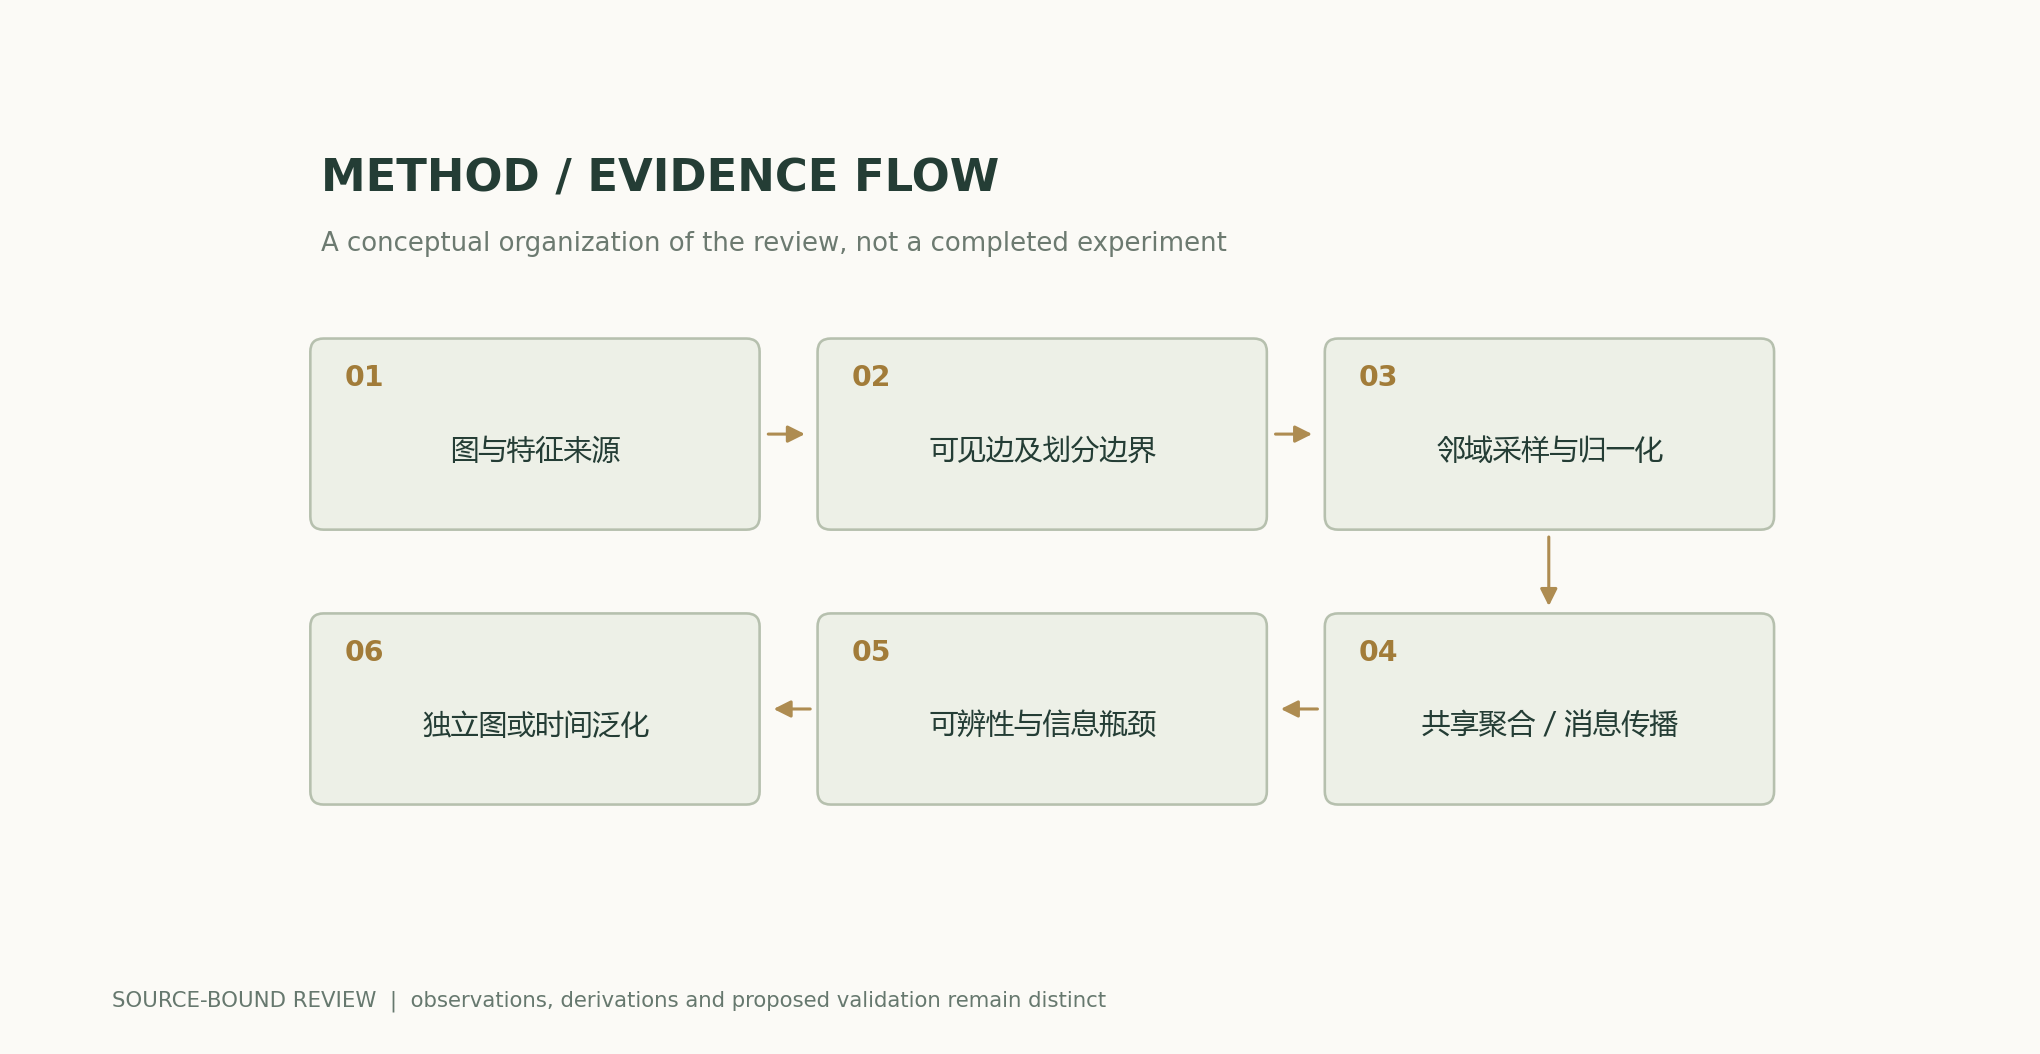
x^{(k)}=P^kx^{(0)},\quad P=D^{-1}(A+I)手法とエビデンスの流れ
解析図と数値例
再計算可能な例題
初期の母分散は0.333333であり、この作用素による10回の伝播後には約0.012679となる。非線形性、残差接続、学習済み重みは挙動を変化させるため、この結果から実際の分類性能を推論することはできない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 正規化された伝播 | 方向、自己ループ、次数の規則を記録する | 同じ名称のアーキテクチャでも異なる作用素を用いる場合がある |
| 平均と和 | 多重集合の識別能力に関する対照比較を構築する | 構造的な識別不能性は学習量を増やしても解消しない |
| 深い層にわたる伝播 | 同質化と長距離情報の必要性を別々に測定する | 過平滑化と過圧縮を混同してはならない |
| グラフの分割 | トランスダクティブ/帰納的なアクセスと時間的な参照可能範囲を明示する | ランダムなノード分割は情報漏洩を引き起こす可能性がある |
検証と実験の計画
- グラフ、特徴量の由来、エッジの方向、自己ループ、重複除去のバージョンを固定する。
- トランスダクティブまたは帰納的なアクセス境界を明示し、時間またはグラフ族に基づいて分割する。
- ノードの番号変更と小規模グラフでの手計算により集約出力を照合する。
- 単純な特徴量ベースのベースライン、異なる集約器、深さ、残差接続を比較し、構造的要因を分離する。
- 局所的タスクと長距離タスク、および複数の乱数シードを用い、層別の性能と手法が失敗したグラフを報告する。
- 大規模グラフでは、サンプリングのカバレッジ、ピークメモリ使用量、時間を併せて測定し、全近傍を用いた参照結果を保持する。
適用範囲と限界
- パスグラフの伝播には学習済み重みを用いていない。
- 分散の低下はすべてのGNNに関する定理ではない。
- 表現力の上界は最適化の成功を保証しない。
- トランスダクティブな成績を帰納的タスクへ自動的に外挿することはできない。
一次資料と主張の対応
- Semi-Supervised Classification with Graph Convolutional Networks, · 2016-09-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- How Powerful are Graph Neural Networks?, , , · 2018-10-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Inductive Representation Learning on Large Graphs, , · 2017-06-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、掲載した一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿の独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前のバージョンの内容を維持している。
概念的な表紙画像と科学的な図解は分けて扱う。科学図は公開された数式と明示的な仮定から計算し、原著論文の結果にはすべて帰属先を明記している。
著者・バージョン・訂正履歴 · /guides/graph-neural-networks/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770