
Resumen
La investigación sobre interpretabilidad intenta comprender los cálculos internos de los modelos, pero una visualización significativa no constituye automáticamente una descripción fiel de un mecanismo. Mediante una construcción que comprime tres características en un espacio bidimensional, este artículo explica la superposición no ortogonal y la interferencia mutua, y establece después una escala de evidencia que va de las observaciones correlacionales a las intervenciones controladas. Las figuras adjuntas no son circuitos extraídos de un modelo real; todos los nombres asignados a características internas requieren validación mediante el comportamiento externo y las intervenciones.[1] Toy Models of Superposition[2] Attention is not Explanation[3] Attention Is All You Need
Traducción del resumen original en inglés
La interpretación mecanicista requiere algo más que nombres plausibles para las características o visualizaciones de atención. Una construcción bidimensional de tres características demuestra la superposición no ortogonal. Distinguimos entre observación, ablación, parcheo y pruebas de suficiencia causal, y analizamos los artefactos de intervención. La geometría simplificada no es un circuito descubierto en un modelo entrenado.
1. Las características no tienen por qué corresponderse una a una con neuronas individuales
Toy Models of Superposition estudia cómo las redes utilizan direcciones no ortogonales para representar más características bajo condiciones como la capacidad limitada y la activación escasa de las características. Un espacio bidimensional puede albergar tres direcciones, pero no puede hacerlas ortogonales por pares, por lo que pueden interferir al activarse simultáneamente. Este hecho geométrico ayuda a explicar la polisemanticidad de las neuronas individuales, pero no demuestra que cualquier red real utilice la misma organización. Las direcciones de las características, los métodos de decodificación y la distribución de los datos deben comunicarse conjuntamente.[1] Toy Models of Superposition
2. Observar una señal correlacionada no equivale a identificar la causa computacional
Una activación puede correlacionarse con un concepto debido a un mecanismo genuino, a características compartidas de las entradas o a que el analista haya seleccionado muestras favorables. Que una sonda lineal pueda leer información tampoco demuestra que el modelo la utilice efectivamente en etapas posteriores. Deben establecerse un conjunto de prueba que no se haya utilizado para nombrar las características, contraejemplos y controles con conceptos similares, e informarse la precisión, la exhaustividad y las entradas para las que falla la explicación. Mostrar únicamente unos pocos ejemplos de activación máxima facilita confundir el sesgo de selección con una semántica estable.[1] Toy Models of Superposition[2] Attention is not Explanation
3. Los pesos de atención no constituyen una descomposición completa de las contribuciones
Las puntuaciones de atención determinan los pesos de mezcla, pero la salida también depende de los valores, las conexiones residuales, las capas posteriores y las no linealidades. Un peso mayor no necesariamente produce una contribución causal final mayor; distintos patrones de atención también pueden generar salidas similares. Attention is not Explanation aporta argumentos concretos y un contexto experimental sobre la fidelidad explicativa; por ello, debe evitarse denominar directamente a los mapas de calor las razones del modelo. Los mapas de calor pueden utilizarse para plantear hipótesis, que después siguen requiriendo pruebas mediante intervenciones.[2] Attention is not Explanation[3] Attention Is All You Need
4. La ablación y el parcheo también pueden salir de la distribución de los datos
Poner una activación a cero, sustituirla por la de otra entrada o desplazarla en una dirección puede crear estados que la red nunca encontró durante el entrenamiento. Un cambio de comportamiento indica que la intervención tiene un efecto, pero no necesariamente que la característica nombrada sea el único mecanismo. Deben compararse varias referencias de intervención, direcciones aleatorias de magnitud equiparada y comportamientos no objetivo para comprobar los efectos secundarios. La necesidad y la suficiencia son cuestiones distintas: el fracaso tras la eliminación y el éxito tras la adición solo responden, cada uno, a una parte de la hipótesis mecanicista.[1] Toy Models of Superposition[2] Attention is not Explanation
5. Las afirmaciones mecanicistas deben delimitarse por tarea y versión del modelo
Una dirección o un circuito descubierto en una tarea pequeña puede no mantenerse con otras instrucciones de entrada, cantidades de capas, versiones del modelo o lenguas. Deben publicarse el hash del modelo, la ubicación de la activación, la selección de datos y el código de intervención, y comprobarse la estabilidad en variantes independientes de la tarea. Aunque una explicación abarque los ejemplos habituales, deben seguir considerándose los residuos sin explicar y los mecanismos alternativos. La fluidez del texto explicativo no debe convertirse en el principal criterio de aceptación.[1] Toy Models of Superposition
6. Las explicaciones verificables requieren capacidad para predecir el comportamiento
Una hipótesis mecanicista útil debe poder predecir, antes de observar los resultados, cómo determinadas entradas controladas o intervenciones modificarán la salida. Deben prerregistrarse las métricas objetivo y no objetivo, compararse referencias sencillas y documentarse las predicciones fallidas. La matriz de Gram de las direcciones bidimensionales de este artículo solo puede demostrar las relaciones no ortogonales de esta construcción; no ha descubierto conceptos en un modelo de lenguaje real ni ha validado ninguna razón interna. La investigación de mecanismos reales requiere datos conductuales independientes e intervenciones reproducibles.[1] Toy Models of Superposition[2] Attention is not Explanation
Ecuaciones fundamentales y derivaciones
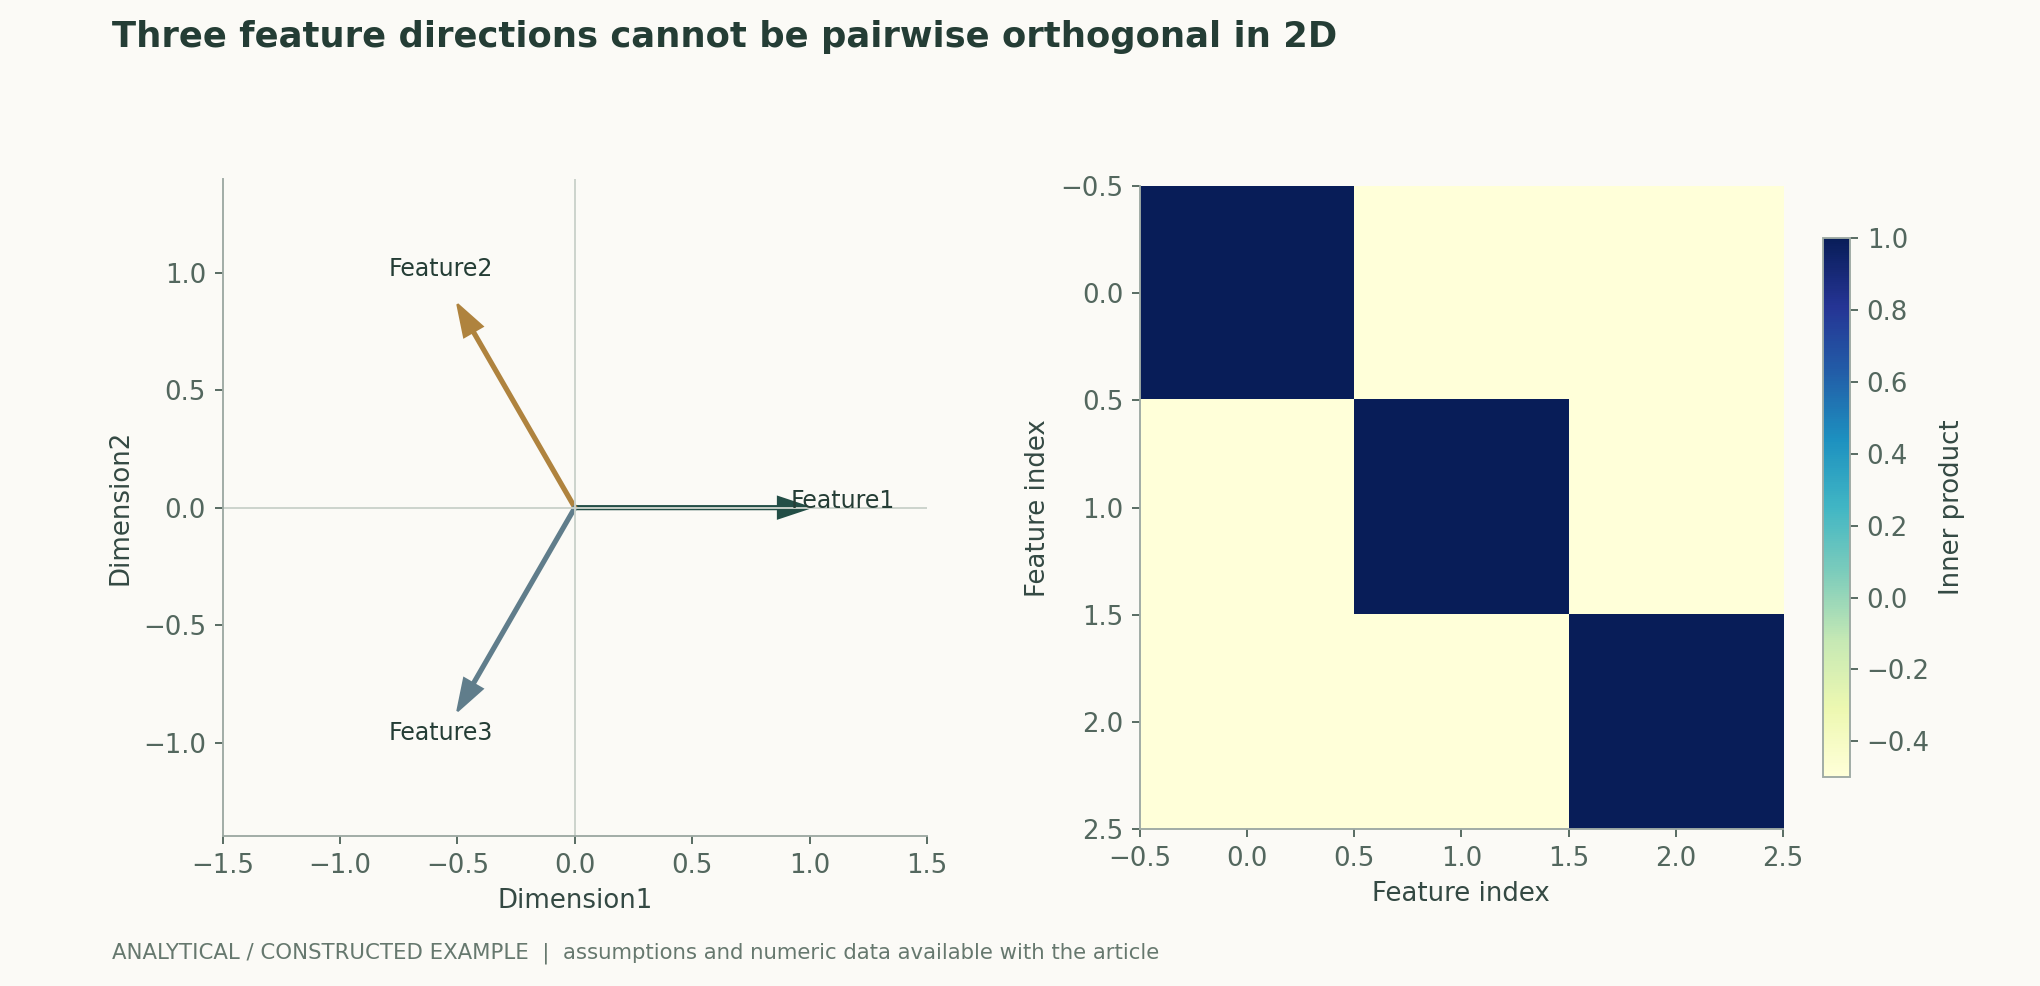
(1) Tres direcciones unitarias se sitúan en un plano bidimensional; son una construcción íntegramente artificial para ilustrar la geometría de la superposición.
LaTeX
v_j=(\cos(2\pi j/3),\sin(2\pi j/3)),\quad j=0,1,2(2) Las entradas fuera de la diagonal son distintas de cero, lo que indica que las lecturas lineales pueden interferir entre sí; no se trata de la matriz de correlación de ningún modelo real.
LaTeX
G_{ij}=v_i^\top v_j,\qquad G_{ij}=-1/2\ (i\ne j)(3) Al describir un efecto de intervención deben especificarse la regla de sustitución, la salida objetivo y los controles; un cambio distinto de cero no basta por sí solo para validar una denominación semántica.
LaTeX
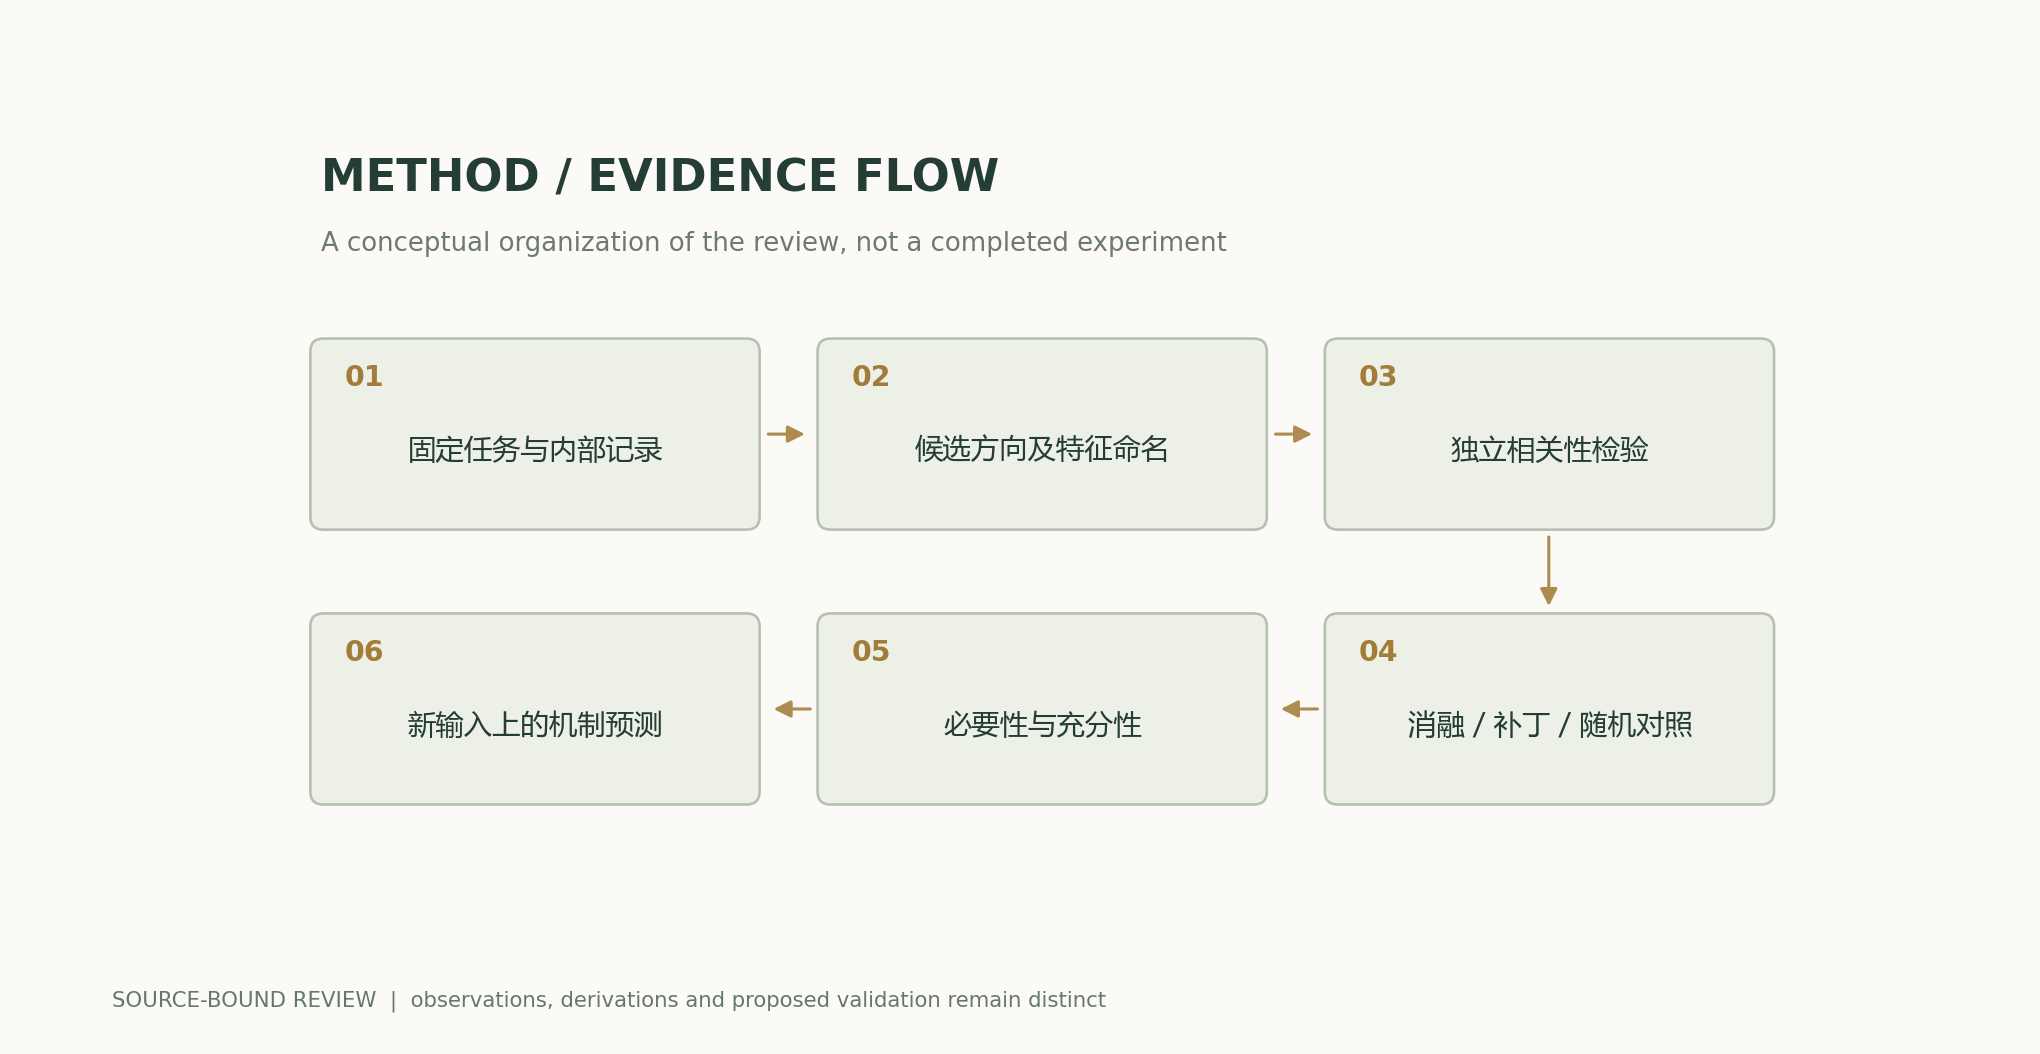
\Delta f=f(\operatorname{intervene}(h))-f(h)Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Los productos internos por pares de las tres direcciones son todos −0.5, lo que demuestra interferencia entre las lecturas en esta construcción. Determinar si un modelo real utiliza esta estructura y cuál es su semántica sigue requiriendo validación mediante entradas independientes, intervenciones y comportamiento.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Observación de activaciones | Comprobar correlaciones y contraejemplos con entradas independientes | Que la información pueda leerse no implica que el modelo la utilice |
| Mapas de atención | Analizarlos junto con los valores, las conexiones residuales y el procesamiento posterior | Los pesos no son las contribuciones finales |
| Ablación/parcheo | Múltiples referencias, direcciones aleatorias y controles de efectos secundarios | Las intervenciones fuera de distribución pueden inducir a error |
| Predicciones mecanicistas | Predecir de antemano los cambios de comportamiento y verificarlos | La fluidez explicativa no equivale a fidelidad |
Plan de verificación y experimentación
- Fijar el hash del modelo, la capa, la ubicación de la activación y la tarea, y dividir las entradas en conjuntos de descubrimiento y validación.
- Guardar las reglas de extracción y denominación de características, e incluir conceptos similares y contraejemplos.
- Examinar conjuntamente la correlación, la necesidad y la suficiencia, evitando realizar un único tipo de intervención.
- Utilizar direcciones aleatorias de magnitud equiparada y varias referencias de sustitución, y medir los efectos secundarios no objetivo.
- Repetir las pruebas con nuevas instrucciones de entrada, lenguas y variantes de la tarea, e informar la proporción de fallos de la explicación.
- Prerregistrar las predicciones mecanicistas y publicar el código, distinguiendo la geometría simplificada de la evidencia sobre circuitos reales.
Ámbito de aplicación y limitaciones
- La construcción bidimensional no es un circuito descubierto en un modelo.
- La lectura mediante sondas no demuestra el uso en etapas posteriores.
- Las intervenciones pueden producir estados fuera de distribución.
- Las conclusiones mecanicistas dependen del modelo y de la tarea.
Correspondencia entre fuentes primarias y afirmaciones
- Toy Models of Superposition, , , , , , , , , , , , , , , · 2022-09-21Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention is not Explanation, · 2019-02-26Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la literatura primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: las páginas ya leídas también se reutilizan cuando una solicitud HEAD reciente devuelve 200 y coincide el ETag. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de las ilustraciones científicas; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versión e historial de correcciones · /guides/mechanistic-interpretability/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770