
要旨
解釈可能性研究はモデル内部の計算の理解を目指すが、意味のある可視化がそのまま機構の忠実な説明になるわけではない。本稿では、三つの特徴を二次元空間に圧縮する構成を用いて、非直交な重ね合わせと相互干渉を説明し、相関の観測から統制された介入に至る証拠の階梯を示す。掲載図は実際のモデルから抽出した回路ではない。内部特徴に付した名称はすべて、外部に現れる挙動と介入による検証を必要とする。[1] Toy Models of Superposition[2] Attention is not Explanation[3] Attention Is All You Need
原文の英語要旨の日本語訳
機構的な解釈には、もっともらしい特徴名や注意の可視化以上のものが必要である。二次元の三特徴構成は、非直交な重ね合わせを示す。本稿では、観測、アブレーション、パッチング、因果的十分性の検証を区別し、介入に伴うアーティファクトを論じる。このトイモデルの幾何構造は、学習済みモデルで発見された回路ではない。
1. 特徴は個々のニューロンと一対一に対応するとは限らない
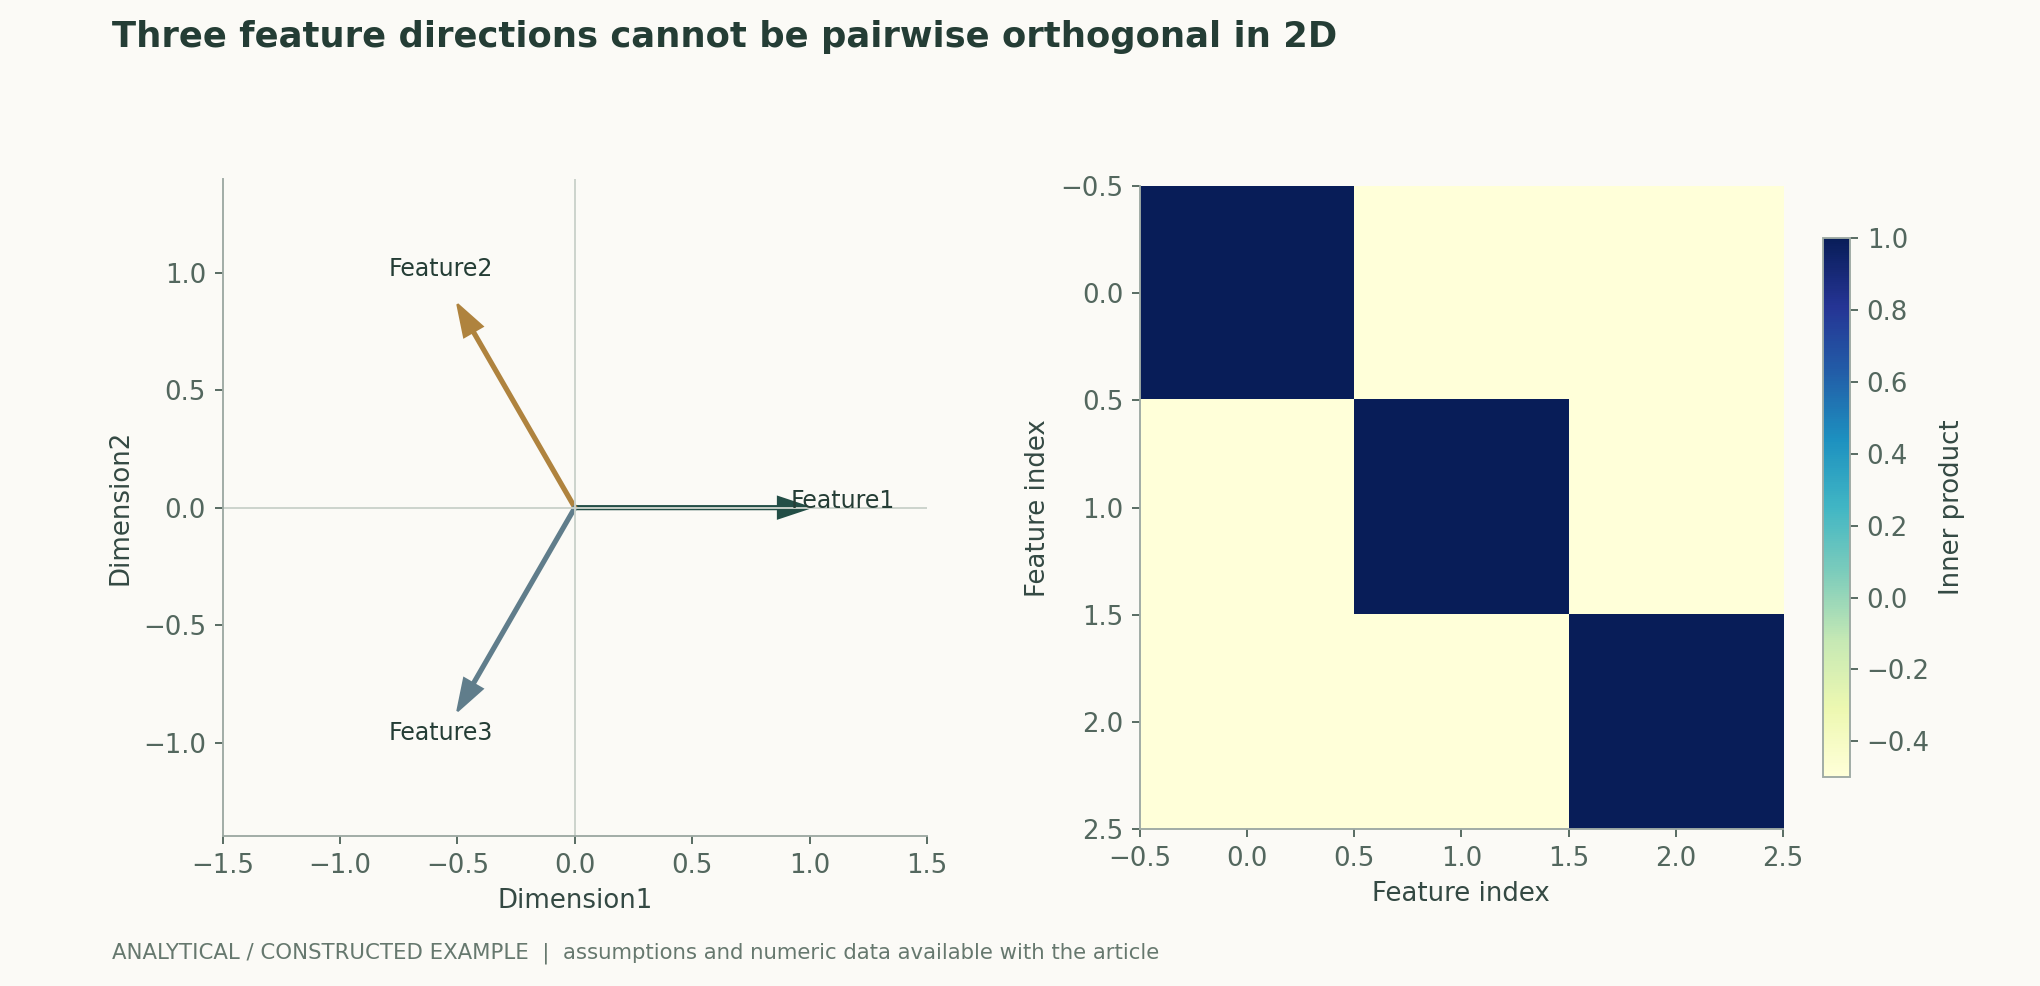
Toy Models of Superpositionは、容量の制約や特徴のスパース性などの条件の下で、ネットワークが非直交な方向を用いてより多くの特徴を表現する仕組みを研究している。二次元空間には三つの方向を配置できるが、それらを互いに直交させることはできないため、同時に活性化すると干渉する可能性がある。この幾何学的事実は、単一ニューロンの多義性を説明する助けとなるが、任意の実際のネットワークが同じ構成を採用していることを証明するものではない。特徴方向、復号方法、データ分布を併せて報告する必要がある。[1] Toy Models of Superposition
2. 相関する信号の観測は計算上の原因の特定を意味しない
活性化とある概念との相関は、真の機構、共通する入力特徴、あるいは分析者による都合のよいサンプルの選択によって生じる可能性がある。線形プローブが情報を読み出せることも、モデルの下流処理がその情報を実際に使用していることの証明にはならない。特徴の命名に用いていないテスト集合、反例、類似概念を用いた対照を設け、適合率、再現率、説明が失敗する入力を報告すべきである。活性化が最も強い少数の例だけを示すと、選択バイアスを安定した意味と取り違えやすい。[1] Toy Models of Superposition[2] Attention is not Explanation
3. 注意重みは寄与の完全な分解ではない
注意スコアは混合重みを決めるが、出力はvalue、残差接続、後続層、非線形性にも依存する。重みが大きいからといって最終的な因果的寄与が大きくなるとは限らず、異なる注意パターンから類似した出力が得られることもある。Attention is not Explanationは、説明の忠実性に関する具体的な議論と実験的文脈を提示しており、これを踏まえて、ヒートマップをそのままモデルの理由と呼ぶことは避けるべきである。ヒートマップは仮説の提案に利用できるが、その後も介入による検証が必要である。[2] Attention is not Explanation[3] Attention Is All You Need
4. アブレーションやパッチングもデータ分布から逸脱しうる
ある活性化をゼロにする、別の入力に由来する活性化に置き換える、ある方向に沿って移動させるといった操作は、ネットワークが学習時に一度も経験していない状態を生み出す可能性がある。挙動の変化は介入に効果があることを示すが、命名された特徴が唯一の機構であることを必ずしも意味しない。複数の介入ベースライン、大きさを揃えたランダム方向、非対象の挙動を比較し、副作用を調べるべきである。必要性と十分性は異なる問題であり、除去後の失敗と追加後の成功は、それぞれ機構仮説の一部にしか答えない。[1] Toy Models of Superposition[2] Attention is not Explanation
5. 機構に関する主張はタスクとモデルのバージョンを限定すべきである
小規模なタスクで発見された方向や回路は、別のプロンプト、層数、モデルのバージョン、言語でも維持されるとは限らない。モデルのハッシュ、活性化の位置、データの選択、介入コードを公開し、独立したタスクの変種で安定性を検証すべきである。説明が一般的な事例を網羅していても、説明できない残差や競合する機構を引き続き考慮する必要がある。説明文の流暢さを主要な受入基準にしてはならない。[1] Toy Models of Superposition
6. 検証可能な説明には挙動を予測する能力が必要である
有用な機構仮説は、結果を見る前に、特定の統制された入力や介入が出力をどのように変えるかを予測できるべきである。対象指標と非対象指標を事前登録し、単純なベースラインと比較し、失敗した予測を記録する必要がある。本稿の二次元方向のグラム行列が証明できるのは、この構成内の非直交関係だけであり、実際の言語モデルの概念を発見したわけでも、内部の理由を検証したわけでもない。実際の機構の研究には、独立した挙動データと再現可能な介入が必要である。[1] Toy Models of Superposition[2] Attention is not Explanation
主要な数式と導出
(1) 三つの単位方向が二次元平面上に配置されている。重ね合わせの幾何構造を示すために全面的に構成したものである。
LaTeX
v_j=(\cos(2\pi j/3),\sin(2\pi j/3)),\quad j=0,1,2(2) 非対角成分がゼロではないことは、線形読み出しが相互に干渉しうることを示す。実際のモデルの相関行列ではない。
LaTeX
G_{ij}=v_i^\top v_j,\qquad G_{ij}=-1/2\ (i\ne j)(3) 介入効果については、置換規則、対象出力、対照を明示しなければならない。ゼロでない変化だけでは意味的な命名の妥当性を証明するには不十分である。
LaTeX
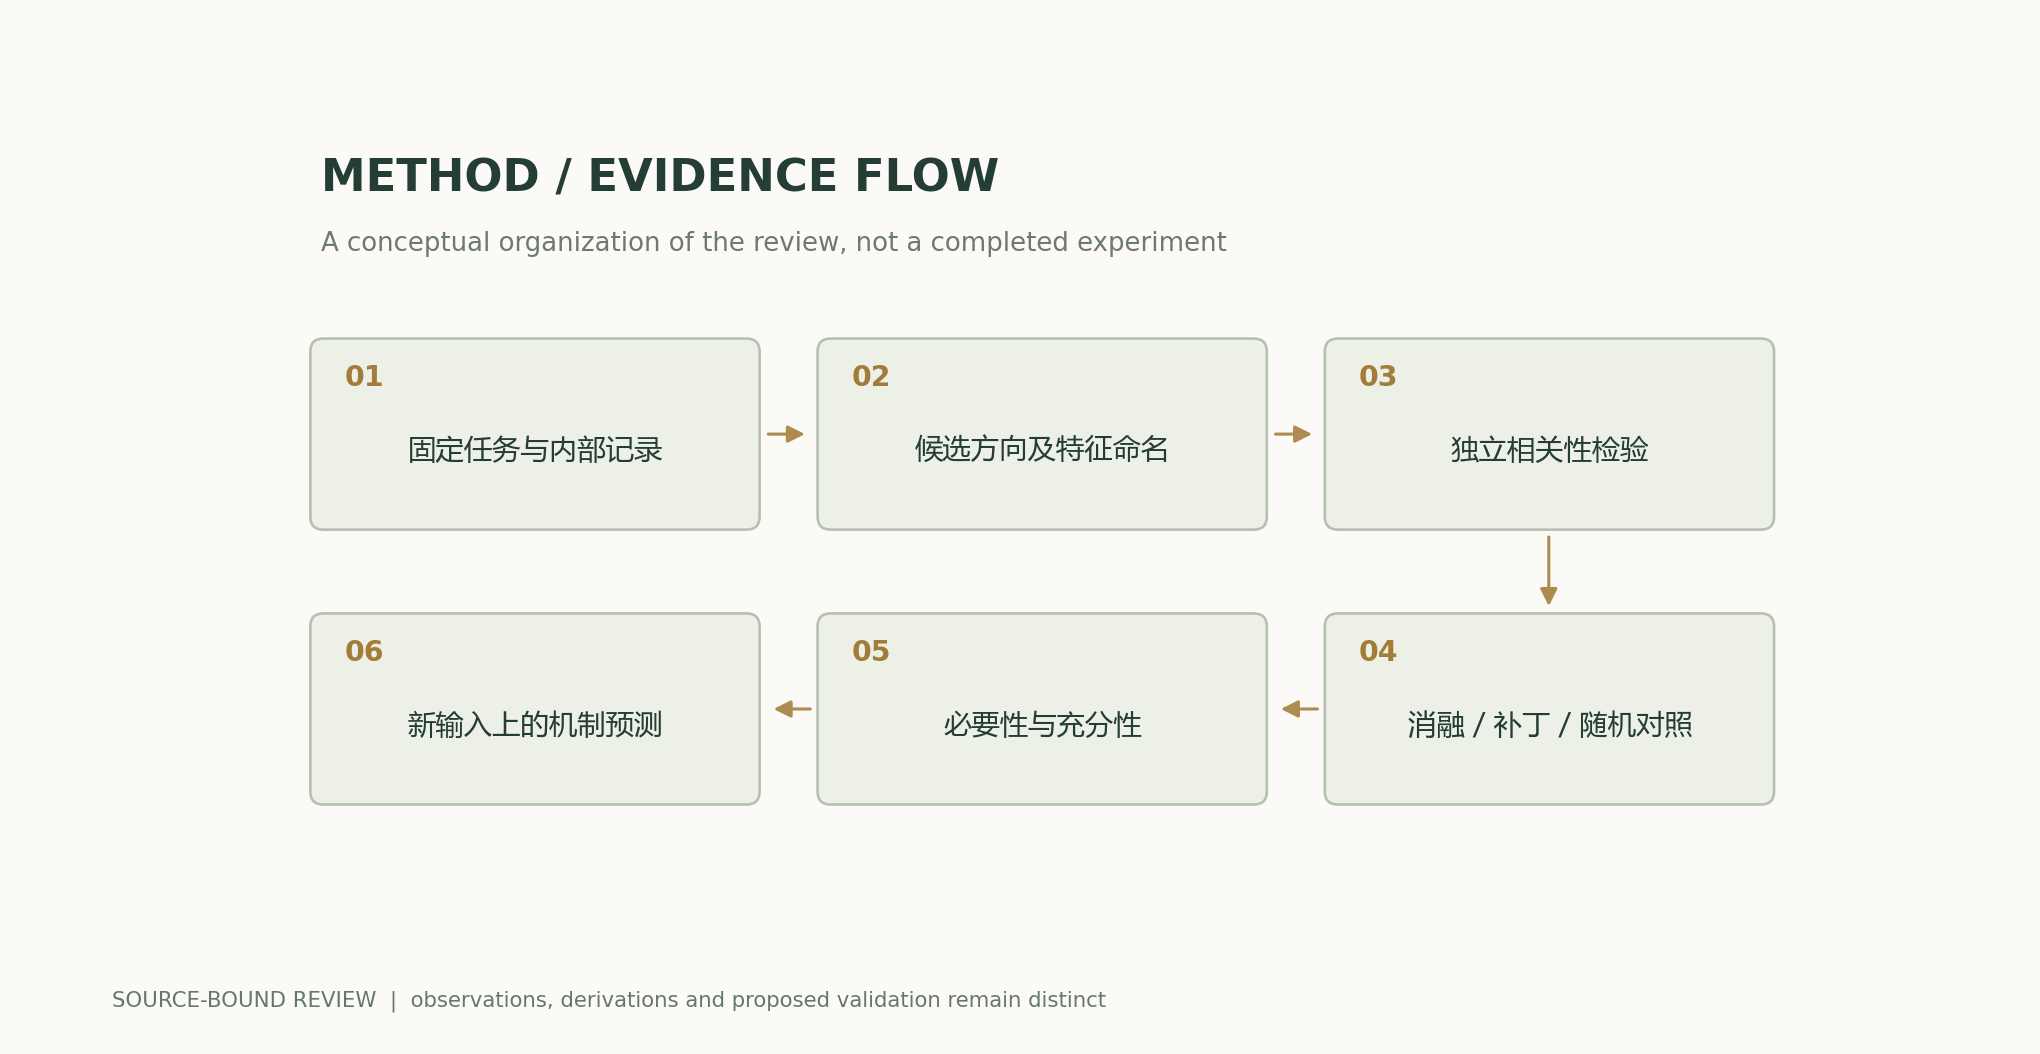
\Delta f=f(\operatorname{intervene}(h))-f(h)方法と証拠の流れ
解析図と数値例
再計算可能な例題
三つの方向の各対の内積はいずれも−0.5であり、この構成では読み出し間に干渉が存在することを示す。実際のモデルがこの構造を使用するか、またその意味は何かについては、独立した入力、介入、挙動による検証がなお必要である。
方法の比較
| 方法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 活性化の観測 | 独立した入力で相関と反例を検証する | 読み出せることはモデルによる使用を意味しない |
| 注意マップ | value、残差接続、下流処理と併せて分析する | 重みは最終的な寄与ではない |
| アブレーション/パッチング | 複数のベースライン、ランダム方向、副作用の統制 | 分布外への介入は誤解を招く可能性がある |
| 機構に基づく予測 | 挙動の変化を事前に予測し、検証する | 説明の流暢さは忠実性を意味しない |
検証と実験の計画
- モデルのハッシュ、層、活性化の位置、タスクを固定し、入力を発見用と検証用に分割する。
- 特徴抽出と命名の規則を保存し、類似概念と反例を加える。
- 相関、必要性、十分性を併せて調べ、一種類の介入だけに依存することを避ける。
- 大きさを揃えたランダム方向と複数の置換ベースラインを用い、非対象の副作用を測定する。
- 新たなプロンプト、言語、タスクの変種で再検証し、説明が失敗する割合を報告する。
- 機構に基づく予測を事前登録してコードを公開し、トイモデルの幾何構造と実際の回路の証拠を区別する。
適用範囲と限界
- 二次元の構成は、発見されたモデル回路ではない。
- プローブによる読み出しは下流での使用を証明しない。
- 介入は分布外の状態を生み出す可能性がある。
- 機構に関する結論はモデルとタスクに依存する。
一次資料と主張の対応
- Toy Models of Superposition, , , , , , , , , , , , , , , · 2022-09-21Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention is not Explanation, · 2019-02-26Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿について独立した査読や独自のモデル実験を実施した記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学図解は区別している。科学図は公開された数式と明示的な仮定から計算し、原論文の結果にはすべて帰属を明記している。
著者、バージョン、訂正履歴 · /guides/mechanistic-interpretability/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770