
要旨
画像・テキスト対照学習などの手法は、転移可能なクロスモーダル表現を構築できる。しかし、学習時のペア対応の成功は、位置、数量、関係、因果的内容についても同程度に信頼できる表現が形成されることを意味しない。本稿では、対照損失における温度の分析、負例に関する条件、情報圧縮の限界を補足し、検索のためのアライメントと密な視覚タスクを区別する。解析図では人為的に設定した類似度を使用し、目的関数の挙動のみを示す。タスク間の判断には、データと評価インターフェースを統制した実際の実験が引き続き必要である。[1] An Image is Worth 16x16 Words: Transformers for Image R[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
原文の英語要旨の日本語訳
マルチモーダル表現を、その学習目的とタスクのインターフェースを通じて検討する。対照学習に基づく確率モデルにより、温度と負例が識別をどのように変化させるかを例示し、情報ボトルネックの観点から、大まかなアライメントと精緻な空間推論を区別する。本レビューは、検索、位置特定、計数、構成的理解について、条件を揃えた評価を提案し、これらを相互に代替可能な尺度としては扱わない。
1. ViTは画像をトークン系列として構成する
ViTは画像をパッチに分割してベクトルに写像し、Transformerで処理する。論文の重要な条件には大規模な事前学習とその後の転移が含まれ、その結果は「どのような小規模データセットでも、純粋なTransformerが必ず畳み込みを上回る」ことを意味しない。アーキテクチャの比較では、事前学習データ、データ拡張手法、計算予算を一定に保つべきである。そうしなければ、データへの投入量の違いが構造単独の寄与として誤って記述される。[1] An Image is Worth 16x16 Words: Transformers for Image R
2. CLIPはテキストによって教師信号のインターフェースを変える
CLIPは画像とテキストのペアデータで対照表現を学習し、対応する画像とテキストを近づけ、対応しない組合せから識別する。論文で報告された学習データの規模は4億組の画像・テキストペアである。推論時には候補クラスをテキストとして記述し、類似度に基づいてゼロショット分類を行える。ここで「ゼロショット」とは、その下流分類タスクの訓練データセットを対象とした該当の学習を行っていないことを指し、モデルが関連する概念に接したことがないという意味ではない。[2] Learning Transferable Visual Models From Natural Langua
3. 類似度スコアは候補集合に依存する
候補テキストに二つのクラスしか含まれない場合、モデルはその二つの記述のいずれかを選ばざるを得ず、画像が必ずどちらかに属することをこれによって証明することはできない。プロンプトの表現、クラスの粒度、複数物体を含む場面は、利用方法に影響する。本稿では、候補テキスト、画像の前処理、認識棄却の規則を併せて保存し、認識、計数、関係、文字の読み取りを別々に評価することを推奨する。一つの分類スコアですべての視覚タスクを代替してはならない。作者分析与复核建议 / Author analysis
4. Perceiverは潜在変数のボトルネックを用いて入力を処理する
Perceiverは非対称な注意機構を用いて高次元入力をより小さな潜在変数集合に集約し、その潜在変数内で処理を行う。これは入力規模と内部計算の構成上の関係を扱うものであり、CLIPの画像・テキスト対照目的とは異なる次元の議論である。ボトルネックの導入は情報選択の問題を伴う。重要な詳細が保持されるかどうかは、具体的なタスクと解像度条件によって検証する必要がある。[3] Perceiver: General Perception with Iterative Attention
5. 解像度とパッチ分割の解析的関係
正方形画像の一辺をH、パッチの一辺をPとし、HがPで割り切れる場合、画像のパッチ数はとなる。ここでとすると、一辺224ピクセルでは196パッチ、448では784パッチとなる。画像パッチ間の全組合せのみを数えると、それぞれ38416と614656であり、16倍になる。これは別の計数例であり、本版の図2の温度曲線に対応するものではない。分類トークン、バッチ、チャネルは数えておらず、実際のFLOPsやGPUメモリの測定でもない。[1] An Image is Worth 16x16 Words: Transformers for Image R
6. 入力予算の選択はタスクに従うべきである
小さな文字の読み取りと大まかな輪郭の判断では、情報保持に対する要件が異なる。本稿では、まずタスクに必要な最小限の視覚的手掛かりを定め、その後に拡大縮小、切り出し、パッチ分割の戦略を比較することを推奨する。高解像度画像を文字が識別できなくなるまで縮小したうえで、表の計算を誤った責任を推論モジュールに求めるなら、入力情報の欠落と推論誤りを混同することになる。評価では、元画像とモデルへの実際の入力との対応関係を保持すべきである。作者分析与复核建议 / Author analysis
7. クロスモーダル評価では処理経路全体を追跡する必要がある
システムは画像エンコーダ、射影器、言語モデル、外部OCRを使用する場合がある。各モジュールのバージョンと学習範囲を明確にし、どの情報が元画像に由来し、どの情報がツールに由来するかを記録すべきである。回答に画像に存在しない属性が含まれる場合、それが知覚、テキストの事前知識、生成段階のいずれで導入されたかを調べる必要がある。モジュールの入出力を保持してこそ、誤りの発生箇所を特定できる。作者分析与复核建议 / Author analysis
表現のアライメントは個々の物体のアライメントを意味しない
画像全体と一文の対応を学ぶ目的は、概念レベルの対応を促し得るが、画素レベルの位置特定、物体の結び付け、完全な空間関係を必ずしも提供しない。「赤い物体は青い物体の左にある」と答えるための証拠は、画像が「街路」という語に関連すると判断するための証拠とは異なる。したがって、画像・テキストのアライメント研究を引用する際には、どの転移タスクについて実証されたのかを明確にし、類似度を扱う能力をすべての視覚推論能力へと拡張して解釈することを避けるべきである。作者分析与复核建议 / Author analysis
8. 対照学習が実際に最適化するのは相対的な識別である
一つの画像とテキスト候補集合に対し、学習目的は、正しいペアの正規化確率を他の候補に対して高める。それが制約するのは、バッチまたは候補集合内の相対スコアであり、自然言語記述の完全な真実性ではない。負例の違いが主に物体カテゴリにある場合、モデルは粗いカテゴリの手掛かりによってタスクを達成でき、すべての空間関係を正しく符号化する必要はない。したがって、学習損失の低下だけからきめ細かな構成的能力を推測するのではなく、負例の構成、重複ペア、意味的近傍を確認する必要がある。[2] Learning Transferable Visual Models From Natural Langua
9. 温度はどのサンプルが勾配を支配するかを変える
温度が低い場合、類似度の差が増幅され、高スコアの負例が正規化の分母と勾配にとってより重要になる。温度が高い場合には分布がより平滑になる。簡単な計算例では、正例の類似度を0.8、31個の負例の類似度を0.2に固定し、温度に応じた確率の変化を示す。これらの数値は教育用の設定であり、CLIPの測定値ではない。実際の学習では類似度、バッチサイズ、負例分布、温度が共に変化するため、この単一変数の曲線でモデル全体の学習ダイナミクスを説明することはできない。[2] Learning Transferable Visual Models From Natural Langua
10. 圧縮表現はタスクに必要な情報と整合しない場合がある
画像全体を有限のベクトルに圧縮することは、全体的な意味の比較に適している一方、精密な位置、局所的な文字、複数の類似物体の区別を弱める可能性がある。視覚Transformerのパッチ分割と位置表現は構造化されたインターフェースを提供する。Perceiverはより小さな潜在変数集合を用いて入力を処理し、別の計算構成を扱う。表現圧縮がタスクに必要な情報を失わせるかどうかは、位置特定、計数、密な予測で検証すべきである。SAMのようなプロンプトで指定可能なセグメンテーションモデルは、さらに異なる目的と出力を用いるため、画像・テキスト検索の成績だけで比較することはできない。[1] An Image is Worth 16x16 Words: Transformers for Image R[3] Perceiver: General Perception with Iterative Attention[4] Segment Anything
11. 構成的汎化には体系的な反実仮想対照が必要である
学習時に赤い物体がほぼ常に特定の背景と共に現れる場合、テスト時に背景を変更したり属性を入れ替えたりすることで、ショートカットが明らかになる可能性がある。物体を一定に保ち、色、数量、空間関係をそれぞれ変えるペア課題を構成し、テキストの長さとプロンプトを統制できる。検索結果についても実際の候補集合を保存すべきである。容易な候補の中で正解しても、類似した関係記述の間で識別できることを意味しない。言語や視覚ドメインごとの結果も個別に示し、全体平均によって系統的な失敗が隠れることを避けるべきである。[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
主要な数式と導出
(1) sは画像とテキストの類似度、τは温度を表す。正しいペアの確率は候補集合全体に依存し、候補数や負例の難しさが変わると、この量も変化する。
LaTeX
p_i=\frac{\exp(s_{ii}/\tau)}{\sum_j\exp(s_{ij}/\tau)},\qquad\mathcal L_i=-\log p_i(2) 勾配は現在の確率と温度に依存し、正例ペアのスコアだけでは決まらない。低温度が難しい負例に与える影響は、実際のスコア分布と併せて分析する必要がある。
LaTeX
\frac{\partial\mathcal L_i}{\partial s_{ij}}=\frac{p_{ij}-\mathbf1\{j=i\}}{\tau}(3) これは類似度を固定した解析例である。計数、位置特定、あるいは任意の実データセットにおけるモデルの成績を予測することはできない。
LaTeX
p_+=\frac{e^{0.8/\tau}}{e^{0.8/\tau}+31e^{0.2/\tau}}方法とエビデンスの流れ
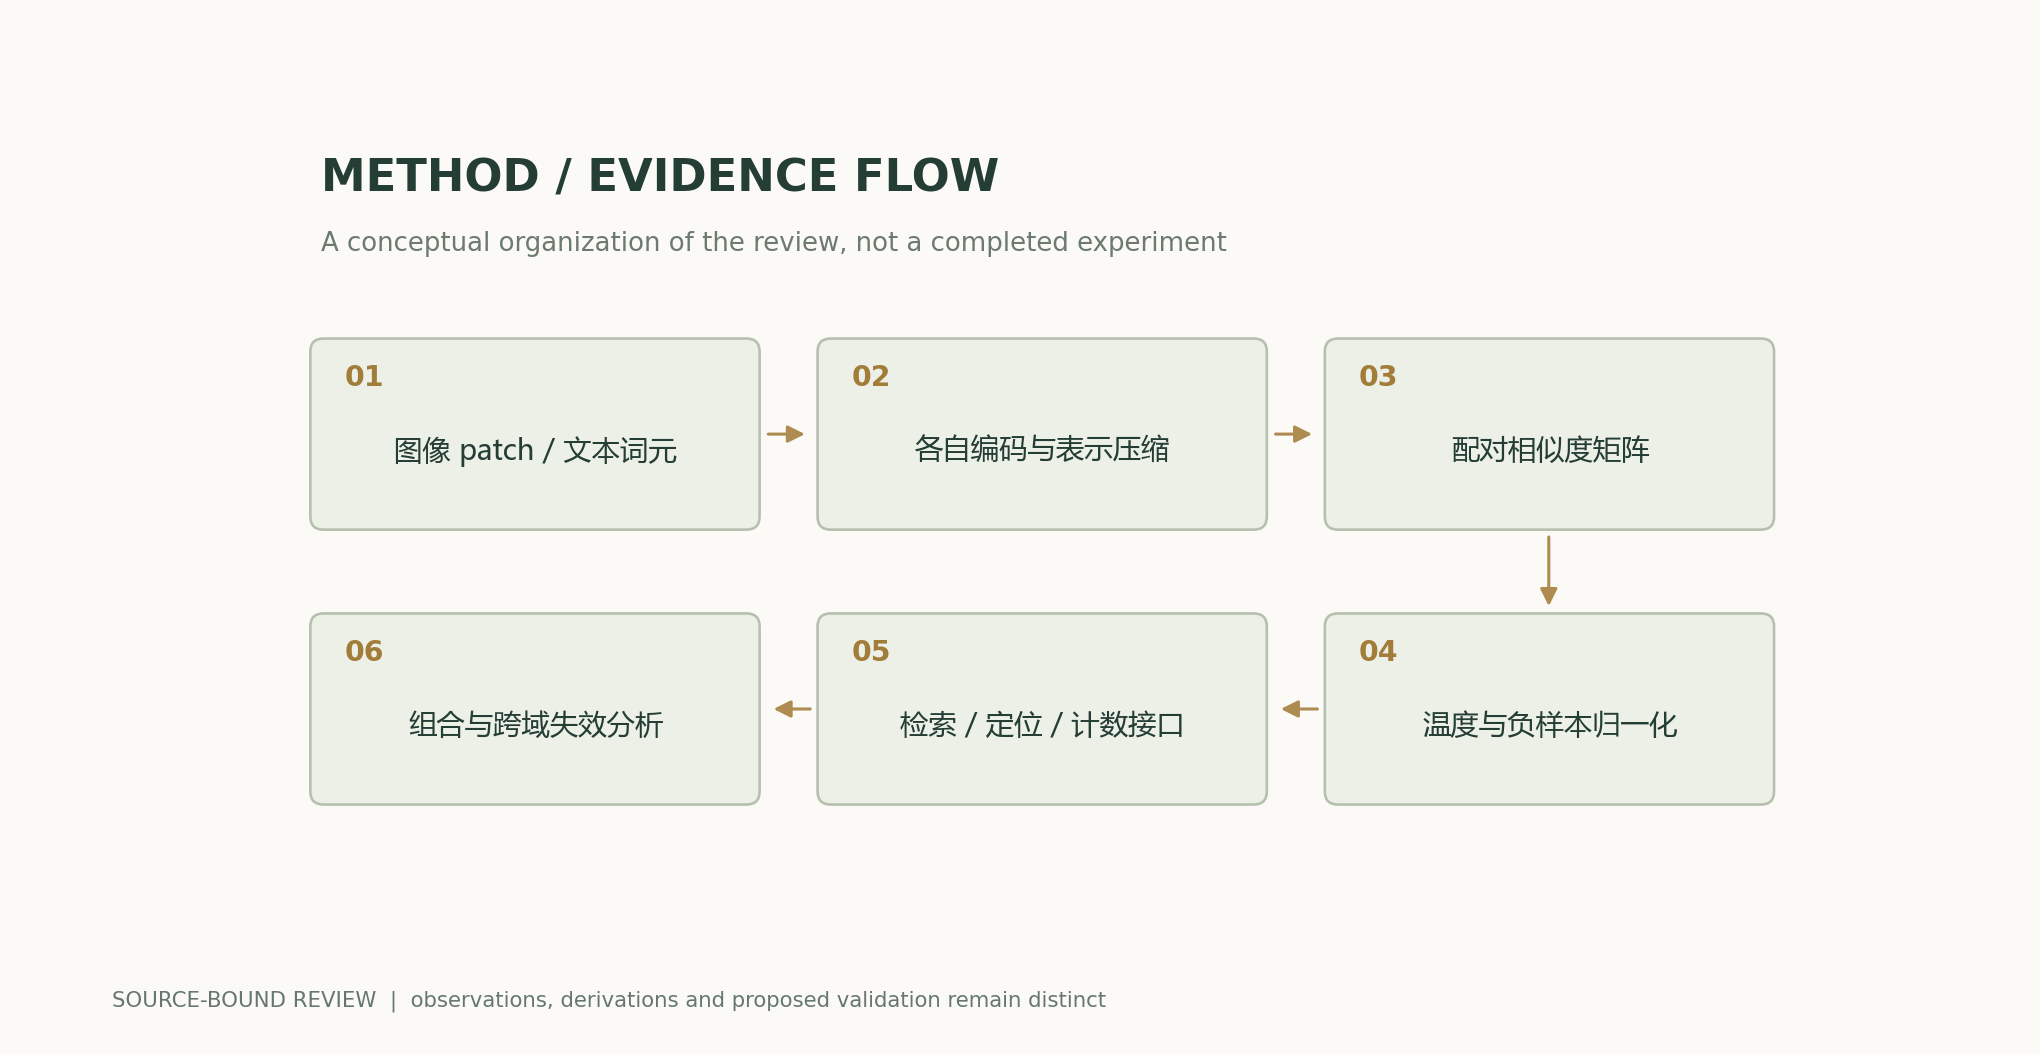
解析図と数値例
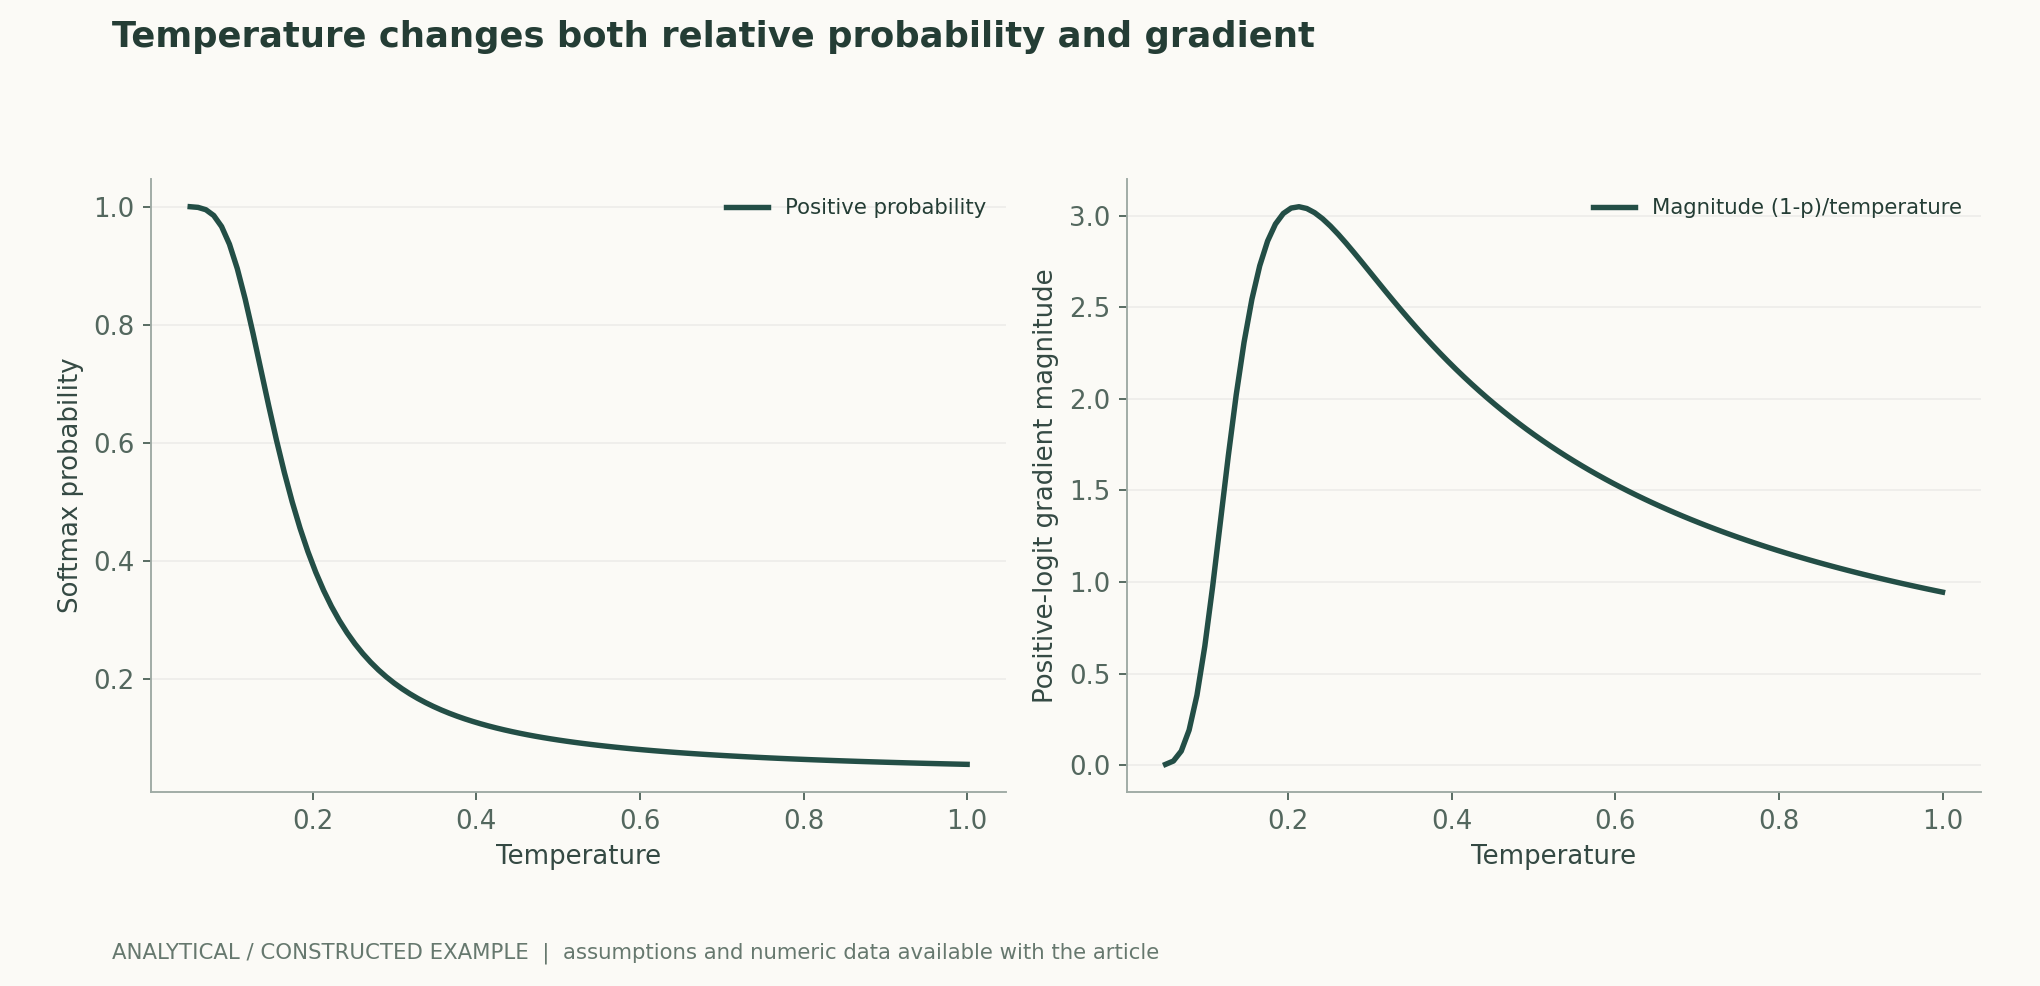
再計算可能な例題
正例の類似度を0.8、31個の負例の類似度をすべて0.2に固定すると、温度0.1での正例確率は約0.929、温度1では約0.056となる。正規化後のスコアの変化は、表現や実際の認識能力が変化したことを証明しない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 画像・テキスト検索 | 候補集合、近傍候補の難易度、言語を固定する | 全体的な意味のアライメントは正確な位置特定と同義ではない |
| 空間タスクと計数タスク | 一つの属性または関係だけを変え、反実仮想対照を保持する | カテゴリに基づくショートカットは構成的誤りを隠す可能性がある |
| 入力圧縮方式 | 同じ出力タスクと情報保持要件の下で比較する | 潜在変数が少なくても、すべての詳細が保持されるとは限らない |
| プロンプトで指定可能なセグメンテーション | 点/ボックスによるプロンプトの予算とセグメンテーションの正解データを明示する | 密な出力の品質を検索スコアで代替することはできない |
検証と実験の計画
- 画像、テキスト、候補集合のバージョンを固定し、ライセンス、重複ペア、データ分割、プロンプトの与え方を記録する。
- 検索、分類、局所的な位置特定、計数、関係判断をそれぞれ評価し、単一タスクの成績でマルチモーダル理解全体を代表させない。
- 同じ物体について一つの属性のみを変更し、背景と位置の反実仮想対照を作成して、設問の整合性を人手で確認する。
- 候補数と類似した負例の難易度を広く変化させ、各誤りに対応する候補テキストと画像領域を保存する。
- 計算方式を比較する際には、タスクのインターフェース、入力解像度、品質目標を固定し、入力圧縮とモデルの目的の変更を分けて示す。
- 言語、文化、視覚ドメインごとの性能を個別に示し、失敗例と判定不能項目を公開し、平均スコアを全領域での保証とみなさない。
適用範囲と限界
- スコアを固定した曲線は、学習ダイナミクスでも実際のモデルの結果でもない。
- ペアデータの相関は、意味に関する因果的理解を保証しない。
- 異なるマルチモーダルタスクには、異なる出力と正解データが必要である。
- 視覚または言語のドメイン横断ベンチマークは新たに追加していない。
一次資料と主張の対応
- An Image is Worth 16x16 Words: Transformers for Image Recognition at ScaleDosovitskiy et al. · 2020-10-22v2; architecture and scaling experiments
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer
- Perceiver: General Perception with Iterative AttentionJaegle et al. · 2021-03-04v2 abstract; latent bottleneck architecture
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、列挙された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿についての独立した査読や独自のモデル実験の記録はない。
リーダー性能の改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙画像と科学的図解は区別されている。科学図は公開された数式と明示された仮定から計算され、原論文の結果にはすべて帰属が明記されている。
著者、バージョン、訂正履歴 · /guides/multimodal-representations/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソースの改訂版: 6251a250b27bb8b449f59b392f81abd355383770