
Resumen
Métodos como el aprendizaje contrastivo entre imágenes y textos pueden establecer representaciones intermodales transferibles, pero el éxito del emparejamiento durante el entrenamiento no implica representaciones igualmente fiables de la posición, la cantidad, las relaciones y el contenido causal. Esta revisión incorpora un análisis de la temperatura en la pérdida contrastiva, las condiciones relativas a las muestras negativas y los límites de la compresión de información, y distingue la alineación para la recuperación de las tareas visuales densas. Los gráficos analíticos utilizan similitudes especificadas artificialmente e ilustran únicamente el comportamiento de la función objetivo; los juicios entre tareas siguen requiriendo experimentos reales que controlen los datos y las interfaces de evaluación.[1] An Image is Worth 16x16 Words: Transformers for Image R[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
Traducción del resumen original en inglés
Las representaciones multimodales se estudian a través de sus objetivos de entrenamiento y sus interfaces de tarea. Un modelo probabilístico contrastivo ilustra cómo la temperatura y las muestras negativas modifican la discriminación, mientras que la perspectiva del cuello de botella de información separa la alineación general del razonamiento espacial fino. La revisión propone evaluaciones equiparables de recuperación, localización, conteo y comprensión composicional, sin tratarlas como medidas intercambiables.
1. ViT organiza las imágenes como secuencias de tokens
ViT divide la imagen en parches, los transforma en vectores y los procesa mediante un Transformer. Entre las condiciones importantes del artículo figuran el preentrenamiento a gran escala y la transferencia posterior; ello no significa que «un Transformer puro supere necesariamente a la convolución en cualquier conjunto de datos pequeño». Las comparaciones de arquitecturas deben mantener constantes los datos de preentrenamiento, los métodos de aumento de datos y el presupuesto computacional; de lo contrario, las diferencias en la inversión en datos pueden atribuirse erróneamente a la contribución exclusiva de la arquitectura.[1] An Image is Worth 16x16 Words: Transformers for Image R
2. CLIP modifica la interfaz de supervisión mediante texto
CLIP aprende representaciones contrastivas con datos de pares imagen–texto, acercando las imágenes y los textos correspondientes y distinguiéndolos de combinaciones no correspondientes. El artículo informa de un conjunto de entrenamiento de 4 × cien millones de pares imagen–texto. Durante la inferencia, las clases candidatas pueden expresarse como texto y la similitud puede utilizarse para la clasificación sin ejemplos específicos de la tarea. Aquí, «sin ejemplos» significa que no se realizó el entrenamiento correspondiente con el conjunto de entrenamiento de la clasificación posterior, no que el modelo nunca haya encontrado conceptos relacionados.[2] Learning Transferable Visual Models From Natural Langua
3. Las puntuaciones de similitud dependen del conjunto de candidatos
Si los textos candidatos contienen únicamente dos clases, el modelo se ve obligado a elegir entre esas dos descripciones; esto no demuestra que la imagen pertenezca necesariamente a una de ellas. La redacción de las indicaciones, la granularidad de las clases y las escenas con múltiples objetos influyen en la forma de uso. Esta revisión recomienda conservar conjuntamente los textos candidatos, el preprocesamiento de las imágenes y las reglas de rechazo, y evaluar por separado el reconocimiento, el conteo, las relaciones y la lectura de texto; una única puntuación de clasificación no debe sustituir a todas las tareas visuales.作者分析与复核建议 / Author analysis
4. Perceiver procesa las entradas mediante un cuello de botella latente
Perceiver utiliza atención asimétrica para condensar entradas de alta dimensionalidad en un conjunto menor de variables latentes y después procesa la información dentro de ese conjunto. Aborda la relación organizativa entre la escala de entrada y el cómputo interno, una dimensión distinta del objetivo contrastivo imagen–texto de CLIP. Introducir un cuello de botella plantea un problema de selección de información: la conservación de detalles importantes debe comprobarse mediante tareas y condiciones de resolución específicas.[3] Perceiver: General Perception with Iterative Attention
5. Relación analítica entre resolución y división en parches
Para una imagen cuadrada de lado H y parches de lado P, cuando H es divisible por P, el número de parches de la imagen es. Tomando, un lado de 224 píxeles produce 196 parches, mientras que 448 produce 784; si solo se cuentan todos los emparejamientos entre parches, las cantidades son 38416 y 614656, respectivamente, lo que supone multiplicar por 16. Este es otro ejemplo de conteo y no corresponde a las curvas de temperatura de la figura 2 de esta versión; no incluye el token de clasificación, los lotes ni los canales, y tampoco es una medición real de FLOPs o de memoria de GPU.[1] An Image is Worth 16x16 Words: Transformers for Image R
6. El presupuesto de entrada debe elegirse en función de la tarea
Leer texto pequeño y reconocer contornos generales imponen requisitos distintos de conservación de información. Esta revisión recomienda determinar primero las pistas visuales mínimas necesarias para la tarea y después comparar estrategias de cambio de tamaño, recorte y división en parches. Si una imagen de alta resolución se reduce hasta que el texto resulta ilegible y luego se culpa al módulo de razonamiento de calcular incorrectamente una tabla, se confunde la pérdida de información de entrada con un error de razonamiento. La evaluación debe conservar la correspondencia entre la imagen original y la entrada real del modelo.作者分析与复核建议 / Author analysis
7. La evaluación intermodal debe seguir toda la cadena
Un sistema puede utilizar un codificador de imágenes, un proyector, un modelo de lenguaje y OCR externo. Deben especificarse la versión y los límites del entrenamiento de cada módulo, registrando qué información procede de la imagen original y cuál de las herramientas. Si una respuesta contiene atributos ausentes de la imagen, debe investigarse si fueron introducidos por la percepción, los conocimientos previos textuales o la fase de generación; solo conservando las entradas y salidas de los módulos es posible localizar los errores.作者分析与复核建议 / Author analysis
Alinear representaciones no implica alinear los objetos uno por uno
Un objetivo que empareja una imagen completa con una oración puede fomentar correspondencias conceptuales sin proporcionar necesariamente localización a nivel de píxel, vinculación de objetos ni relaciones espaciales completas. La evidencia necesaria para responder «el objeto rojo está a la izquierda del objeto azul» difiere de la necesaria para determinar que una imagen está relacionada con la palabra «calle». Por ello, al citar investigaciones sobre alineación imagen–texto, debe precisarse qué tarea de transferencia se ha demostrado, evitando extender la capacidad de similitud a todas las capacidades de razonamiento visual.作者分析与复核建议 / Author analysis
8. El aprendizaje contrastivo optimiza realmente la discriminación relativa
Para una imagen y un conjunto de textos candidatos, el objetivo de entrenamiento aumenta la probabilidad normalizada del emparejamiento correcto respecto de los demás candidatos. Restringe las puntuaciones relativas dentro del lote o del conjunto de candidatos, no la veracidad completa de las descripciones en lenguaje natural. Si las muestras negativas difieren principalmente en la categoría del objeto, el modelo puede resolver la tarea mediante pistas de categorías generales sin codificar correctamente cada relación espacial. Por tanto, deben examinarse la construcción de las muestras negativas, los emparejamientos duplicados y los vecinos semánticos, en lugar de inferir capacidad composicional fina únicamente a partir del descenso de la pérdida de entrenamiento.[2] Learning Transferable Visual Models From Natural Langua
9. La temperatura modifica qué muestras dominan el gradiente
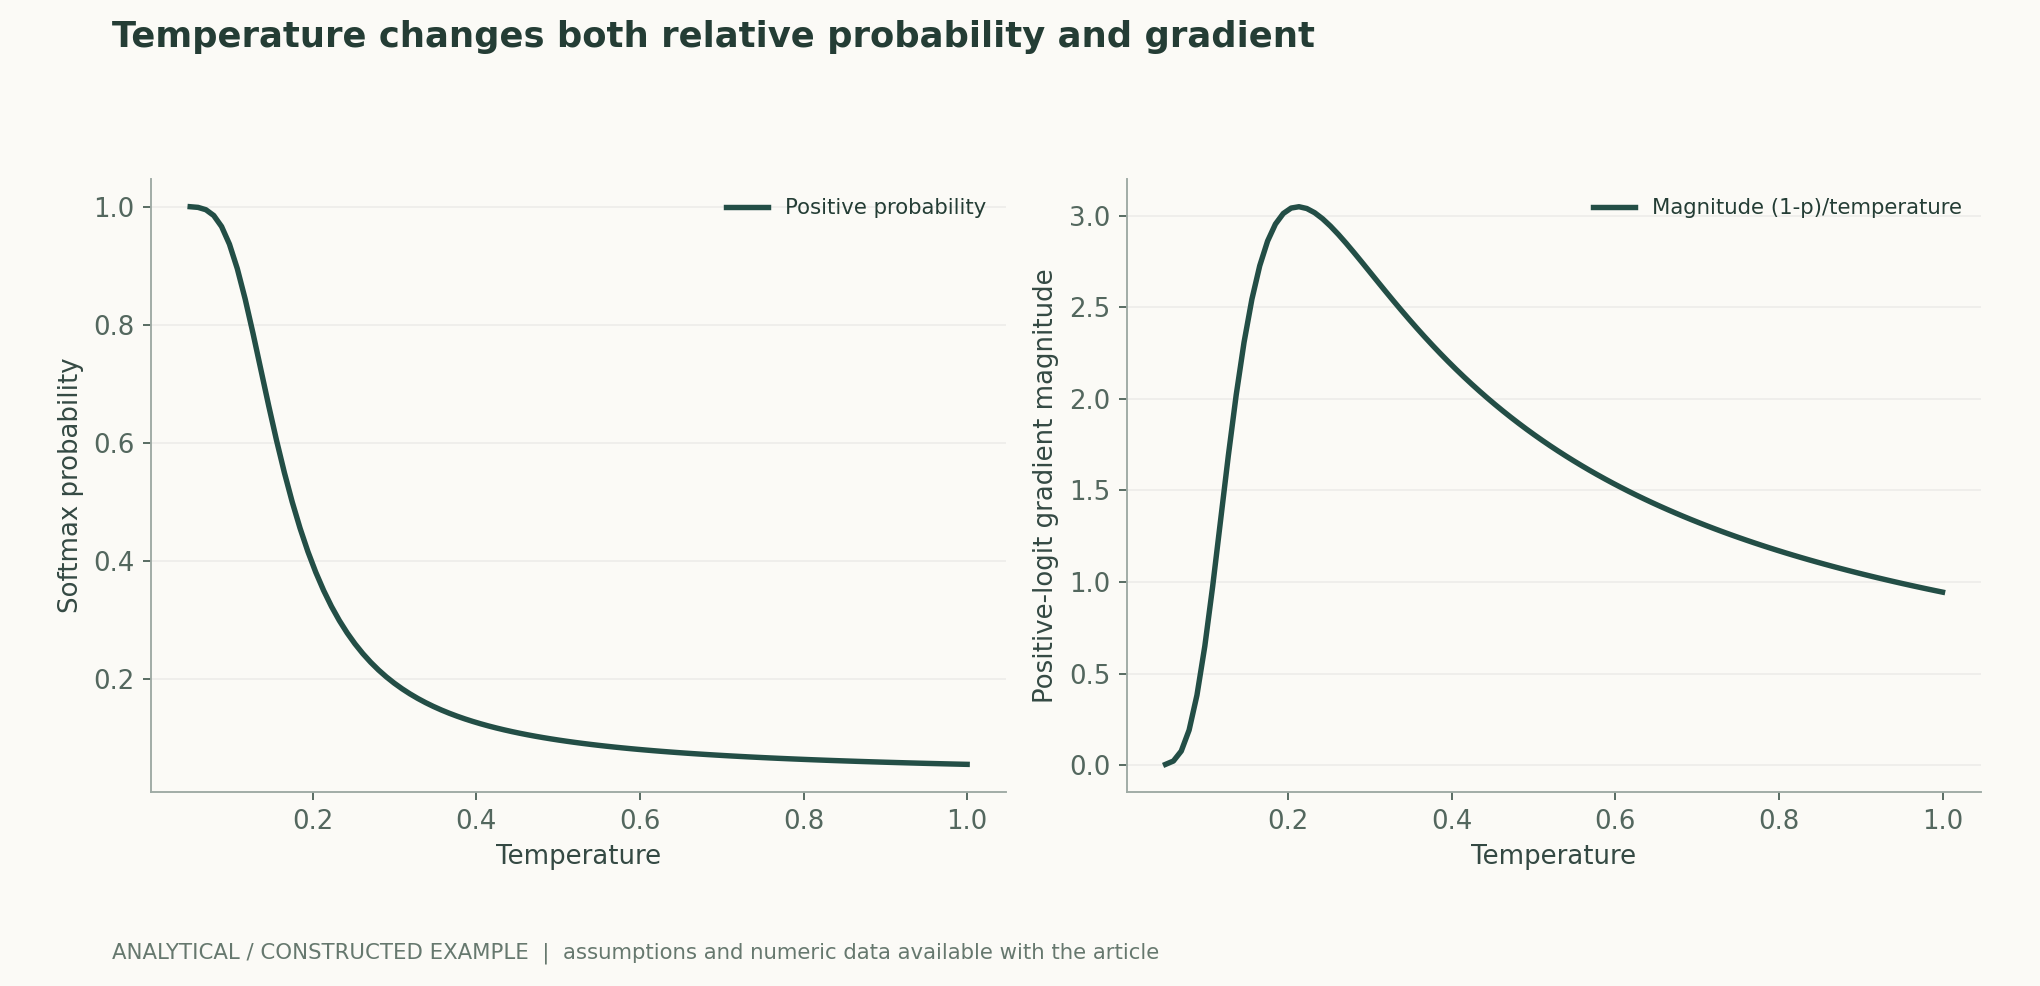
Con temperaturas más bajas se amplifican las diferencias de similitud, y las muestras negativas con puntuaciones altas adquieren mayor importancia para el denominador de normalización y el gradiente; temperaturas más altas producen una distribución más suave. Un ejemplo numérico sencillo fija la similitud positiva en 0.8 y 31 similitudes negativas en 0.2, mostrando cómo varía la probabilidad con la temperatura. Estos valores son supuestos didácticos, no mediciones de CLIP. Durante el entrenamiento real, las similitudes, el tamaño del lote, la distribución de las muestras negativas y la temperatura varían conjuntamente; esta curva de una sola variable no puede explicar toda la dinámica de entrenamiento del modelo.[2] Learning Transferable Visual Models From Natural Langua
10. Las representaciones comprimidas pueden no corresponderse con la información que requiere la tarea
Comprimir una imagen completa en un vector finito resulta adecuado para comparar la semántica global, pero puede debilitar la distinción de posiciones precisas, texto local y múltiples objetos similares. La división en parches y las representaciones posicionales de los Transformers visuales proporcionan una interfaz estructurada; Perceiver procesa las entradas mediante un conjunto latente menor y aborda otra organización del cómputo. La posible pérdida de información necesaria para la tarea debida a la compresión de representaciones debe comprobarse mediante localización, conteo o predicción densa. Los modelos de segmentación guiada por indicaciones, como SAM, emplean otros objetivos y salidas, y no pueden compararse únicamente mediante el rendimiento en recuperación imagen–texto.[1] An Image is Worth 16x16 Words: Transformers for Image R[3] Perceiver: General Perception with Iterative Attention[4] Segment Anything
11. La generalización composicional requiere controles contrafactuales sistemáticos
Si durante el entrenamiento los objetos rojos aparecen casi siempre con un determinado tipo de fondo, cambiar el fondo o intercambiar atributos durante la prueba puede revelar atajos. Pueden construirse tareas emparejadas en las que los objetos permanezcan constantes y se modifiquen por separado el color, la cantidad y las relaciones espaciales, controlando la longitud del texto y las indicaciones. Los resultados de recuperación también deben conservar el conjunto real de candidatos: acertar entre candidatos fáciles no implica mantener la capacidad de discriminar entre descripciones de relaciones similares. También deben presentarse por separado los resultados de distintos idiomas y dominios visuales, para evitar que las medias agregadas oculten fallos sistemáticos.[2] Learning Transferable Visual Models From Natural Langua[3] Perceiver: General Perception with Iterative Attention
Ecuaciones fundamentales y derivaciones
(1) s representa la similitud imagen–texto y τ la temperatura. La probabilidad del emparejamiento correcto depende de todo el conjunto de candidatos; cambiar el número de candidatos o la dificultad de las muestras negativas modifica esta magnitud.
LaTeX
p_i=\frac{\exp(s_{ii}/\tau)}{\sum_j\exp(s_{ij}/\tau)},\qquad\mathcal L_i=-\log p_i(2) El gradiente depende de la probabilidad actual y de la temperatura, no solo de la puntuación del par positivo. El efecto de una temperatura baja sobre los negativos difíciles debe analizarse junto con la distribución real de las puntuaciones.
LaTeX
\frac{\partial\mathcal L_i}{\partial s_{ij}}=\frac{p_{ij}-\mathbf1\{j=i\}}{\tau}(3) Este es un ejemplo analítico con similitudes fijas. No puede predecir el rendimiento del modelo en conteo, localización ni en ningún conjunto de datos real.
LaTeX
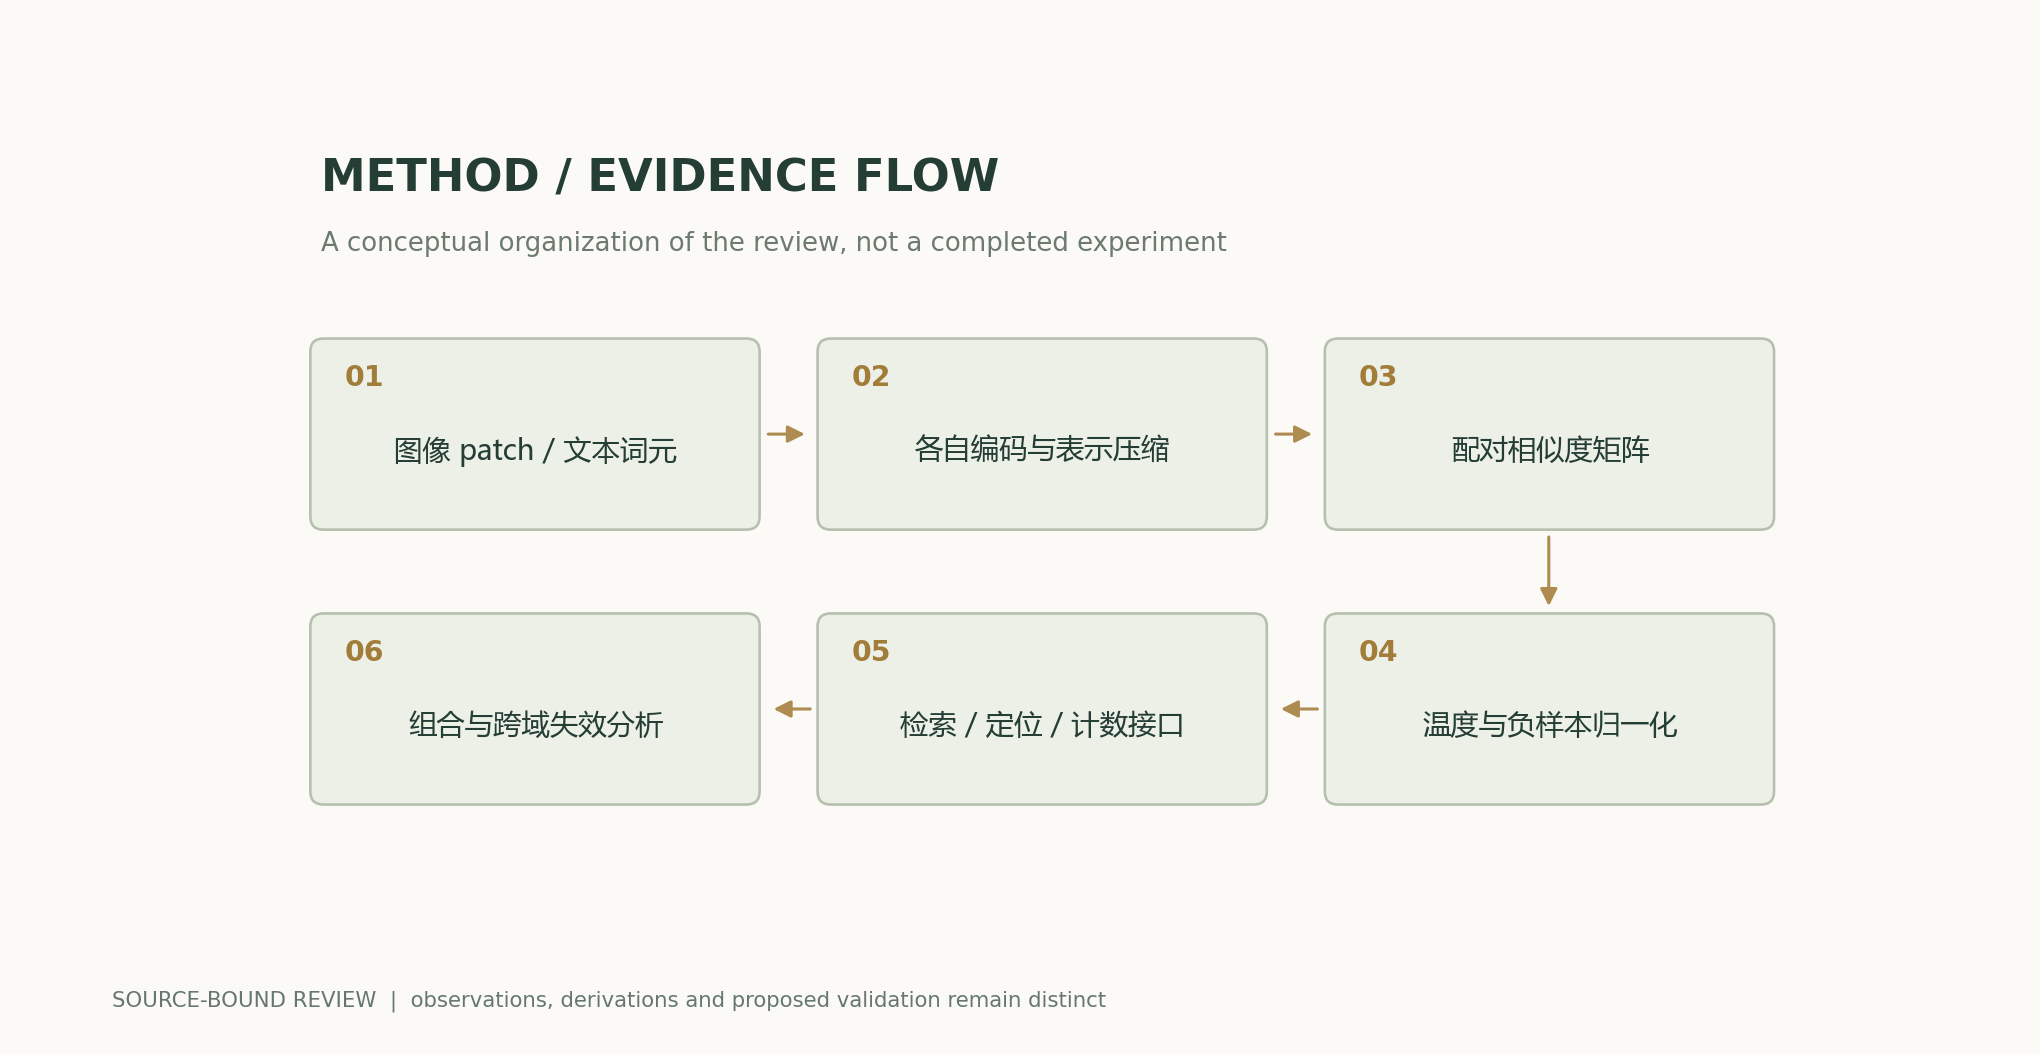
p_+=\frac{e^{0.8/\tau}}{e^{0.8/\tau}+31e^{0.2/\tau}}Flujo metodológico y de evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo con cálculo reproducible
Fijando la similitud de la muestra positiva en 0.8 y las de las 31 muestras negativas en 0.2, la probabilidad de la muestra positiva es aproximadamente 0.929 a una temperatura de 0.1 y aproximadamente 0.056 a una temperatura de 1. Los cambios en las puntuaciones normalizadas no demuestran cambios en las representaciones ni en la capacidad real de reconocimiento.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo y explicación |
|---|---|---|
| Recuperación imagen–texto | Fijar el conjunto de candidatos, la dificultad de los vecinos y el idioma | La alineación semántica global no equivale a una localización precisa |
| Tareas espaciales y de conteo | Modificar un solo atributo o relación y conservar controles contrafactuales | Los atajos de categoría pueden ocultar errores composicionales |
| Esquemas de compresión de entrada | Comparar las mismas tareas de salida y los mismos requisitos de conservación de información | Un menor número de variables latentes no conserva necesariamente todos los detalles |
| Segmentación guiada por indicaciones | Especificar el presupuesto de indicaciones mediante puntos/recuadros y la referencia verdadera de segmentación | Las puntuaciones de recuperación no pueden sustituir la calidad de las salidas densas |
Plan de verificación y experimentación
- Fijar las versiones de las imágenes, los textos y los conjuntos de candidatos, y registrar las licencias, los emparejamientos duplicados, las particiones y los métodos de indicación.
- Evaluar por separado la recuperación, la clasificación, la localización de regiones, el conteo y los juicios sobre relaciones, evitando que el rendimiento en una única tarea represente toda la comprensión multimodal.
- Modificar un solo atributo en los mismos objetos, crear controles contrafactuales de fondos y posiciones y verificar mediante revisión humana la coherencia de los ítems de prueba.
- Explorar distintos números de candidatos y grados de dificultad de muestras negativas similares, conservando los textos candidatos y las regiones de imagen asociados a cada error.
- Al comparar esquemas computacionales, fijar la interfaz de tarea, la resolución de entrada y el objetivo de calidad, y presentar por separado la compresión de entrada y los cambios en los objetivos del modelo.
- Presentar el rendimiento por separado según idioma, cultura y dominio visual, publicar los fallos y los ítems indeterminados, y no considerar la puntuación media una garantía para todos los dominios.
Ámbito de aplicación y limitaciones
- Las curvas con puntuaciones fijas no son dinámicas de entrenamiento ni resultados de modelos reales.
- Las correlaciones en datos emparejados no garantizan una comprensión causal de la semántica.
- Las distintas tareas multimodales requieren salidas y referencias verdaderas diferentes.
- No se incorporan nuevos bancos de pruebas entre dominios visuales o lingüísticos.
Correspondencia entre fuentes primarias y afirmaciones
- An Image is Worth 16x16 Words: Transformers for Image Recognition at ScaleDosovitskiy et al. · 2020-10-22v2; architecture and scaling experiments
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer
- Perceiver: General Perception with Iterative AttentionJaegle et al. · 2021-03-04v2 abstract; latent bottleneck architecture
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó la revisión y realizó las derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de las ilustraciones científicas; las figuras científicas se calculan mediante ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/multimodal-representations/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770