
摘要:精度是一组联合条件
引导编辑把“在哪里改”和“改成什么”写入同一套分子识别与模板系统,但一个碱基达到预期并不自动说明整个细胞的基因组结果正确。本文以原始机制及修复环境研究为证据起点,建立从输入细胞、完整读段到预期产物的分层账本。核心问题是如何同时报告改写概率、非预期产物、缺失测量和后续选择,让设计优化所提升的指标对应真正关心的生物学对象。[1] Search-and-replace genome editing without double-strand[2] Enhanced prime editing systems by manipulating cellular
English abstract
Prime editing couples targeted nicking to template-directed reverse transcription. This review separates intended editing, product purity, delivery and cellular selection. We develop a multinomial outcome ledger, show why conditional purity can conceal low starting-cell yield, and propose molecule-linked and longitudinal validation without presenting new editing experiments.
机制与首篇研究的适用范围
Anzalone等提出将切口酶、逆转录模块与包含编辑信息的引导RNA耦合,展示多类定点改变。该研究提供了能力范围的实验依据,但体系、位点和细胞类型是结论的组成部分。“无需双链断裂”描述设计路径,不等于任何条件下不存在双链损伤、大片段变化或细胞应激。本文不将可编辑变异的理论覆盖范围写成疾病治疗成功率。[1] Search-and-replace genome editing without double-strand
修复环境使同一设计产生不同结果
Chen等通过细胞决定因素分析和编辑器结构优化,说明宿主修复过程会改变编辑产物分布。因而编辑器性能应被看成设计、细胞环境和测量流程的联合函数。不能把一个细胞背景中的倍数改善,直接移植为另一种组织的固定增益。原研究中的短期效果与本文提出的长期验证目标也应分开,后者需要额外证据。[2] Enhanced prime editing systems by manipulating cellular
定义不能重叠的结果空间
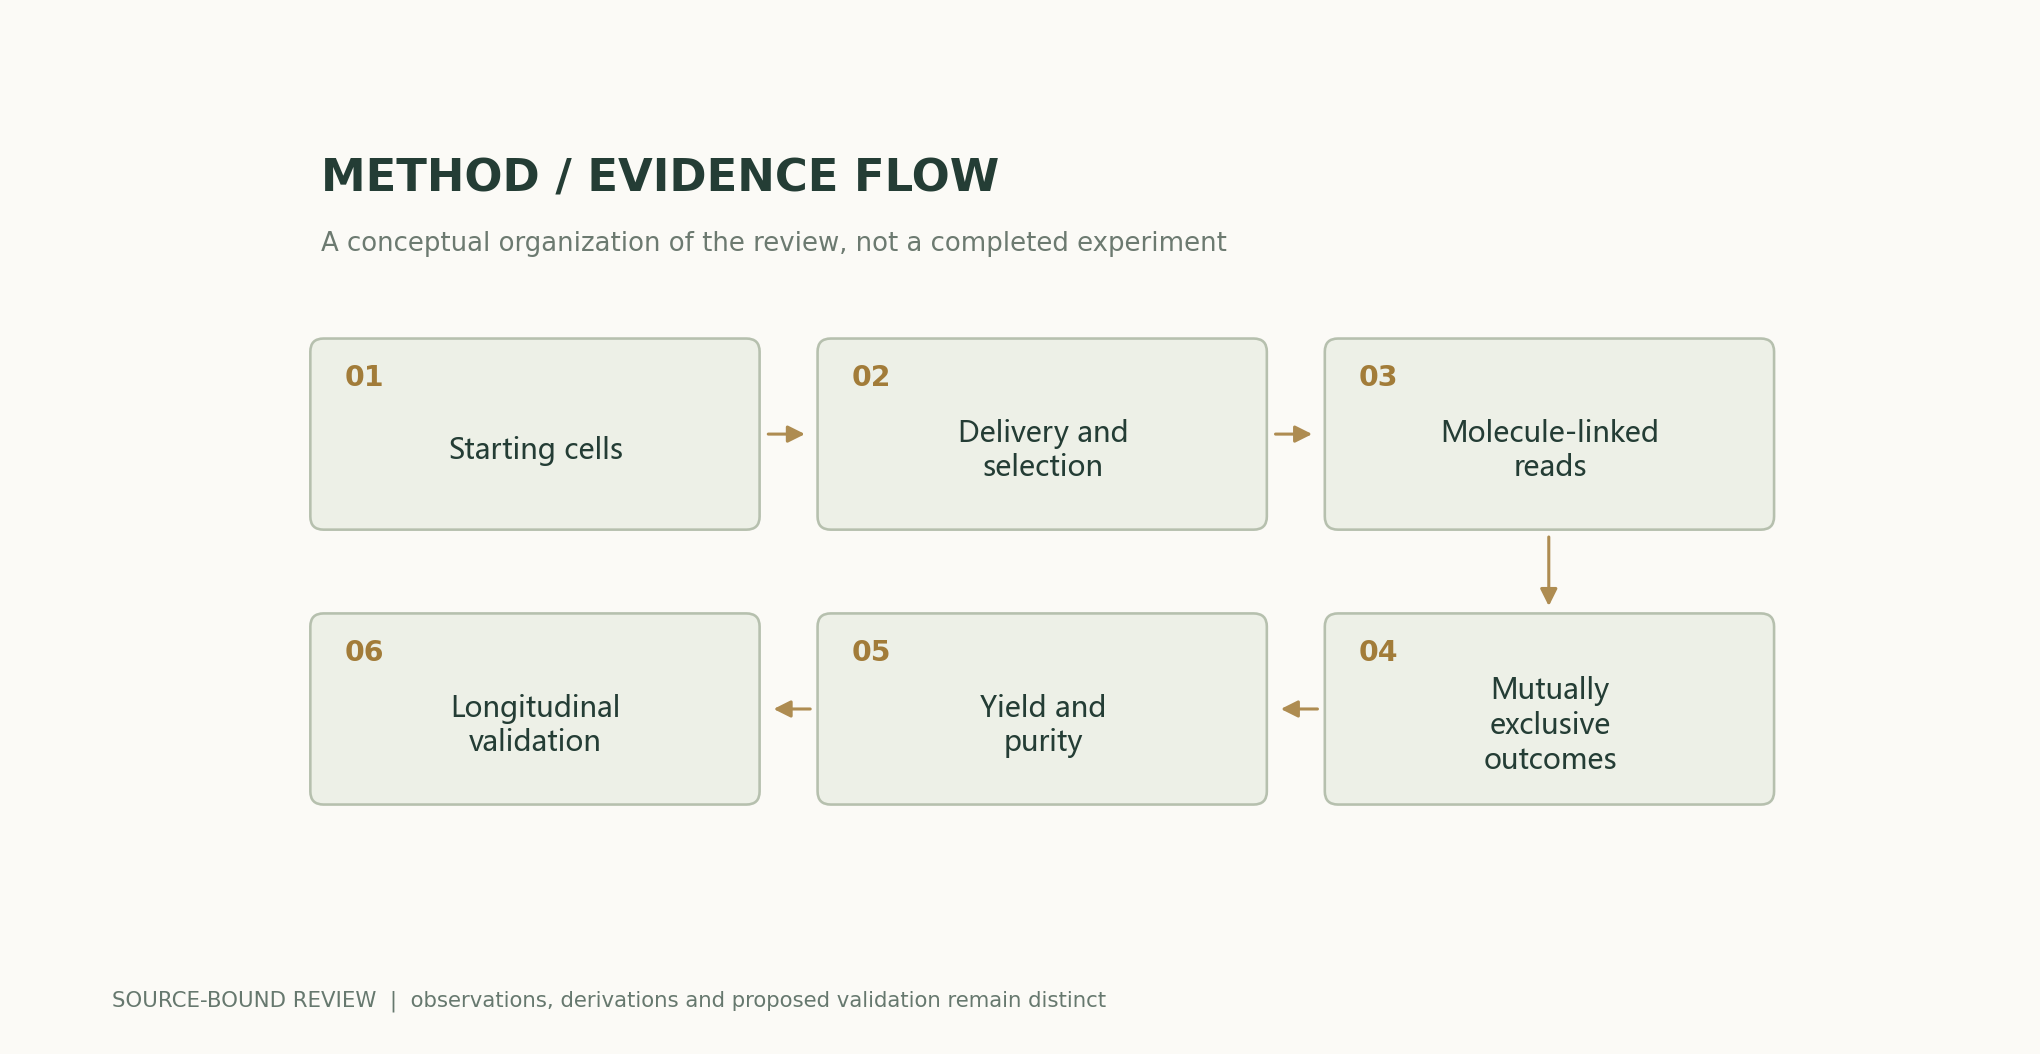
本文建议先按分子定义互斥类别:完全预期、带额外改变、未改写、结构异常以及不可判定。完全预期必须指定观察窗口;只读到局部正确的分子不能被自动分配到“全基因组正确”。若多个位点位于同一分子,独立计数会重复使用证据。对无法确定是否同源的长短读段,应保留关联不确定性,而不是用最大的成功数字拼接结果。作者分析与复核建议 / Author analysis
分母为什么会改变结论
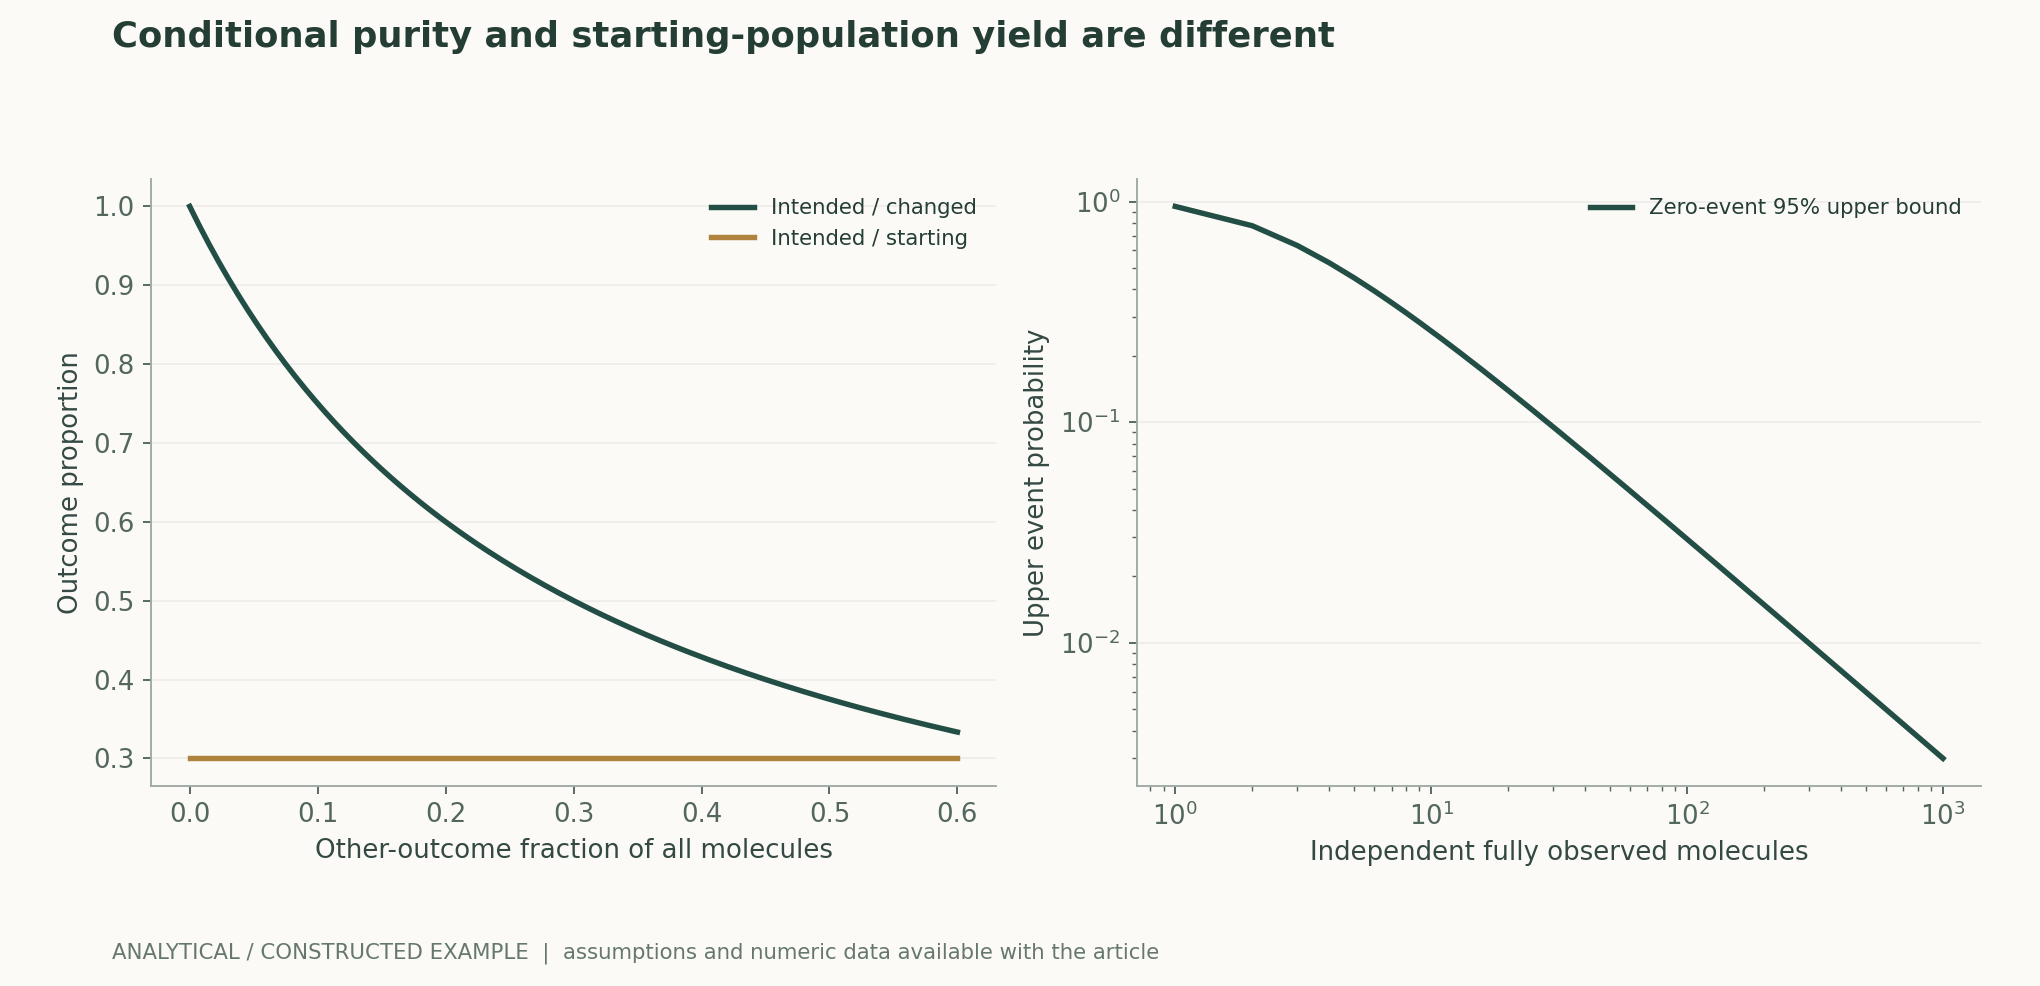
构造一个纯粹算术例子:1000条合格原始分子中,300条完全预期、100条带其他改变、600条未改写。预期编辑率是30%,在所有改变产物中的纯度为75%。两个数都正确,却回答不同问题。如果先删去未改写分子再宣称75%效率,就把条件概率变成了总体概率。若另有100条无法判定的分子,总体分母还必须另列,不能悄悄删除。作者分析与复核建议 / Author analysis
递送与存活构成另一层选择
假定进入观察的细胞只占起始细胞的一半,且其中预期改写比例为30%,则起始细胞口径的产率只有15%。这不是递送平台的真实参数,而是说明条件选择如何累乘。更复杂的情况是正确改写与存活相关,此时不能直接把独立测得的两个比例相乘,必须获得同一细胞或同一谱系上的联合数据。否则优选存活者可能掩盖受损群体。作者分析与复核建议 / Author analysis
序列窗口与结构事件
短读段可以精细区分局部碱基,却未必跨越较远的重排断点。扩大窗口会降低某些事件的漏检,但也可能改变比对失败和扩增偏好。合理策略是针对不同事件类别配置互补测量,并明确每种测量可见的区域。需要对“未观察到”的事件给出检测上限,而不是把观察窗口之外的风险设为零。引导编辑的精度应随分辨率一起报告。作者分析与复核建议 / Author analysis
测序错误与低频非预期产物
当目标错误率接近测序或扩增背景时,增加读数可能只会更精确地测量平台偏差。本文把观测频率写成真实事件和误判过程的混合,要求独立阴性样本与已知混合比例的校准材料。错误若与序列上下文相关,统一扣除一个常数背景并不充分。最好在分子层去重后再估计频率,且保留原始读数与独立分子数的区别。作者分析与复核建议 / Author analysis
零观测不能证明零事件
若每个独立分子发生某事件的概率是q,n个分子均未检出的概率为(1−q)的n次方。由此可以推导单侧置信上限,样本越少,上限越宽。公式依赖独立性与完美检出,实际有漏检时约束更弱。图中的上限仅是二项模型,不是本文对任何编辑器做出的安全估计,也不能替代需要长期观察的细胞行为结论。作者分析与复核建议 / Author analysis
位点选择造成的外推误差
容易测量、容易递送或最先成功的位点往往更可能进入展示集。若设计器又在这些位点上调参,测试集会偏向同一类局部序列。本文建议先固定未参与设计选择的位点家族,并按序列相似性和细胞背景分组。应报告失败位点和缺失原因;跨位点平均值必须说明是否加权,不能让大量技术重复压过少数难位点。作者分析与复核建议 / Author analysis
时间维度与克隆扩增
早期预期产物比例和长期谱系占比并非同一量。一个稀有细胞若具有增长优势,可在后续样本中占据很大比例;反之,正确编辑细胞也可能逐渐消失。因此纵向比较需要记录培养或随访条件、谱系关联及取样比例。把后期比例升高都归因于编辑反应继续发生,会混淆生成机制与选择机制,尤其在分裂速度不一致时。作者分析与复核建议 / Author analysis
多目标优化不能只有一个最高分
设计评价至少包含预期产率、其他改变率、不可判定比例和成本。可以绘制这些指标的Pareto前沿,说明没有一个候选在所有维度同时占优。若必须合成单一分数,应预先公开权重及可接受下界,并做权重敏感性分析。否则修改权重就能制造新的“最佳方案”。本文的图采用假定参数解释分母,不给具体实验设计排序。作者分析与复核建议 / Author analysis
可复核的统计单位
读段、原始分子、细胞、克隆与独立批次构成嵌套结构。技术重复只能降低测量噪声,不能替代独立背景的复制。置信区间应围绕研究目标选择重采样层级,例如以批次或谱系为单位。若跨方法共享同一批样本,比较具有配对结构,应利用这种结构估计差异,而不是把双方全部读段假定为独立观察。作者分析与复核建议 / Author analysis
AI设计器应该输出可证伪声明
一个有用的设计模型应说明预测的是局部编辑率、完整产物纯度还是递送后的联合成功率。输出不确定性需要在未见背景中校准;模型还应能拒绝超出训练覆盖的请求。本文建议保留训练版本、候选过滤顺序与每次失败记录,使“模型推荐”可追溯到准确输入。模型分数只形成检验优先级,不能代替分子测量结果。作者分析与复核建议 / Author analysis
从现有研究到待验证命题
可检验的扩展是:在完整分母、相同事件窗口和独立批次下,针对修复环境的优化是否仍提高联合正确产率;该提升是否以更高不可判定率或特定谱系选择为代价。要回答这些问题,必须预先规定主要终点并完整保存未成功样本。本文提供评价框架和解析模型,没有新增编辑细胞、临床观察或长期安全实验。作者分析与复核建议 / Author analysis
同一误差率下的样本量设计
若目标是把完全未检出事件的95%上限压到1%以内,独立且完全检出时需要约299个分子;压到千分之一则约2995个。这些数量来自对数不等式,不是建议某种实验的合规规模。实际取样若受同一克隆主导,数千读段也可能远少于数千独立证据,因此预先设计必须同时约束分子覆盖、细胞来源和批次数量。作者分析与复核建议 / Author analysis
比率差异的可解释比较
在两个编辑方案之间,纯度提升可能来自预期产物增多,也可能只是其他改变产物减少。两种机制对总体产率的影响不同。本文建议同时展示互斥类别的绝对频率差、相对频率和不确定区间,并在共同样本上做配对比较。单独比较条件比率容易忽略分母变化,特别是在一种方案使大批样本无法测量时。作者分析与复核建议 / Author analysis
批次效应与盲法归类
如果实验人员知道候选所属方案,模糊产物的人工分类可能发生方向一致的偏差。重分析可先固定质量规则和事件分类器,再由隐藏候选标签的流程输出结果。遇到分类规则需要修订时,应保留旧规则结果并在所有候选上同步重跑,不能只修补最受关注的设计。分类器的版本因此也是研究结果的一部分。作者分析与复核建议 / Author analysis
否定性结果的发表价值
低产率、未改善或只在少数背景有效的设计,能够约束机制适用范围,而不是研究过程中的废料。完整数据应允许定位哪个环节限制了联合成功:没有进入细胞、没有形成预期产物,还是形成后未保持。这样的可定位失败能帮助后续模型避免重复无效搜索,也能检验提升究竟来自生物学改变还是展示口径改变。作者分析与复核建议 / Author analysis
结论:把“正确”绑定到对象
引导编辑的科学价值在于可编程改写机制,而可信应用还依赖结果空间、测量覆盖和选择过程的共同约束。最有信息的报告应允许读者重新计算不同分母、不同窗口和不同时间点下的结果,并清楚看到哪些结论在改变假设后仍成立。这比只展示一个局部最高效率更接近可累计的研究证据,也为不同实验室之间的公平比较提供了基础。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 互斥类别构成完整分母;不可判定也列为一类。
LaTeX
\widehat p_k=n_k/N,\qquad \sum_k n_k=N(2) 条件纯度不等于所有原始分子中的编辑产率。
LaTeX
P(\mathrm{intended}\mid\mathrm{changed})=n_{\rm intended}/(n_{\rm intended}+n_{\rm other})(3) 起始样本联合产率;D表示进入目标递送/观察条件,I表示完全预期产物。
LaTeX
Y=P(D)P(I\mid D)(4) 零事件的单侧二项上限,依赖独立且完全检出。
LaTeX
q_{\rm upper}=1-\alpha^{1/n}方法与证据流程
解析图与数值示例
可复算例题
1000分子中300预期、100其他改变、600未改变:总体产率30%,改变产物纯度75%。若仅半数起始细胞进入观察,条件预期率30%对应起始15%。零事件n=299时95%上限约0.997%。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| 局部短读测序 | 观察窗口内碱基组成 | 窗口外结构事件 |
| 长读段关联 | 同分子上多处改变 | 长度偏差与平台错误 |
| 单细胞分析 | 细胞层联合结果 | 掉失与细胞选择 |
| 独立批次 | 实验背景变化 | 足够位点与背景覆盖 |
| 纵向谱系 | 增长与结果保持 | 时间跨度及谱系采样 |
| AI设计分数 | 候选排序 | 未见背景中的实测校准 |
复核与实验方案
- 固定结果窗口、互斥分类和主要分母。
- 保存原始读数、分子去重规则与比对失败数。
- 利用校准材料估计背景错误和漏检。
- 分别计算总体产率与改变产物中的纯度。
- 按独立批次和位点家族比较设计器。
- 检查递送、存活和取样的关联选择。
- 重新计算不同窗口与缺失归类下的敏感性。
- 冻结数据、代码、参数与准确来源版本。
适用范围与局限
- 本文没有真实编辑实验或临床数据。
- 二项上限假设独立及完全检出。
- 局部正确不证明其他基因组区域正确。
- 所引研究体系不能直接外推其他组织。
- 技术重复与长期谱系证据不能互相替代。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 引导RNA编码目标改变并与逆转录编辑模块协作。 | 原研究选定位点与细胞条件。 | Search-and-replace genome editing without double-strand breaks or donor DNAAbstract; Figs. 1–5 |
| 修复环境与编辑器架构影响产物分布。 | 原研究对照及短期结果。 | Enhanced prime editing systems by manipulating cellular determinants of editing outcomesAbstract; cellular determinants and PEmax |
值得检验的研究问题
- 完整分母下的联合正确率是否仍保持位点间优势?
- 哪些测量缺失与特定编辑结果相关?
- 长期谱系选择如何改变早期产物比例?
一手来源与主张对应
- Search-and-replace genome editing without double-strand breaks or donor DNAAndrew V. Anzalone, Peyton B. Randolph, Jessie R. Davis, Alexander A. Sousa, Luke W. Koblan, Jonathan M. Levy, et al. · 2019-10-21Abstract; Figs. 1–5
- Enhanced prime editing systems by manipulating cellular determinants of editing outcomesPeter J. Chen, Jeffrey A. Hussmann, Jun Yan, Friederike Knipping, Purnima Ravisankar, Pin-Fang Chen, et al. · 2021-10Abstract; mismatch-repair and PEmax results
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da