
Resumen: la precisión es un conjunto de condiciones conjuntas
La edición prime codifica «dónde modificar» y «por qué secuencia sustituir» en un mismo sistema de reconocimiento molecular y plantilla, pero que una base alcance el estado deseado no demuestra automáticamente que el resultado genómico de toda la célula sea correcto. Esta revisión toma como punto de partida probatorio los estudios del mecanismo original y del entorno de reparación, y construye un registro jerárquico que abarca desde las células de entrada y las lecturas completas hasta los productos deseados. La cuestión central es cómo comunicar conjuntamente la probabilidad de reescritura, los productos no deseados, las mediciones ausentes y la selección posterior, de modo que los indicadores mejorados por la optimización del diseño correspondan a las entidades biológicas que realmente interesan.[1] Search-and-replace genome editing without double-strand[2] Enhanced prime editing systems by manipulating cellular
Traducción del resumen original en inglés
La edición prime acopla la introducción dirigida de cortes en una sola hebra con la transcripción inversa guiada por una plantilla. Esta revisión distingue la edición deseada, la pureza de los productos, la entrega y la selección celular. Desarrollamos un registro multinomial de resultados, mostramos por qué la pureza condicional puede ocultar un bajo rendimiento respecto a las células iniciales y proponemos una validación vinculada a moléculas y longitudinal, sin presentar nuevos experimentos de edición.
Mecanismo y alcance del estudio inicial
Anzalone y sus colaboradores propusieron acoplar una nickasa, un módulo de transcripción inversa y un ARN guía que contiene la información de edición, y demostraron diversos tipos de cambios en sitios específicos. El estudio aporta evidencia experimental sobre el alcance de estas capacidades, pero el sistema, los sitios y los tipos celulares forman parte de sus conclusiones. «Sin necesidad de roturas de doble hebra» describe la vía de diseño; no implica que en cualquier condición estén ausentes el daño de doble hebra, los cambios en segmentos grandes o el estrés celular. Esta revisión no presenta la cobertura teórica de variantes editables como una tasa de éxito terapéutico.[1] Search-and-replace genome editing without double-strand
El entorno de reparación hace que un mismo diseño produzca resultados distintos
Mediante el análisis de determinantes celulares y la optimización de la arquitectura del editor, Chen y sus colaboradores mostraron que los procesos de reparación del hospedador modifican la distribución de los productos de edición. Por tanto, el rendimiento del editor debe considerarse una función conjunta del diseño, el entorno celular y los procedimientos de medición. Una mejora de cierto número de veces en un contexto celular no puede trasladarse directamente como una ganancia fija a otro tejido. Los efectos a corto plazo del estudio original también deben distinguirse de los objetivos de validación a largo plazo propuestos aquí, que requieren evidencia adicional.[2] Enhanced prime editing systems by manipulating cellular
Definir un espacio de resultados con categorías no solapadas
Esta revisión recomienda definir primero categorías mutuamente excluyentes a nivel molecular: completamente deseado, con cambios adicionales, sin reescritura, estructuralmente anómalo e indeterminado. La categoría completamente deseado debe especificar la ventana de observación; las moléculas cuya lectura solo demuestra corrección local no pueden asignarse automáticamente a «corrección en todo el genoma». Si varios sitios se encuentran en una misma molécula, contarlos de manera independiente reutiliza la evidencia. Cuando no pueda determinarse si las lecturas largas y cortas comparten origen, debe conservarse la incertidumbre sobre su vinculación, en lugar de ensamblar resultados a partir de las cifras de éxito más altas.作者分析与复核建议 / Author analysis
Por qué el denominador cambia las conclusiones
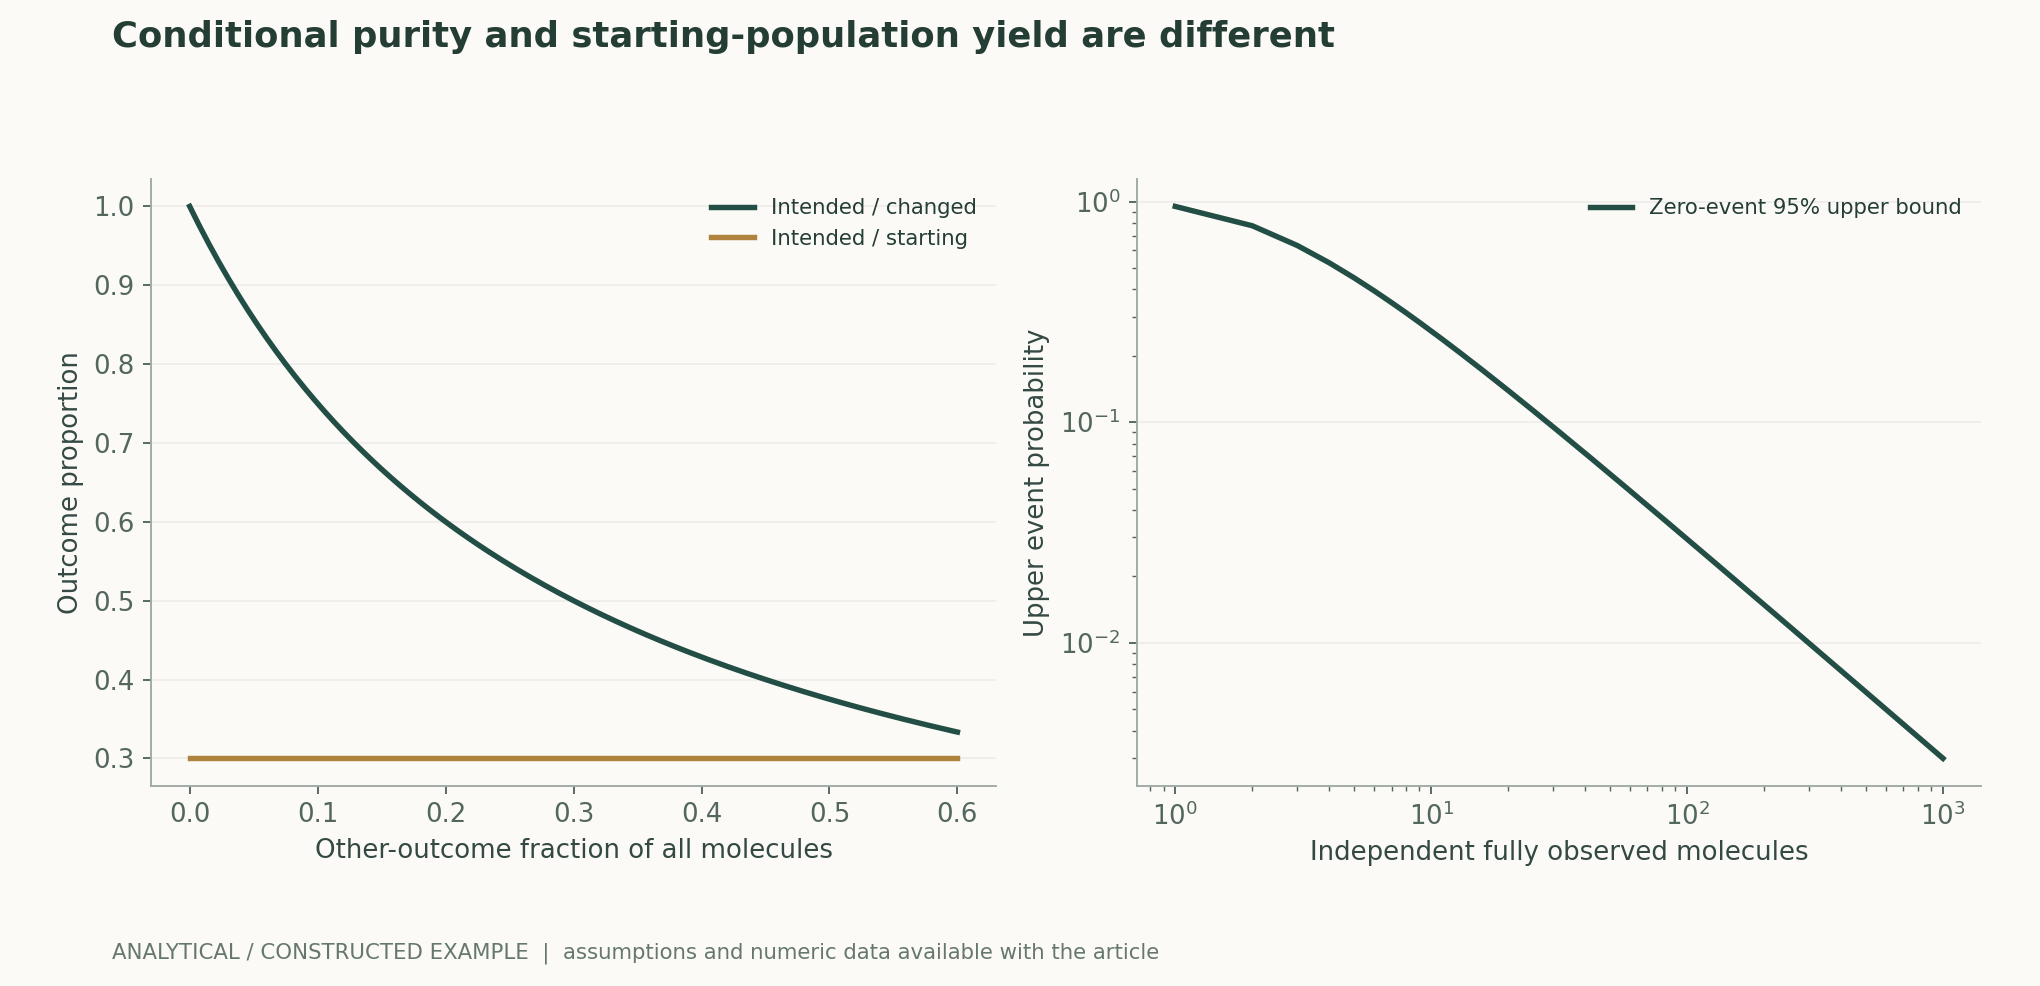
Consideremos un ejemplo puramente aritmético: entre 1000 moléculas originales que cumplen los criterios, 300 son completamente deseadas, 100 presentan otros cambios y 600 no se han reescrito. La tasa de edición deseada es 30%, mientras que la pureza entre todos los productos modificados es 75%. Ambas cifras son correctas, pero responden a preguntas distintas. Si primero se eliminan las moléculas no reescritas y después se declara una eficiencia de 75%, se convierte una probabilidad condicional en una probabilidad global. Si además existen 100 moléculas indeterminadas, también debe indicarse por separado el denominador global; no pueden eliminarse de forma silenciosa.作者分析与复核建议 / Author analysis
La entrega y la supervivencia constituyen otra capa de selección
Supongamos que las células que entran en observación representan solo la mitad de las iniciales y que la proporción con reescritura deseada entre ellas es 30%; entonces el rendimiento referido a las células iniciales es de solo 15%. Estos no son parámetros reales de una plataforma de entrega, sino una ilustración de cómo la selección condicional se acumula multiplicativamente. Una situación más compleja se presenta cuando la reescritura correcta se asocia con la supervivencia: en tal caso no pueden multiplicarse directamente dos proporciones medidas de forma independiente, sino que se necesitan datos conjuntos de la misma célula o del mismo linaje. De lo contrario, seleccionar preferentemente a los supervivientes puede ocultar la población dañada.作者分析与复核建议 / Author analysis
Ventanas de secuencia y eventos estructurales
Las lecturas cortas permiten distinguir con precisión las bases locales, pero quizá no abarquen puntos de rotura de reordenamientos más distantes. Ampliar la ventana puede reducir la falta de detección de ciertos eventos, aunque también puede modificar los fallos de alineamiento y el sesgo de amplificación. Una estrategia razonable consiste en utilizar mediciones complementarias para distintas categorías de eventos y especificar las regiones visibles para cada medición. Debe proporcionarse un límite superior basado en la detección para los eventos «no observados», en lugar de asignar un riesgo nulo fuera de la ventana de observación. La precisión de la edición prime debe comunicarse junto con la resolución.作者分析与复核建议 / Author analysis
Errores de secuenciación y productos no deseados de baja frecuencia
Cuando la tasa de error objetivo se aproxima al fondo de secuenciación o amplificación, aumentar las lecturas puede limitarse a medir con mayor precisión el sesgo de la plataforma. Esta revisión expresa la frecuencia observada como una mezcla de eventos reales y un proceso de clasificación errónea, y exige muestras negativas independientes y materiales de calibración con proporciones de mezcla conocidas. Si los errores dependen del contexto de secuencia, restar uniformemente un único fondo constante no basta. Es preferible estimar las frecuencias después de la deduplicación molecular, conservando la distinción entre el número de lecturas brutas y el de moléculas independientes.作者分析与复核建议 / Author analysis
La ausencia de observaciones no demuestra la ausencia de eventos
Si la probabilidad de un evento en cada molécula independiente es q, la probabilidad de no detectarlo en ninguna de n moléculas es (1−q) elevado a n. De ello puede derivarse un límite superior de confianza unilateral; cuanto menor sea la muestra, más amplio será el límite superior. La fórmula depende de la independencia y de una detección perfecta, y la restricción se debilita cuando en la práctica hay eventos no detectados. El límite superior de la figura corresponde únicamente a un modelo binomial, no a una estimación de seguridad de ningún editor realizada por esta revisión, y tampoco sustituye las conclusiones sobre comportamiento celular que requieren observación a largo plazo.作者分析与复核建议 / Author analysis
Errores de extrapolación causados por la selección de sitios
Los sitios fáciles de medir, accesibles a la entrega o en los que primero se obtiene éxito suelen tener más probabilidades de incorporarse al conjunto mostrado. Si además se ajusta el diseñador en esos sitios, el conjunto de prueba favorecerá los mismos tipos de secuencias locales. Esta revisión recomienda fijar de antemano familias de sitios que no hayan participado en la selección del diseño y agruparlas por similitud de secuencia y contexto celular. Deben comunicarse los sitios fallidos y los motivos de los datos ausentes; las medias entre sitios deben especificar si están ponderadas, evitando que numerosas réplicas técnicas eclipsen unos pocos sitios difíciles.作者分析与复核建议 / Author analysis
La dimensión temporal y la expansión clonal
La proporción temprana de productos deseados y la proporción de un linaje a largo plazo no son la misma magnitud. Una célula rara con ventaja de crecimiento puede representar una gran fracción de las muestras posteriores; a la inversa, las células correctamente editadas pueden desaparecer gradualmente. Por ello, las comparaciones longitudinales requieren registrar las condiciones de cultivo o seguimiento, las relaciones de linaje y las fracciones de muestreo. Atribuir todo aumento posterior de la proporción a la continuación de la reacción de edición confunde los mecanismos de generación con los de selección, especialmente cuando difieren las velocidades de división.作者分析与复核建议 / Author analysis
La optimización multiobjetivo no puede reducirse a una única puntuación máxima
La evaluación del diseño debe incluir al menos el rendimiento deseado, la tasa de otros cambios, la proporción indeterminada y el coste. Puede trazarse la frontera de Pareto de estos indicadores para mostrar que ningún candidato domina simultáneamente en todas las dimensiones. Si es necesario combinarlos en una única puntuación, deben publicarse de antemano los pesos y los límites inferiores aceptables, y realizarse un análisis de sensibilidad a los pesos. De lo contrario, basta cambiar los pesos para fabricar una nueva «mejor solución». Las figuras de esta revisión utilizan parámetros supuestos para explicar los denominadores y no clasifican diseños experimentales concretos.作者分析与复核建议 / Author analysis
Unidades estadísticas verificables
Las lecturas, las moléculas originales, las células, los clones y los lotes independientes forman una estructura anidada. Las réplicas técnicas solo pueden reducir el ruido de medición; no sustituyen la replicación en contextos independientes. El nivel de remuestreo de los intervalos de confianza debe elegirse según el objetivo del estudio, por ejemplo utilizando lotes o linajes como unidades. Si distintos métodos comparten el mismo lote de muestras, la comparación presenta una estructura pareada, que debe aprovecharse para estimar las diferencias, en lugar de asumir que todas las lecturas de ambos métodos son observaciones independientes.作者分析与复核建议 / Author analysis
Los diseñadores basados en IA deberían emitir afirmaciones falsables
Un modelo de diseño útil debe especificar si predice la tasa de edición local, la pureza del producto completo o la tasa de éxito conjunto tras la entrega. La incertidumbre de sus resultados debe calibrarse en contextos no vistos; el modelo también debería poder rechazar solicitudes fuera de la cobertura de su entrenamiento. Esta revisión recomienda conservar la versión de entrenamiento, el orden de filtrado de candidatos y el registro de cada fallo para que las «recomendaciones del modelo» sean trazables hasta sus entradas exactas. Las puntuaciones del modelo solo establecen prioridades de prueba y no sustituyen los resultados de las mediciones moleculares.作者分析与复核建议 / Author analysis
De la investigación existente a las proposiciones pendientes de validación
Una extensión comprobable consiste en determinar si, con un denominador completo, ventanas de eventos idénticas y lotes independientes, la optimización dirigida al entorno de reparación sigue aumentando el rendimiento conjunto correcto, y si esa mejora se obtiene a costa de una mayor tasa de resultados indeterminados o de la selección de linajes específicos. Para responder, debe predefinirse el criterio principal de valoración y deben conservarse íntegramente las muestras sin éxito. Esta revisión aporta un marco de evaluación y modelos analíticos; no añade nuevas células editadas, observaciones clínicas ni experimentos de seguridad a largo plazo.作者分析与复核建议 / Author analysis
Diseño del tamaño muestral con una misma tasa de error
Si el objetivo es reducir el límite superior de confianza al 95% para un evento nunca detectado a no más de 1%, se necesitan aproximadamente 299 moléculas con independencia y detección perfecta; reducirlo a una milésima requiere aproximadamente 2995. Estas cantidades proceden de una desigualdad logarítmica y no recomiendan un tamaño que cumpla requisitos regulatorios para un experimento concreto. Si el muestreo real está dominado por un mismo clon, miles de lecturas pueden representar muchas menos de miles de unidades de evidencia independientes; por ello, el diseño previo debe imponer restricciones conjuntas a la cobertura molecular, el origen celular y el número de lotes.作者分析与复核建议 / Author analysis
Comparaciones interpretables de las diferencias entre cocientes
Entre dos enfoques de edición, el aumento de pureza puede deberse a una mayor cantidad de productos deseados o simplemente a una reducción de los productos con otros cambios. Estos mecanismos afectan de distinta manera al rendimiento global. Esta revisión recomienda presentar conjuntamente las diferencias de frecuencia absoluta, las frecuencias relativas y los intervalos de incertidumbre de las categorías mutuamente excluyentes, y realizar comparaciones pareadas en muestras compartidas. Comparar solo cocientes condicionales facilita pasar por alto cambios del denominador, especialmente cuando uno de los enfoques hace que muchas muestras no puedan medirse.作者分析与复核建议 / Author analysis
Efectos de lote y clasificación enmascarada
Si el personal experimental sabe a qué enfoque pertenece cada candidato, la clasificación manual de productos ambiguos puede adquirir un sesgo sistemático en una misma dirección. El reanálisis puede fijar primero las reglas de calidad y el clasificador de eventos y después generar resultados mediante un procedimiento que oculte las etiquetas de los candidatos. Cuando sea necesario revisar las reglas de clasificación, deben conservarse los resultados de las reglas anteriores y repetirse el análisis simultáneamente para todos los candidatos, en lugar de corregir únicamente el diseño que recibe mayor atención. Por tanto, la versión del clasificador también forma parte de los resultados del estudio.作者分析与复核建议 / Author analysis
El valor de publicar resultados negativos
Los diseños con bajo rendimiento, sin mejora o eficaces solo en unos pocos contextos permiten delimitar el alcance del mecanismo; no son residuos del proceso investigador. Los datos completos deben permitir localizar la etapa que limita el éxito conjunto: falta de entrada en las células, falta de formación del producto deseado o falta de mantenimiento después de formarse. Estos fallos localizables pueden ayudar a los modelos posteriores a evitar búsquedas infructuosas repetidas y a comprobar si la mejora procede de cambios biológicos o de cambios en el criterio de presentación.作者分析与复核建议 / Author analysis
Conclusión: vincular lo «correcto» a la entidad evaluada
El valor científico de la edición prime reside en su mecanismo de reescritura programable, mientras que las aplicaciones fiables también dependen de las restricciones conjuntas del espacio de resultados, la cobertura de medición y los procesos de selección. Los informes más informativos deberían permitir a los lectores recalcular los resultados con distintos denominadores, ventanas y momentos, y ver claramente qué conclusiones siguen siendo válidas al cambiar los supuestos. Esto se aproxima más a una evidencia investigadora acumulativa que mostrar una única eficiencia local máxima, y proporciona una base para comparar justamente entre laboratorios.作者分析与复核建议 / Author analysis
Ecuaciones principales y derivaciones
(1) Las categorías mutuamente excluyentes constituyen el denominador completo; los resultados indeterminados también forman una categoría.
LaTeX
\widehat p_k=n_k/N,\qquad \sum_k n_k=N(2) La pureza condicional no equivale al rendimiento de edición entre todas las moléculas originales.
LaTeX
P(\mathrm{intended}\mid\mathrm{changed})=n_{\rm intended}/(n_{\rm intended}+n_{\rm other})(3) Rendimiento conjunto en la muestra inicial; D indica la entrada en las condiciones objetivo de entrega/observación e I, un producto completamente deseado.
LaTeX
Y=P(D)P(I\mid D)(4) Límite superior binomial unilateral con ausencia de eventos, dependiente de la independencia y de una detección perfecta.
LaTeX
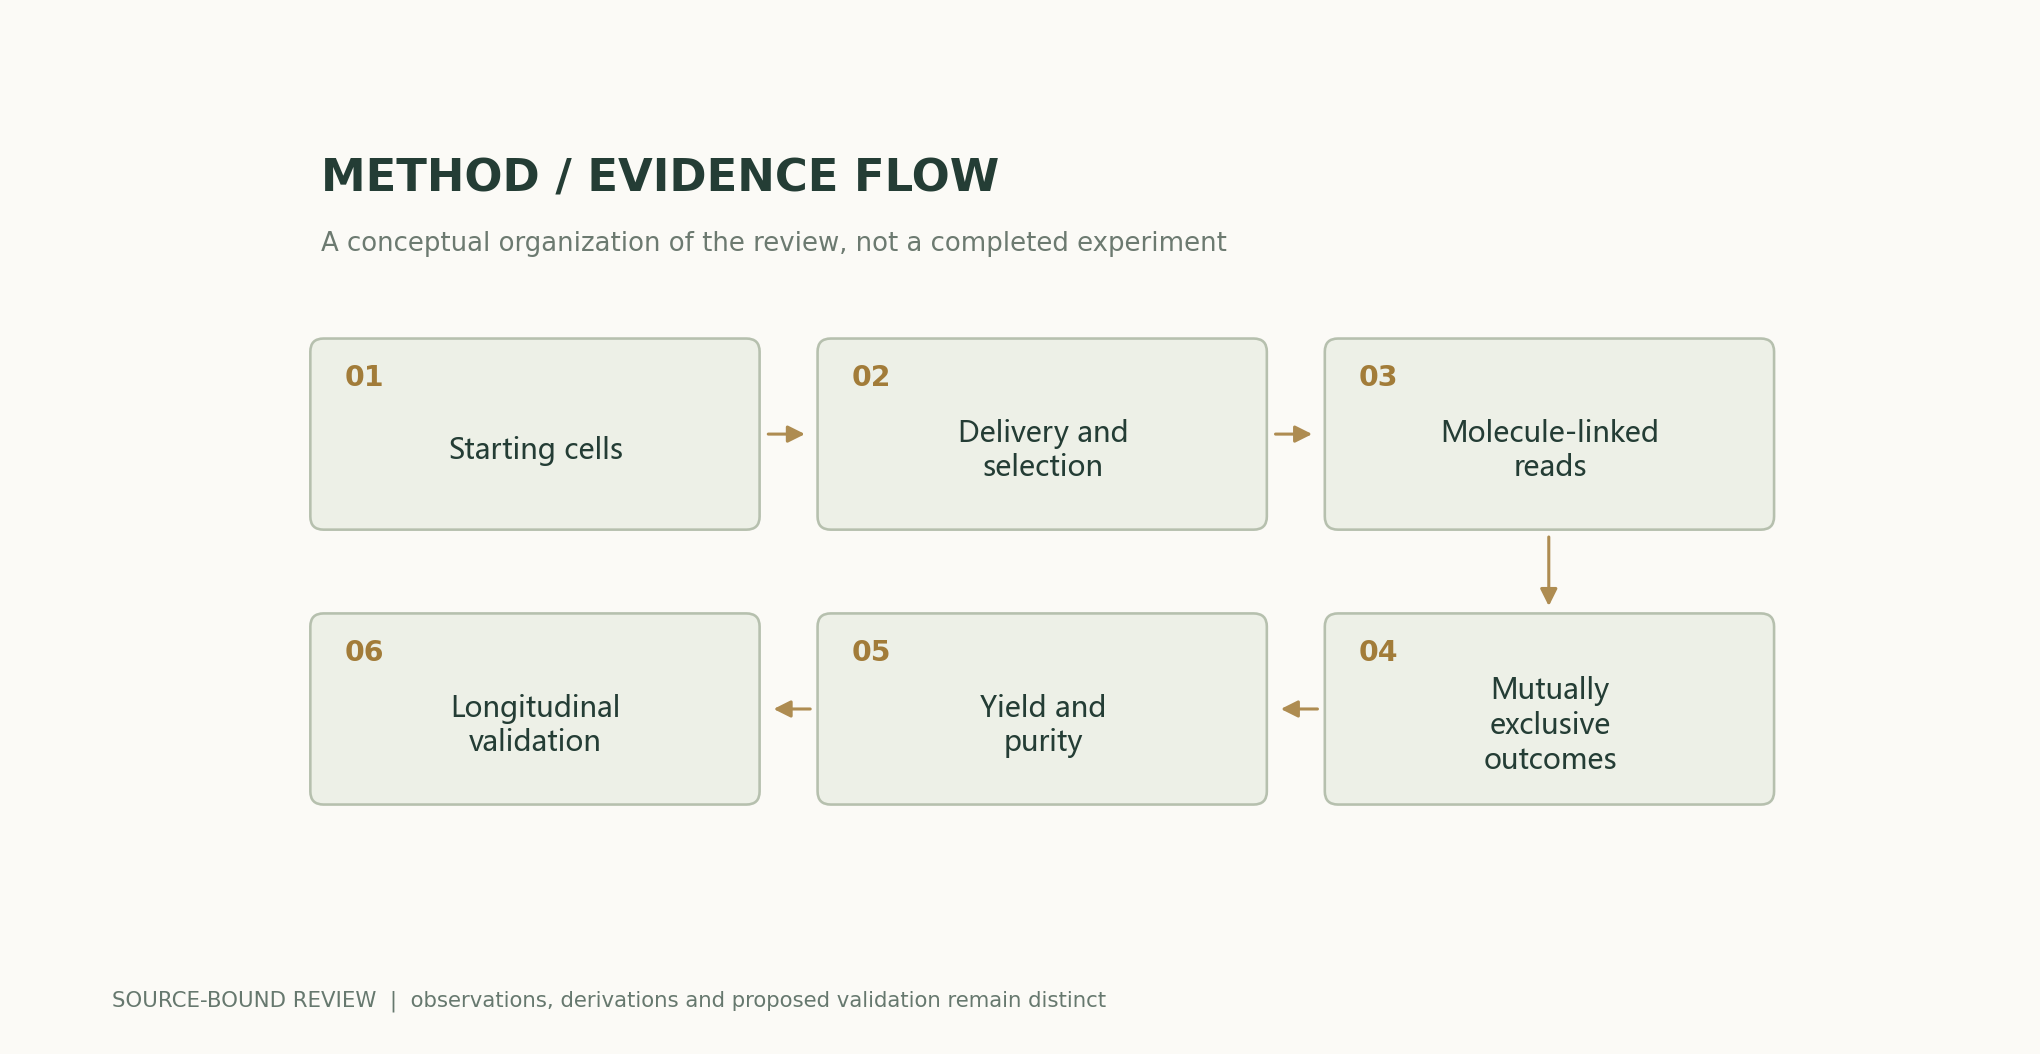
q_{\rm upper}=1-\alpha^{1/n}Flujo de métodos y evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto reproducible mediante recálculo
Entre 1000 moléculas, 300 son deseadas, 100 presentan otros cambios y 600 no han cambiado: rendimiento global 30%, pureza entre productos modificados 75%. Si solo la mitad de las células iniciales entra en observación, la tasa condicional deseada 30% corresponde a 15% respecto a la población inicial. Con ausencia de eventos y n=299, el límite superior de confianza al 95% es aproximadamente 0.997%.
Comparación de métodos
| Método o criterio de cálculo | Qué delimita directamente | Evidencia todavía necesaria |
|---|---|---|
| Secuenciación local de lecturas cortas | Composición de bases dentro de la ventana de observación | Eventos estructurales fuera de la ventana |
| Vinculación mediante lecturas largas | Múltiples cambios en una misma molécula | Sesgo de longitud y errores de plataforma |
| Análisis unicelular | Resultados conjuntos a nivel celular | Pérdida de detección y selección celular |
| Lotes independientes | Variación del contexto experimental | Cobertura suficiente de sitios y contextos |
| Seguimiento longitudinal de linajes | Crecimiento y mantenimiento de los resultados | Duración y muestreo de linajes |
| Puntuación de diseño por IA | Ordenación de candidatos por puntuación | Calibración empírica en contextos no vistos |
Plan de verificación y experimentación
- Fijar la ventana de resultados, la clasificación mutuamente excluyente y el denominador principal.
- Conservar las lecturas brutas, las reglas de deduplicación molecular y los recuentos de fallos de alineamiento.
- Utilizar materiales de calibración para estimar los errores de fondo y los fallos de detección.
- Calcular por separado el rendimiento global y la pureza entre los productos modificados.
- Comparar los diseñadores por lotes independientes y familias de sitios.
- Examinar la selección asociada con la entrega, la supervivencia y el muestreo.
- Recalcular la sensibilidad con distintas ventanas y clasificaciones de los resultados ausentes.
- Congelar los datos, el código, los parámetros y las versiones exactas de las fuentes.
Alcance y limitaciones
- Esta revisión no contiene experimentos de edición reales ni datos clínicos.
- El límite superior binomial presupone independencia y detección perfecta.
- La corrección local no demuestra la corrección de otras regiones genómicas.
- Los sistemas de los estudios citados no pueden extrapolarse directamente a otros tejidos.
- Las réplicas técnicas y la evidencia de linajes a largo plazo no pueden sustituirse mutuamente.
Evidencia de los estudios originales y su alcance
| Resultados del estudio original | Alcance | Fuente y ubicación |
|---|---|---|
| El ARN guía codifica el cambio objetivo y coopera con el módulo de edición por transcripción inversa. | Sitios y condiciones celulares seleccionados en el estudio original. | Edición genómica de búsqueda y reemplazo sin roturas de doble hebra ni ADN donanteResumen; figuras 1–5 |
| El entorno de reparación y la arquitectura del editor influyen en la distribución de los productos. | Controles y resultados a corto plazo del estudio original. | Sistemas mejorados de edición prime mediante la manipulación de los determinantes celulares de los resultados de ediciónResumen; determinantes celulares y PEmax |
Preguntas de investigación que merece la pena contrastar
- ¿Mantiene la tasa conjunta de corrección su ventaja entre sitios cuando se utiliza el denominador completo?
- ¿Qué mediciones ausentes se asocian con resultados específicos de edición?
- ¿Cómo modifica la selección de linajes a largo plazo las proporciones tempranas de productos?
Correspondencia entre fuentes primarias y afirmaciones
- Search-and-replace genome editing without double-strand breaks or donor DNAAndrew V. Anzalone, Peyton B. Randolph, Jessie R. Davis, Alexander A. Sousa, Luke W. Koblan, Jonathan M. Levy, et al. · 2019-10-21Abstract; Figs. 1–5
- Enhanced prime editing systems by manipulating cellular determinants of editing outcomesPeter J. Chen, Jeffrey A. Hussmann, Jun Yan, Friederike Knipping, Purnima Ravisankar, Pin-Fang Chen, et al. · 2021-10Abstract; mismatch-repair and PEmax results
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada con fuentes y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de esta revisión solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de un registro de revisión independiente por pares de este artículo ni de modelos originales, experimentos clínicos o experimentos físicos propios del mismo.
Primera publicación: un estudio temático en profundidad de evidencia científica interdisciplinaria; conserva las fuentes de cada sección y la delimitación entre la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos que acompañan al artículo; sus leyendas especifican individualmente los supuestos y los criterios de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para repetir los cálculos · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da