
要旨
検索拡張生成は、モデルの出力を外部資料に結び付ける技術的経路を提供するが、検索が重要なエビデンスを網羅していない、エビデンス同士が矛盾する、回答が資料に制約されていない、引用が結論を支持できないといった多様な失敗がある。本稿は、検索、コンテキストの構成、生成、帰属という各段階に沿ってこれらの問題を論じ、全体の成功率を個別に介入可能な条件付き事象へと分解し、ゴールドスタンダードのエビデンス、妨害エビデンス、位置の摂動を用いた検証計画を提示する。追加した解析例は誤差の伝播を説明するものであり、現在のいかなる製品の正答率を測定したものでもない。[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
原文の英語要旨の日本語訳
検索拡張生成を、事実性を自動的に保証するものではなく、条件付き事象の連鎖として分析する。本レビューは、候補の網羅性、エビデンスの十分性、回答の整合性、引用の帰属を区別し、成功の明示的な分解を導出するとともに、検索の失敗と生成の失敗を切り分ける統制された介入を設計する。数値プロットには明示した確率の仮定を用いており、検索ベンチマークの実測値は用いていない。
1. パラメトリックメモリと外部文書はどのように役割を分担するか
LewisらのRAG研究は、生成モデルと検索可能なノンパラメトリックな文書ストアを組み合わせた。RAG-SequenceとRAG-Tokenは、検索された文書が生成にどのように関与するかについて、異なるモデル化を採用している。この仕組みによってモデルは外部テキストを利用できるが、利用可能なエビデンスの範囲は、依然として検索対象のリポジトリの内容、網羅範囲、バージョンによって決まる。モデルは検索に接続しただけで世界の完全な知識を自動的に獲得するわけではない。[1] Retrieval-Augmented Generation for Knowledge-Intensive
2. DPRが最適化するのは検索段階である
DPRはデュアルエンコーダを用いて質問と文章区間をベクトルとして表現し、類似度に基づいて候補テキストを探す。これにより、検索は文字通りの一致だけに依存しなくなるが、ベクトルの近さが単に話題の近さを表している場合もある。システムは依然として、その文章区間が同じ実体に言及しているだけなのか、それとも同じ質問に実際に答えているのか、また、内容が意味的に関連しているのか、それとも時期、地域、条件の面で適用可能なのかを区別する必要がある。[2] Dense Passage Retrieval for Open-Domain Question Answer
3. 論文の結果を忠実に再描画するには
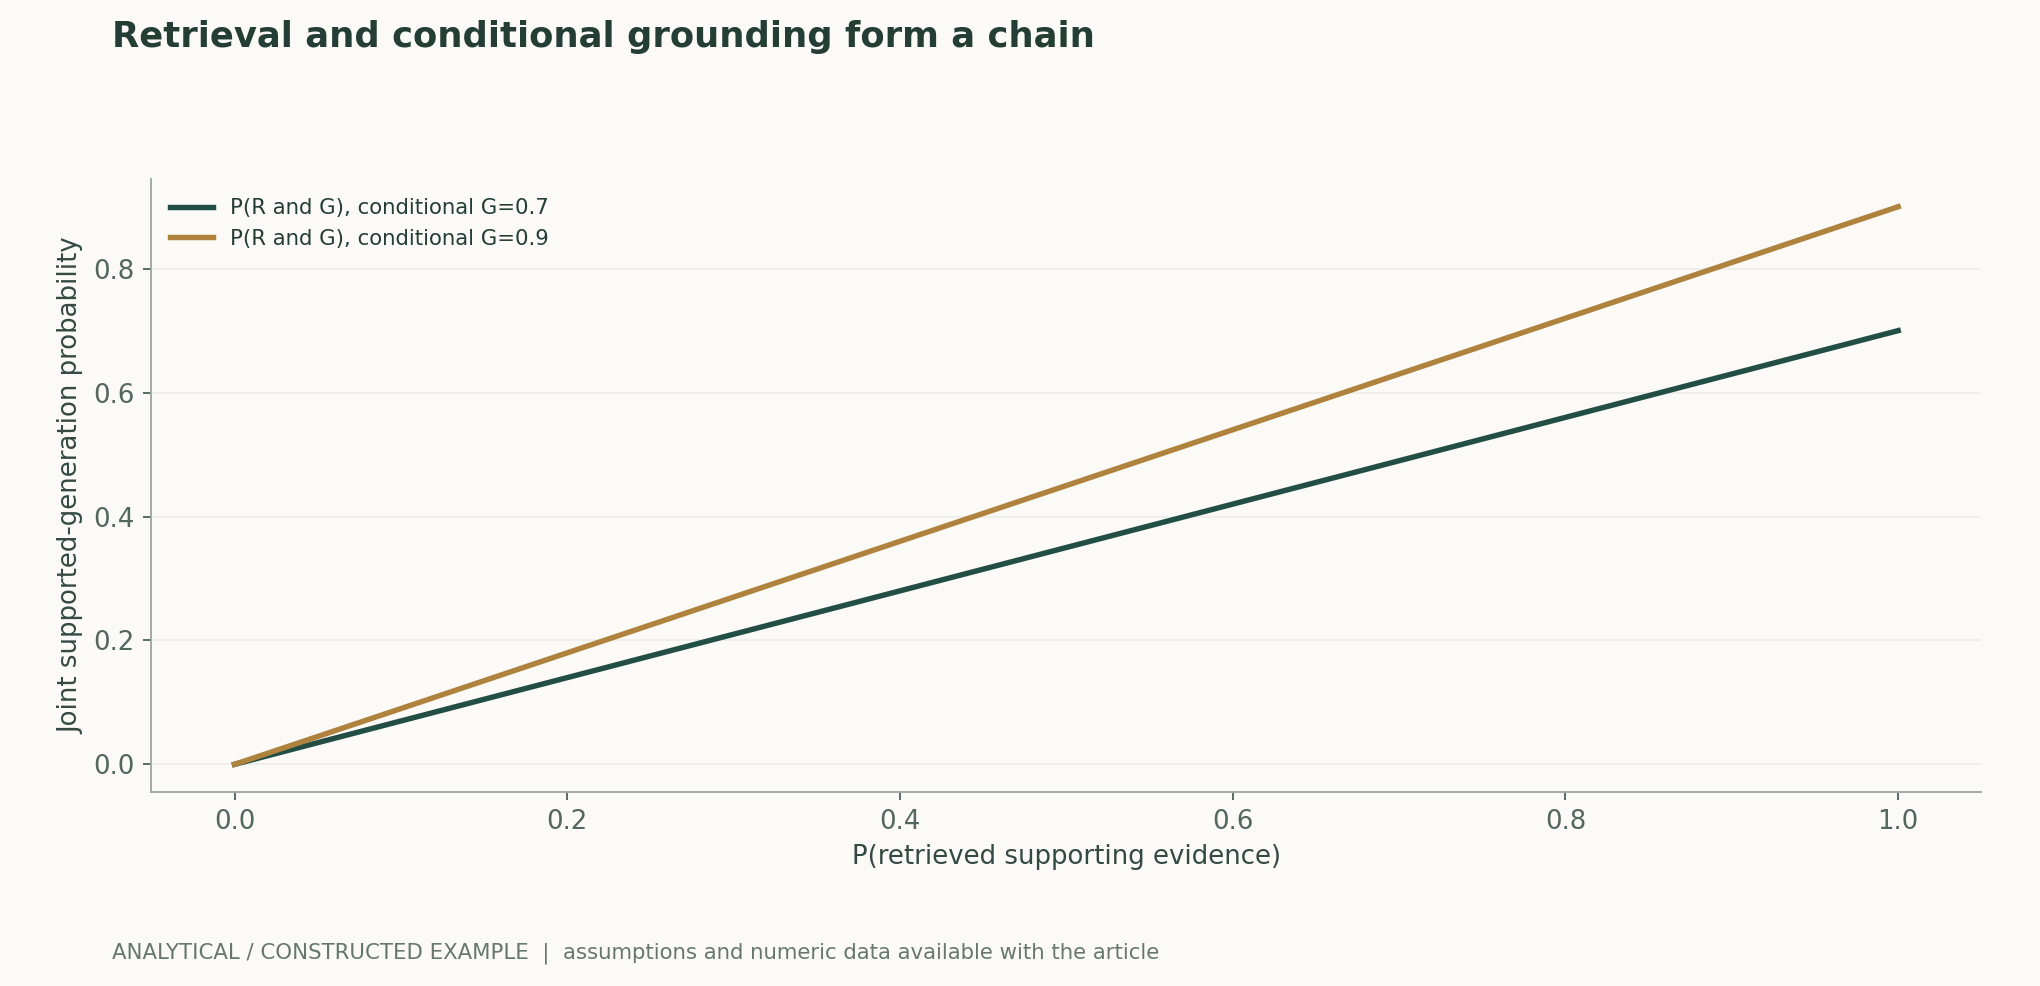
RAGの原論文の表1は、Natural QuestionsのテストにおけるDPR、RAG-Token、RAG-Sequenceの完全一致スコアを、それぞれ41.5、44.1、44.5と報告している。これは同じ過去の表に掲載されたシステム間の比較であり、学習と構成要素の違いが同時に存在するため、スコア差のすべてを単一モジュールの因果的な効果に帰することはできない。旧版ではこの表を再描画していたが、本版の図2では、支持エビデンスの連鎖に関する解析計算へ変更し、これらの過去のスコアを現在の実験として図示することはしていない。[1] Retrieval-Augmented Generation for Knowledge-Intensive
4. エビデンスをコンテキストに入れても失敗は起こりうる
Lost in the Middleは、複数文書を用いた質問応答とキー・バリュー検索の課題において、関連情報の位置が研究対象モデルの性能に影響することを観察した。この知見は、入力ウィンドウに文書を収められることと、モデルがあらゆる位置の情報を安定して利用できることは別であると示唆する。ただし、その後のすべてのモデルが同じ程度に性能低下することを証明したわけではなく、新しいモデル、プロンプト、課題については改めて測定する必要がある。[3] Lost in the Middle: How Language Models Use Long Contex
5. 引用リンクと論理的な支持は分けて検証する
回答は、誤った結論の後に正しいリンクを置くこともあれば、限定された条件下で得られた結果をすべての場合に一般化することもある。本稿は、重要な事実ごとに「主張—エビデンスの該当箇所—出典のバージョン」の対応を保存し、エビデンスが結論を実際に含意するかを確認することを推奨する。比較、日付、数値については、分母、単位、適用条件を照合すべきであり、推論については、本文中で分析であると明示すべきである。作者分析与复核建议 / Author analysis
6. 実行可能な評価の分解
まず、回答可能な質問と回答不可能な質問を含む集合を構築し、信頼できる参照回答とエビデンスの位置を保存する。候補エビデンスの再現率、最終回答の正確性、引用先の正確性、主張の支持率をそれぞれ集計し、回答の差し控えも独立に観察する。これらの指標を、定義のない単一の「正答率」にまとめてはならない。評価者が言語的な流暢さだけを見ていると、エビデンスが欠けている場合にシステムが過大な評価を受ける可能性がある。作者分析与复核建议 / Author analysis
7. 更新と矛盾をどのように記録するか
出典が改訂または撤回された場合や、機関ごとの見解・基準が矛盾する場合には、まずアクセス時刻と具体的なバージョンを保存し、次にどの見解・基準を採用したかとその理由を説明すべきである。検索結果は発見の手掛かりにすぎず、原文との照合こそが追跡可能な事実の基盤である。未確認の情報については、互いに転載し合う複数のウェブページから見かけ上の合意を作り出すのではなく、不足を説明したり結論を保留したりすることが正しい出力となりうる。作者分析与复核建议 / Author analysis
「支持」に操作的定義を与える
「ある手法があるデータセットでベースラインを上回る」という主張を例にすると、適切なエビデンスは、少なくとも手法のバージョン、データ分割、ベースライン、評価指標を示す必要がある。原文が英語のテストセットだけを評価しているなら、読解ガイドは言語の条件を省略してはならない。数値が開発セットに由来するなら、独立したテストセットの性能として書き換えてはならない。出典が支持する範囲が精密であるほど、後続の読者は、意味の異なる「性能がよい」という表現をめぐって論争するのではなく、実質的な不一致を見つけやすくなる。作者分析与复核建议 / Author analysis
8. 成功率は条件付き事象として記述し、恣意的に乗算しない
Rを検索結果に十分なエビデンスが含まれること、Gをそのエビデンス集合から正しく、かつエビデンスに支持された結論を生成することとする。同時成功率はP(R)P(G|R)であり、RとGの独立性を仮定する必要はない。後者の項を条件付き成功率として明示した場合にのみ、乗算に意味がある。検索でエビデンスを取り逃した場合でも、モデルがパラメトリックメモリに依存して正答できるなら、最終回答の正答率にはP(正答|非R)P(非R)も含まれ、エビデンスに支持された成功率と直接同一視することはできない。評価では、回答が正しいかと、帰属可能な十分なエビデンスがあるかを同時に記録し、偶然の正答を検索連鎖の信頼性として数えることを避けるべきである。[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer
9. 引用の正確性、関連性、十分性は異なる判断である
引用先が実在し、同じ話題を論じていても、直近の主張を支持しているとは限らない。文単位の帰属では、少なくとも、出典にアクセスできるか、特定された文章区間に支持情報が含まれるか、適用条件が本文に保持されているか、複数の出典が複合的な主張のすべての部分を網羅しているかを確認する必要がある。互いに矛盾する資料については、都合のよい文章区間だけを選んで矛盾を消すのではなく、対立を明示すべきである。システムは文書のバージョン、検索された抜粋、生成時に実際に参照可能だったコンテキストを保存すべきであり、最終的なリンクだけを保存しても、当時のエビデンス条件を再構成することはできない。[1] Retrieval-Augmented Generation for Knowledge-Intensive [3] Lost in the Middle: How Language Models Use Long Contex
10. 置換実験によって失敗する構成要素を特定する
質問と生成器を固定し、十分なゴールドスタンダードのエビデンス、現在の検索結果、妨害項目だけからなる集合、空のコンテキストをそれぞれ与える。ゴールドスタンダードでも失敗するなら、問題は再現率だけにとどまらない。現在の検索では失敗し、ゴールドスタンダードでは成功するなら、検索またはコンテキスト選択を優先して点検する価値がある。また、同じエビデンス集合の中で重要な文章区間の位置を移動し、長さの増加とエビデンス位置の変化を混同しないようにする必要がある。この実験は未実施の設計であり、実際の入力、モデルのバージョン、出力を記録して初めて、各段階の実測差を報告できる。[2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
11. インデックスの更新も再現可能性の一部である
検索結果は、クロール、分割、重複除去、埋め込みモデル、近傍探索インデックスの変化に伴って変わる。同じ言語モデルが同じ質問に異なる回答を出したとしても、生成器が変化したことを必ずしも意味しない。完全な検証には、インデックスのスナップショットまたは再構築可能な一覧、チャンク分割規則、文書の日時、ランキング設定が必要であり、文書の削除や訂正がどのように伝播するかも記録すべきである。時間に敏感な質問では、アクセス可能性と事実の有効日も別々に保存しなければならない。重複除去は繰り返し提示される機会を減らすが、出典の品質や矛盾に関する判断の代わりにはならない。[4] Deduplicating Training Data Makes Language Models Bette[1] Retrieval-Augmented Generation for Knowledge-Intensive
主要な数式と導出
(1) Rは十分なエビデンスがコンテキストに入ること、Gはその条件下で正しく、かつエビデンスに支持された回答が得られることを表す。図の条件付き確率は仮に設定したものであり、検索の改善が後段のボトルネックによって制約されうることを示すために用いている。
LaTeX
P(R\cap G)=P(R)\,P(G\mid R)(2) Aは回答が正しいことだけを表す。パラメトリックメモリや推測によって、検索されたエビデンスがない回答でも正答する場合があるため、最終的な正答率はエビデンス連鎖の完全性の代替指標にはならない。
LaTeX
P(A)=P(A\mid R)P(R)+P(A\mid \neg R)P(\neg R)(3) 計数単位は事前に定めるべきであり、複合的な主張は分割し、アノテーションの不一致を記録する必要がある。分母やアノテーション指針が変わる場合、この比率を実験間で直接比較することはできない。
LaTeX
\mathrm{Coverage}=\frac{\#\{\text{有充分证据支持的可核查主张}\}}{\#\{\text{全部可核查主张}\}}方法とエビデンスの流れ
解析図と数値例
再計算可能な例題
支持エビデンスの検索率が0.8で、検索成功後の根拠に基づく生成率が0.9である場合、同時成功率は0.72となる。これは全回答の正答率とは等しくない。エビデンスがない場合の推測による正答や、エビデンスがある場合の誤答は、別途集計する必要がある。
方法の比較
| 方法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 最終回答のみを評価する | エビデンスの十分性と生成入力を併せて記録する | エビデンスなしの正答が検索漏れを隠す可能性がある |
| Recall@kのみを測定する | コーパス、関連性のアノテーション、十分なエビデンスの定義を固定する | 関連する文章区間の取得は結論全体の支持を保証しない |
| 引用リンクだけを数える | 主張ごとにバージョン、該当位置、適用条件を照合する | リンクの存在は帰属の成立を意味しない |
| 長いコンテキストによる強化 | エビデンス集合を固定し、位置と妨害項目に摂動を加える | より多くのテキストを読み込むと、より多くの矛盾も持ち込まれる可能性がある |
検証と実験の計画
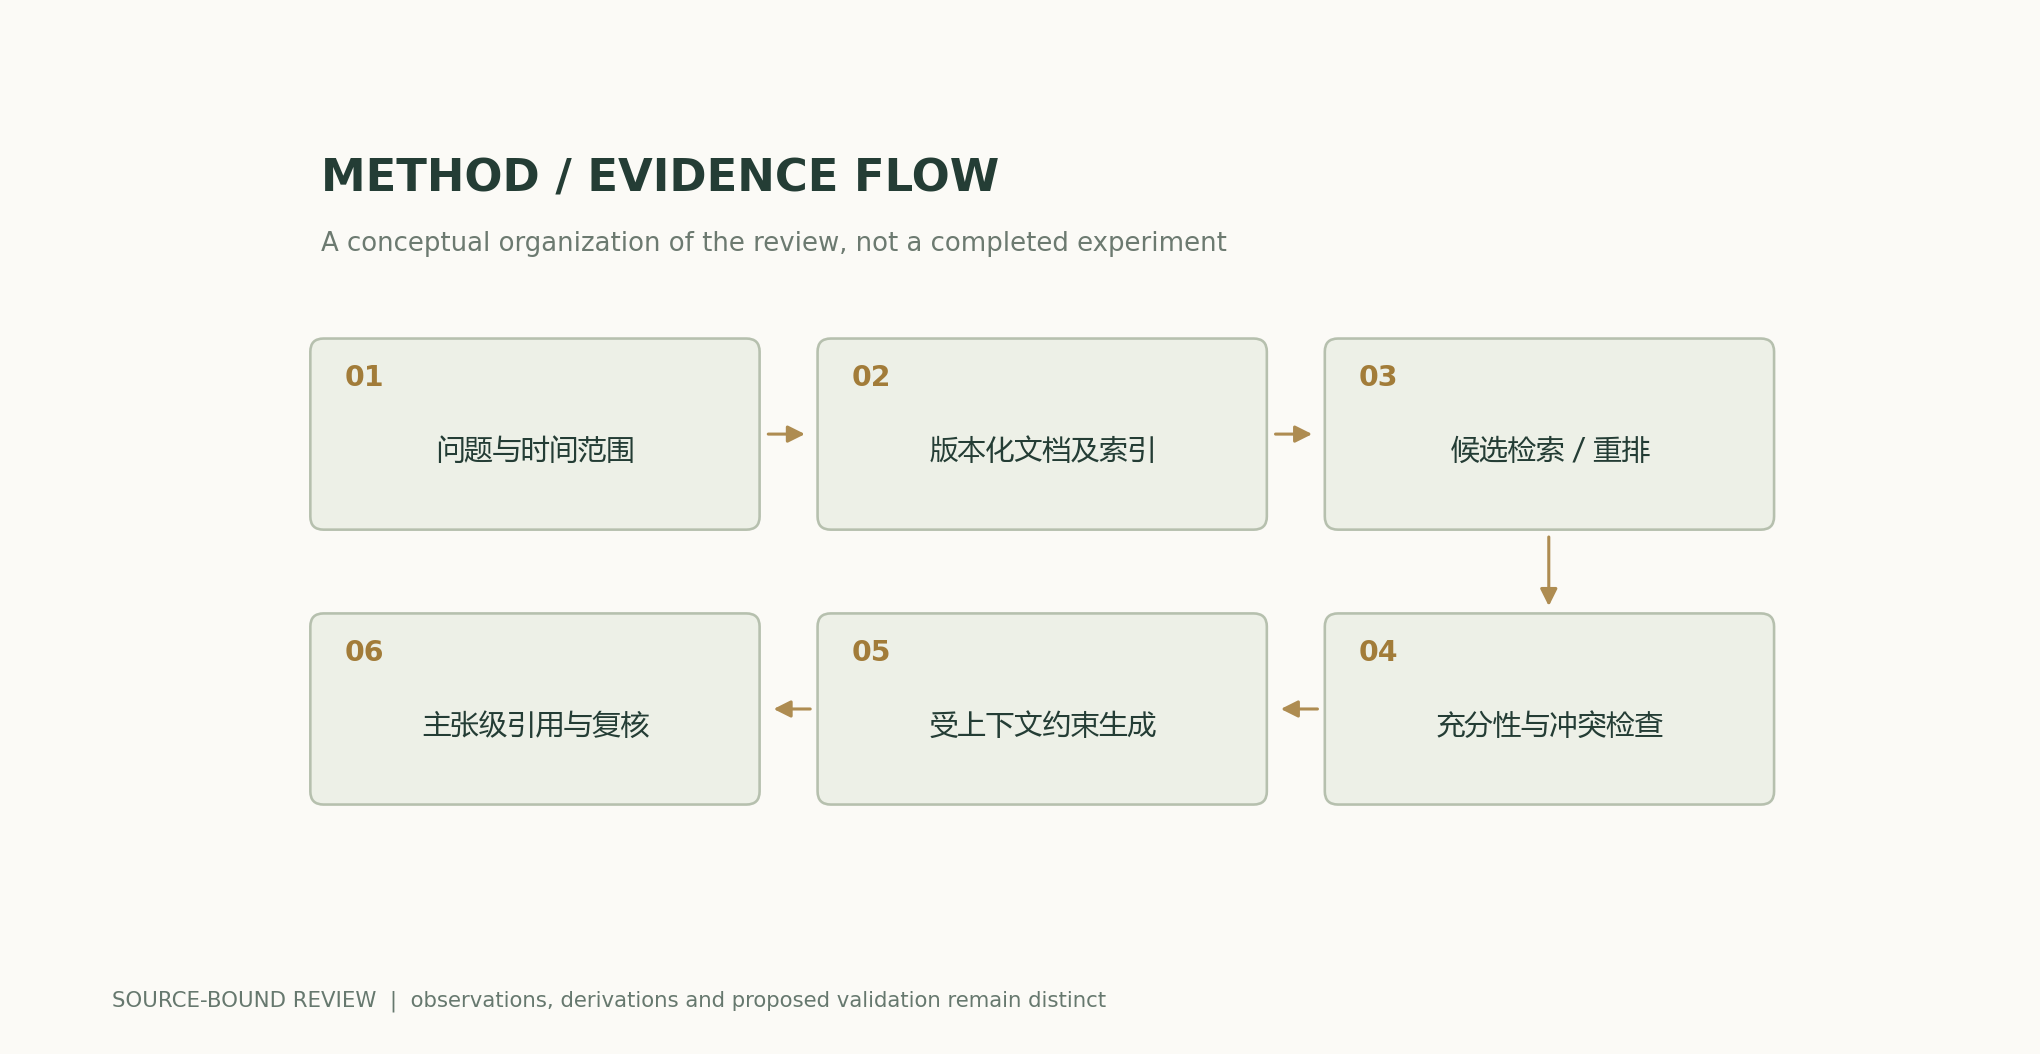
- 文書集合とインデックスのスナップショットを保存し、埋め込みモデル、分割、重複除去、近傍探索、再ランキングの設定を記録し、データの締切時点を定める。
- 各質問について、必要なエビデンスと省略できない適用条件をアノテーションする。アノテータ間の不一致は別途記録して保存する。
- ゴールドスタンダード、実際の検索結果、妨害項目、空のコンテキストをそれぞれ用い、生成器とサンプリング予算を一定に保つ。
- 同じ重要エビデンスをコンテキスト内の異なる位置に置き、全長を統制して、位置効果と情報量の変化を区別する。
- 回答の正確性、支持の十分性、引用箇所の特定、矛盾の開示を分けて評価し、複数の次元を不透明な単一スコアに圧縮しない。
- 出典の訂正または削除後に同じ要求を再実行し、無効になったエビデンスが古いインデックスやキャッシュから密かに提供され続けないことを確認する。
適用範囲と限界
- 十分なエビデンスのアノテーションは課題と分野に依存する。
- 確率曲線は条件付き事象の解析的な説明にすぎない。
- 検索システムは原資料の真実性を自動的に検証するものではない。
- 新たな検索ベンチマークやモデル比較の成績は提示していない。
一次資料と主張の対応
- Retrieval-Augmented Generation for Knowledge-Intensive NLP TasksLewis et al. · 2020-05-22v4; section 2 and Table 1
- Dense Passage Retrieval for Open-Domain Question AnsweringKarpukhin et al. · 2020-11EMNLP 2020 abstract and paper
- Lost in the Middle: How Language Models Use Long ContextsLiu et al. · 2023-07-06v3 abstract; multi-document QA and key-value retrieval
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿の独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合も、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学的な図解は区別している。科学図は公開された数式と明示した仮定に基づいて計算し、原論文の結果にはすべて帰属先を明記している。
著者、バージョン、訂正の履歴 · /guides/rag-evidence-chain/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソースの改訂版: 6251a250b27bb8b449f59b392f81abd355383770