
Resumen
La generación aumentada por recuperación ofrece una vía técnica para conectar las salidas de los modelos con materiales externos, pero presenta múltiples modos de fallo: la recuperación puede no cubrir evidencia clave, las evidencias pueden contradecirse, las respuestas pueden no quedar restringidas por los materiales y las citas pueden no respaldar las conclusiones. Esta revisión aborda estos problemas a lo largo de las etapas de recuperación, organización del contexto, generación y atribución; descompone la tasa global de éxito en sucesos condicionales sobre los que se puede intervenir por separado; y propone un protocolo de verificación con evidencia de referencia, evidencia distractora y perturbaciones de posición. Los ejemplos analíticos añadidos explican la propagación de errores; no miden la exactitud de ningún producto actual.[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
Traducción del resumen original en inglés
La generación aumentada por recuperación se analiza como una cadena de sucesos condicionales, en lugar de una garantía automática de veracidad factual. La revisión distingue la cobertura de candidatos, la suficiencia de la evidencia, la coherencia de la respuesta y la atribución de citas; deriva una descomposición explícita del éxito; y diseña intervenciones controladas que aíslan los fallos de recuperación de los de generación. Los gráficos numéricos utilizan supuestos probabilísticos declarados, no mediciones de pruebas de referencia de recuperación.
1. Cómo se reparten las funciones la memoria paramétrica y los documentos externos
El estudio sobre RAG de Lewis y sus colaboradores combinó un modelo generativo con un repositorio documental no paramétrico que permite la recuperación. RAG-Sequence y RAG-Token emplean formas distintas de modelar cómo participan los documentos recuperados en la generación. Este mecanismo permite al modelo utilizar texto externo, pero el contenido, la cobertura y la versión del repositorio de recuperación siguen delimitando la evidencia disponible; conectar un modelo a un sistema de recuperación no le proporciona automáticamente un conocimiento completo del mundo.[1] Retrieval-Augmented Generation for Knowledge-Intensive
2. DPR optimiza la etapa de recuperación
DPR utiliza un codificador dual para representar preguntas y pasajes como vectores y buscar textos candidatos según su similitud. Así, la recuperación deja de depender exclusivamente de la coincidencia literal, pero la proximidad vectorial puede reflejar solo cercanía temática. El sistema aún debe distinguir si un pasaje menciona la misma entidad o realmente responde a la misma pregunta, y si su contenido es semánticamente pertinente o aplicable en cuanto al tiempo, la región y las condiciones.[2] Dense Passage Retrieval for Open-Domain Question Answer
3. Cómo volver a representar fielmente los resultados publicados
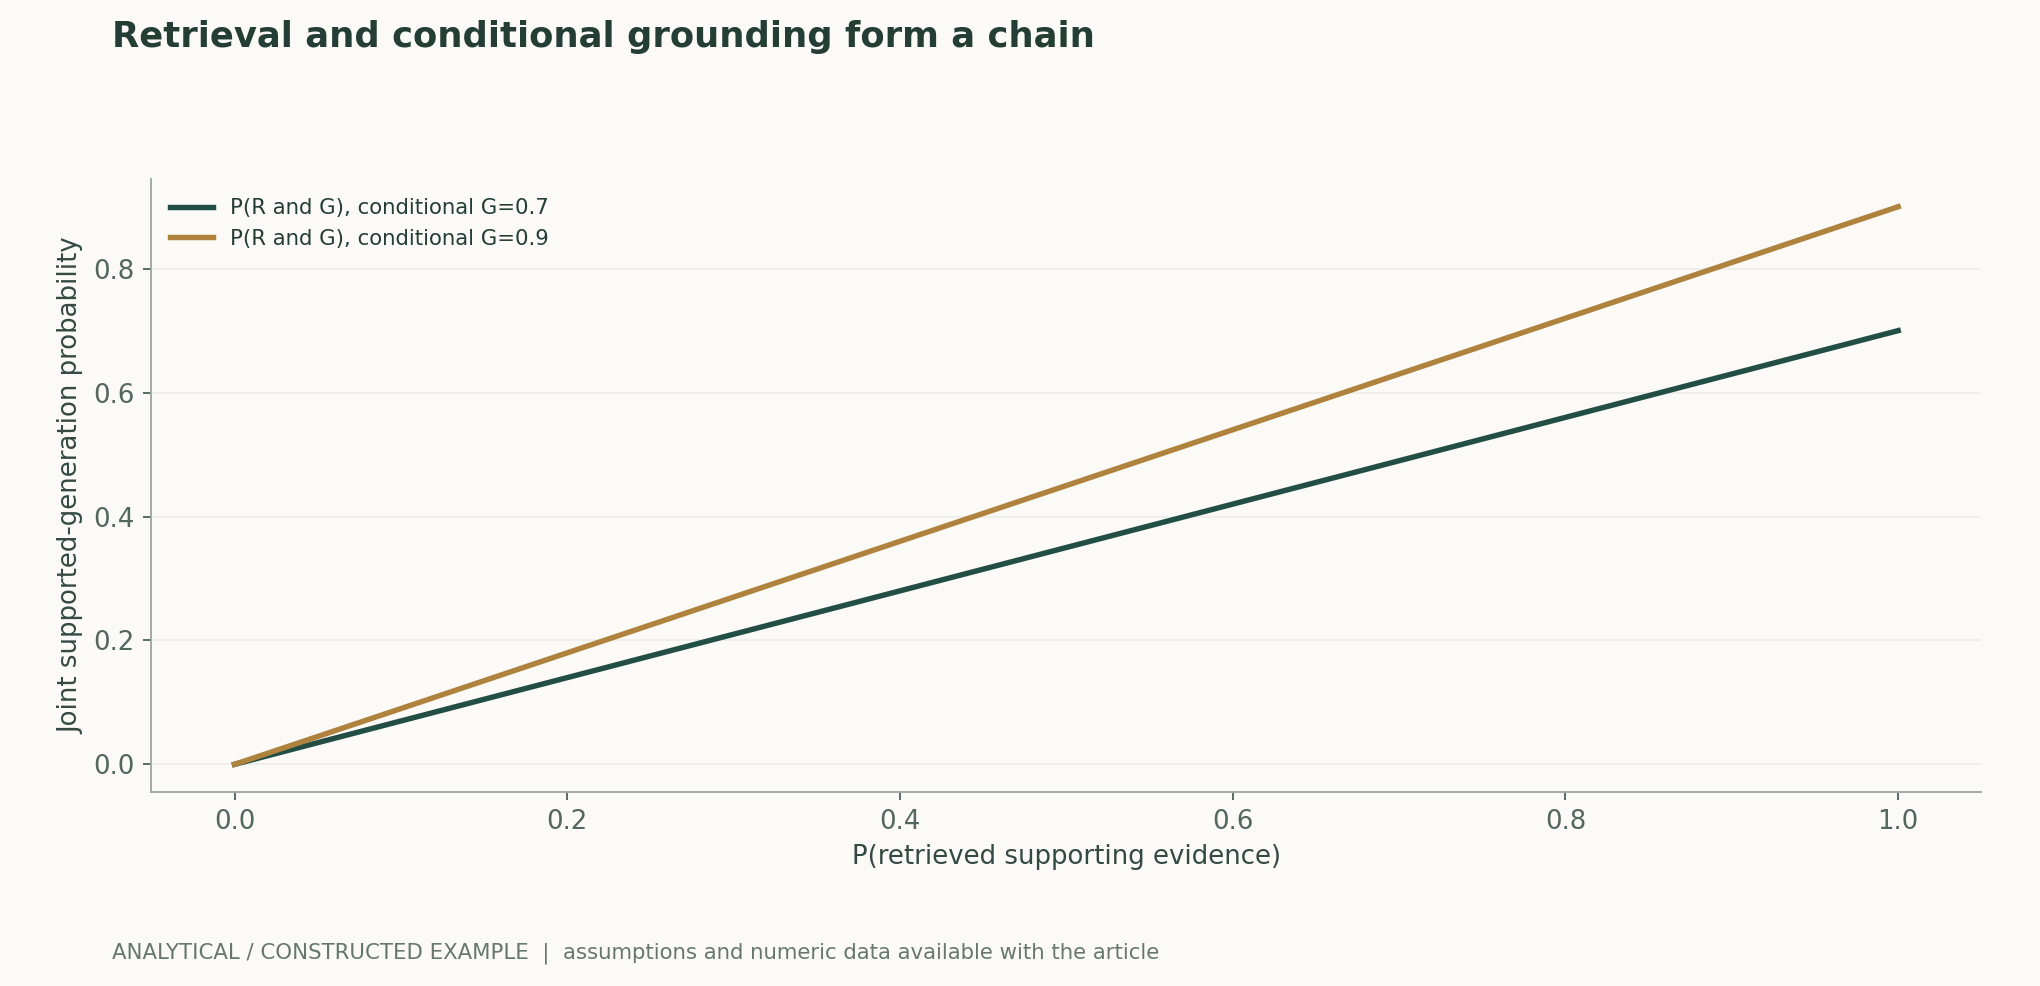
La tabla 1 del artículo original de RAG informa de puntuaciones de coincidencia exacta de 41.5, 44.1 y 44.5 para DPR, RAG-Token y RAG-Sequence, respectivamente, en la prueba de Natural Questions. Se trata de una comparación entre sistemas incluidos en una misma tabla histórica, con diferencias simultáneas de entrenamiento y componentes; no puede atribuirse toda la diferencia de puntuación al beneficio causal de un único módulo. Una versión anterior volvió a representar esa tabla; en esta versión, la figura 2 se sustituye por un cálculo analítico de la cadena de evidencias de respaldo y ya no presenta esas puntuaciones históricas como un experimento actual.[1] Retrieval-Augmented Generation for Knowledge-Intensive
4. Incluir evidencia en el contexto no impide todos los fallos
Lost in the Middle observó, en tareas de respuesta a preguntas con múltiples documentos y de recuperación de pares clave-valor, que la posición de la información pertinente afectaba al rendimiento de los modelos estudiados. Este hallazgo recuerda que alojar documentos en una ventana de entrada y utilizar de forma estable la información en todas sus posiciones son capacidades distintas. No demostró que todos los modelos posteriores se deterioren en la misma magnitud; los modelos, las instrucciones y las tareas nuevos requieren nuevas mediciones.[3] Lost in the Middle: How Language Models Use Long Contex
5. Los enlaces de las citas y el respaldo lógico deben verificarse por separado
Una respuesta puede colocar un enlace correcto tras una conclusión incorrecta, o extender a todos los casos un resultado sujeto a condiciones limitadas. Esta revisión recomienda conservar, para cada hecho clave, una correspondencia «afirmación—ubicación del fragmento de evidencia—versión de la fuente» y comprobar si la evidencia implica realmente la conclusión. En comparaciones, fechas y cifras deben verificarse los denominadores, las unidades y las condiciones de aplicabilidad; las inferencias deben identificarse explícitamente como análisis en el texto.作者分析与复核建议 / Author analysis
6. Una descomposición ejecutable de la evaluación
Primero se debe construir un conjunto que incluya preguntas que puedan responderse y otras que no, conservando respuestas de referencia fiables y las ubicaciones de la evidencia. Se deben medir por separado la exhaustividad de la evidencia candidata, la corrección de la respuesta final, la corrección del destino de las citas y la proporción de afirmaciones respaldadas, y examinar aparte la abstención. No deben combinarse estas métricas en una «exactitud» indefinida. Si los evaluadores solo consideran la fluidez lingüística, el sistema puede recibir puntuaciones excesivas cuando falta evidencia.作者分析与复核建议 / Author analysis
7. Cómo registrar actualizaciones y contradicciones
Cuando se revisan o retractan fuentes, o discrepan los criterios de distintas instituciones, primero deben conservarse la fecha y hora de acceso y la versión concreta, y después explicarse qué criterio se adopta y por qué. Los resultados de recuperación son únicamente pistas para descubrir información; la comprobación del texto original es la base de los hechos trazables. Para información aún no confirmada, la salida correcta puede consistir en explicar la laguna o aplazar la conclusión, en vez de construir un consenso aparente a partir de varias páginas web que se reproducen entre sí.作者分析与复核建议 / Author analysis
Dar una definición operativa al «respaldo»
Para una afirmación como «un método supera a una referencia en un conjunto de datos», la evidencia adecuada debe especificar al menos la versión del método, la partición de los datos, la referencia y la métrica de evaluación. Si el artículo original solo evaluó un conjunto de prueba en inglés, la guía de lectura no puede omitir la condición lingüística; si las cifras proceden de un conjunto de desarrollo, no pueden reformularse como rendimiento en un conjunto de prueba independiente. Cuanto más preciso sea el alcance del respaldo de la fuente, más fácil resultará para los lectores posteriores identificar desacuerdos reales, en lugar de discutir sobre varias expresiones de «mejor rendimiento» con significados distintos.作者分析与复核建议 / Author analysis
8. Las tasas de éxito deben formularse como sucesos condicionales, no multiplicarse arbitrariamente
Sea R el suceso de que los resultados de recuperación contienen evidencia suficiente, y G el de generar una conclusión correcta y respaldada a partir de ese conjunto de evidencias. La tasa conjunta de éxito es P(R)P(G|R), sin necesidad de suponer que R y G sean independientes. La multiplicación solo tiene sentido si el segundo término se define explícitamente como una tasa de éxito condicional. Si, cuando falla la recuperación, el modelo todavía puede responder correctamente mediante su memoria paramétrica, la tasa de corrección de la respuesta final también incluye P(correcta|no R)P(no R) y no puede equipararse directamente con la tasa de éxito respaldado por evidencia. La evaluación debe registrar tanto si la respuesta es correcta como si existe evidencia suficiente y atribuible, para evitar considerar un acierto fortuito como prueba de fiabilidad de la cadena de recuperación.[1] Retrieval-Augmented Generation for Knowledge-Intensive [2] Dense Passage Retrieval for Open-Domain Question Answer
9. La corrección, la pertinencia y la suficiencia de una cita son juicios distintos
Una cita puede existir realmente y tratar el mismo tema sin respaldar la afirmación inmediatamente contigua. La atribución a nivel de oración exige comprobar, como mínimo, si la fuente es accesible, si el pasaje localizado contiene información de respaldo, si el texto conserva las condiciones de aplicabilidad y si las distintas fuentes cubren todas las partes de una afirmación compuesta. Las contradicciones entre materiales deben exponerse explícitamente, en lugar de eliminarse seleccionando solo un pasaje conveniente. El sistema debe conservar las versiones de los documentos, los fragmentos recuperados y el contexto realmente visible durante la generación; guardar únicamente el enlace final no permite reconstruir las condiciones de evidencia de aquel momento.[1] Retrieval-Augmented Generation for Knowledge-Intensive [3] Lost in the Middle: How Language Models Use Long Contex
10. Localizar componentes que fallan mediante experimentos de sustitución
Manteniendo constantes la pregunta y el generador, se proporcionan por separado evidencia de referencia suficiente, los resultados actuales de recuperación, un conjunto formado solo por distractores y un contexto vacío. Fallar incluso con evidencia de referencia indica que el problema no se limita a la exhaustividad; fallar con la recuperación actual y tener éxito con la evidencia de referencia indica que conviene inspeccionar prioritariamente la recuperación o la selección del contexto. También deben desplazarse los pasajes clave dentro del mismo conjunto de evidencias para no confundir el aumento de longitud con cambios de posición de la evidencia. Este experimento es un diseño pendiente de ejecución; solo pueden comunicarse diferencias medidas entre etapas después de registrar las entradas reales, las versiones de los modelos y las salidas.[2] Dense Passage Retrieval for Open-Domain Question Answer[3] Lost in the Middle: How Language Models Use Long Contex
11. La actualización del índice también forma parte de la reproducibilidad
Los resultados de recuperación varían con los cambios en el rastreo, la segmentación, la deduplicación, el modelo de representaciones vectoriales y el índice de vecinos más cercanos. Obtener respuestas distintas a la misma pregunta con el mismo modelo de lenguaje no implica necesariamente que haya cambiado el generador. Una verificación completa requiere una instantánea del índice o un manifiesto que permita reconstruirlo, reglas de fragmentación, fechas de los documentos y configuraciones de ordenación; también debe registrarse cómo se propagan las eliminaciones y correcciones de documentos. En preguntas sensibles al tiempo, la accesibilidad y las fechas de validez de los hechos también deben conservarse por separado. La deduplicación reduce la exposición repetida, pero no sustituye la evaluación de la calidad de las fuentes y sus contradicciones.[4] Deduplicating Training Data Makes Language Models Bette[1] Retrieval-Augmented Generation for Knowledge-Intensive
Ecuaciones fundamentales y derivaciones
(1) R indica que entra evidencia suficiente en el contexto, y G indica que se obtiene una respuesta correcta y respaldada bajo esa condición. Las probabilidades condicionales de la figura se fijan de manera hipotética para mostrar cómo las mejoras de recuperación pueden verse limitadas por cuellos de botella posteriores.
LaTeX
P(R\cap G)=P(R)\,P(G\mid R)(2) A solo indica que la respuesta es correcta. La memoria paramétrica o una conjetura pueden producir una respuesta correcta incluso sin evidencia recuperada; por ello, la tasa final de corrección no sustituye la integridad de la cadena de evidencias.
LaTeX
P(A)=P(A\mid R)P(R)+P(A\mid \neg R)P(\neg R)(3) La unidad de recuento debe definirse de antemano; las afirmaciones compuestas deben dividirse y deben registrarse los desacuerdos de anotación. Si cambian los denominadores y las directrices de anotación, esta proporción no puede compararse directamente entre experimentos.
LaTeX
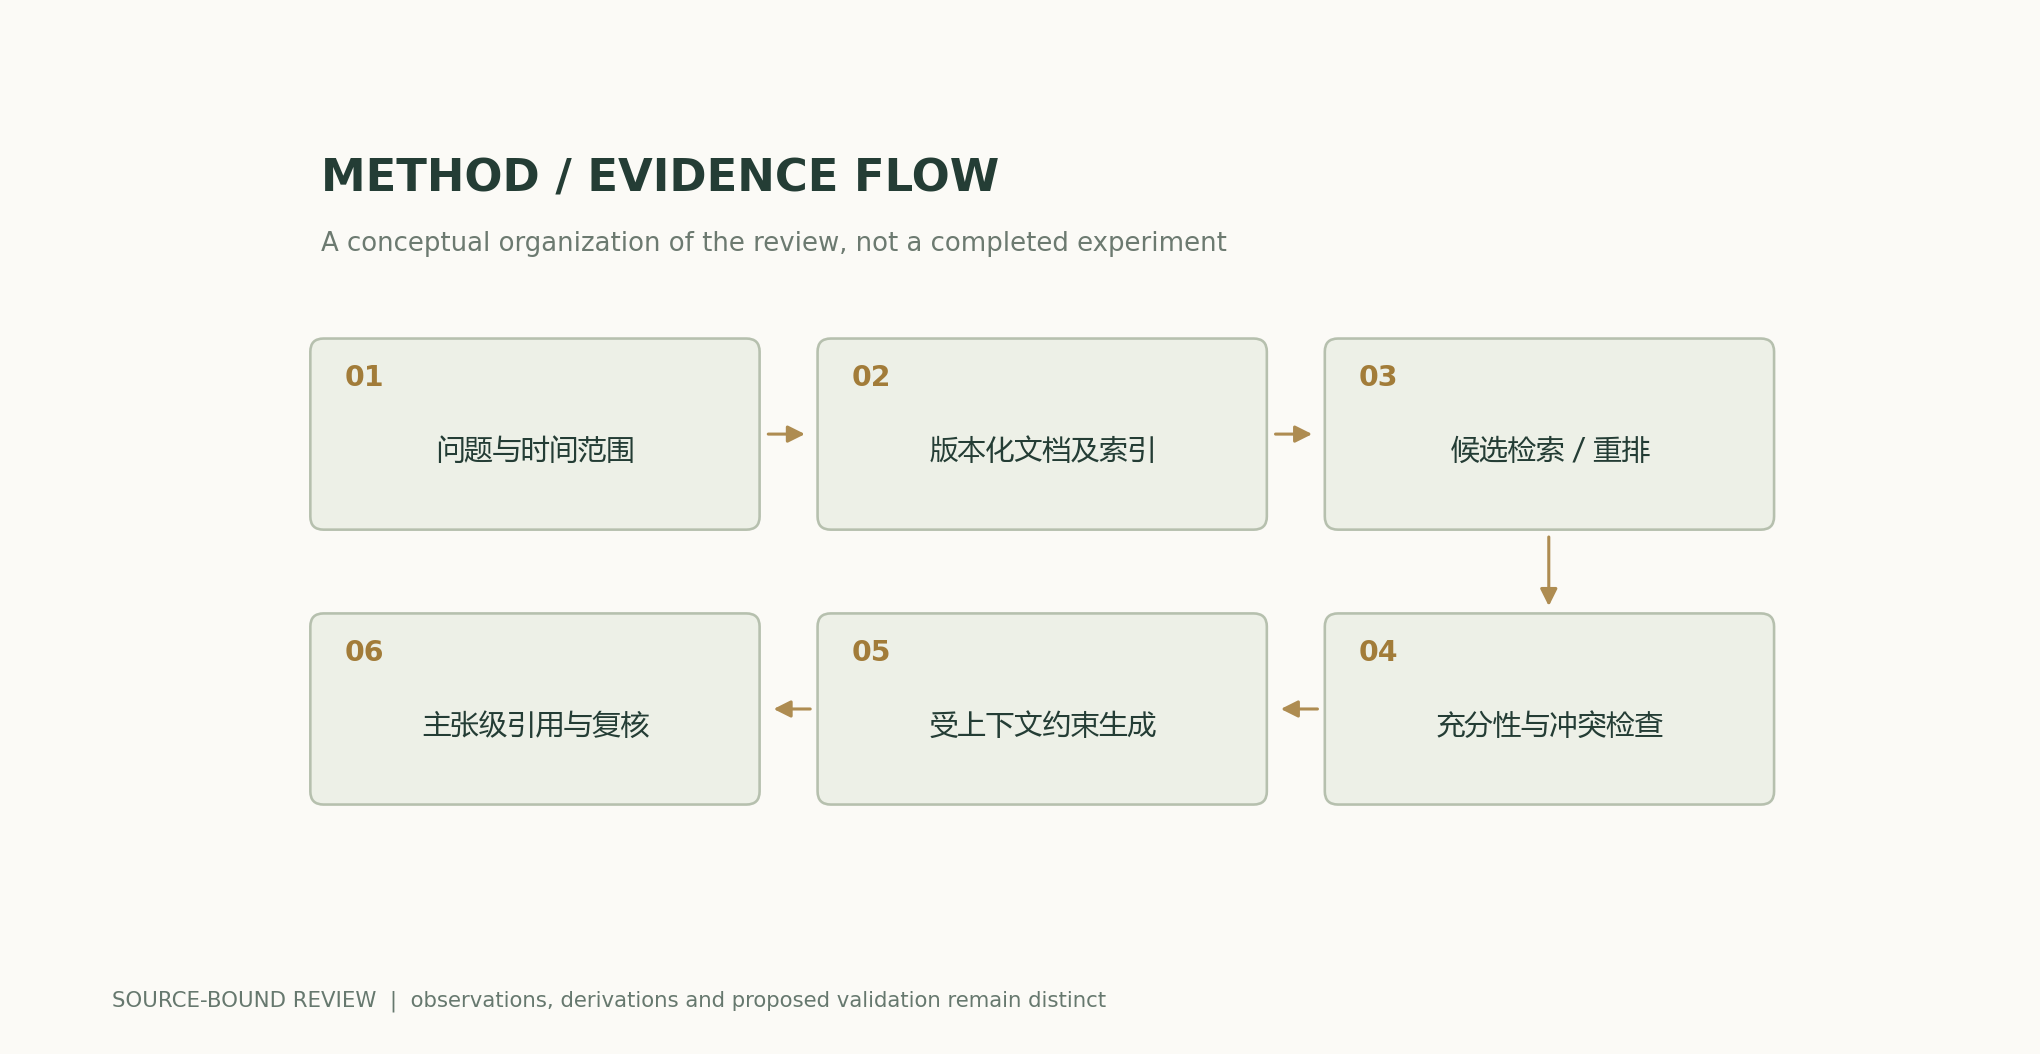
\mathrm{Coverage}=\frac{\#\{\text{有充分证据支持的可核查主张}\}}{\#\{\text{全部可核查主张}\}}Flujo del método y de la evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Si la tasa de recuperación de evidencia de respaldo es 0.8 y la tasa de generación fundamentada tras una recuperación exitosa es 0.9, la tasa conjunta es 0.72. Esto no equivale a la exactitud de todas las respuestas; los aciertos por conjetura sin evidencia y los errores pese a disponer de evidencia deben contabilizarse por separado.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Evaluar únicamente la respuesta final | Registrar tanto la suficiencia de la evidencia como las entradas de generación | Responder correctamente sin evidencia puede ocultar omisiones de recuperación |
| Medir únicamente Recall@k | Fijar el corpus, las anotaciones de pertinencia y la definición de evidencia suficiente | Recuperar pasajes pertinentes no garantiza el respaldo de toda la conclusión |
| Contar únicamente los enlaces de las citas | Verificar la versión, la ubicación y las condiciones de aplicabilidad de cada afirmación | La existencia de un enlace no demuestra la validez de la atribución |
| Mejora mediante contexto largo | Fijar el conjunto de evidencias y perturbar las posiciones y los distractores | Leer más texto también puede introducir más contradicciones |
Protocolo de verificación y experimentación
- Conservar la colección de documentos y una instantánea del índice; registrar el modelo de representaciones vectoriales y las configuraciones de segmentación, deduplicación, búsqueda de vecinos más cercanos y reordenación; establecer una fecha límite de los datos.
- Anotar, para cada pregunta, la evidencia necesaria y las condiciones de aplicabilidad que no pueden omitirse; archivar por separado los desacuerdos entre anotadores.
- Utilizar por separado contextos de referencia, de recuperación real, de distractores y vacíos, manteniendo constantes el generador y el presupuesto de muestreo.
- Colocar la misma evidencia clave en distintas posiciones del contexto y controlar la longitud total para distinguir los efectos de posición de los cambios en la cantidad de información.
- Evaluar por separado la corrección de la respuesta, la suficiencia del respaldo, la localización de las citas y la revelación de contradicciones, sin comprimir múltiples dimensiones en una puntuación opaca.
- Volver a ejecutar la misma solicitud tras corregir o eliminar una fuente, para confirmar que un índice antiguo o una caché no siguen suministrando silenciosamente evidencia invalidada.
Ámbito de aplicación y limitaciones
- La anotación de evidencia suficiente depende de la tarea y del ámbito.
- Las curvas de probabilidad son únicamente ilustraciones analíticas de sucesos condicionales.
- Los sistemas de recuperación no verifican automáticamente la veracidad de las fuentes originales.
- No se aportan nuevas pruebas de referencia de recuperación ni puntuaciones comparativas de modelos.
Correspondencia entre fuentes primarias y afirmaciones
- Retrieval-Augmented Generation for Knowledge-Intensive NLP TasksLewis et al. · 2020-05-22v4; section 2 and Table 1
- Dense Passage Retrieval for Open-Domain Question AnsweringKarpukhin et al. · 2020-11EMNLP 2020 abstract and paper
- Lost in the Middle: How Language Models Use Long ContextsLiu et al. · 2023-07-06v3 abstract; multi-document QA and key-value retrieval
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag permanece igual. El cuerpo del texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/rag-evidence-chain/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770