
要旨
RNAの配列、塩基対形成、三次元配座、機能の間には多層的な対応関係が存在する。豊富な配列データと比較的少ない構造データの隔たりが、基盤モデルを魅力的なものにしている。本稿ではRhoFold+、RiNALMo、生体分子の統合モデリングを比較し、二次構造、三次構造の幾何、条件依存的な配座アンサンブルを区別する。二状態平衡と塩基対行列の制約を導出し、単一の高スコア構造では溶液中のすべての状態を代表できず、機能も証明できないことを示す。図には実在するRNAの予測や実験データは含まれない。本稿が提示するのは、再計算可能な分析とファミリー外検証の枠組みである。[1] Accurate RNA 3D structure prediction using a language m[2] RiNALMo: General-Purpose RNA Language Models Can Genera[3] Accurate structure prediction of biomolecular interacti
原文英語要旨の日本語訳
RNA言語モデルは豊富な配列を活用する一方、実験的に決定された三次元構造は依然として比較的限られている。本稿ではRhoFold+、RiNALMo、生体分子の統合予測を検討し、配列表現、二次構造の塩基対形成、三次構造の幾何、配座アンサンブルを区別する。二状態の熱力学的な例と塩基対行列の制約により、信頼度の高い単一構造が溶液中の挙動を必ずしも捉えない理由を示す。すべての数値例は解析的なものであり、実在するRNAの予測でも、機能のエビデンスでもない。
1. 配列の事前学習は統計的構造を提供するが、完全な三次元の真値を直接提供するわけではない
RhoFold+はRNAの言語表現を組み込んで一本鎖の三次元構造を予測するのに対し、RiNALMoは汎用的なRNA表現と構造などの下流タスクを研究する。両者は、大量のラベルなし配列が構造の問題に情報を与えうることを示している。しかし、配列コーパスの規模は独立した三次元構造の数ではなく、RNAのすべてのファミリーの網羅を意味するわけでもない。本稿では、配列の出典、相同性に基づく重複除去、構造教師データの集合をそれぞれ記録することを提案する。テスト対象のファミリーが事前学習に含まれていた場合、結論では構造ラベルを用いない転移と、完全に未見のファミリーへの外挿を区別すべきであり、一括してゼロショット発見と呼ぶべきではない。[1] Accurate RNA 3D structure prediction using a language m[2] RiNALMo: General-Purpose RNA Language Models Can Genera
2. 塩基対グラフと三次元座標では制約が異なる
二次構造は通常、塩基対関係によって表現されるが、三次構造にはさらに骨格、スタッキング、長距離接触、局所的な化学幾何が必要となる。塩基対を正しく予測するモデルが正しい空間的な折りたたみを復元できるとは限らず、逆に全体の座標が近くても局所的な塩基対誤りが隠れている場合がある。本稿では、塩基対の適合率と再現率、局所幾何、長距離接触、全体の重ね合わせを個別に評価し、使用する原子と対称性の対応付けを明示することを提案する。異なるタスクのスコアをそのまま平均して「RNA正解率」とすることはできない。長さ、柔軟性、構造の欠損に対する感度が異なるためである。[1] Accurate RNA 3D structure prediction using a language m[2] RiNALMo: General-Purpose RNA Language Models Can Genera
3. 本稿の導出:塩基対行列には構造的制約が必要である
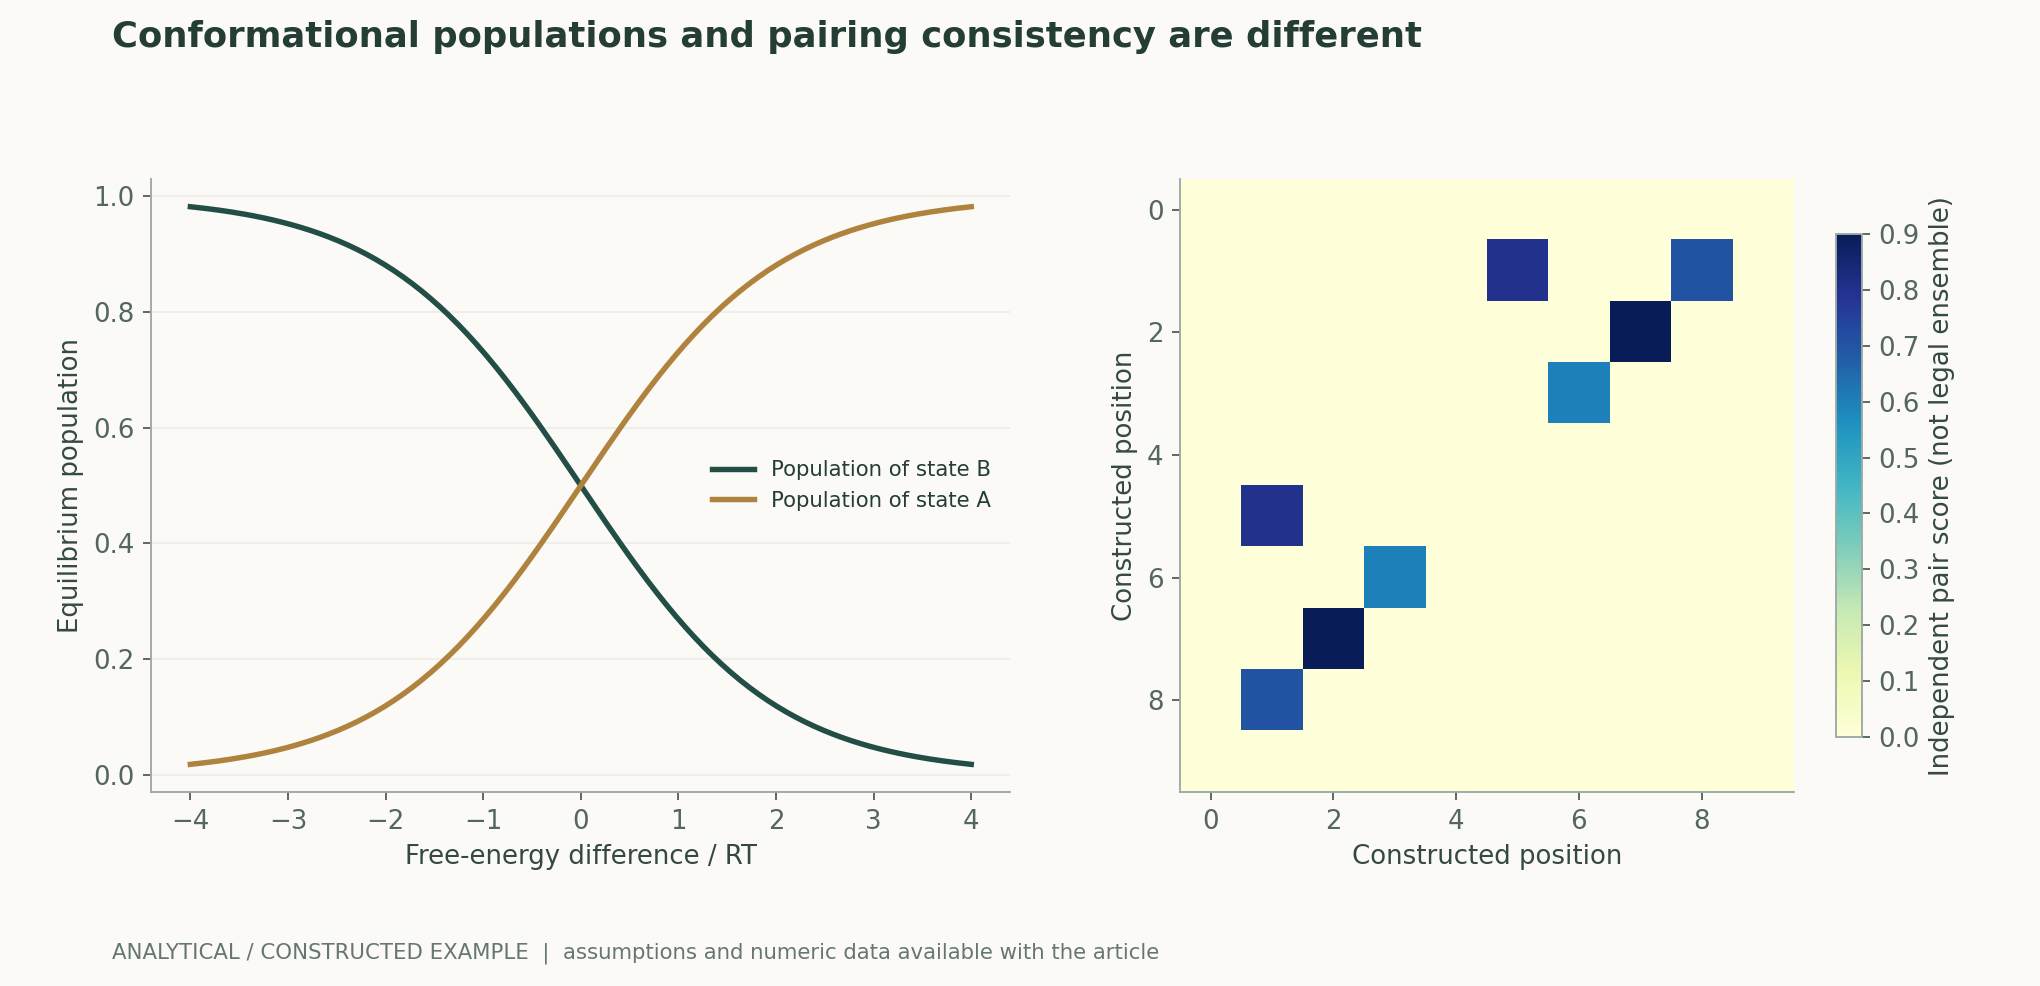
Pijを位置iとjが塩基対を形成する周辺確率とする。基本的な制約には、対称性、対角成分がゼロであること、そして単一の相手との塩基対形成を仮定する簡略化モデルでは各行和が一を超えないことが含まれる。各対を独立に分類するだけではこれらの制約に違反する可能性があり、事後的なデコーディングは元のスコア順位を変える場合がある。本稿では小さな塩基対行列を用い、高確率の二つの候補が同じ位置を取り合う例を示すことで、周辺的に最適な選択の組合せが必ずしも全体として妥当にならないことを説明する。実際のRNAには非標準的な相互作用も存在するため、単一相手の塩基対制約はタスクの定義であり、すべての三次元相互作用に普遍的な法則として誤記すべきではない。作者分析与复核建议 / Author analysis
4. シュードノットは逐次的な分解と空間的な折りたたみの関係を複雑にする
配列軸上で塩基対を表す弧が交差すると、単純な入れ子構造では表現できない関係が生じうる。本稿では、評価前にシュードノット、非標準塩基対、複数鎖間の相互作用を許容するかどうかを明示すべきだと考える。入れ子構造のデコーディングのみを支持する手法が、シュードノットを持つ標的をすべて除外したうえで一般的なRNA構造の問題を解決したと主張することはできない。より豊かな構造を許容する手法も、同じ標的と資源予算で比較しなければならない。図の塩基対模式図は表現可能な範囲を説明するものであり、特定分子の実際の結合関係を表すものではない。作者分析与复核建议 / Author analysis
5. 本稿の導出:二つの妥当な配座の存在比は自由エネルギー差に応じて変化しうる
AとBの二状態だけからなる平衡系を考え、Aに対するBの自由エネルギー差をΔGとすると、Bの存在比はボルツマン比で与えられる。ΔG/(RT)を無次元の横軸とした場合、差が−2から2に変化すると、Bの存在比は約0.881から0.119へ低下する。この図はどのRNAにもフィッティングしておらず、最も確からしい構造を出力できるシステムが、無視できない存在比を持つ他の状態を見落としうることだけを示している。予測信頼度の低さと実際の配座多状態性も混同してはならない。前者はモデルの知識不足に由来する可能性があり、後者は系自体の分布の広さに由来する可能性があるため、両者には異なるエビデンスが必要となる。作者分析与复核建议 / Author analysis
6. 温度、イオン、結合相手は構造を規定する条件である
RNA構造の解釈では記述されている条件を考慮しなければならず、一本鎖の予測と、タンパク質、リガンド、他の核酸を含む統合予測は、入力の異なる問題である。AF3は多成分モデリングの範囲を拡張した一方、RhoFold+などの手法にはそれぞれ固有のタスク境界がある。本稿では、各構造についてコンストラクト、鎖、修飾、条件、相互作用相手の情報を保存することを提案する。参照構造に安定化をもたらす相手が含まれ、予測入力には含まれない場合、その差のすべてをアルゴリズムの失敗に帰すべきではない。一方、条件の違いを理由に困難な試料をすべて除去してはならず、比較可能な集合と条件情報が不完全な集合を事前に定義すべきである。[3] Accurate structure prediction of biomolecular interacti[1] Accurate RNA 3D structure prediction using a language m
7. 構造指標の柔軟性と長さに対する偏りは分析を要する
全体の重ね合わせ誤差は長い鎖のある柔軟領域に支配される場合がある一方、局所的な塩基対指標はドメイン間の配向を見落としうる。本稿では、コア、柔軟領域、長距離関係を併せて報告し、欠損原子と参照構造の不確実性に関する情報を保持することを提案する。最も安定な断片だけを選んで評価すると、完全な構造を復元する能力を過大評価しやすい。また、未解明の領域を厳密な真値として扱うことも、不合理なペナルティを生む。測定の欠損と予測誤りを分け、各評価項目の種類について、評価可能な分母を明示すべきである。作者分析与复核建议 / Author analysis
8. ファミリーによる分割は配列の無作為分割よりも転移を適切に検証できる
RiNALMoの原研究は、未見ファミリーを対象とする構造タスクでの汎化を重視している。本稿では、配列類似性、ファミリー、構造トポロジーによる層別化を併用し、学習データ内の最近傍と事前学習との重複を記録することを提案する。配列類似性が低くても、構造トポロジーが新規とは限らず、無作為分割にも多量の相同情報が含まれる可能性がある。モデル選択と閾値の決定には検証用ファミリーのみを使用し、最終テストは保留すべきである。各タスクにおける「未見」の条件を明示しなければならず、新規性の異なる程度を一つの汎化というラベルで覆うことはできない。[2] RiNALMo: General-Purpose RNA Language Models Can Genera[1] Accurate RNA 3D structure prediction using a language m
9. 本稿の分析:構造アンサンブルの検証は最良の一枚を超える必要がある
手法が複数の配座を生成する場合、参照を知った後で最も近い一つだけを選ぶのではなく、アンサンブル全体の重み、クラスタリング、選択規則を報告すべきである。アンサンブル評価では、網羅性と確率配分を別々に検証すべきであり、正しい配座を含んでいることは、正しい存在比を与えていることを意味しない。条件変化に対する予測では、複数の条件をあらかじめ固定し、独立した構造または動態に関連する観測と比較できる。測定されていない配座の重みはモデルの仮説として扱い続けなければならず、サンプリング頻度を真の熱力学的確率として直接解釈することはできない。作者分析与复核建议 / Author analysis
技術補足 A · 独立した閾値処理では塩基対制約を保証できない
位置iとj、およびiとkの周辺スコアがいずれも閾値を超えていると仮定する。それぞれを独立に採用すると、単一相手との塩基対形成タスクでiに二つの相手が割り当てられる。全体的なデコーディングでは妥当な集合の中から選択しなければならず、局所的に高いスコアを持つ対を棄却する場合がある。本稿では、性能向上が表現に由来するのか、デコーディング規則に由来するのかを調べるため、元のスコア、制約、最終的な塩基対を併せて保存することを提案する。シュードノットを許容するタスクでは妥当な集合も異なるため、範囲を明示せずに両者のデコーディング結果を直接比較してはならない。作者分析与复核建议 / Author analysis
技術補足 B · 擬似エネルギーは実験的な自由エネルギーではない
構造予測手法の中には、スコアや予測ポテンシャルを用いて配座を選択するものがある。これらのスコアは品質と相関していても、エネルギーの単位や正しい温度依存性を備えているとは限らない。これらをそのままボルツマン式に代入すると、数値的には精密でも物理的意味のない重みが得られる可能性がある。本稿の二状態図は自由エネルギー差を独立に仮定した入力として扱っており、モデル信頼度から生成していない。研究が実際のアンサンブルを再現すると主張する場合、スコアと観測の関係を独立に較正し、溶液条件とサンプリングの網羅範囲を明示する必要がある。作者分析与复核建议 / Author analysis
技術補足 C · 平均構造は実現可能な配座とは限らない
RNAが大きく離れた二つの配座の間を遷移する場合、座標の平均は局所幾何を満たさない形状を生みうる。本稿では、測定関数が一般に非線形であることから、先に座標を平均して観測量を生成するのではなく、配座アンサンブルから観測量を計算することを提案する。実験によっては時間平均または集団平均が得られるため、単一構造の参照との比較ではこの平均化の層を考慮する必要がある。モデルが最適な配座を一つしか出力しない場合には、タスクの範囲を正直に限定すべきである。サンプリングを増やす場合も、それが妥当な状態に対応することを示す必要があり、数をアンサンブルの質の代わりにすることはできない。作者分析与复核建议 / Author analysis
技術補足 D · 時間分割とファミリー分割は異なる外挿を検証する
時間に基づくホールドアウトは、新しい構造が学習前にすでに既知であったリスクを低減する。ファミリーのホールドアウトは配列および構造パターンの転移を検証し、トポロジーのホールドアウトはさらにフォールドの新規性を問う。本稿では、どれか一つを「最も厳格」として選ぶのではなく、三つの区分上の位置付けを併せて記録することを提案する。事前学習に相同配列が含まれ、対応する構造が含まれていなくても、重要な情報が提供される可能性があり、透明性をもって説明すべきである。同じテスト集合で手法を比較する際は、利用可能な配列データベースと探索時間を揃える必要がある。そうしなければ、外部情報量の差がネットワーク構造の優位性と誤認される可能性がある。[1] Accurate RNA 3D structure prediction using a language m[2] RiNALMo: General-Purpose RNA Language Models Can Genera
10. 結論:RNA基盤モデルには条件、構造階層、分布を結び付けることが求められる
RNA研究の機会は、豊富な配列情報を、希少な構造、条件、機能の観測と結び付けることにある。本稿の行列および二状態の導出は、妥当な塩基対形成、三次元的な正確さ、配座分布が、隣接していても異なる科学的問題であることを示す。信頼できる成果物は、読者がファミリー分割、入力条件、すべての候補、測定範囲を再確認できるようにし、説明できない状態も保存すべきである。そうすることで、基盤モデルは見た目の美しい分子形状を生成し続けるだけのものではなく、反証可能な構造研究の道具となりうる。作者分析与复核建议 / Author analysis
主要な式と導出
(1) 単一相手との塩基対形成を扱う二次構造タスクの周辺整合性制約。すべての非標準的な三次元相互作用を網羅するものではない。
LaTeX
P_{ij}=P_{ji},\quad P_{ii}=0,\quad\sum_jP_{ij}\le1(2) 二状態平衡ではΔG=GB−GA。図の横軸は無次元の自由エネルギー差である。
LaTeX
P(B)=\frac1{1+\exp[\Delta G/(RT)]}(3) 配座アンサンブルにわたる観測量の期待値は、最も確からしい構造の観測値とは等しくない。
LaTeX
\langle A\rangle=\sum_kp_kA(x_k),\qquad\sum_kp_k=1(4) 塩基対集合の適合率と再現率の統合。塩基対の定義と空集合の扱いを固定する必要がある。
LaTeX
F_1=\frac{2PR}{P+R},\qquad P=\frac{TP}{TP+FP},\quad R=\frac{TP}{TP+FN}方法とエビデンスの流れ
解析図と数値例
再計算可能な例題
DeltaG/RT=-2および2のとき、Bの存在比はそれぞれ0.880797および0.119203である。構成した行列の位置1の行和は1.5であり、独立に高いスコアを持つ塩基対が必ずしも全体として妥当にならないことを示す。
手法の比較
| 階層 | 測定評価項目 | 未確定の事項 |
|---|---|---|
| 言語表現 | 固定タスクへの転移 | 完全な三次元構造 |
| 二次構造の塩基対形成 | 妥当性、適合率、再現率 | 三次構造の空間幾何 |
| 三次構造の座標 | 局所幾何と全体幾何 | 溶液中の配座存在比 |
| 多成分 | 相互作用相手と条件の明示 | 相互作用相手のいないすべての状態 |
| 生成アンサンブル | 網羅性、選択、確率 | サンプリング頻度が熱力学的重みに等しいこと |
| 機能の解釈 | 条件と機能の独立した測定 | 構造が美しければ機能が成立すること |
再検証と実験の計画
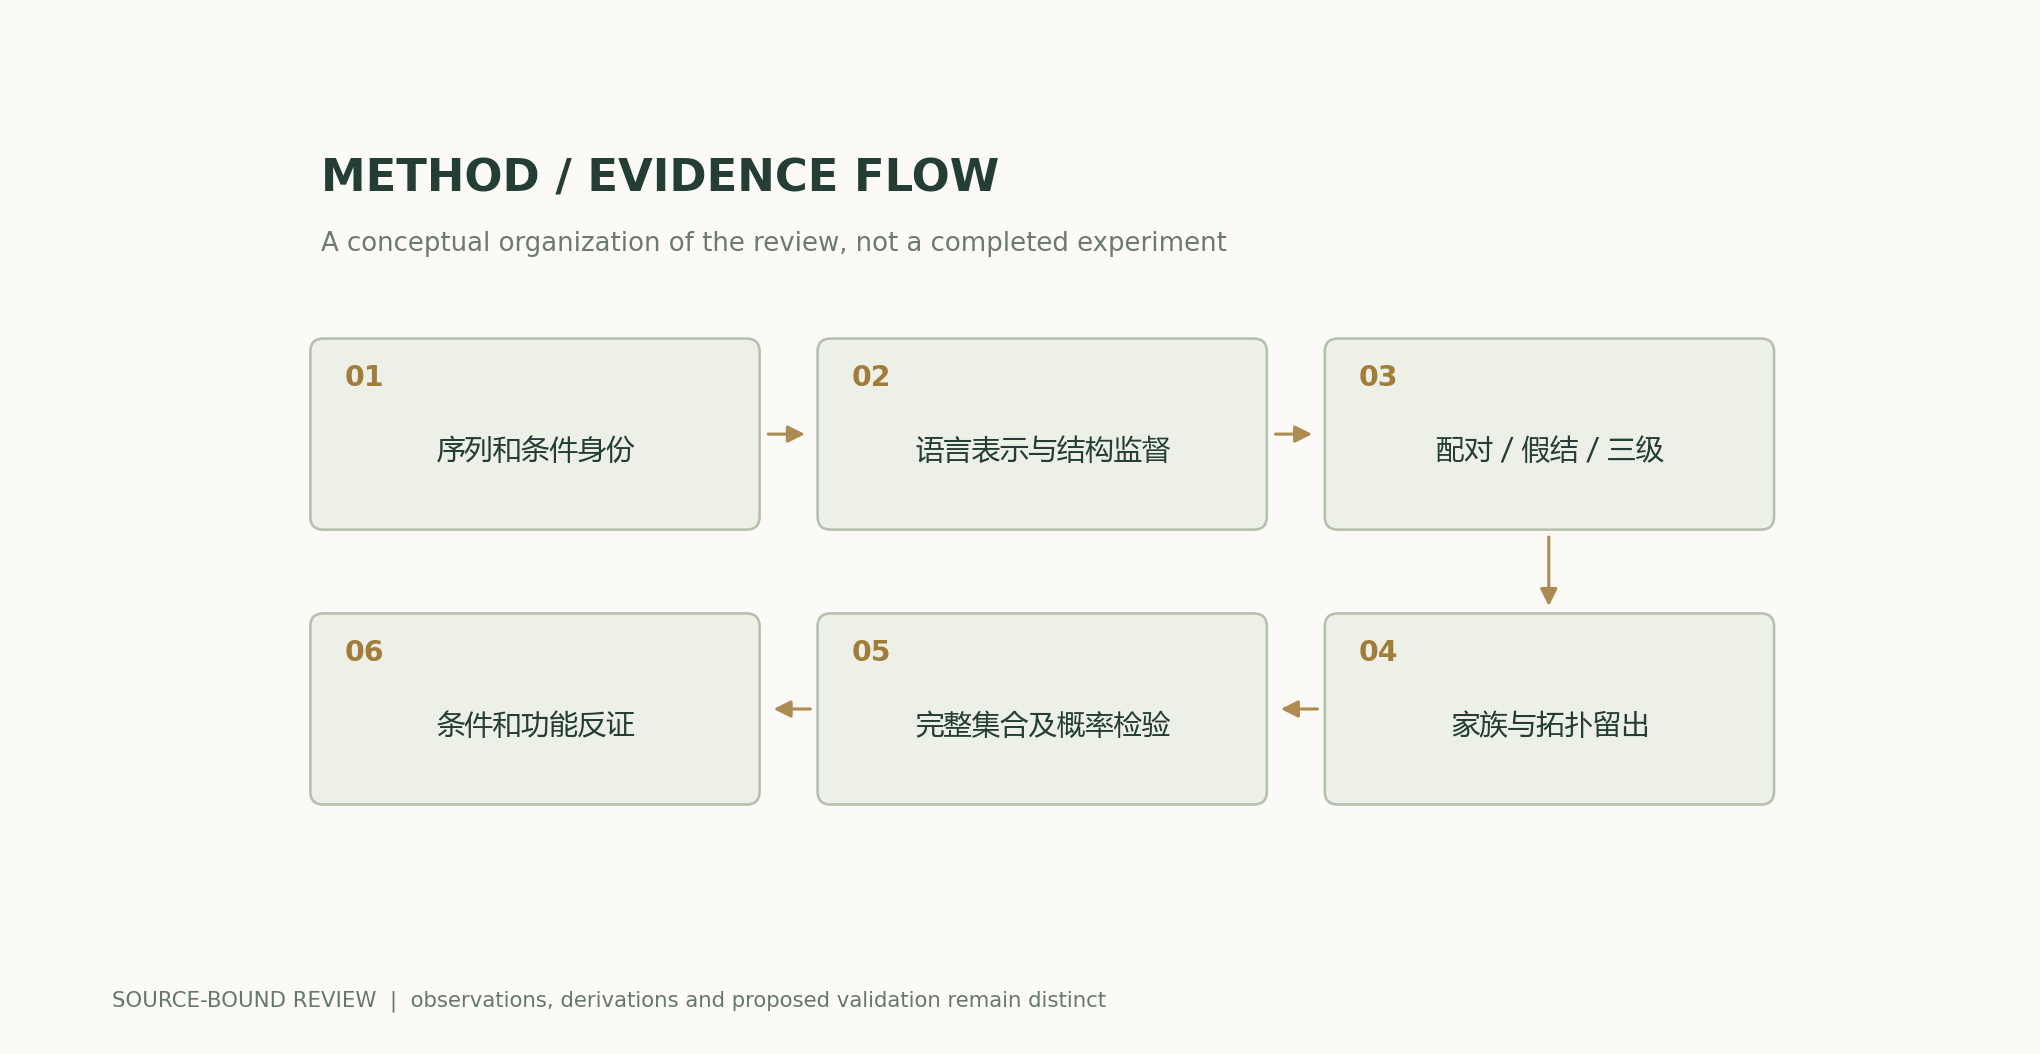
- 配列、コンストラクト、相互作用相手、修飾、モデルのタスク範囲を固定する。
- 事前学習配列と構造教師データについて、それぞれ重複と最近傍を記録する。
- ファミリー、配列、トポロジーによる層別ホールドアウトを行い、検証集合にテスト用ファミリーを再利用しない。
- 塩基対、シュードノット、非標準的関係の評価定義を固定する。
- 局所、全体、長距離、欠損領域を分けて測定し、評価可能な分母を保持する。
- アンサンブル生成ではすべての配座と重みを保存し、参照が既知となった後の最良候補の選別を禁止する。
- 条件間の転移と機能に関する主張には別途独立した測定を設け、スコアで代用しない。
- 入力と分析を公開する。本稿の解析的な二状態例を実際のRNA動態として登録しない。
適用範囲と限界
- 実在するRNAの予測も測定も行っていない。
- 二状態平衡と単一相手の塩基対行列は簡略化した仮定である。
- 生成確率が物理的な配座存在比に自動的に等しくなるわけではない。
- 参照構造とモデル入力の条件は一致しない場合がある。
- ファミリー外への転移と機能機構には、それぞれ固有のエビデンスが必要である。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| RNAの言語表現は一本鎖の三次元構造予測を支援する。 | 配列の規模は三次元構造の実験数や全条件の網羅を意味しない。 | 言語モデルに基づく深層学習手法による高精度なRNAの3次元構造予測要旨、方法および評価 |
| 原プレプリントは表現の転移と未見ファミリーの構造タスクを研究している。 | 二次構造での性能を、そのまま三次構造や機能の正解率と言い換えることはできない。 | RiNALMo:汎用RNA言語モデルは構造予測タスクで良好に汎化できる要旨、下流の構造タスク |
| 統合モデリングは核酸と他の成分に拡張されている。 | 相互作用相手と入力条件を明示する必要がある。 | AlphaFold 3による生体分子相互作用の高精度な構造予測要旨および生体分子タスクの範囲 |
検証に値する研究課題
- ファミリーのホールドアウトとトポロジーのホールドアウトは、異なる表現上のボトルネックを明らかにできるか。
- 生成アンサンブルは、正しい網羅性と条件ごとの重みの双方を復元できるか。
- モデルの知識不足と実際の配座多状態性を最もよく区別する外部観測は何か。
一次資料と主張の対応
- Accurate RNA 3D structure prediction using a language model-based deep learning approachShen et al. · 2024-11-21RNA-language-model pretraining on approximately 23.7 million sequences; single-chain 3D prediction scope.
- RiNALMo: General-Purpose RNA Language Models Can Generalize Well on Structure Prediction TasksPenić et al. · 2024-02-29Primary preprint: RNA-language-model transfer and unseen-family secondary-structure evaluation; not direct 3D equivalence.
- Accurate structure prediction of biomolecular interactions with AlphaFold 3Abramson et al. · 2024-05-08Nature 2024; diffusion module and limitations
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典付きの研究レビューと独自の解析である。原論文の実験は原研究チームによるものであり、本稿の計算は記載した式と明示した仮定のみを検証する。本サイトには現時点で、本稿に関する独立した査読や、独自モデル、臨床実験、物理実験の記録はない。
初出:AIと科学的発見に関する詳細特集。節ごとの出典を保持し、原研究のエビデンスと著者による解析の境界を維持する。
概念的な表紙はImageGenによって生成された。科学図は付属のコードと数値ファイルから作成し、図注に仮定と測定の定義を項目ごとに示している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開と版の履歴
ソースの改訂版: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c