
Resumen
La ómica espacial conecta los estados celulares con la estructura tisular, pero los resultados de los distintos métodos no son iguales: algunos alinean células con posiciones espaciales, otros estiman la composición celular local y otros aprenden representaciones capaces de predecir vecindades. Este artículo compara Tangram, CytoSPACE y Nicheformer utilizando como marco común la identificabilidad de las señales mezcladas y la escala de vecindad. Derivamos la amplificación del error causada por marcadores casi colineales y utilizamos un tejido construido para mostrar cómo los cambios de radio modifican la composición de la vecindad. La conclusión central es que un error bajo de reconstrucción de la expresión no garantiza un mapeo celular único y que la proximidad, por sí sola, tampoco demuestra comunicación celular. Las figuras y tablas no utilizaron tejidos reales ni muestras de pacientes.[1] Deep learning and alignment of spatially resolved singl[2] High-resolution alignment of single-cell and spatial tr[3] Nicheformer: a foundation model for single-cell and spa
Traducción del resumen original en inglés
Los modelos espaciales conectan la expresión celular con la organización tisular, pero la ubicación de las células, la composición local y la comunicación son problemas de inferencia distintos. Comparamos Tangram, CytoSPACE y Nicheformer desde la perspectiva de la identificabilidad. Una mezcla de dos firmas y un ejemplo de vecindad dependiente del radio ponen de manifiesto una ambigüedad que puede persistir pese a un error bajo de reconstrucción. Proponemos validación espacial por bloques, genes reservados y replicación a nivel de muestra para distinguir una interpolación útil de una biología tisular transferible.
1. Un mismo mapa tisular puede encubrir tres problemas distintos
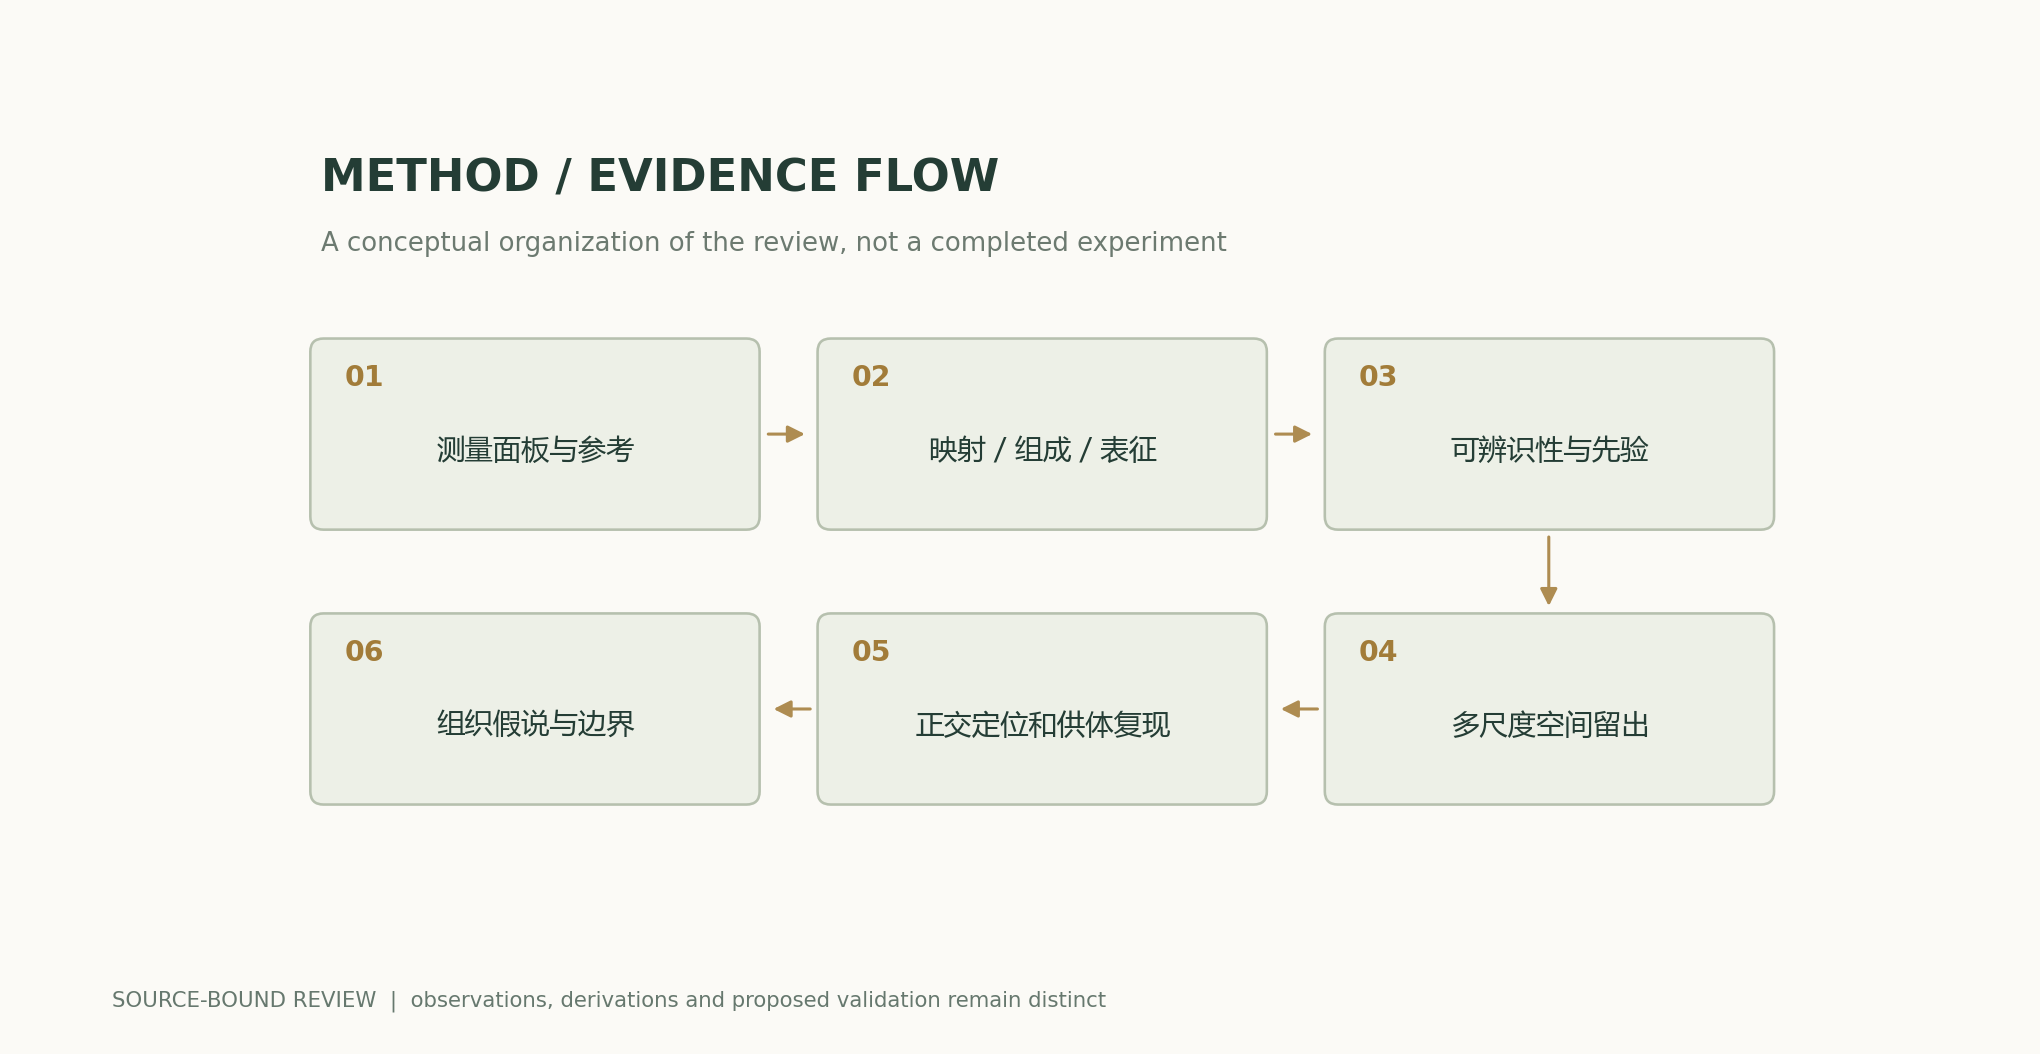
Tangram alinea la expresión de células individuales con observaciones espaciales, CytoSPACE estudia la asignación de células a posiciones espaciales con alta resolución y Nicheformer aprende representaciones transferibles a partir de datos unicelulares y espaciales. No se deberían ordenar estos tres métodos únicamente según un mapa de calor espacial que parezca claro. El problema de mapeo se ocupa de la posición y la asignación; el de composición, de las proporciones de tipos celulares dentro de una región; y el de representación, de las tareas posteriores que puede sustentar una representación embebida. Este artículo recomienda establecer primero un diccionario de unidades de salida —célula individual, punto de medición, vecindad o región tisular— y después especificar qué variables se observan realmente y cuáles se completan mediante información a priori o el modelo.[1] Deep learning and alignment of spatially resolved singl[2] High-resolution alignment of single-cell and spatial tr[3] Nicheformer: a foundation model for single-cell and spa
2. La alineación de la expresión aprovecha los genes compartidos, pero también está limitada por la cobertura de medición
La descripción metodológica de Tangram destaca los genes compartidos y la compatibilidad de las fuentes tisulares; la optimización del mapeo hace concordar la expresión reconstruida con las observaciones espaciales. Si el panel de medición carece de marcadores que distingan estados celulares similares, distintas asignaciones pueden producir una expresión casi idéntica. Este artículo considera este fenómeno un problema de identificabilidad, en lugar de atribuirlo simplemente a una capacidad insuficiente de la red. Deben conservarse el panel de genes, las diferencias de captura y la composición de las células de referencia; cuando falta un tipo celular en la referencia, el modelo puede explicarlo mediante el tipo conocido más cercano. La validación debe incluir marcadores no utilizados en el ajuste y evidencias externas morfológicas o de localización, en vez de limitarse a evaluar de nuevo los genes de entrenamiento.[1] Deep learning and alignment of spatially resolved singl[2] High-resolution alignment of single-cell and spatial tr
3. Derivación de este artículo: cómo las firmas celulares similares amplifican los errores de composición
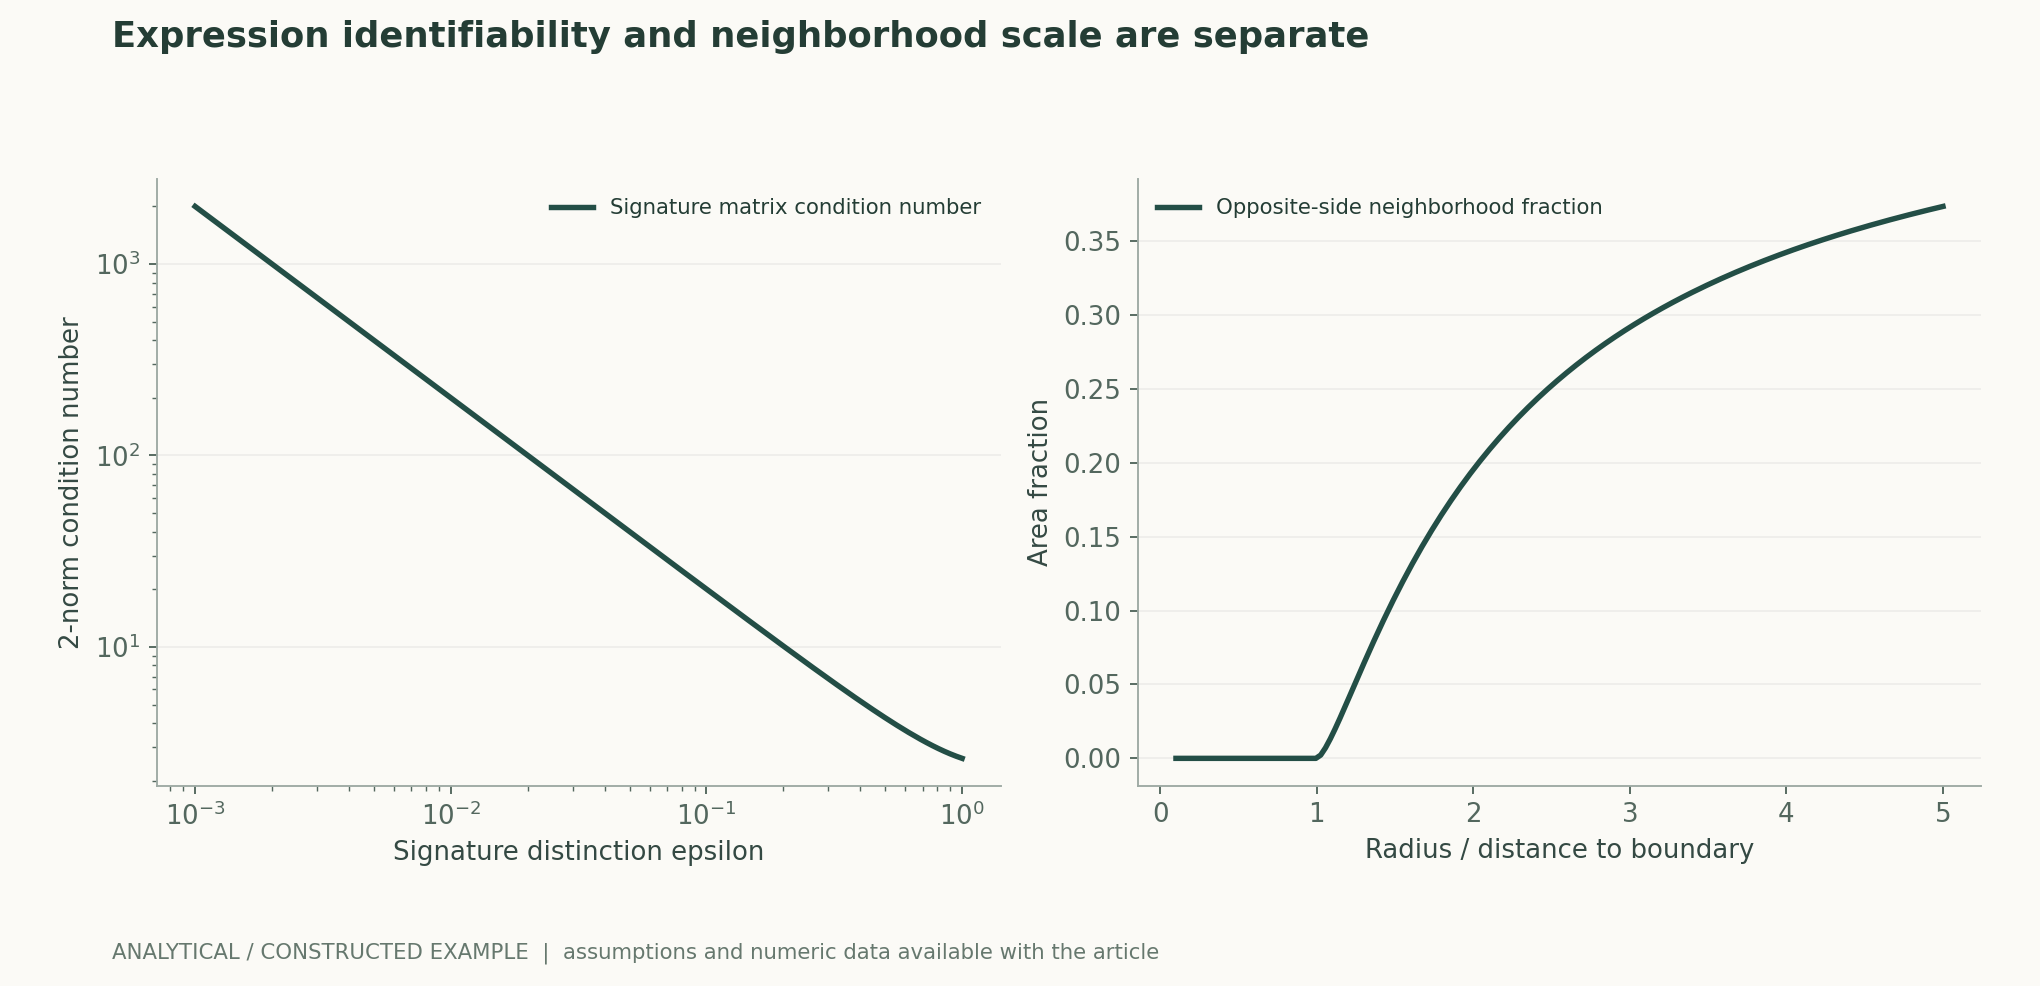
Sean las dos firmas celulares normalizadas a primera =(1,0) y a segunda =(1,ε), y supóngase que la medición se forma mezclándolas en determinadas proporciones. El segundo componente solo aporta una señal discriminante multiplicada por ε, por lo que una misma perturbación observacional δ corresponde a un cambio de composición de aproximadamente δ/ε. Cuando ε disminuye de 1 a 0.01, la precisión de medición necesaria para distinguir la misma diferencia de proporciones aumenta cien veces. Si ε=0, las dos firmas son idénticas y la composición deja de ser única. La figura muestra la variación del número de condición de la matriz y del error de recuperación con ε; todas las unidades y los errores son valores construidos. Esto explica por qué un modelo mayor no puede recuperar una respuesta única a partir de información inexistente.作者分析与复核建议 / Author analysis
4. Las restricciones de composición pueden reducir el conjunto factible, pero también introducir sesgos
CytoSPACE formula el mapeo celular como un problema de optimización con restricciones de composición, entre otras, lo que demuestra que la tarea puede aprovechar información adicional a la expresión. Este artículo analiza su significado general: conocer los recuentos o las proporciones celulares permite excluir muchas asignaciones poco plausibles, pero las propias restricciones pueden ser erróneas si la información a priori procede de otro corte, donante o tecnología. Deben notificarse por separado el error de ajuste sin restricciones, la desviación respecto de las restricciones y la exactitud de localización externa, además de realizar análisis de sensibilidad a perturbaciones de la información a priori. Si el modelo solo funciona cuando se conocen las proporciones verdaderas exactas, su capacidad debe limitarse al mapeo condicional, sin describirla como un descubrimiento independiente de toda la composición celular a partir de la señal espacial bruta.[2] High-resolution alignment of single-cell and spatial tr
5. Las representaciones de vecindad convierten el problema espacial en un problema de escala
Nicheformer utiliza la composición de la vecindad local como una de sus tareas interpretables y la evalúa en múltiples escalas de vecindad y conjuntos de datos tisulares. Un radio fijo permite definir un objeto explícito, pero un radio pequeño destaca la proximidad inmediata, mientras que uno grande se aproxima más al entorno regional; ambos pueden corresponder a preguntas biológicas distintas. Este artículo recomienda incluir el radio, el tratamiento de los límites, la densidad celular y la granularidad de los tipos celulares como parte de los resultados. En tejidos de distinta densidad, el mismo radio no contiene el mismo número de células; definir la vecindad mediante un número fijo de vecinos más próximos modifica, en cambio, la distancia física. No debe seleccionarse la escala más favorable después de encontrar un resultado significativo.[3] Nicheformer: a foundation model for single-cell and spa
6. Análisis de este artículo: la composición de la vecindad cambia con los límites y el radio
Construyamos un tejido plano de densidad celular uniforme, con células de tipo A y B a ambos lados de un límite recto, y un centro situado a una distancia d a la derecha del límite. Cuando el radio cumple r≤d, toda la vecindad pertenece al tipo del lado derecho; cuando r>d, la proporción del otro lado queda determinada por el área de un segmento circular. Aunque la expresión de la célula central permanezca completamente inalterada, la etiqueta de vecindad cambia de forma continua al aumentar el radio más allá de d. Esto muestra que algunos supuestos «errores de predicción» pueden deberse a un desajuste de la escala de las etiquetas. La figura presenta proporciones exactas de áreas circulares, no células colocadas aleatoriamente ni inferencias sobre tejidos reales; en el límite tisular, las proporciones tienden a la mitad para cada lado, mientras que lejos de él la proporción del otro lado es cero.作者分析与复核建议 / Author analysis
7. La correlación espacial puede hacer que las particiones aleatorias sean excesivamente optimistas
Las posiciones adyacentes de un mismo corte tisular comparten microambiente, lote y artefactos de medición. Si los puntos de entrenamiento y prueba se dividen aleatoriamente de forma intercalada, el modelo puede aprovechar patrones similares cercanos sin aprender necesariamente reglas transferibles entre regiones. Este artículo propone reservar bloques espaciales contiguos y, después, aplicar reservas más exigentes por corte y donante; durante la evaluación, deben conservarse las curvas de rendimiento según la distancia a la región de entrenamiento. Los intervalos de confianza requieren remuestreo al menos a nivel de corte o donante, en lugar de tratar cada célula adyacente como una réplica independiente. Las particiones aleatorias siguen siendo útiles para estimar la interpolación local, pero deben notificarse con ese nombre y no representan la generalización a tejidos nuevos.作者分析与复核建议 / Author analysis
8. La colocalización y la comunicación requieren evidencias diferentes
La proximidad espacial de dos tipos celulares puede respaldar que se encuentran en entornos similares, pero no demuestra por sí sola que un eje concreto ligando–receptor esté transmitiendo señales. La expresión, las proteínas, el contacto y los cambios funcionales pertenecen a distintos niveles de observación. Este artículo propone conservar por separado las estadísticas de colocalización y las hipótesis mecanísticas: las primeras requieren controlar la abundancia celular y la estructura tisular, mientras que las segundas deben permitir excluir explicaciones basadas en un entorno compartido o un tercer tipo celular. Si los cambios del mapa se deben principalmente a modificaciones de la segmentación celular o de las etiquetas de tipo, debe corregirse primero la cadena de medición, en vez de atribuir todos los cambios a comunicación biológica.作者分析与复核建议 / Author analysis
9. Establecer comparaciones contrastables entre tecnologías
Una comparación rigurosa debe mantener constantes la región tisular, el conjunto de genes compartidos y las condiciones de referencia, y evaluar por separado las tareas de mapeo, composición y vecindad. Los genes de ajuste y de validación deben separarse; el protocolo también debe especificar qué información a priori se permite utilizar a los modelos. Los criterios principales de valoración pueden ser errores de localización o composición validados con marcadores independientes, y los secundarios, la transferencia entre regiones y el rendimiento en tipos raros. Si un método destaca en clases celulares amplias pero asigna estados escasos a clases mayoritarias cercanas, debe notificarse a nivel de tipo, en lugar de quedar oculto por una media ponderada por el número total de células.作者分析与复核建议 / Author analysis
Suplemento técnico A · Del mapeo probabilístico a la asignación de células individuales
Una matriz de mapeo blando permite que una célula tenga pesos en varias posiciones; satisfacer la reconstrucción de la expresión no significa que cada célula tenga ya una ubicación única. Convertir después estos pesos en una asignación rígida tomando el máximo elimina la incertidumbre y puede modificar los recuentos regionales. Este artículo recomienda publicar conjuntamente resúmenes de los pesos blandos, las asignaciones finales y las diferencias entre ambos, y comprobar si los objetos de baja confianza se concentran en límites o entre tipos similares. Si varias optimizaciones producen posiciones celulares diferentes pero la misma composición regional, las conclusiones estables deben limitarse al nivel de composición, en lugar de imponer que cada posición se considere un hecho unicelular confirmado.[1] Deep learning and alignment of spatially resolved singl[2] High-resolution alignment of single-cell and spatial tr
Suplemento técnico B · Distinguir el número de condición de la especificación incorrecta del modelo
La cota de perturbación lineal supone que se conoce la matriz de firmas A; si la referencia real procede de otra tecnología o carece de ciertos estados, la propia matriz también contiene errores. En ese caso, los errores de observación y de referencia pueden modificar conjuntamente la composición, y reducir únicamente el ruido de medición no resuelve necesariamente el problema. Este artículo recomienda variar por separado las células de referencia, el panel de genes y la profundidad de recuento para observar la estabilidad de los resultados. Si el error procede principalmente de ausencias en la referencia, aumentar el número de muestras de esa misma referencia puede limitarse a hacer más segura la respuesta equivocada. Se necesita información discriminante adicional o permitir una clase desconocida, no solo aumentar la capacidad de la red.作者分析与复核建议 / Author analysis
Suplemento técnico C · Las etiquetas de composición de la vecindad están sujetas a restricciones composicionales
Las proporciones de todos los tipos de una vecindad suman uno, por lo que el aumento de un tipo obliga a disminuir las otras proporciones, aunque sus recuentos absolutos no hayan cambiado. Por tanto, la correlación entre proporciones no equivale a exclusión mutua entre células. Este artículo recomienda conservar tanto el número total de células de la vecindad como las proporciones de tipos, y distinguir densidad y composición durante el análisis. Para las proporciones nulas también debe indicarse si representan una ausencia real de detección, la incapacidad del panel para distinguir el tipo o la ausencia de células vecinas. Añadir un pseudoconteo a todos los ceros antes de calcular correlaciones puede modificar las conclusiones sobre tipos raros; los pseudoconteos y las transformaciones deben incorporarse a una configuración auditable.作者分析与复核建议 / Author analysis
Suplemento técnico D · El registro entre cortes no equivale a medir repetidamente la misma célula
Los cortes adyacentes pueden proporcionar contextos tisulares próximos, pero no siempre permiten establecer una correspondencia individual para cada célula. Este artículo recomienda dividir la validación entre cortes en tres granularidades —región, tipo y célula— y conservar el error de cada clase de correspondencia. Si solo existe concordancia regional, la mejora del modelo debe notificarse mediante criterios de valoración regionales. Mezclar coordenadas precisas a nivel celular con etiquetas regionales genera una falsa confirmación de alta resolución. Para las conclusiones dependientes de los límites, puede desplazarse o perturbarse deliberadamente el registro y comprobar si se mantienen dentro de un intervalo explícito, en vez de utilizar una única alineación especialmente favorable.作者分析与复核建议 / Author analysis
10. Conclusión: la ecología tisular requiere predicciones con escalas explícitas
Una posibilidad importante de los modelos fundacionales espaciales es devolver los estados celulares a su contexto tisular, pero su credibilidad depende de explicitar el objeto de salida, la información disponible y la escala. Los dos contraejemplos de este artículo muestran, respectivamente, que tanto la identificabilidad de la expresión como la definición de vecindad pueden limitar la unicidad de la respuesta. Los productos científicos deben incluir el panel de genes, la referencia, la información a priori, las particiones espaciales y las regiones de fallo, para que las reproducciones posteriores permitan determinar si las diferencias proceden de la tecnología, las condiciones o la biología. Vincular estas condiciones a versiones exactas contribuye más a acumular conocimiento tisular transferible que añadir continuamente mapas de calor atractivos.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) Ejemplo general de mezcla lineal; los modelos reales de captura, recuento y expresión pueden ser más complejos.
LaTeX
y=A\pi+\eta,\qquad \pi_k\ge0,\quad\sum_k\pi_k=1(2) Cota de perturbación de mínimos cuadrados sin restricciones para una A fija de rango columna completo; los casos con restricciones o especificación incorrecta requieren un análisis separado.
LaTeX
\|\delta\pi\|\le\|A^+\|\,\|\delta y\|(3) Proporción del área del otro lado cuando una vecindad circular cruza un límite recto en un plano uniforme; es 0 cuando r≤d.
LaTeX
q(r,d)=\frac{\arccos(d/r)-(d/r)\sqrt{1-(d/r)^2}}{\pi},\quad r>d(4) Composición de una vecindad definida por radio que excluye la célula central; las vecindades vacías se registran como datos ausentes y no se sustituyen por un vector 0.
LaTeX
\pi_k(i;r)=\frac{\sum_{j\ne i}\mathbf1(\|z_j-z_i\|\le r)\mathbf1(c_j=k)}{\sum_{j\ne i}\mathbf1(\|z_j-z_i\|\le r)}Flujo de métodos y evidencias
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto recalculable
Reducir epsilon por un factor de 100 reduce la señal discriminante del segundo componente por un factor de 100; cuando r<=d, la proporción del otro lado es 0, y cuando r=2d, es aproximadamente 0.195501; cuando r/d tiende a infinito, se aproxima a 0.5.
Comparación de métodos
| Problema | Escala o información que debe mantenerse fija | Validación independiente |
|---|---|---|
| Mapeo de expresión | Genes compartidos, células de referencia y unidades espaciales | Genes reservados y localización morfológica |
| Composición regional | Alcance de captura e información a priori sobre recuentos celulares | Recuentos externos y proporciones de tipos |
| Predicción de vecindades | Radio o número de vecinos más próximos, reglas de límites | Múltiples escalas y nuevos cortes |
| Estados raros | Granularidad de etiquetas y cobertura de referencia | Errores a nivel de tipo y clases desconocidas |
| Mecanismos de comunicación | Distinción entre colocalización, expresión y función | Mediciones ortogonales e intervenciones |
| Transferencia entre tecnologías | Panel, normalización, lote | Nuevos donantes y tecnologías independientes |
Plan de verificación y experimentación
- Fijar las coordenadas espaciales, el panel de medición, la versión de las etiquetas y las fuentes de referencia.
- Declarar la unidad de salida y distinguir posición, composición, vecindad e hipótesis de comunicación.
- Conservar genes de validación no utilizados en el ajuste y señales de localización que puedan confirmarse de forma independiente.
- Reservar progresivamente bloques espaciales, cortes y donantes, registrando la distancia a los datos de entrenamiento.
- Perturbar simultáneamente la información a priori sobre recuentos y composición celular para comprobar la estabilidad de las conclusiones.
- Predefinir los radios de vecindad y las reglas de límites; registrar por separado las vecindades vacías.
- Desglosar los resultados por tipo, densidad y estado raro, y proporcionar intervalos a nivel de donante.
- Publicar mapas, resúmenes de entradas y regiones de fallo; no sustituir la evidencia mecanística por la colocalización.
Ámbito de aplicación y limitaciones
- La mezcla lineal y el plano uniforme son modelos analíticos hipotéticos.
- No se utilizaron datos tisulares ni se ejecutaron los modelos mencionados.
- El análisis del número de condición no abarca por completo la ausencia de células de referencia ni el sesgo de captura.
- Las etiquetas de vecindad dependen de la escala y deben redefinirse para comparar tejidos.
- La colocalización por sí sola no permite identificar relaciones causales de comunicación celular.
Evidencias de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Alinea la expresión unicelular y espacial mediante genes compartidos. | La información depende del panel y de una referencia compatible; no garantiza una asignación única. | Aprendizaje profundo y alineación de transcriptomas unicelulares resueltos espacialmente con TangramDescripción del método por sus autores |
| Evalúa la tarea de composición de la vecindad en múltiples tejidos y escalas de vecindad. | Las regiones infrecuentes y heterogéneas y la definición de vecindad siguen influyendo en los resultados. | Nicheformer: un modelo fundacional para la ómica unicelular y espacialComposición de la vecindad; fig. 5 |
| Mapeo de células a posiciones con alta resolución y comparación de varios métodos. | La información a priori y la configuración de medición forman parte de las condiciones del método. | Alineación de alta resolución de transcriptomas unicelulares y espaciales con CytoSPACEMétodo y evaluación comparativa |
Preguntas de investigación que merece la pena contrastar
- ¿Puede la identificabilidad de las firmas de expresión predecir fallos de mapeo entre tecnologías?
- ¿Cómo difieren un radio físico fijo y un número fijo de vecinos en la generalización entre tejidos?
- ¿Se deben los errores de localización de estados celulares raros principalmente a ausencias en la referencia, en lugar de a la capacidad del modelo?
Fuentes primarias y afirmaciones correspondientes
- Deep learning and alignment of spatially resolved single-cell transcriptomes with TangramBiancalani et al. · 2021Primary paper: mapping, shared genes and spatial alignment; associated author repository is linked by the paper.
- High-resolution alignment of single-cell and spatial transcriptomes with CytoSPACEVahid et al. · 2023-03-06Cell-to-spot assignment, compositional constraints and dedicated mapping benchmarks.
- Nicheformer: a foundation model for single-cell and spatial omicsTejada-Lapuerta et al. · 2025-10-30Neighborhood composition definitions and evaluation at multiple radii; rare and heterogeneous regions.
Citación y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de revisión por pares independiente de este artículo ni de registros de experimentos originales con modelos, clínicos o físicos.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se conservan las fuentes de cada sección y los límites entre las evidencias de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos al artículo; sus leyendas especifican, punto por punto, los supuestos y las definiciones de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para recalcular · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c