
摘要
推测解码先由便宜的草稿模型提出多个token,再利用目标模型验证,在适当的接受与残差采样规则下保留目标分布。本文推导单步概率质量如何被分配,并将分布正确性与系统加速分开讨论。解析成本模型明确假设逐步接受率恒定、目标验证成本单位化;它只用于解释折中,不是设备实测。温度、截断采样、停止条件和数值精度均被纳入复核方案。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
English abstract
Speculative decoding is studied as exact distribution correction under explicitly matched target probabilities and sampling rules. We derive the accepted mass and residual distribution, then analyze an idealized constant-acceptance cost model. The plotted speed ratios are analytical scenarios, not hardware measurements. Temperature, truncation, numerical precision and stopping semantics must be tested as part of correctness.
1. 草稿是提案而不是最终答案
设目标分布为p、草稿分布为q。草稿模型便宜并不足够,它还要在当前上下文下与目标分布有足够重叠,否则大量提案会被拒绝。多token草稿中的后续分布依赖前缀,验证到第一个拒绝后,后面的草稿不再具有同一个已接受前缀。实现必须按正确的条件概率处理,而不能简单把所有位置独立筛选后拼接。目标模型的实际采样规则也属于p的定义。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
2. 接受与残差共同恢复目标概率
对来自q的候选token,以min(1,p/q)接受,得到的已接受概率质量是min(p,q)。未覆盖的目标质量为正部[p-q],拒绝时从该残差归一化分布采样,才能补齐目标分布。这一校正解释了为何不能在拒绝时任意换一个高概率token,也不能把草稿接受率直接当作输出质量。实际实现需要正确处理零概率和数值精度;若p、q的温度或截断支持不一致,应按处理后的真实分布校正。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
3. 分布等价不意味着相同随机轨迹
正确的推测采样与逐步目标采样可以具有相同输出分布,却不必在相同种子下生成完全相同的字符串,因为随机数消耗顺序不同。测试应先对小词表和短序列计算精确分布,比较大量采样的频率与统计误差,再检查完整模型语义。对于贪心解码,等价目标不同;对于top-k或top-p,截断与重归一化位置也必须一致。不能仅凭若干文本样例相似宣布实现正确。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
4. 预期收益来自一次验证推进多步
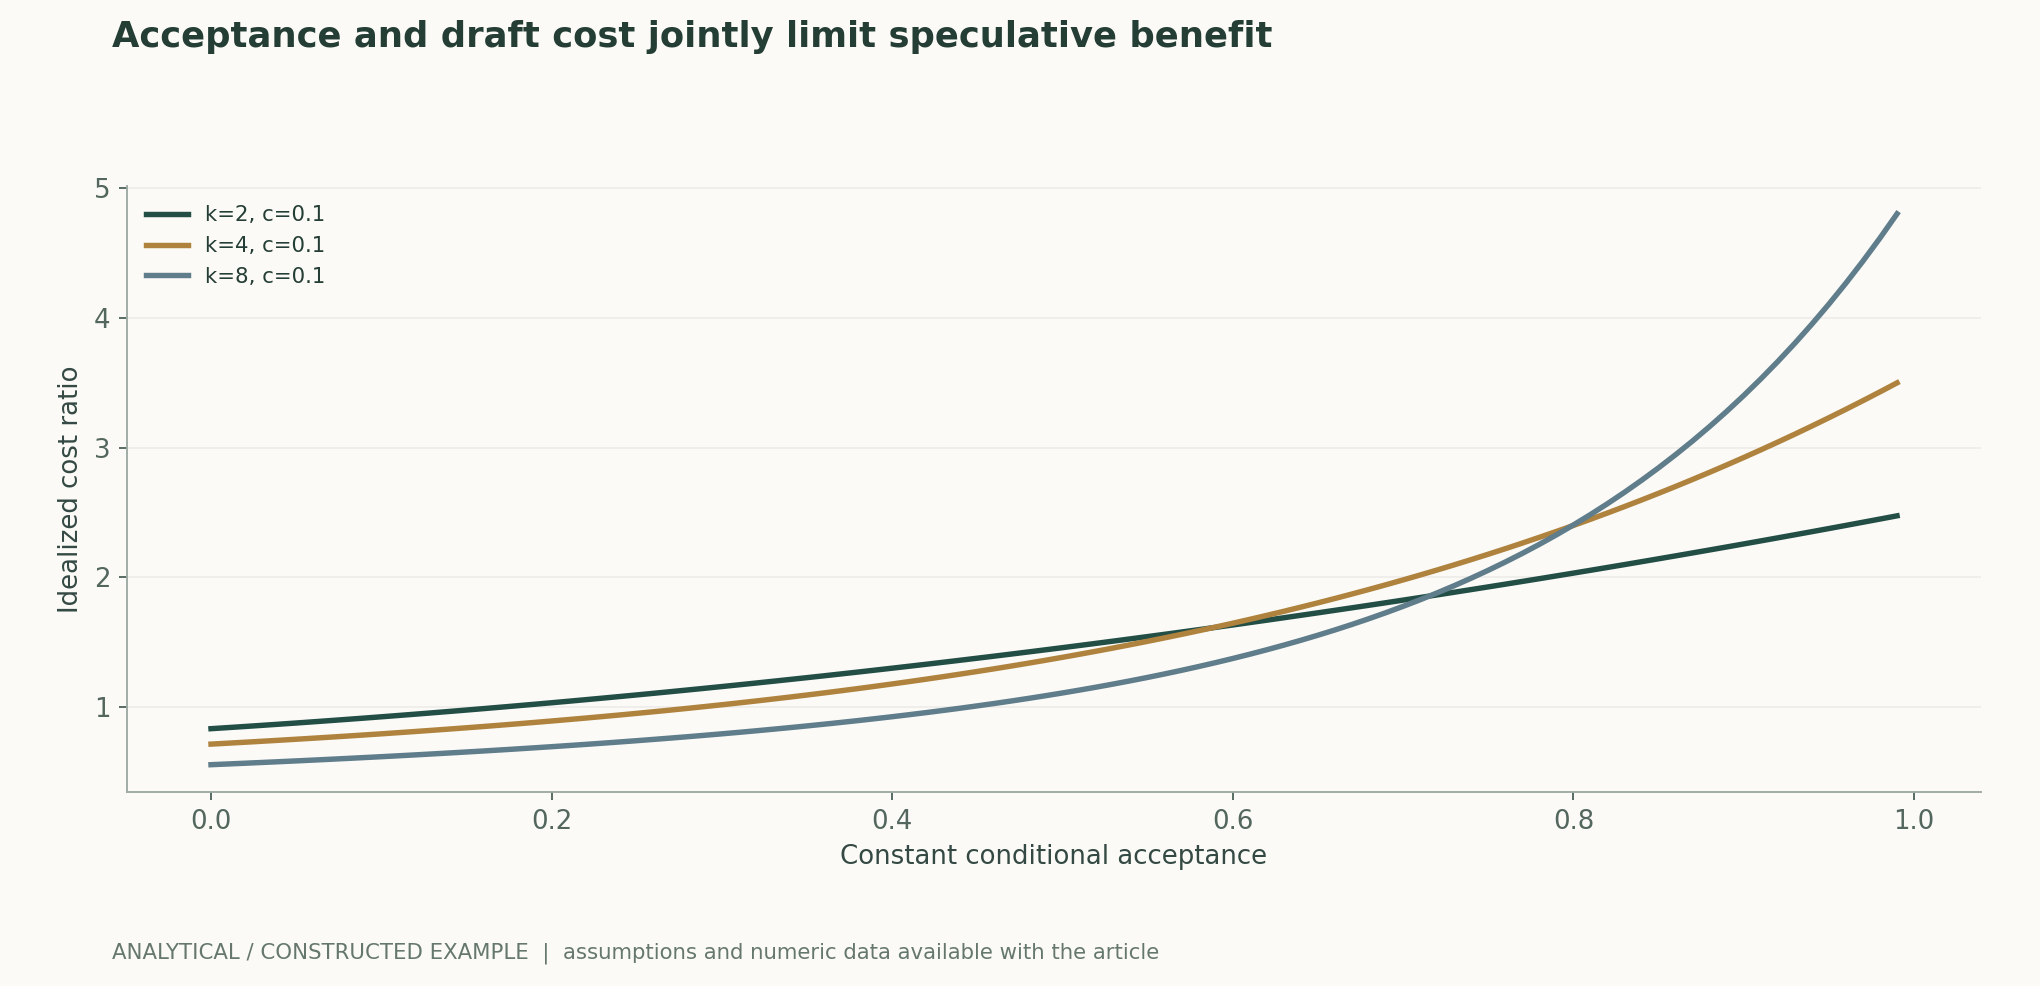
在理想化的恒定独立接受率α下,长度k的草稿可让一次目标验证平均推进1+α+…+α^k个token。但草稿生成、目标验证长度增加、内存复制和同步也有成本。若草稿成本较高或接受率低,系统可能更慢。图中把一次目标验证成本设为1、每草稿token成本设为0.1,仅画出这个模型的条件性比值;真实验证成本不恒定,必须在目标设备和批量上重新测量。[1] Fast Inference from Transformers via Speculative Decodi
5. 批处理与KV管理会改变最优草稿长度
较长草稿增加潜在推进步数,也增加计算、暂存KV与拒绝后的回滚。连续批处理中的请求接受长度不同,会引入调度和padding成本;多个请求共享设备时,单请求收益可能与总体吞吐不一致。应分别测首token延迟、稳定解码速度、尾延迟和内存,并覆盖短输出与长输出。动态选择草稿长度也需要记录决策规则,不能在看完结果后只报告最有利区间。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
6. 正确性与性能需要两份验收
先验收分布、停止token、最大长度、请求取消和KV回滚,再验收端到端成本。分布正确的实现仍可能受精度或采样实现影响;速度好的实现若改变目标分布,则需要作为另一种近似算法单独命名和评价。所有性能比较应固定目标模型、采样设置、输入分布与服务约束。本文没有运行草稿/目标模型,公式图只支持接受率与理想成本的关系,不支持任何真实加速倍数。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
Equations and derivations
(1) 候选来自q;q为零的位置不会由该提案分布提出。接受质量只是目标概率的一部分。
LaTeX
a(x)=\min\{1,p(x)/q(x)\},\qquad q(x)a(x)=\min\{p(x),q(x)\}(2) 拒绝后的校正分布;分母为零时两分布相等,不需要该拒绝分支。
LaTeX
r(x)=\frac{[p(x)-q(x)]_+}{\sum_y[p(y)-q(y)]_+}(3) 恒定独立接受率与单位验证成本下的理想模型。图取c=0.1;真实硬件的验证、批处理和KV成本另测。
LaTeX
\mathbb E[L]=\sum_{i=0}^{k}\alpha^i,\qquad S_{\mathrm{toy}}=\frac{\sum_{i=0}^{k}\alpha^i}{1+kc}Method and evidence flow
Analytical figures
Worked calculation
理想模型中α=0.8、k=4时平均推进3.3616 token,成本1.4,比例约2.401;α=0.2时比例约0.893,反而没有收益。真实验证成本与批处理并不恒定。
Method comparison
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 概率校正 | 对处理后的p、q核对接受与残差 | 省略残差会改变目标分布 |
| 随机复现 | 检验分布而非只比较同种子文本 | 等分布不要求相同随机轨迹 |
| 草稿长度 | 联合测接受长度与所有额外开销 | 更长草稿不保证更快 |
| 生产服务 | 分列吞吐、尾延迟、取消与KV回滚 | 单请求理想收益不代表批量收益 |
Verification protocol
- 固定目标和草稿模型版本、温度、top-k/top-p及停止语义。
- 构造可穷举小词表,逐项核对接受质量加残差等于p。
- 在短序列上做频率检验,报告样本数和统计误差而非只看文本。
- 覆盖零概率、分布相等、首步拒绝、全接受和停止token等边界。
- 固定输入/输出长度与批量,测草稿、验证、KV、调度和端到端时间。
- 逐项检查取消与回滚,并把近似改动同保持目标分布的实现分开报告。
Scope and limitations
- 没有模型或硬件加速实测。
- 恒定接受率只是假设模型。
- 采样变换与精度会影响分布校正。
- 服务调度可能改变最优参数。
Primary sources and claim mapping
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Accelerating Large Language Model Decoding with Speculative Sampling, , , , , · 2023-02-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
Citations and exports
BibTeXRISCSL JSONTXTArticle JSON
Author, versions and sources
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
Cover and figure provenance · Data, sources and assumptions · Publication and version record
Source revision: ed6feca8fdc75c8de482fd69dedf17cbc746a9d1