
Resumen
Los datos sintéticos pueden reducir parte de los costes de anotación, pero también pueden reproducir errores del modelo docente, restringir la cobertura o contaminar la evaluación. Este artículo considera la generación, el filtrado, la deduplicación y el entrenamiento como un proceso que determina conjuntamente la distribución efectiva de los datos, deriva la probabilidad de que un evento raro aparezca al menos una vez después del filtrado y analiza las limitaciones de este modelo de muestreo independiente. Los gráficos adjuntos no son experimentos de degradación de modelos; los efectos reales deben validarse mediante datos reales independientes y un presupuesto de entrenamiento fijo.[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
Traducción del resumen original en inglés
Los procesos de datos sintéticos se evalúan como sistemas de muestreo y selección. Distinguimos entre corrección, cobertura y dependencia, derivamos la retención de eventos raros bajo un modelo explícito de muestreo independiente y describimos controles que protegen contra la contaminación. Las curvas de cobertura son escenarios analíticos, no resultados empíricos de colapso de modelos. Para evaluar un corpus generado se necesitan datos reales reservados para la evaluación e información de procedencia.
1. El volumen de datos no equivale a la cantidad de información efectiva
Generar un millón de textos no significa obtener un millón de señales de aprendizaje independientes. Las instrucciones similares, un mismo modelo docente, las plantillas repetidas y las respuestas semejantes pueden producir correlaciones fuertes. La calidad también debe definirse por separado en términos de corrección factual, pertinencia para la tarea, utilidad lingüística y cobertura de las poblaciones objetivo; una puntuación única puede ocultar distintos fallos. Self-Instruct ofrece un procedimiento concreto en el que un modelo genera instrucciones que posteriormente se filtran, pero cualquier contexto nuevo sigue requiriendo la validación de sus reglas de generación y filtrado; el nombre de un método no puede considerarse una garantía de calidad.[2] Self-Instruct: Aligning Language Models with Self-Gener
2. Los filtros modifican tanto los errores como la cobertura
El filtrado puede reducir los errores evidentes, pero también puede retener preferentemente contenido común, fácil de juzgar o acorde con las preferencias del modelo docente. Si las muestras raras pero correctas tienen mayor probabilidad de ser rechazadas erróneamente, serán aún más escasas en el entrenamiento posterior. Deben estimarse por separado las tasas de retención de las distintas categorías, en lugar de informar únicamente de la tasa global de aceptación. Si el filtro y el generador comparten puntos ciegos, también pueden validar mutuamente sus errores. La revisión humana requiere un muestreo estratificado según el riesgo y la cola larga, y no puede limitarse al lote con mayores probabilidades de superar el filtro.[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener
3. La cobertura de la cola larga puede evaluarse primero mediante un cálculo probabilístico
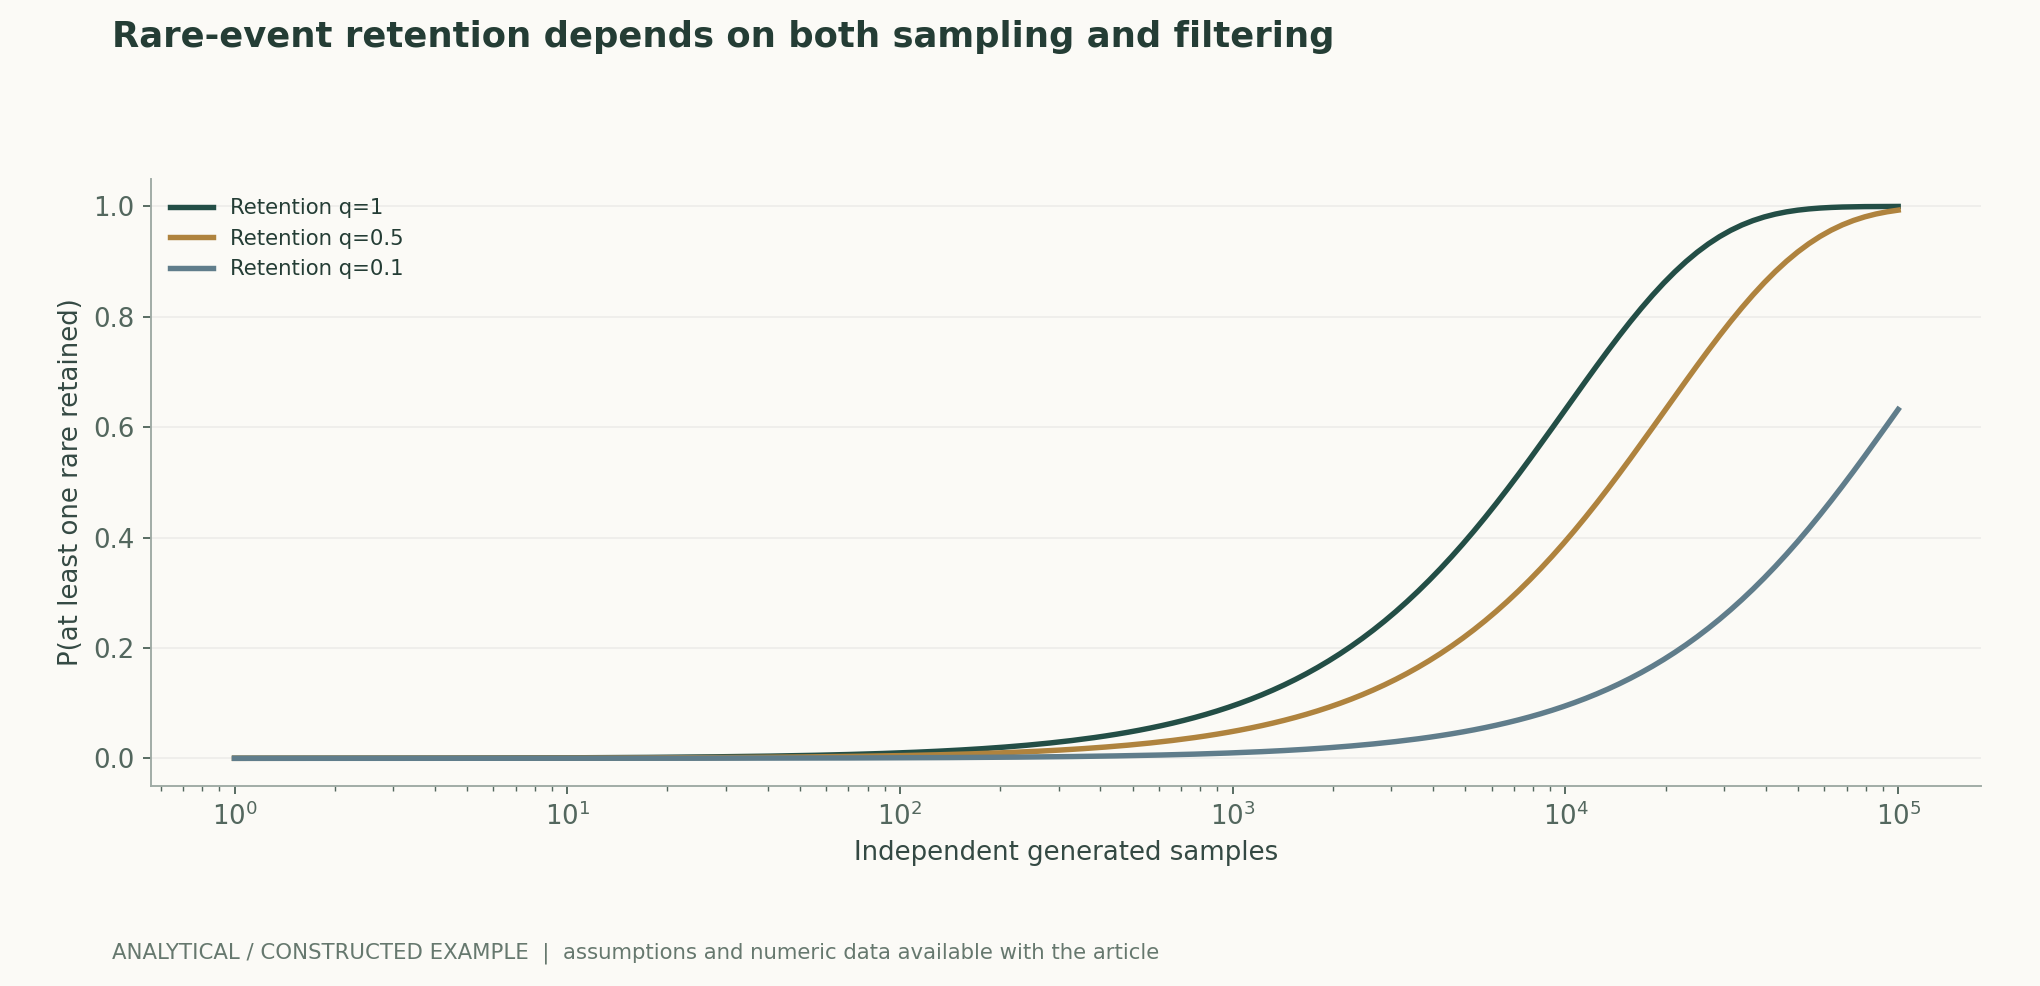
Supongamos que la probabilidad original de un evento es p, que su probabilidad de ser retenido por el filtrado es q y que las n generaciones son independientes. La probabilidad de retenerlo al menos una vez es entonces 1−(1−pq)^n. Esta fórmula muestra claramente que un mayor muestreo y una mejor retención de la cola larga pueden compensarse entre sí, pero una sola aparición no implica un aprendizaje suficiente. Cuando las muestras reales están correlacionadas, el soporte del modelo docente es limitado o el evento no puede generarse en absoluto, el modelo de independencia resulta demasiado optimista. En el gráfico, p=0.0001, y q toma los valores 1, 0.5 y 0.1, únicamente para explicar esta relación condicional.[1] Textbooks Are All You Need
4. El uso recursivo de datos generados requiere conservar anclajes de datos reales
La investigación sobre el entrenamiento recursivo con datos generados analiza los riesgos de pérdida de las colas de la distribución y de acumulación de errores; sus conclusiones dependen del modelo, la mezcla de datos y las condiciones de entrenamiento, y no pueden reducirse a que todos los datos sintéticos sean necesariamente perjudiciales. Lo fundamental es registrar la generación de procedencia de cada muestra, la proporción de datos reales y las reglas de filtrado y remuestreo, y seguir la calidad por estratos sobre un conjunto fijo de pruebas reales. Generar continuamente con el modelo actual y evaluar con modelos similares puede crear un circuito cerrado sin una verdad de referencia externa.[1] Textbooks Are All You Need
5. La deduplicación y las comprobaciones de contaminación deben realizarse a nivel de familias
Las reformulaciones, traducciones y explicaciones del modelo docente de una misma pregunta original pueden aparecer a ambos lados de la partición entre entrenamiento y prueba. Comparar únicamente hashes de cadenas omite variantes semánticas, mientras que un filtrado semántico excesivo puede eliminar por error preguntas similares legítimas. Deben conservarse las familias de muestras, las instrucciones de generación y los enlaces a las fuentes, agruparse las variantes relacionadas antes de la partición y someterse las coincidencias por similitud a revisión humana. La investigación sobre deduplicación de datos de entrenamiento indica que los datos duplicados afectan a la memorización y a la interpretación de las evaluaciones; los procesos de datos sintéticos deberían adelantar estas comprobaciones.[3] Deduplicating Training Data Makes Language Models Bette[2] Self-Instruct: Aligning Language Models with Self-Gener
6. La aceptación requiere presupuestos equiparables y una evaluación independiente con datos reales
Al comparar propuestas de datos sintéticos, deben mantenerse fijos el modelo base y el número total de tokens de entrenamiento, y variar por separado la estrategia de generación, el filtro y la proporción de mezcla de datos reales y sintéticos. Deben comunicarse los costes de generación y revisión humana, la tasa de duplicación y la cobertura por categorías, evitando informar únicamente de la puntuación final del entrenamiento. Las pruebas deben incluir entradas reales no vistas previamente, casos raros y conjuntos de errores del modelo docente. El gráfico de cobertura de este artículo es solo un cálculo preliminar al diseño, no una certificación de la calidad del corpus, y tampoco demuestra que alguna proporción de mezcla sea óptima.[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
Ecuaciones fundamentales y derivaciones
(1) Se suponen un muestreo independiente e idénticamente distribuido y una tasa de retención constante; una sola aparición no garantiza un entrenamiento suficiente.
LaTeX
P(\text{至少保留一次})=1-(1-pq)^n(2) En el ejemplo, p=10 elevado a la potencia negativa 4; los valores reales de p y q deben estimarse mediante auditorías estratificadas.
LaTeX
\mathbb E[N_{\mathrm{rare}}]=npq(3) a(x) es la probabilidad de que una muestra sea aceptada, lo que muestra que el filtro modifica toda la distribución y no se limita a eliminar errores.
LaTeX
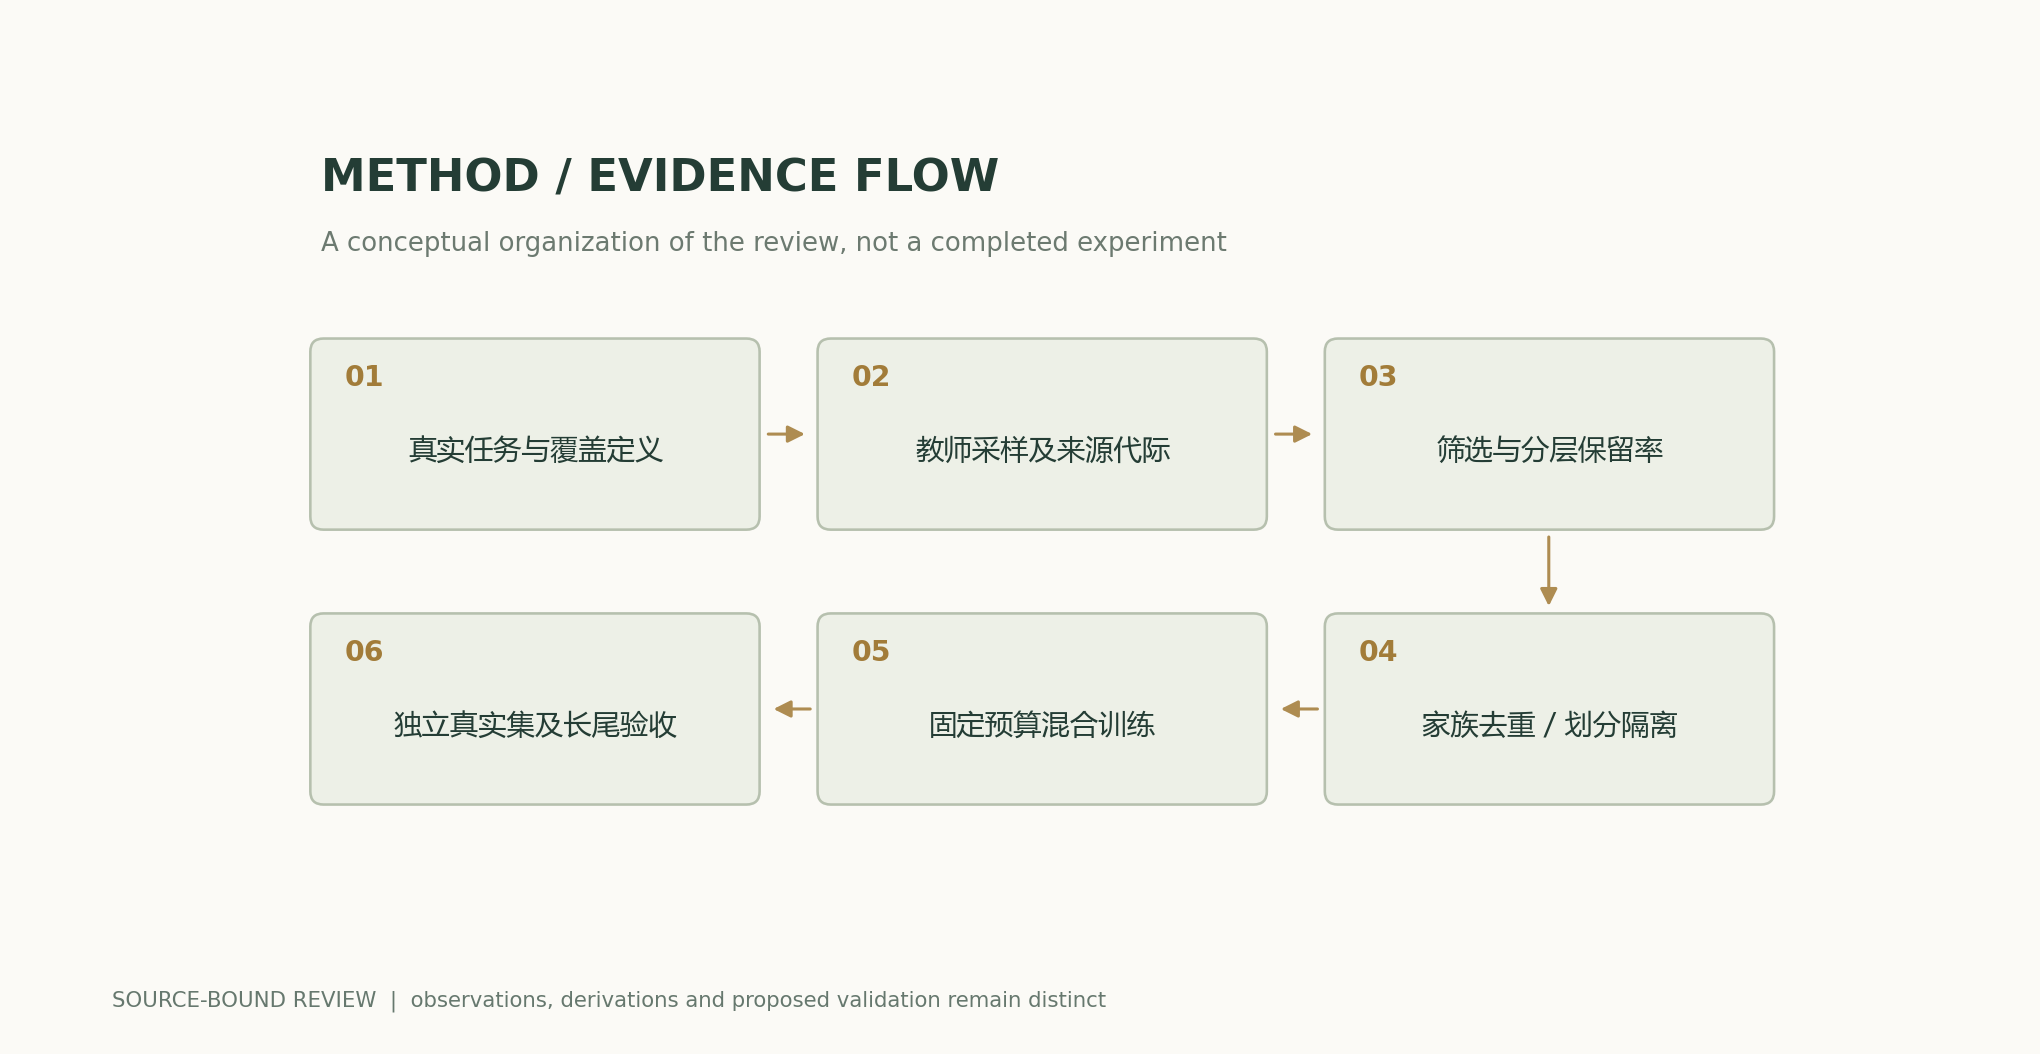
P_{\mathrm{kept}}(x)\propto P_{\mathrm{gen}}(x)\,a(x)Flujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Cuando n=10000, la probabilidad de retención al menos una vez es aproximadamente 0.632 para q=1, y aproximadamente 0.095 para q=0.1. La generación correlacionada o la ausencia de ese patrón en el modelo docente pueden hacer que el modelo de independencia resulte demasiado optimista.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Cantidad de muestras generadas | Informar también de duplicaciones, familias y cobertura | Más muestras no garantizan más información independiente |
| Filtrado de calidad | Medir la precisión y la retención por categoría | La tasa global de aceptación oculta los rechazos erróneos en la cola larga |
| Entrenamiento recursivo | Conservar la información generacional y los anclajes de datos reales | No puede extrapolarse que todos los datos sintéticos conduzcan necesariamente a una degradación |
| Conjunto de evaluación | Mantener fuentes reales independientes y la separación entre familias | La evaluación por el modelo docente de sus propias muestras generadas puede ser circular |
Plan de revisión y experimentación
- Definir previamente las tareas objetivo y las dimensiones de calidad, y fijar un conjunto de pruebas reales independiente.
- Registrar el modelo generador, las instrucciones, el muestreo, la generación de procedencia y cada operación de filtrado.
- Dividir por familias y realizar una deduplicación exacta y aproximada; comprobar mediante muestreo los falsos positivos y negativos de las coincidencias semánticas.
- Auditar la corrección, la retención y la independencia por categorías comunes y raras.
- Mantener fijos los tokens de entrenamiento y el modelo base, y realizar estudios de ablación de los filtros y las proporciones de mezcla de datos reales y sintéticos.
- Publicar los costes de generación, revisión y entrenamiento, e informar del conjunto de fallos del modelo docente y de la calidad en la cola larga.
Ámbito de aplicación y limitaciones
- El modelo de cobertura supone un muestreo independiente.
- No se realizaron nuevos experimentos de entrenamiento con corpus ni de degradación.
- Una sola aparición en la cola larga no garantiza el aprendizaje.
- La calidad del filtrado y la cobertura pueden entrar en conflicto.
Correspondencia entre fuentes primarias y afirmaciones
- Textbooks Are All You Need, , , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled Textbooks Are All You Need, by Suriya Gunasekar and 18 other authors · 2023-06-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Self-Instruct: Aligning Language Models with Self-Generated Instructions, , , , , , · 2022-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en la literatura primaria indicada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y coincide el ETag. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de las ilustraciones científicas; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y los resultados de los artículos originales se atribuyen a sus respectivas fuentes.
Autor, versiones e historial de correcciones · /guides/synthetic-data-quality/v1/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770