
要旨
合成データはアノテーション費用の一部を削減できる一方、教師モデルの誤りを再現し、カバレッジを狭め、評価を汚染する可能性もある。本稿では、生成、選別、重複除去、学習を、有効なデータ分布を共同で決定する一連の過程として捉え、選別後に希少事象が少なくとも一度出現する確率を導出するとともに、この独立サンプリングモデルの限界を論じる。掲載図はモデル劣化の実験ではない。実際の効果は、独立した実データと固定した学習予算によって検証しなければならない。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
原文英語要旨の日本語訳
合成データのパイプラインを、サンプリングと選別のシステムとして評価する。正確性、カバレッジ、依存性を区別し、明示的な独立サンプリングモデルの下で希少事象の保持を導出するとともに、汚染を防ぐ対照条件を記述する。カバレッジ曲線は解析上のシナリオであり、モデル崩壊の実証結果ではない。生成されたコーパスの評価には、評価用に取り置いた実データと来歴情報が必要である。
1. データ量は有効な情報量ではない
百万件のテキストを生成しても、百万個の独立した学習信号が得られるとは限らない。類似したプロンプト、同一の教師モデル、反復されるテンプレート、類似した回答は、強い相関を生じさせる。品質についても、事実に照らした正確性、タスクとの関連性、言語的な利用可能性、対象集団のカバレッジをそれぞれ分けて定義すべきであり、単一のスコアでは異なる失敗が覆い隠される可能性がある。Self-Instructは、モデルが指示を生成し、それを選別する具体的な方法を提供するが、新たな状況では常に生成・フィルタリング規則の検証が必要であり、手法の名称を品質保証とみなすことはできない。[2] Self-Instruct: Aligning Language Models with Self-Gener
2. フィルタは誤りとカバレッジを同時に変える
フィルタリングは明白な誤りを減らしうる一方、一般的な内容、判定しやすい内容、教師モデルの選好に合致する内容を優先的に残す可能性もある。希少だが正しいサンプルが誤って棄却されやすい場合、そのようなサンプルは後続の学習でさらに不足する。全体の通過率だけを報告するのではなく、カテゴリごとの保持率を推定すべきである。フィルタと生成器が盲点を共有していれば、互いの誤りを正しいと認める可能性もある。人手によるレビューでは、リスクとロングテールに応じた層化サンプリングが必要であり、最も通過しやすい一群だけを確認してはならない。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener
3. ロングテールのカバレッジはまず確率計算で検討できる
ある事象の元の確率をp、選別によって保持される確率をqとし、n回の生成が独立であると仮定すると、少なくとも一度保持される確率は1−(1−pq)^nとなる。この式は、サンプリングの増加とロングテールの保持の改善が互いを補いうることを明確に示すが、一度の出現は十分な学習を意味しない。実際のサンプルに相関がある場合、教師モデルの分布の台が限られている場合、あるいは事象がそもそも生成されない場合には、独立モデルは過度に楽観的となる。図ではp=0.0001とし、qに1、0.5、0.1を用いているが、これはこの条件付きの関係を説明するためにすぎない。[1] Textbooks Are All You Need
4. 生成データの再帰的利用には実データの基準点を保持する必要がある
生成データを用いた再帰的学習に関する研究では、分布の裾部の喪失と誤差の蓄積のリスクが論じられている。その結論はモデル、データの混合、学習条件に依存しており、あらゆる合成データが必ず有害であるという主張に単純化することはできない。重要なのは、各サンプルの来歴上の世代、実データの割合、選別と再サンプリングの規則を記録し、固定した実データのテスト集合で層別の品質を追跡することである。現行モデルによる生成と同種のモデルによる評価を繰り返すと、外部の正解情報を欠いた閉ループが形成される可能性がある。[1] Textbooks Are All You Need
5. 重複除去と汚染の検査はファミリー単位で行うべきである
同じ元問題の言い換え、翻訳、教師モデルによる解説が、学習用とテスト用の分割をまたいで存在する可能性がある。文字列のハッシュだけを比較すると意味的な変種を見逃し、過度に強い意味的フィルタリングは正当な類似問題を誤って削除する可能性がある。サンプルのファミリー、生成プロンプト、出典リンクを保存し、分割前に関連する変種をまとめ、類似性による一致判定を人手で確認すべきである。学習データの重複除去に関する研究は、重複データが記憶と評価結果の解釈に影響することを示しており、合成データの処理ではこれらの検査を早い段階に組み込むべきである。[3] Deduplicating Training Data Makes Language Models Bette[2] Self-Instruct: Aligning Language Models with Self-Gener
6. 受け入れ判定には予算の統一と独立した実データによる評価が必要である
合成データの手法を比較する際は、ベースモデルと総学習トークン数を固定し、生成戦略、フィルタ、実データと合成データの混合比を別々に変える。最終的な学習スコアだけでなく、生成費用、人手によるレビュー費用、重複率、カテゴリ別のカバレッジを報告する。テストには、未見の実入力、希少な状況、教師モデルの誤り事例集合を含めるべきである。本稿のカバレッジ図は設計前の試算にすぎず、コーパスの品質認証ではなく、いずれかの混合比が最適であることを証明するものでもない。[1] Textbooks Are All You Need[2] Self-Instruct: Aligning Language Models with Self-Gener[3] Deduplicating Training Data Makes Language Models Bette
主要な数式と導出
(1) 独立同分布のサンプリングと一定の保持率を仮定する。一度の出現は十分な学習を保証しない。
LaTeX
P(\text{至少保留一次})=1-(1-pq)^n(2) 例ではp=10の負の4乗とする。実際のpとqは層化監査によって推定する必要がある。
LaTeX
\mathbb E[N_{\mathrm{rare}}]=npq(3) a(x)はサンプルが受け入れられる確率であり、フィルタが単に誤りを除去するだけでなく、分布全体を変えることを示す。
LaTeX
P_{\mathrm{kept}}(x)\propto P_{\mathrm{gen}}(x)\,a(x)手法とエビデンスのフロー
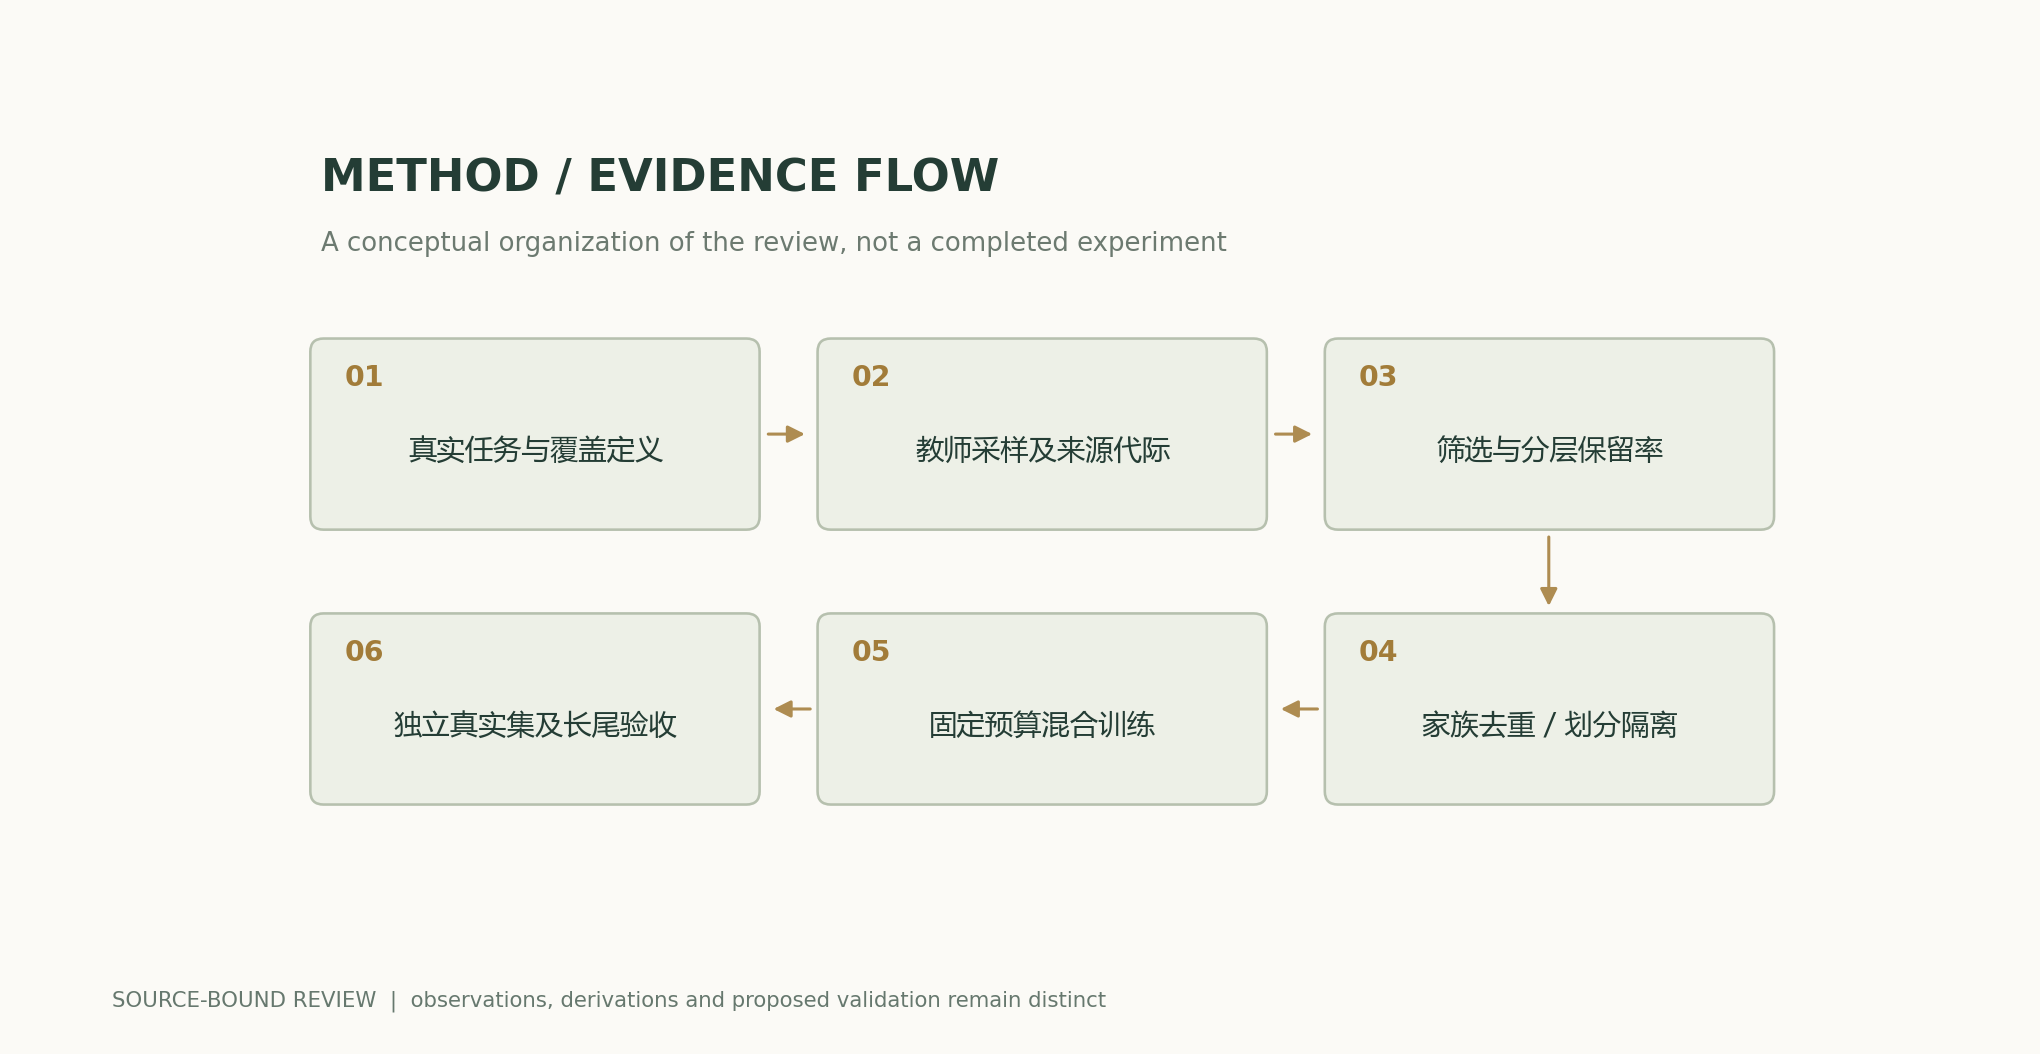
解析図と数値例
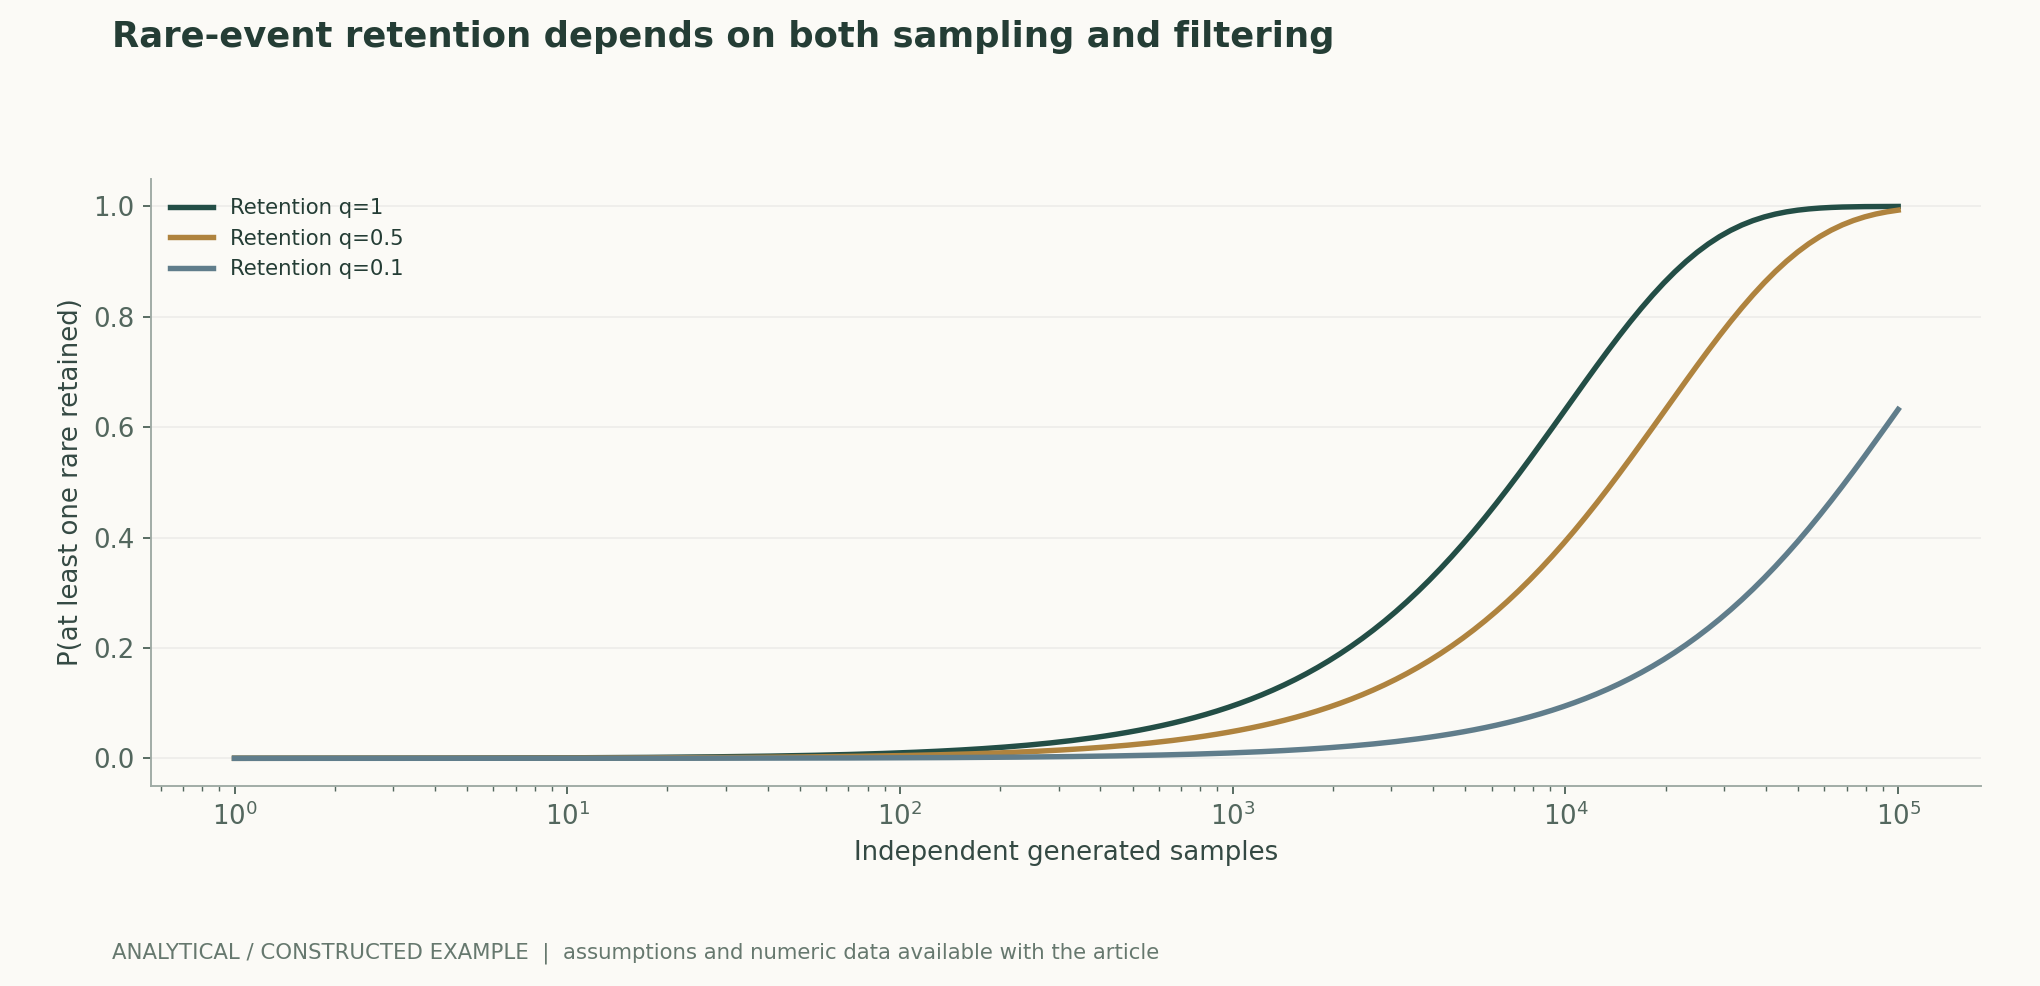
再計算可能な例題
n=10000のとき、少なくとも一度保持される確率は、q=1では約0.632、q=0.1では約0.095となる。生成結果の相関や教師モデルにおける当該パターンの欠如により、独立モデルは過度に楽観的となりうる。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 生成サンプル数 | 重複、ファミリー、カバレッジも併せて報告する | サンプルの増加は独立した情報の増加を保証しない |
| 品質フィルタリング | カテゴリごとに適合率と保持率を測定する | 全体の通過率はロングテールの誤棄却を覆い隠す |
| 再帰的学習 | 世代情報と実データの基準点を保持する | あらゆる合成データが必ず劣化をもたらすと外挿することはできない |
| 評価集合 | 独立した実データの出所とファミリー間の隔離を維持する | 教師モデルが自身の生成サンプルを評価すると循環的になりうる |
再検証と実験計画
- 対象タスクと品質の評価軸を事前に定義し、独立した実データのテスト集合を固定する。
- 生成モデル、プロンプト、サンプリング、来歴上の世代、各フィルタリング操作を記録する。
- ファミリー単位で分割し、完全一致と近似一致による重複除去を実施するとともに、意味的マッチングの偽陽性と偽陰性を抜き取り検査する。
- 一般的なカテゴリと希少なカテゴリごとに、正確性、保持率、独立性を監査する。
- 学習トークン数とベースモデルを固定し、フィルタと実データ・合成データの混合比についてアブレーションを行う。
- 生成、レビュー、学習の費用を公開し、教師モデルの失敗事例集合とロングテールの品質を報告する。
適用範囲と限界
- カバレッジモデルはサンプリングの独立性を仮定している。
- 新たなコーパス学習実験や劣化実験は実施していない。
- ロングテールの事例が一度出現しても、学習できるとは限らない。
- フィルタリングの品質とカバレッジは相反する可能性がある。
一次資料と主張の対応
- Textbooks Are All You Need, , , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled Textbooks Are All You Need, by Suriya Gunasekar and 18 other authors · 2023-06-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Self-Instruct: Aligning Language Models with Self-Generated Instructions, , , , , , · 2022-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿に関する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持する。
概念的な表紙画像と科学的な図解は区別している。科学図は公開された数式と明示した仮定から計算し、原論文の結果にはすべて帰属先を明記している。
著者、版、更正履歴 · /guides/synthetic-data-quality/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・版履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770