
Resumen
Un servicio que espera a muchas dependencias hereda una distribución de latencia distinta de la de cualquier dependencia individual. Esta revisión relaciona la amplificación por ramificación, las solicitudes redundantes y la realimentación de las colas para explicar por qué optimizaciones locales aparentemente satisfactorias pueden fracasar en el límite de la aplicación. The Tail at Scale motiva la atención a los componentes más lentos; los trabajos sobre redundancia establecen que las solicitudes adicionales pueden reducir la latencia bajo supuestos específicos sobre los recursos; Homa examina mecanismos de transporte para mensajes cortos. Derivamos probabilidades de ramificación con ramas independientes y un modelo de carga deliberadamente simplificado, y después utilizamos enumeración finita para comprobar el cálculo de probabilidades. Estos modelos separan un beneficio de los estadísticos de orden de su posible coste en recursos. No predicen el comportamiento de un servicio desplegado sin mediciones de llegadas, correlación, cancelación y planificación. El protocolo de evaluación propuesto trata los plazos de extremo a extremo, el trabajo que consume recursos y la equidad como resultados conjuntos, en lugar de informar únicamente de un percentil favorable.
1. El grafo de la solicitud es la unidad de análisis
Una solicitud de usuario rara vez corresponde a un único tiempo de servicio aislado. Puede autenticar, recuperar un índice, contactar con varios fragmentos, ordenar candidatos y escribir un registro de auditoría. Una dependencia secuencial contribuye de forma distinta de una dependencia paralela, y una respuesta que espera a todos los fragmentos difiere de otra que puede devolverse tras alcanzar un cuórum. Por tanto, una prueba de rendimiento debe especificar el grafo de dependencias y la regla de finalización antes de resumir la latencia. De lo contrario, una afirmación como «el backend tiene una latencia de cola de diez milisegundos» deja sin definir su objeto experimental. La unidad útil es una operación de aplicación completada, incluidos los reintentos y el trabajo infructuoso que consumió parte de su plazo. Esta perspectiva también cambia la instrumentación: una traza debe conectar la creación de ramas, la admisión en cola, la cancelación y la respuesta final, en lugar de tratar cada llamada remota satisfactoria como una muestra independiente.
2. Qué establecen las fuentes fundamentales
Dean y Barroso describen cómo los grandes servicios amplifican el efecto de los componentes ocasionalmente lentos y analizan mecanismos para controlar el comportamiento de la cola de la distribución. Vulimiri y sus colaboradores estudian el trabajo redundante como técnica para reducir la latencia, cuyos efectos dependen de los recursos disponibles y de las características del servicio. Homa diseña un transporte para llamadas a procedimientos remotos en centros de datos, con énfasis en la latencia de los mensajes cortos y la planificación dirigida por el receptor. Estas contribuciones abordan capas diferentes. No puede suponerse que una solicitud de cobertura a nivel de aplicación, una decisión de prioridad del transporte y una reducción de la interferencia en la planificación se combinen de forma aditiva. Su enseñanza común es identificar el cuello de botella y la regla de finalización. Esta revisión utiliza sus mecanismos como referentes conceptuales; no transfiere las aceleraciones que comunican a una implementación sin medir. [1], [2], [3]
3. Un suceso poco frecuente se convierte en un resultado habitual de la aplicación
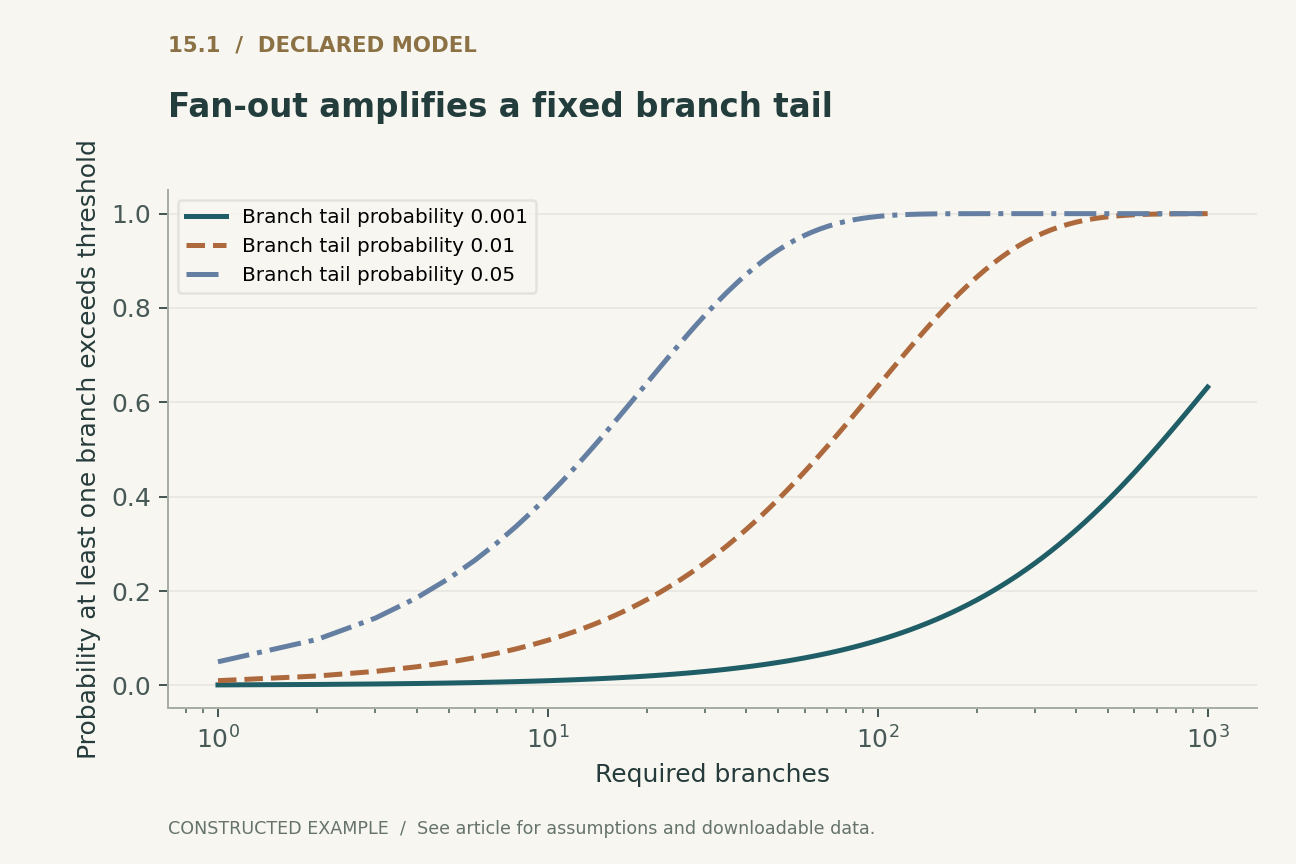
Supongamos que una rama supera un umbral fijo con probabilidad p, de forma independiente entre n ramas. Si todas las ramas deben terminar, la probabilidad de que al menos una supere el umbral es uno menos la probabilidad de que ninguna lo supere. Con p igual a 0.01 y n igual a 100, el resultado es aproximadamente 0.634. Así, un suceso descrito como una cola del uno por ciento a nivel de rama puede afectar a la mayoría de las solicitudes compuestas. El umbral debe mantenerse idéntico en este cálculo; no se pueden combinar percentiles distintos de las ramas como si describieran el mismo suceso. Tampoco cubre la fórmula la finalización por cuórum. Para un cuórum, un estadístico de orden sustituye al máximo y la cola binomial correspondiente debe ajustarse al número de respuestas requeridas.
4. La independencia es un supuesto diagnóstico
Las ramas reales comparten conmutadores, hosts, particiones de almacenamiento, recolectores de basura, oleadas de despliegue y controladores de admisión previos. Su dependencia modifica la distribución del máximo. Bajo dependencia positiva perfecta, añadir ramas idénticas no multiplica la probabilidad de un episodio lento común; con fallos compartidos heterogéneos, puede generar un comportamiento multimodal que un único coeficiente de correlación oculta. Por tanto, el cálculo independiente es un caso de referencia transparente, no una cota superior universal. Un análisis útil de trazas conserva las marcas temporales conjuntas y las etiquetas de ubicación compartida. Volver a muestrear cada rama por separado destruye precisamente la dependencia que un experimento de extremo a extremo necesita conservar. Una prueba debe incluir tanto ruido sintético independiente como interferencia sincronizada, para que cualquier mejora alegada tenga un ámbito de funcionamiento identificable.
5. El beneficio de una solicitud de cobertura antes de considerar las colas
Supongamos que un intento original tiene una función de supervivencia S(t), y que un duplicado independiente comienza tras un retraso d con la misma distribución del tiempo de servicio. Antes de d, la supervivencia del tiempo de finalización sigue siendo S(t). Después pasa a ser S(t) multiplicada por S(t menos d), siempre que el primer resultado satisfactorio termine la operación y ambos intentos sigan siendo aptos para completarse. Este es un cálculo con distribución fija: se supone que lanzar un duplicado no ralentiza ninguno de los intentos ni ninguna otra solicitud. Ese supuesto es más sólido cuando hay mucha capacidad libre. Falla cuando el trabajo redundante ocupa un trabajador escaso o crea contención por un bloqueo compartido en un componente posterior. Un duplicado también necesita una identidad de operación segura; devolver la primera respuesta no hace que dos escrituras sean semánticamente equivalentes a una.
6. Por qué contabilizar los recursos puede invertir el resultado
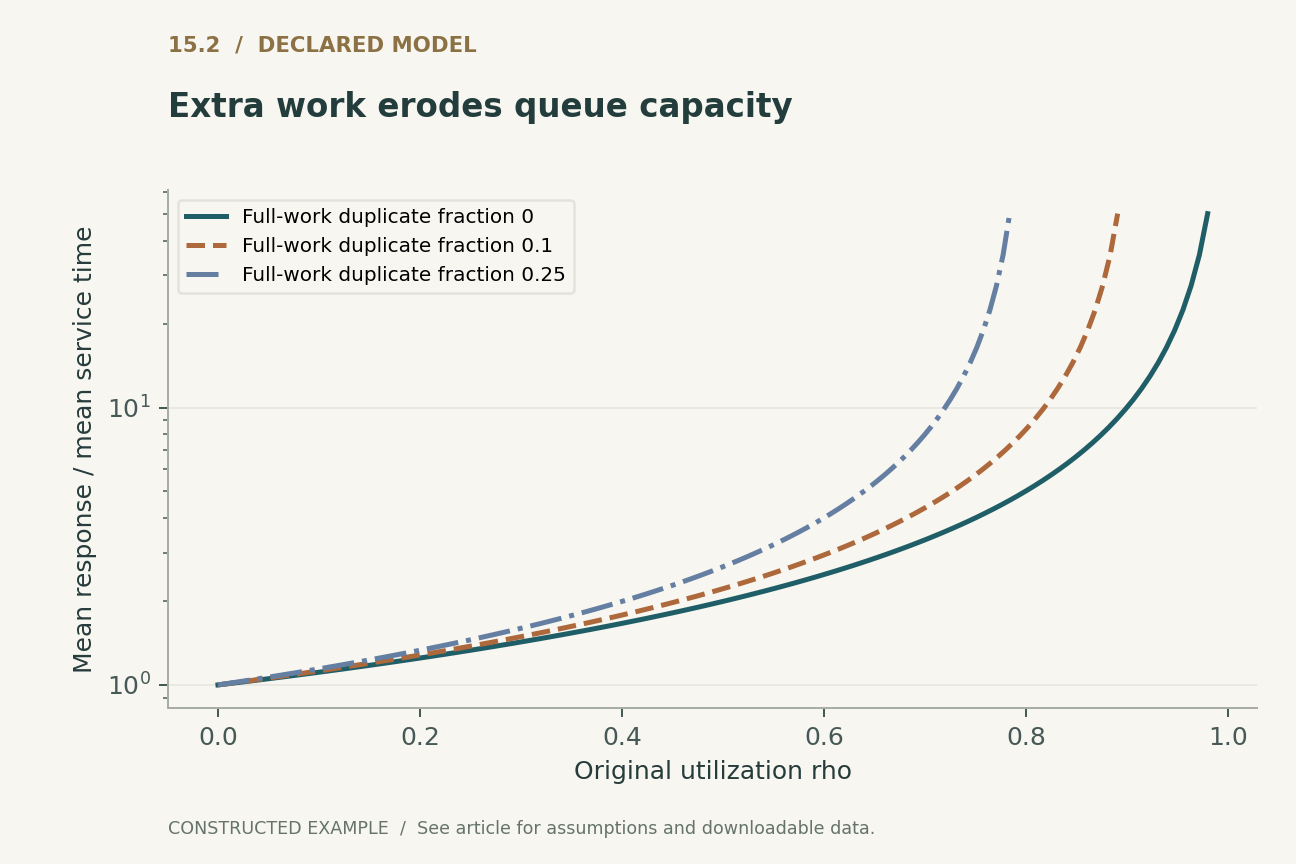
Consideremos una cola de referencia M/M/1 con utilización rho. Si una fracción h de las solicitudes crea un duplicado que realiza una unidad adicional completa de trabajo esperado, la utilización ofrecida pasa a ser (1 más h) multiplicado por rho. El multiplicador del tiempo medio de respuesta es la razón entre los márgenes de capacidad restante, mientras la cola sea estable. Con rho igual a 0.8 y h igual a 0.25, la nueva utilización alcanza la unidad; el modelo carece de una media estacionaria finita. Esto no predice el comportamiento de una solicitud de cobertura cancelada eficientemente. Es un caso adverso explícito que muestra que el beneficio de un estadístico de orden puede desaparecer cuando se ignora la conservación del trabajo. Las figuras presentan únicamente la región estable e indican los supuestos, en lugar de trazar una curva finita a través de la inestabilidad.
7. La cancelación tiene un punto de finalización observable
Enviar un mensaje de cancelación no demuestra que el trabajo se haya detenido. Una base de datos puede haber confirmado ya la transacción, un kernel de GPU puede no ser interrumpible y un trabajador puede advertir la cancelación solo después de su siguiente llamada bloqueante. Mida el intervalo entre la solicitud de cancelación y la liberación efectiva de los recursos. Incluya tanto el intento ganador como los abandonados al contabilizar tiempo de CPU, bytes, asignaciones y solicitudes a servicios posteriores. Para los efectos secundarios, utilice idempotencia a nivel de aplicación con un límite de persistencia adecuado; un identificador de solicitud de transporte no basta por sí solo. El criterio de aceptación debe especificar si la cancelación es de mejor esfuerzo o un contrato de recursos exigible. Un sistema que solo registra la latencia de los intentos satisfactorios puede ocultar su mayor coste en intentos perdedores invisibles.
8. Un experimento capaz de distinguir mecanismos
Comience con un proceso de llegadas, una distribución de tamaños de solicitud, un grafo de ramificación y un límite de capacidad documentados. Compare la misma carga de trabajo con la cobertura desactivada, con duplicación inmediata y con varias políticas diferidas. Separe los cambios en la carga ofrecida de los cambios en la prioridad de planificación. Utilice un generador de llegadas en bucle abierto cuando la afirmación se refiera a una tasa externa de llegadas fija; un cliente en bucle cerrado puede reducir automáticamente la carga cuando el servicio se ralentiza y, con ello, ocultar la sobrecarga. Informe de los incumplimientos de plazos y las solicitudes incompletas junto con los cuantiles de latencia. Reconstruya el trabajo que consume recursos a partir de todos los intentos. Una comparación equitativa también comprueba si los inquilinos sin cobertura sufren mayor latencia de cola, porque una mejora obtenida trasladando retrasos a otros inquilinos es un resultado distinto de aumentar la eficiencia del servicio.
9. Qué comprueba realmente el apéndice ejecutable
El apéndice enumera todas las asignaciones de estados lento o rápido para pequeños grupos de ramificación independientes, suma sus probabilidades y compara el resultado con la expresión cerrada. También comprueba el ejemplo de 100 ramas y el límite de estabilidad de la cola. Son comprobaciones finitas de coherencia matemática. No simulan un centro de datos, no validan una pila de red ni estiman un percentil de un servicio real. La primera figura varía el número de ramas y la probabilidad declarada de que una rama supere un umbral fijo. La segunda varía la utilización y la fracción de duplicación con trabajo completo. Su propósito es hacer visible una posible inversión del resultado. Una investigación en producción debería sustituir estas entradas ilustrativas por distribuciones conjuntas medidas y verificar el simulador con trazas reservadas para validación.
10. Una regla práctica de decisión
Una intervención sobre la latencia de cola resulta convincente cuando mejora una métrica de finalización de la aplicación dentro de un intervalo de carga declarado, respetando un presupuesto de recursos y equidad. Debe seguir siendo beneficiosa bajo interferencias compartidas plausibles y fallar de forma predecible cerca de la sobrecarga. La política necesita una condición de desactivación, como un umbral de profundidad de cola o de saturación, además de evidencia de que esa condición puede observarse con suficiente rapidez. No reduzca toda la decisión a una única cifra p99. El mejor diseño puede utilizar menos ramas, un contrato de resultados parciales, mejor control de admisión o menor latencia de cancelación, en lugar de más duplicación. La contribución científica consiste en identificar qué mecanismo modifica la distribución de extremo a extremo y dónde deja de ser válida esa explicación.
Ejecutado localmente · Alcance acotado
Enumeración de ramificación independiente y un límite de sobrecarga
Sucesos binarios independientes en las ramas y contabilización de carga M/M/1; sin trazas de servicio.
10 aserciones superadas. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "hundred_branch_probability": 0.6339676587267709,
  "unstable_utilization": 1.0
}
Descargar los 20 ejemplos ejecutablesLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Ramas independientes e idénticamente distribuidas; se requieren las n respuestas y p(t) se refiere a un único umbral común.
(2) El duplicado comienza en d; los intentos son independientes y sus distribuciones de servicio no cambian con la duplicación.
(3) Un modelo de contabilización deliberadamente adverso: una fracción h de las solicitudes duplica una unidad completa de trabajo esperado.
(4) Razón de tiempos medios de respuesta M/M/1 con capacidad de servicio invariable; fuera de la región estable no está definida como media estacionaria.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Afirmación | Medición necesaria | Omisión habitual |
|---|---|---|
| Las solicitudes de cobertura reducen la latencia | Finalizaciones de extremo a extremo con igual carga externa | Solicitudes canceladas o con tiempo de espera agotado |
| La cancelación ahorra trabajo | Liberación efectiva de recursos y trabajo de todos los intentos | Solo el acuse de recibo de la cancelación |
| La ramificación es segura | Comportamiento conjunto de las ramas y regla de finalización | Histogramas marginales independientes |
| La política es eficiente | Trabajo total e impacto en otros inquilinos | Solo la latencia del intento ganador |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Especificar el grafo de dependencias, el plazo y la regla de finalización por todas las respuestas o por cuórum.
- Generar cargas de trabajo equivalentes en bucle abierto a lo largo de un intervalo de utilización declarado de antemano.
- Registrar cada intento, solicitud de cancelación, evento de liberación de recursos y efecto secundario.
- Incluir interferencia correlacionada y un inquilino de control sin cobertura.
- Comparar latencia de extremo a extremo, probabilidad de fallo, trabajo total y equidad.
- Publicar trazas de llegadas, semillas, reglas de exclusión y el umbral de desactivación por sobrecarga.
Qué establecen las fuentes primarias
Jeffrey Dean, Luiz André Barroso · 2013 [1]
Contribución. Una gran ramificación motiva la atención a nivel de aplicación a los componentes ocasionalmente lentos.
Límite. Importan el mecanismo y el contexto de la carga de trabajo; aquí no se transfiere ninguna aceleración.
Localización en la fuente. The Tail at Scale, discusión del artículo.
Ashish Vulimiri, Philip Brighten Godfrey, Radhika Mittal et al. · 2013 [2]
Contribución. Las solicitudes redundantes pueden reducir la latencia bajo supuestos específicos sobre recursos y servicio.
Límite. La carga adicional y la cancelación pueden modificar la distribución durante el funcionamiento.
Localización en la fuente. Manuscrito del autor, resumen y modelo de redundancia.
Behnam Montazeri, Yilong Li, Mohammad Alizadeh et al. · 2018 [3]
Contribución. La planificación del transporte puede afectar a la latencia RPC de los mensajes cortos.
Límite. Un resultado de transporte no establece una política de solicitudes de cobertura a nivel de aplicación.
Localización en la fuente. Homa, resumen y diseño del protocolo.
Límites de este análisis
- No se recopilaron trazas de producción ni resultados de pruebas de rendimiento de red para este artículo.
- Las ramas independientes y las colas M/M/1 son modelos de referencia, no descripciones que se afirme que corresponden a Homa o a un servicio desplegado.
- El modelo de duplicación con trabajo completo excluye deliberadamente la cancelación temprana satisfactoria.
- La enumeración finita valida fórmulas en casos pequeños y no valida una implementación distribuida completa.
Una revisión analítica centrada en tres fuentes primarias fundamentales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la bibliografía hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Puede incorporarse la latencia de cancelación a un presupuesto de trabajo en línea con un error de estimación acotado?
- ¿Cómo debería una política de cobertura tener en cuenta los estados de cola correlacionados entre réplicas?
- ¿Qué contratos de resultados parciales reducen la amplificación por ramificación sin alterar las conclusiones científicas?
Referencias
- Jeffrey Dean, Luiz André Barroso. The tail at scale. Communications of the ACM (2013). 10.1145/2408776.2408794.
- Ashish Vulimiri, Philip Brighten Godfrey, Radhika Mittal et al.. Low latency via redundancy. Proceedings of the ninth ACM conference on Emerging networking experiments and technologies (2013). 10.1145/2535372.2535392.
- Behnam Montazeri, Yilong Li, Mohammad Alizadeh et al.. Homa: a receiver-driven low-latency transport protocol using network priorities. Proceedings of the 2018 Conference of the ACM Special Interest Group on Data Communication (2018). 10.1145/3230543.3230564.
Acceso a la fuente [1]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [3]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo ni del material suplementario.
Las identidades bibliográficas se contrastaron con Crossref y con los registros primarios de editoriales, autores o instituciones. Las notas sobre acceso a las fuentes y versiones que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos enunciados; no constituyen una verificación formal de los sistemas citados.