
摘要
需要等待许多依赖项的服务,会承接一种不同于任一单独依赖项的延迟分布。本综述将扇出放大、冗余请求与排队反馈联系起来,解释为何看似成功的局部优化会在应用边界处失效。The Tail at Scale 阐明了关注最慢组件的必要性;冗余相关研究表明,在特定资源假设下,额外请求能够降低延迟;Homa 则考察面向短消息的传输层机制。我们推导独立分支的扇出概率和一个刻意简化的负载模型,再用有限枚举检查概率计算。这些模型将次序统计量带来的收益与其潜在资源成本区分开来。若没有到达过程、相关性、取消及调度方面的测量,它们无法预测已部署服务的表现。所提出的评估方案将端到端截止期限、资源工作量与公平性视为需要共同考察的结果,而非只报告一个有利的百分位数。
1. 请求图是分析单位
用户请求很少只对应一个孤立的服务时间。它可能需要进行身份验证、检索索引、联系多个分片、对候选项排序并写入审计记录。串行依赖与并行依赖的贡献方式不同,等待所有分片的响应也不同于达到法定数量后即可返回的响应。因此,基准测试必须先明确依赖图与完成规则,再概括延迟。否则,“后端的尾延迟为十毫秒”之类的说法,其实验对象仍未定义。有效的分析单位是一次已完成的应用操作,其中包括重试,以及消耗了其截止期限内时间但未成功的工作。这一视角也会改变观测方式:跟踪记录应将分支创建、队列准入、取消和最终响应联系起来,而不是把每次成功的远程调用都当作独立样本。
2. 奠基性文献确立了什么
Dean 和 Barroso 描述了大型服务如何放大偶发慢组件的影响,并讨论了控制尾部行为的机制。Vulimiri 及其同事研究了将冗余工作用作降低延迟的技术,其效果取决于可用资源与服务特性。Homa 为数据中心远程过程调用设计了一种传输协议,重点关注短消息延迟与接收端驱动的调度。这些贡献针对不同层次。不能假定应用层对冲、传输优先级决策与调度干扰的减少能够产生可加的组合效果。它们共同的启示是明确瓶颈与完成规则。本综述以这些机制作为概念支点,不会将它们报告的加速效果移用到未经测量的实现上。 [1], [2], [3]
3. 罕见事件成为常见的应用结果
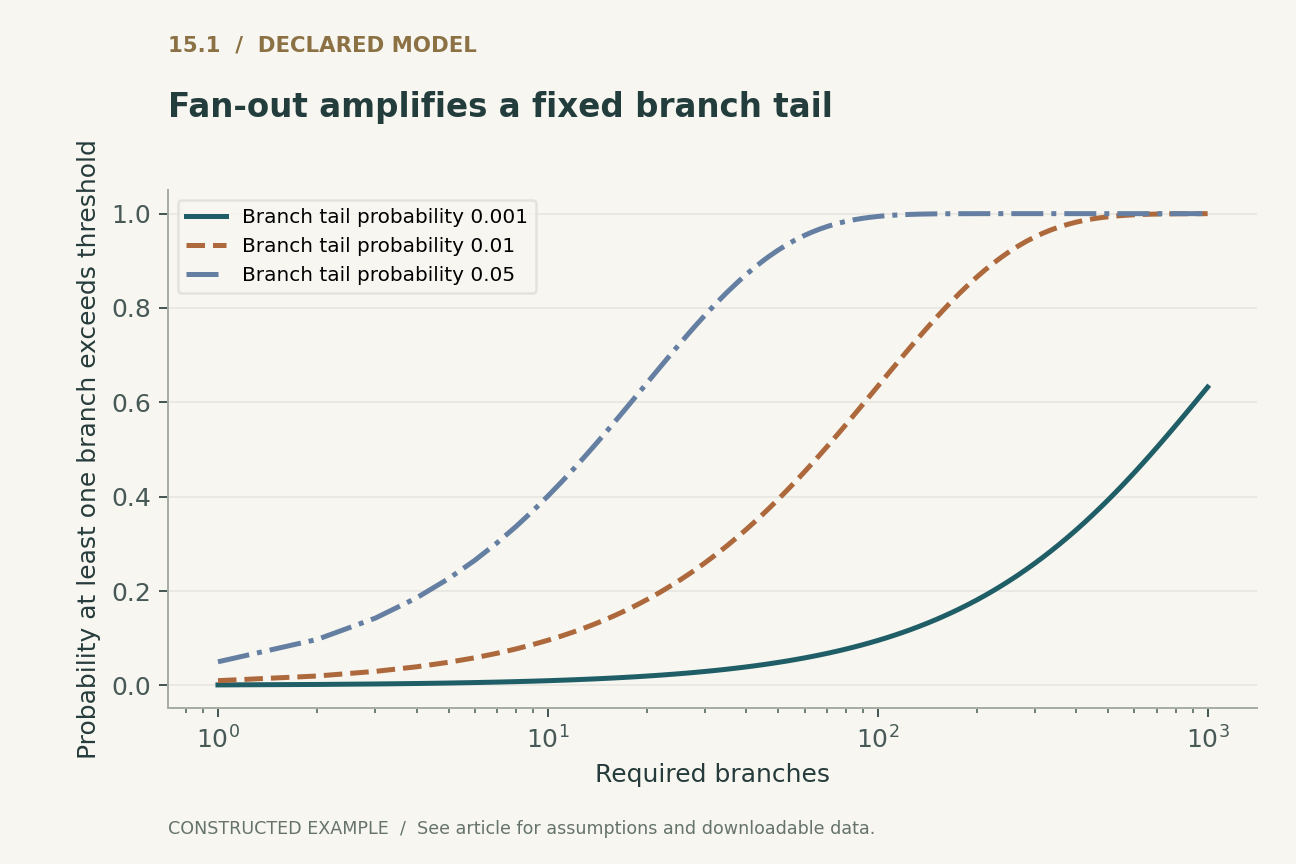
设一个分支超过固定阈值的概率为 p,且 n 个分支之间相互独立。如果所有分支都必须完成,那么至少一个分支超过阈值的概率,等于一减去没有任何分支超过阈值的概率。当 p 为 0.01、n 为 100 时,结果约为 0.634。因此,在分支层面被描述为百分之一尾部事件的情况,可能影响大多数复合请求。在这一计算中,阈值必须保持一致;不能将不同的分支百分位数混合起来,仿佛它们描述的是同一事件。该公式也不涵盖达到法定数量即完成的情形。对于法定数量完成规则,应以相应的次序统计量替代最大值,且对应的二项分布尾概率必须与所需响应数量匹配。
4. 独立性是一项诊断性假设
真实分支会共享交换机、主机、存储分区、垃圾回收器、部署批次以及上游准入控制器。它们之间的依赖关系会改变最大值的分布。在完全正依赖下,增加相同分支并不会成倍增加共同慢事件的概率;在异质性共享故障下,则可能产生单一相关系数无法揭示的多峰行为。因此,独立性计算是一个透明的参照情形,而非普适上界。有效的跟踪分析应保留各分支之间对应的时间戳与共享部署位置标签。对每个分支单独重采样,恰恰会破坏端到端实验需要保留的依赖关系。测试应同时包含独立合成噪声与同步干扰,使任何声称的改进都有可辨识的运行适用范围。
5. 计入排队影响之前,对冲请求的收益
假设原始尝试的生存函数为 S(t),一个独立副本在延迟 d 后启动,并具有相同的服务时间分布。在 d 之前,完成时间的生存函数仍为 S(t)。此后,在首个成功结果结束操作且两次尝试均保持可完成状态的前提下,它变为 S(t) 与 S(t 减 d) 的乘积。这是一项固定分布计算:它假设启动副本不会减慢任一次尝试,也不会减慢任何其他请求。当富余容量较大时,这一假设最有依据。当冗余工作占用稀缺工作线程,或引发对共享下游锁的争用时,该假设便不成立。副本还需要安全的操作身份标识;返回首个响应,并不会让两次写入在语义上等同于一次写入。
6. 为什么资源核算可能逆转结果
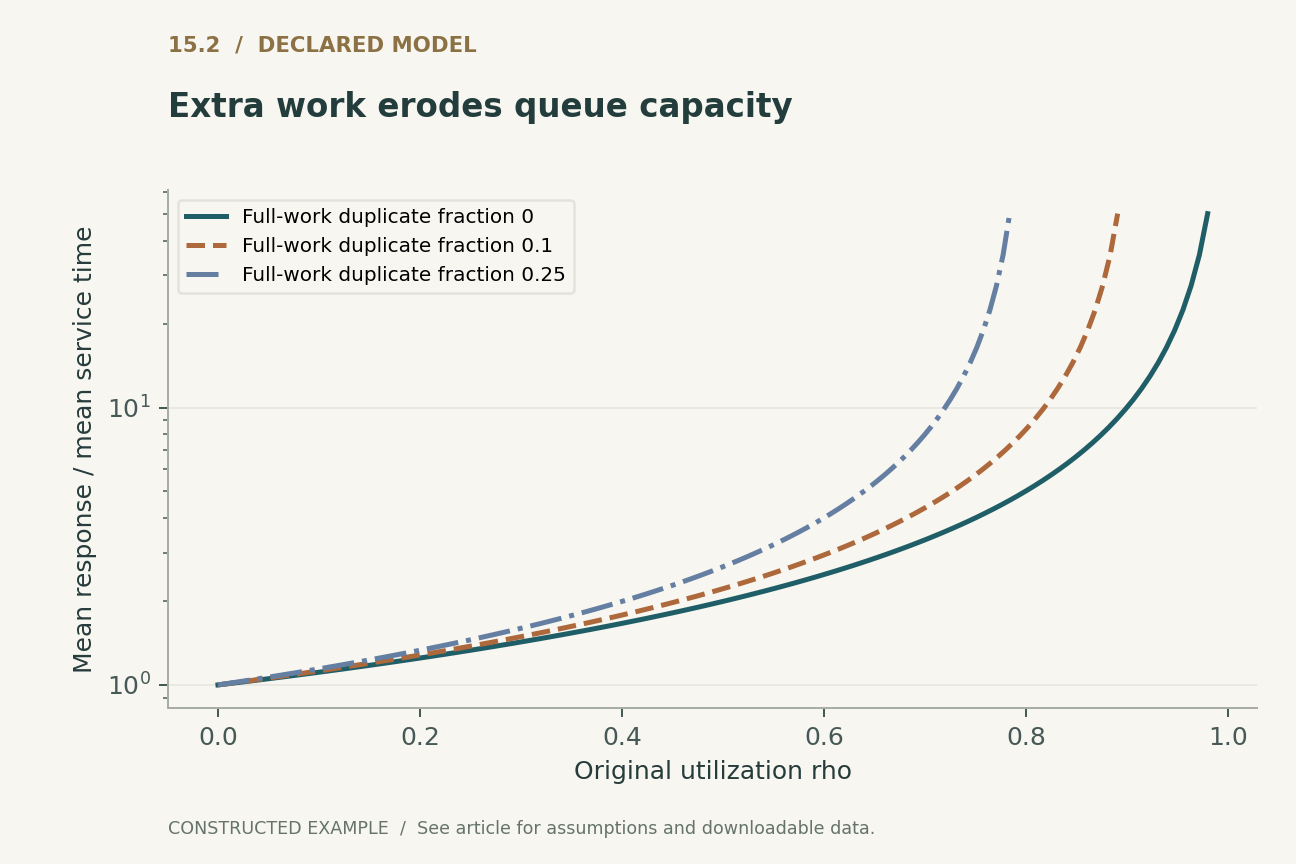
考虑一个利用率为 rho 的 M/M/1 参考队列。如果比例为 h 的请求会创建副本,且副本执行一个完整的额外预期工作单位,那么所提供负载对应的利用率变为(1 加 h)乘以 rho。在队列保持稳定时,平均响应时间的倍数等于剩余容量裕量之比。当 rho 为 0.8、h 为 0.25 时,新的利用率达到一;此时模型不存在有限的稳态均值。这并不是对高效取消的对冲请求所作的预测,而是一个明确的不利案例,表明忽视工作量守恒时,次序统计量带来的收益可能消失。图中仅呈现稳定区域并标明假设,而不是绘制一条穿过不稳定区域的有限值曲线。
7. 取消具有可观测的完成时点
发送取消消息并不能证明工作已经停止。数据库可能已经提交,GPU 内核可能不可抢占,工作线程也可能直到下一次阻塞调用之后才察觉取消。应测量从发出取消请求到实际释放资源之间的时间间隔。核算 CPU 时间、字节数、内存分配及下游请求时,既要计入获胜尝试,也要计入被放弃的尝试。对于副作用,应使用具有适当持久化边界的应用层幂等性;仅有传输层请求标识符并不足够。验收标准应说明,取消是尽力而为,还是强制执行的资源契约。只记录成功尝试延迟的系统,可能把最大的成本隐藏在不可见的失败竞争尝试中。
8. 能够区分机制的实验
首先记录到达过程、请求大小分布、扇出图与容量限制。对同一工作负载,比较关闭对冲、立即复制以及若干延迟策略。将所提供负载的变化与调度优先级的变化分开。当所考察的主张涉及固定外部到达率时,应使用开环到达生成器;闭环客户端可能在服务变慢时自动降低负载,从而掩盖过载。除延迟分位数外,还应报告截止期限违约与未完成请求。根据所有尝试重建资源工作量。公平的比较还需检查,未使用对冲的租户是否承受了更高尾延迟,因为将延迟转嫁给其他租户所换来的改进,与提高服务效率是不同的结果。
9. 可执行附录实际检查了什么
附录枚举了小规模独立扇出组中所有慢或快状态的分配,累加其概率,并将结果与闭式表达式比较。它还检查了 100 个分支的示例以及队列稳定性边界。这些是有限的数学一致性检查。它们不模拟数据中心,不验证网络协议栈,也不估计真实服务的百分位数。第一幅图改变分支数量,以及预先声明的分支超过固定阈值的概率。第二幅图改变利用率与完整工作量复制比例,其目的是让潜在的结果逆转清晰可见。生产环境调查应以实测联合分布替代这些示意性输入,并用留出的跟踪记录验证模拟器。
10. 一条实用决策规则
当一项尾延迟干预措施在声明的负载范围内改善应用完成指标,同时遵守资源与公平性预算时,它才具有说服力。它应在合理可预期的共享干扰下仍然有益,并在接近过载时以可预测的方式失效。策略需要禁用条件,例如队列深度或饱和度阈值,还需要证据证明能够足够迅速地观测到该条件。不要把整个决策简化为一个 p99 数值。最优设计可能采用更少的分支、部分结果契约、更好的准入控制或更短的取消延迟,而非更多复制。科学贡献在于辨识哪种机制改变了端到端分布,以及这一解释从何处开始不再成立。
本地已执行 · 范围有限
独立扇出枚举与过载边界
独立二元分支事件与 M/M/1 负载核算;未使用服务跟踪记录。
10 项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
检查已记录的验证见证
{
  "hundred_branch_probability": 0.6339676587267709,
  "unstable_utilization": 1.0
}明确声明的分析模型
四个方程,明确的假设
(1) 分支独立同分布;需要全部 n 个响应,且 p(t) 对应同一个共同阈值。
(2) 副本在 d 时启动;各次尝试相互独立,且其服务时间分布不因复制而改变。
(3) 刻意设置的不利核算模型:比例为 h 的请求会复制一个完整的预期工作单位。
(4) 服务容量保持不变时的 M/M/1 平均响应时间比;在稳定区域之外,作为稳态均值的该量无定义。
构造示例 · 可复现数据
检查定量论证
这些曲线由所声明的模型计算得出,并非所引用研究中的观测结果。每幅图均附有数值数据与矢量版本。


哪类证据回答哪类问题?
| 主张 | 必要测量 | 常见遗漏 |
|---|---|---|
| 对冲降低延迟 | 相同外部负载下的端到端完成情况 | 已取消或超时的请求 |
| 取消节省工作量 | 实际资源释放与所有尝试的工作量 | 只查看取消确认 |
| 扇出是安全的 | 分支联合行为与完成规则 | 相互独立的边际直方图 |
| 策略是高效的 | 总工作量及对其他租户的影响 | 只查看获胜尝试的延迟 |
一项拟议验证方案
这是一项拟议的评估设计。未开展生产系统或硬件基准测试。另行执行的有限模型记录在可执行检查部分。
- 明确依赖图、截止期限,以及等待全部响应还是达到法定数量即完成的规则。
- 在预先声明的利用率范围内生成相互匹配的开环工作负载。
- 记录每次尝试、取消请求、资源释放事件与副作用。
- 纳入相关干扰以及一个不使用对冲的对照租户。
- 比较端到端延迟、失败概率、总工作量与公平性。
- 公布到达跟踪记录、随机种子、排除规则与过载禁用阈值。
一手文献确立了什么
Jeffrey Dean, Luiz André Barroso · 2013 [1]
贡献。 大规模扇出促使应用层关注偶发的慢组件。
适用边界。 机制与工作负载情境十分重要;本文不移用任何加速效果。
文献定位。 The Tail at Scale,文章中的讨论。
Ashish Vulimiri, Philip Brighten Godfrey, Radhika Mittal et al. · 2013 [2]
贡献。 在特定资源与服务假设下,冗余请求能够降低延迟。
适用边界。 额外负载与取消可能改变运行时分布。
文献定位。 作者稿,摘要与冗余模型。
Behnam Montazeri, Yilong Li, Mohammad Alizadeh et al. · 2018 [3]
贡献。 传输调度可能影响短消息 RPC 延迟。
适用边界。 传输层的结果不能确立应用层对冲策略的有效性。
文献定位。 Homa,摘要与协议设计。
本分析的局限
- 本文未采集生产环境跟踪记录或网络基准测试结果。
- 独立分支与 M/M/1 队列是参考模型,并非声称其描述了 Homa 或已部署服务。
- 完整工作量复制模型刻意排除了成功的提前取消。
- 有限枚举验证的是小规模情形下的公式,并不验证完整的分布式实现。
这是一篇聚焦于三项选定的奠基性一手文献的分析性综述,包含原创的演算示例。它并非对截至 2026 年的文献所作的穷尽性或系统性调查。文献访问范围与版本说明随参考文献一并记录。
可能改变结论的问题
- 能否在估计误差有界的条件下,将取消延迟纳入在线工作量预算?
- 对冲策略应如何考虑副本之间相关的队列状态?
- 哪些部分结果契约能够在不改变科学结论的前提下减少扇出放大?
参考文献
- Jeffrey Dean, Luiz André Barroso. The tail at scale. Communications of the ACM (2013). 10.1145/2408776.2408794.
- Ashish Vulimiri, Philip Brighten Godfrey, Radhika Mittal et al.. Low latency via redundancy. Proceedings of the ninth ACM conference on Emerging networking experiments and technologies (2013). 10.1145/2535372.2535392.
- Behnam Montazeri, Yilong Li, Mohammad Alizadeh et al.. Homa: a receiver-driven low-latency transport protocol using network priorities. Proceedings of the 2018 Conference of the ACM Special Interest Group on Data Communication (2018). 10.1145/3230543.3230564.
文献 [1] 访问范围。 一手记录、摘要及选定的可访问正文;并非对全文或补充材料的穷尽性审查。
文献 [2] 访问范围。 一手记录、摘要及选定的可访问正文;并非对全文或补充材料的穷尽性审查。
文献 [3] 访问范围。 一手记录、摘要及选定的可访问正文;并非对全文或补充材料的穷尽性审查。
书目身份信息已依据 Crossref 以及原始出版商、作者或机构的记录核对。下文的文献访问与版本说明描述了核查范围;这并非穷尽性的全文审查。
作者与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析构造与拟议评估设计归于本文。
封面为 ImageGen 概念插图。技术图表根据已声明的模型或有限示例计算生成,并提供 Python 与 CSV。它们不是已部署产品的测量结果,也不是复现的性能基准测试。
这份本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查了所述小型模型;它们并非对所引用系统的形式化验证。