
Resumen
Los modelos fundacionales de célula única pueden aprender representaciones amplias de la expresión génica, pero la exigencia más estricta para una «célula virtual» es predecir las respuestas celulares tras intervenciones no vistas. Un estudio de 2025 constató que varios métodos de aprendizaje profundo no superaban de forma consistente referencias lineales simples; otro estudio de 2026 señaló que los genes de fondo no afectados por la perturbación pueden diluir las métricas habituales, y que las métricas calibradas pueden revelar mejoras de los métodos profundos frente a referencias no informativas. Este artículo no reduce ambos hallazgos a una inversión entre ganadores y perdedores, sino que analiza cómo las tareas, las métricas y los controles determinan conjuntamente las conclusiones. Presentamos un marco cuyos cálculos pueden reproducirse para efectos dispersos, interacciones entre perturbaciones combinadas y estratificación estadística, y proponemos un diseño de validación prospectiva.[3] Deep-learning-based gene perturbation effect prediction[4] Deep learning perturbation models can outperform baseli[2] scGPT: toward building a foundation model for single-ce
Traducción del resumen original en inglés
Una célula virtual útil debe predecir las respuestas a las intervenciones, no limitarse a reconstruir perfiles de expresión conocidos. Examinamos Geneformer, scGPT y evaluaciones comparativas de perturbaciones con resultados contrastantes de 2025 y 2026. Una construcción explícita de efectos dispersos demuestra la dilución de las métricas, y un análisis de aditividad frente a interacción aísla el contenido científico de la predicción de combinaciones. Distinguimos entre replicación a nivel celular, generalización a nivel de perturbación y predicción de distribuciones, y proponemos después un protocolo prerregistrado con múltiples métricas y controles positivos y negativos.
1. La calidad de las representaciones y la predicción de intervenciones son capacidades distintas
Geneformer y scGPT exploran, cada uno, el preentrenamiento a gran escala y la adaptación a tareas posteriores. Que un modelo forme representaciones claras de los tipos celulares indica que ha captado estructura útil en la expresión; sin embargo, predecir intervenciones génicas no vistas también requiere vincular la identidad de la intervención, el contexto celular y el tiempo con la respuesta. Si el entrenamiento y la prueba solo separan distintas células sometidas a la misma perturbación, la evaluación puede comprobar principalmente la reconstrucción, en vez de la generalización a nuevas perturbaciones. Este artículo considera las «células no vistas», las «intervenciones no vistas», las «combinaciones no vistas» y los «contextos no vistos» como problemas diferentes. Cada uno debe comunicarse por separado y no puede sustituirse por gráficos atractivos de representaciones de baja dimensionalidad.[1] Transfer learning enables predictions in network biolog[2] scGPT: toward building a foundation model for single-ce
2. El cuestionamiento basado en referencias lineales revela deficiencias en evaluaciones comparativas específicas
La comparación de 2025 evaluó varios métodos de predicción de perturbaciones con datos, versiones y esquemas de adaptación definidos, y destacó la competitividad de las referencias simples. Su sección de métodos también describió las interfaces de los distintos modelos, los presupuestos de entrenamiento y el tratamiento de algunas representaciones que requerían decodificadores adicionales. Esta conclusión exige establecer cuidadosamente las referencias, pero no demuestra que todos los modelos profundos sean para siempre incapaces de aprender mecanismos de perturbación. Las comparaciones deben utilizar las mismas entradas, particiones, procedimientos de preprocesamiento y presupuestos, y examinar por separado las contribuciones del modelo y del decodificador añadido; de lo contrario, afirmar que «los modelos fundacionales superan a los métodos lineales» podría reflejar principalmente diferencias en supervisión adicional o en la cantidad de ajuste realizado.[3] Deep-learning-based gene perturbation effect prediction
3. Por qué los nuevos estudios de métricas pueden ofrecer observaciones diferentes
El estudio de 2026 examinó la calibración mediante 14 conjuntos de datos y 18 métricas, haciendo hincapié en si existía suficiente rango dinámico entre los controles positivos y negativos. Señaló que algunas métricas habituales de error global o correlación tienen una sensibilidad insuficiente a efectos de perturbación débiles y dispersos, y evaluó métricas ponderadas, diferenciales y basadas en recuperación. Este avance no justifica seleccionar retrospectivamente métricas que favorezcan al modelo preferido; exige demostrar primero que las métricas distinguen controles positivos y negativos conocidos, y solo entonces comparar los modelos. Por ello, este artículo separa «si el modelo ha aprendido la señal» y «si la métrica puede detectar la señal» en dos hipótesis que pueden fallar de forma independiente.[4] Deep learning perturbation models can outperform baseli
4. Derivación de este artículo: los genes de fondo pueden diluir las diferencias relevantes
Se construye un conjunto de 1000 genes, de los cuales 10 presentan cada uno una magnitud de respuesta de 2, mientras que los demás no cambian. Un modelo que predice ausencia de cambio en todos ellos tiene un error cuadrático medio global, MSE, de solo 0.04; un modelo que predice la mitad de la magnitud real de respuesta tiene un MSE de 0.01. Si otro modelo acierta exactamente en los genes que responden, pero introduce un error de 0.25 en cada uno de los 990 genes de fondo, su MSE global es aproximadamente 0.0619, peor que el de los dos modelos anteriores. Este ejemplo no demuestra que se puedan ignorar los errores de fondo, sino que el error global de reconstrucción y la recuperación de efectos biológicos miden objetivos distintos. La figura muestra simultáneamente los errores en todos los genes y en el subconjunto que responde, para evitar elegir una conclusión científica mediante una única puntuación global.作者分析与复核建议 / Author analysis
5. La evaluación ponderada también debe evitar la filtración de respuestas
Ponderar según la intensidad del efecto o los genes con expresión diferencial puede aumentar la atención a la señal de perturbación, pero la selección de pesos y conjuntos de genes no debe devolver las respuestas de prueba al entrenamiento o al ajuste. Este artículo recomienda definir de antemano las reglas de evaluación y aislar del proceso de modelado las mediciones de prueba utilizadas para evaluar. Si el conjunto de genes procede de los valores verdaderos de prueba, debe explicarse que se utiliza únicamente para una puntuación posterior fija y que no puede convertirse en una entrada del modelo. También deben comunicarse el sesgo en los genes de fondo y la tasa de efectos espurios. Un modelo que solo optimiza los genes con cambios significativos, pero genera numerosos cambios falsos en los demás, no puede considerarse un simulador completo de la respuesta celular.作者分析与复核建议 / Author analysis
6. Derivación de este artículo: la predicción de combinaciones debe superar una referencia aditiva interpretable
Las respuestas medias a las perturbaciones individuales A y B y al control permiten construir una predicción aditiva de la perturbación doble; la respuesta real a la perturbación doble menos esta referencia constituye el residuo de interacción respecto de la escala utilizada. Si ambas perturbaciones individuales ya se han visto en una prueba de combinaciones, la tarea es completamente distinta de aquella en que «ninguna de las dos perturbaciones individuales se ha visto». Una mayor correlación de expresión para perturbaciones dobles puede deberse simplemente a conservar el nivel basal celular. Este artículo recomienda evaluar por separado la respuesta total, la diferencia respecto al control y el residuo de interacción, y estratificar según si los componentes de la combinación se han visto previamente. Solo superar la referencia aditiva en el residuo respalda que el modelo haya aprendido, en esa evaluación comparativa, información que va más allá de la suma simple.作者分析与复核建议 / Author analysis
7. La célula promedio no representa la distribución de respuestas
Bajo una misma intervención, las células pueden dividirse en subpoblaciones que responden y que no responden, o cambiar siguiendo múltiples trayectorias de estado. Predecir la media puede ser óptimo con una pérdida cuadrática, pero producir un estado intermedio inexistente en el experimento. Este artículo propone registrar por separado la media global, las proporciones de las subpoblaciones y las diferencias entre distribuciones; las pruebas de distribución también requieren controlar el lote, la profundidad de secuenciación y el número de células, pues de lo contrario el ruido técnico puede confundirse con heterogeneidad. Que un modelo generativo produzca una distribución más rica no implica automáticamente que sea más realista: debe compararse con distribuciones de muestras independientes y con la misma referencia no informativa, y deben conservarse los estados celulares en los que la predicción fracasa.作者分析与复核建议 / Author analysis
8. Análisis de este artículo: el tamaño muestral efectivo no es el número total de células
Disponer de miles de células para una perturbación no equivale a miles de experimentos de intervención independientes; las células de un mismo donante y lote comparten muchas condiciones. Si el criterio principal de valoración es la generalización a perturbaciones no vistas, la unidad estadística debe tener en cuenta, como mínimo, las perturbaciones y las réplicas biológicas, en lugar de remuestrear cada célula de manera independiente. Este artículo recomienda resumir primero la incertidumbre técnica dentro de cada perturbación y después comparar los métodos a nivel de perturbación o de donante, comunicando por separado los casos no concluyentes por un número insuficiente de células. Si muchas réplicas proceden de unas pocas perturbaciones fáciles de predecir, agrupar directamente las células sesgará el rendimiento medio hacia ellas y producirá intervalos de confianza demasiado estrechos.作者分析与复核建议 / Author analysis
9. Un experimento prospectivo capaz de convertir el debate en conocimiento
Primero se fijan el conjunto de intervenciones y los contextos celulares, se prerregistran los modelos lineales, de media, aditivos y profundos junto con sus presupuestos, y después se establecen las métricas principales calibradas mediante controles positivos y negativos. Las mediciones externas solo se hacen accesibles tras completar las predicciones de los modelos; se comunican conjuntamente el error de todos los genes, las diferencias inducidas por perturbaciones, los residuos de interacción y las distribuciones de subpoblaciones. Si un modelo solo mejora en determinadas perturbaciones de efecto intenso, deben explicarse sus condiciones de aplicabilidad. Si las conclusiones de las métricas entran en conflicto, deben examinarse el criterio científico de valoración y la sensibilidad de las métricas, en lugar de eliminar las desfavorables. Este diseño puede transformar el debate sobre el tamaño de los modelos en conclusiones condicionales reproducibles.作者分析与复核建议 / Author analysis
Suplemento técnico A · Recuentos, normalización y escala de los efectos biológicos
La expresión de una célula individual depende tanto del estado real del RNA como de la captura y la profundidad de secuenciación. La normalización por tamaño de biblioteca y la transformación logarítmica pueden modificar el ruido y la interpretación de las diferencias, por lo que debe especificarse la escala en la que se cumple la aditividad. La aditividad de los recuentos brutos, la de la expresión normalizada y la del espacio log1p no constituyen la misma hipótesis. Este artículo recomienda conservar resúmenes de los recuentos brutos y todos los parámetros de transformación, y mantener la coherencia entre entrenamiento y evaluación. Si una métrica mejora tras la transformación, primero debe determinarse si sigue correspondiendo al criterio biológico previsto, en vez de interpretarla automáticamente como una respuesta celular más precisa.作者分析与复核建议 / Author analysis
Suplemento técnico B · La identidad de la perturbación y el contexto deben introducirse conjuntamente
Predecir perturbaciones no vistas requiere alguna representación transferible de la perturbación, como características génicas, redes de conocimiento previo o información relacionada con la secuencia; una etiqueta discreta nunca vista no aporta automáticamente un mecanismo biológico. Al mismo tiempo, intervenir sobre el mismo gen puede producir respuestas distintas en diferentes contextos celulares. Este artículo recomienda formular el modelo como una función que transforma condiciones como el contexto, la intervención y el tiempo en una respuesta, y realizar ablaciones por separado de estas fuentes de información. Si un modelo utiliza principalmente el contexto promedio para reconstruir la expresión, su puntuación global puede ser muy buena sin haber identificado la perturbación. Al evaluar tareas no vistas, debe conservarse un registro de la información previa que contienen realmente las entradas.[1] Transfer learning enables predictions in network biolog[2] scGPT: toward building a foundation model for single-ce
Suplemento técnico C · Los controles positivos también contienen ruido de medición
Los controles positivos construidos a partir de réplicas técnicas o subconjuntos independientes de células permiten estimar la sensibilidad de una métrica a señales reproducibles, pero los propios controles positivos no son valores verdaderos exentos de ruido. La desigualdad en el número de células, el lote y la composición del muestreo afectan a su límite superior de rendimiento. Este artículo recomienda documentar la construcción de los controles positivos y negativos dentro de cada conjunto de datos y examinar cómo cambia el rango dinámico de las métricas con el número de células y la intensidad del efecto. Si una métrica ni siquiera distingue de forma fiable el control positivo, la interpretación de la clasificación de modelos es limitada; si el control positivo es de mala calidad, tampoco puede concluirse por ello que la tarea científica sea intrínsecamente impredecible.[4] Deep learning perturbation models can outperform baseli
Suplemento técnico D · Las interacciones entre perturbaciones combinadas requieren suficiente capacidad de medición
Supóngase que la perturbación doble y las dos perturbaciones individuales se estiman a partir de números finitos de células. La varianza del residuo de interacción viene determinada conjuntamente por las varianzas y covarianzas de cuatro medias. Incluso si existe una interacción real, el error de medición puede impedir una conclusión. Este artículo recomienda estimar primero, mediante réplicas independientes, la escala de interacción que puede resolverse, y después determinar el objetivo de evaluación del modelo, distinguiendo los casos no concluyentes de los errores de predicción. Así se evita tanto penalizar modelos mediante residuos ruidosos como pasar por alto señales no aditivas reales debido a un error global pequeño. Lo que debe comunicarse es la información reproducible que supera la referencia aditiva, no diferencias arbitrariamente pequeñas.作者分析与复核建议 / Author analysis
10. Conclusión: las células virtuales necesitan compromisos contrastables mediante intervenciones y refutables
El valor científico de una célula virtual reside en formular predicciones precisas, delimitadas y refutables sobre intervenciones todavía no medidas, y no en volver a dibujar atlas celulares conocidos. Los modelos fundacionales existentes y los estudios de evaluación muestran conjuntamente que la definición de la tarea, las referencias sólidas y las métricas calibradas son indispensables. Los ejemplos de efectos dispersos e interacciones de este artículo solo explican la lógica de medición y no pueden registrarse como experimentos celulares reales. Las futuras plataformas deben vincular cada predicción con la identidad de la intervención, el contexto, el tiempo de medición y la versión del modelo, de modo que la reproducción y los resultados negativos puedan volver a la misma pregunta científica, en lugar de generar continuamente nuevas clasificaciones difíciles de comparar.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) Referencia aditiva de una combinación bajo el mismo contexto y escala; solo la parte de la respuesta a la perturbación doble que excede este término constituye el residuo de interacción.
LaTeX
\widehat\mu_{A+B}^{\mathrm{add}}=\mu_A+\mu_B-\mu_0(2) El error medio de todos los genes puede ser insensible a los efectos dispersos; aun así, debe conservarse el error de fondo.
LaTeX
\operatorname{MSE}=\frac1G\sum_{g=1}^{G}(\widehat\Delta_g-\Delta_g)^2(3) Definición general del error ponderado de este artículo; los pesos deben predefinirse y esta definición no pretende representar todas las métricas calibradas específicas del estudio fuente.
LaTeX
\operatorname{WMSE}=\frac{\sum_g w_g(\widehat\Delta_g-\Delta_g)^2}{\sum_g w_g}(4) Residuo de interacción de una combinación en la escala de expresión seleccionada; cambiar la escala puede modificar la interpretación numérica.
LaTeX
\epsilon_{AB}=\mu_{AB}-\mu_A-\mu_B+\mu_0Flujo de métodos y evidencia
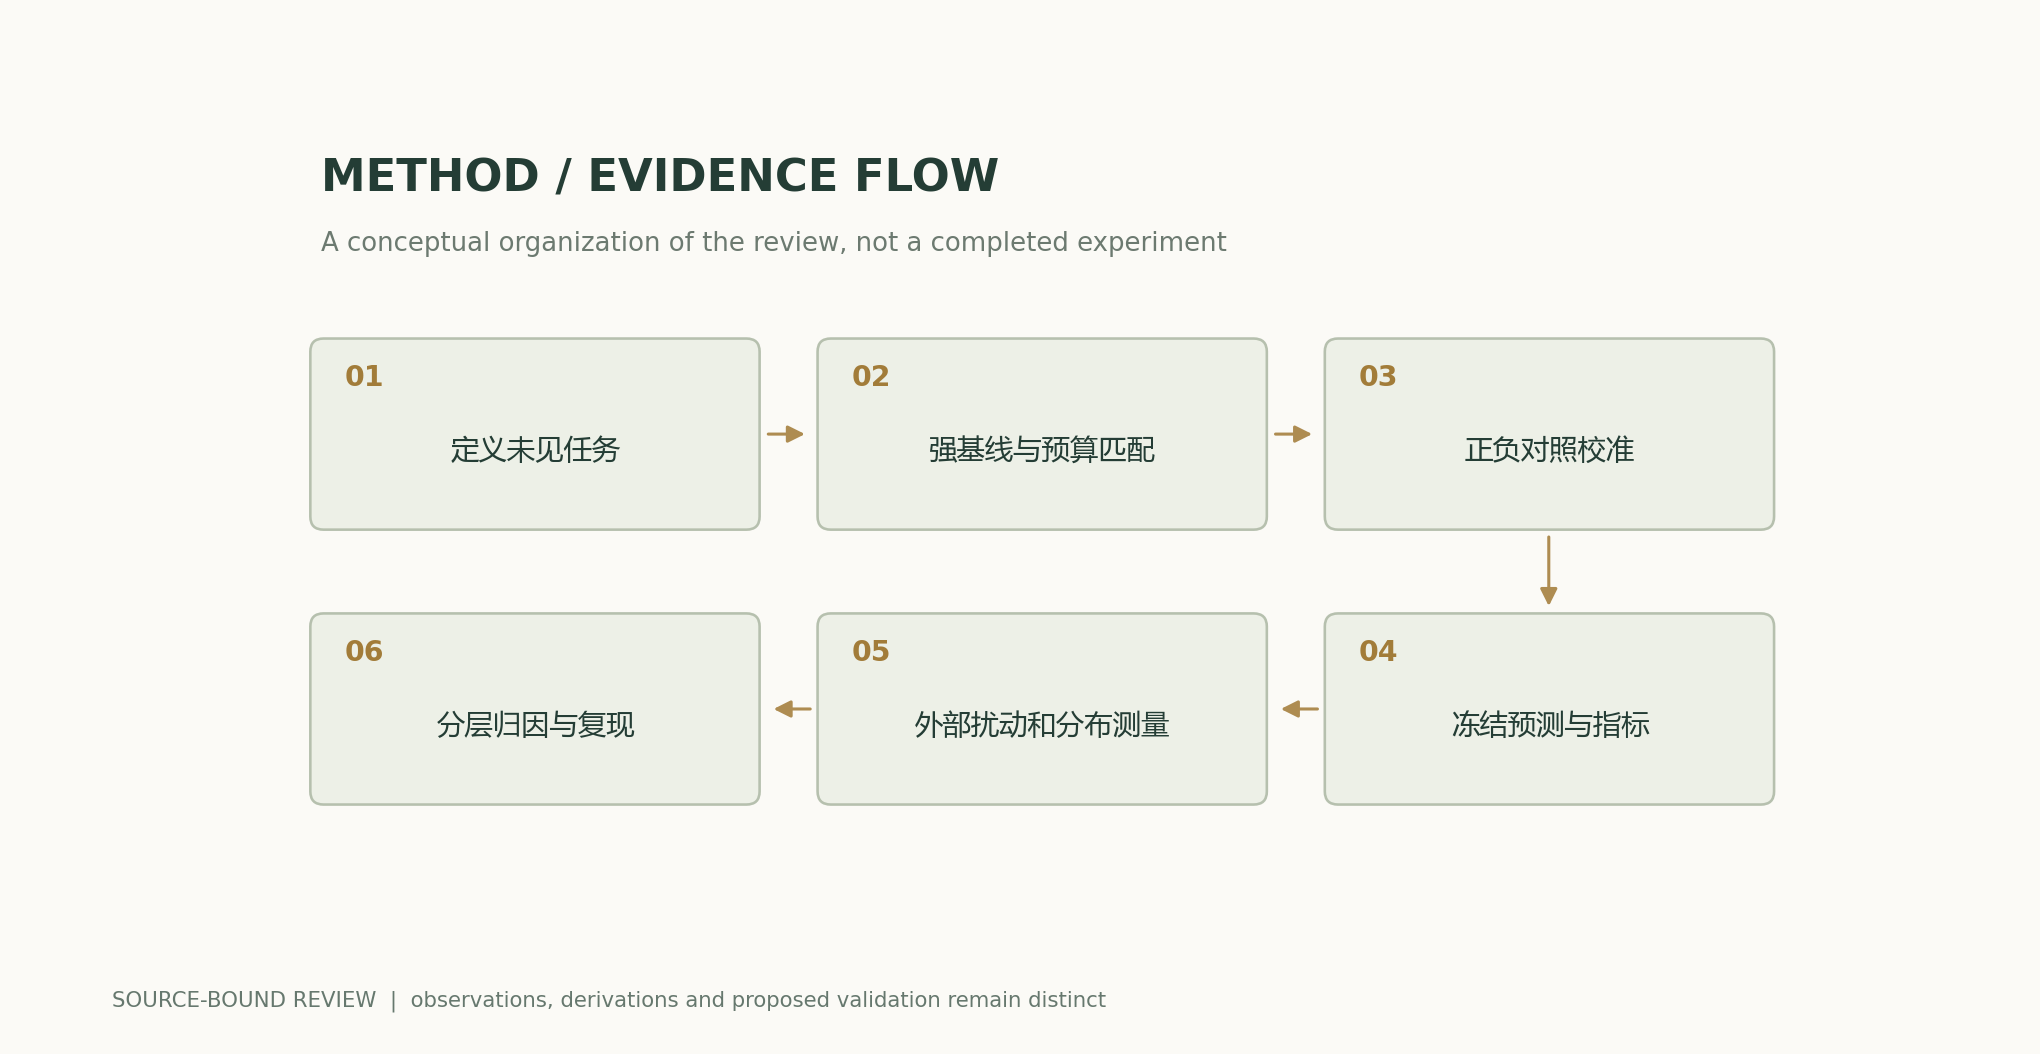
Figuras analíticas y ejemplos numéricos
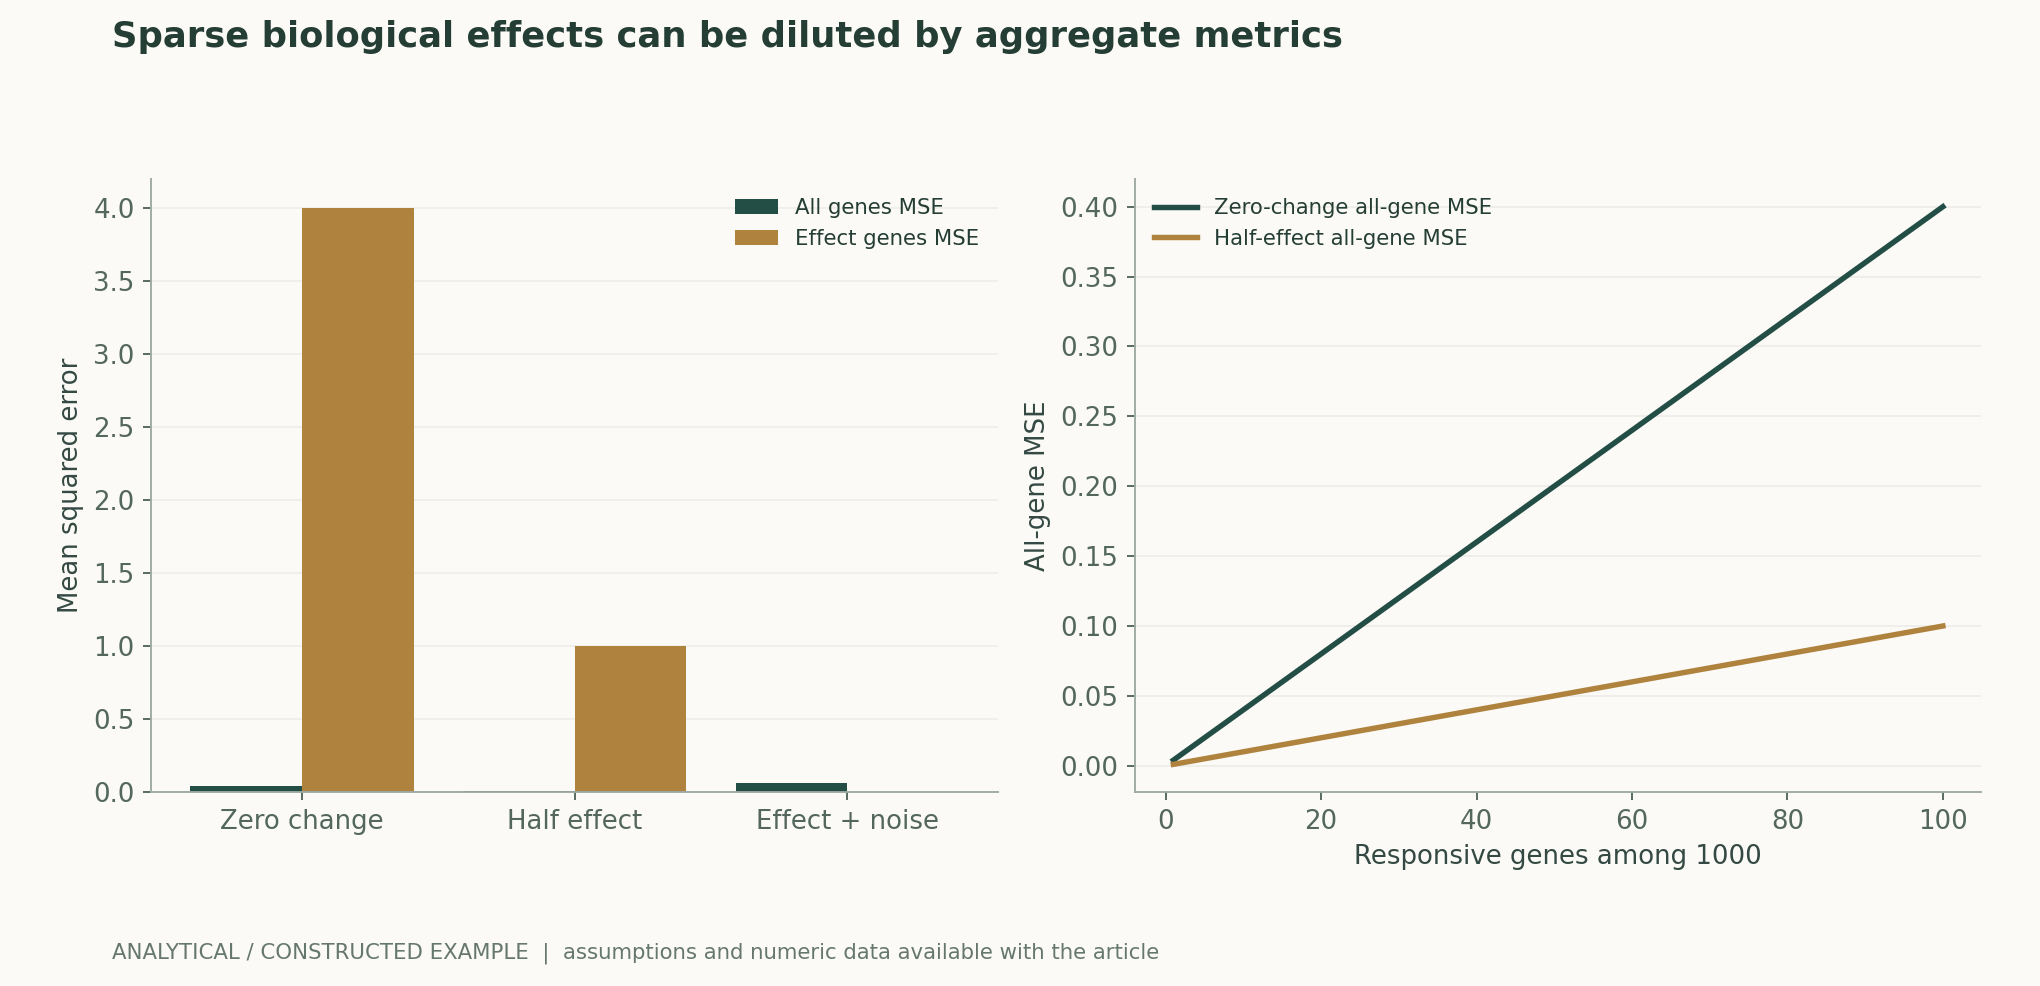
Ejemplo resuelto con cálculos reproducibles
Cambio nulo: MSE=10×4/1000=0.04; para la mitad del efecto, el valor es 0.01; si los genes que responden se predicen exactamente y el error de fondo es 0.25, el total es MSE=0.061875.
Comparación de métodos
| Tarea o métrica | Referencia / control necesario | Confusión que debe rechazarse |
|---|---|---|
| Células no vistas | Reconstrucción mediante la media de la misma perturbación | Denominarlo intervenciones no vistas |
| Intervenciones no vistas | Referencia de la media y modelo lineal con características equiparadas | Partición aleatoria de células |
| Combinaciones no vistas | Predicción aditiva a partir de componentes vistos | Comunicar únicamente la correlación de la expresión total |
| Nuevo contexto celular | Equiparación del contexto y reserva de donantes para prueba | Interpretar las diferencias técnicas entre lotes como mecanismos |
| Efectos dispersos | Calibración con controles positivos y negativos y error de fondo | Seleccionar retrospectivamente métricas favorables |
| Distribución de estados | Proporciones de subpoblaciones e iguales presupuestos de células | Equiparar una media correcta con una distribución correcta |
Plan de verificación y experimentación
- Fijar el diccionario de tareas que especifica intervenciones, contextos, etiquetas de dosis y tiempos de observación.
- Establecer conjuntos reservados de prueba por intervención, componente de combinación, donante y lote, por separado.
- Unificar el preprocesamiento y los presupuestos de entrenamiento, y conservar las referencias de media, lineales y aditivas.
- Seleccionar las características de entrada y los hiperparámetros únicamente con el conjunto de entrenamiento, aislando las mediciones de prueba.
- Verificar primero que las métricas de evaluación distinguen los controles positivos de los negativos y después predefinir los criterios principales de valoración.
- Comunicar conjuntamente los resultados de todos los genes, las diferencias, las interacciones y los cambios espurios de fondo, conservando los conflictos.
- Utilizar las intervenciones y las réplicas biológicas como niveles estadísticos, y registrar por separado las muestras no concluyentes.
- Obtener nuevas mediciones después de fijar las predicciones y publicar todos los resultados y las diferencias entre versiones.
Ámbito de aplicación y limitaciones
- La figura de efectos dispersos se generó íntegramente con datos construidos.
- No se entrenó ningún modelo de célula única ni se realizaron nuevas perturbaciones celulares.
- Las tareas y métricas de los estudios de 2025 y 2026 no pueden combinarse directamente en una clasificación unificada.
- La interpretación de los residuos respecto de la aditividad depende de la escala de expresión y del contexto compartido.
- Las distribuciones celulares y los mecanismos causales siguen requiriendo réplicas biológicas independientes y evidencia de intervención.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultado del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Varios métodos profundos no superaron de forma consistente referencias lineales simples en las condiciones de prueba del estudio. | La conclusión está vinculada a los datos, las versiones de los modelos, los presupuestos y las métricas. | La predicción de los efectos de perturbaciones génicas mediante aprendizaje profundo todavía no supera referencias lineales simplesResultados y métodos |
| El análisis de calibración de 14 conjuntos de datos y 18 métricas muestra que algunos métodos profundos pueden superar referencias no informativas. | Esto no permite seleccionar retrospectivamente métricas favorables ni declarar una superioridad universal. | Los modelos de perturbaciones de aprendizaje profundo pueden superar las referencias con métricas calibradasResumen; calibración de métricas; evaluación de modelos |
| Explora representaciones preentrenadas y múltiples tareas de adaptación. | La transferencia de representaciones no equivale automáticamente a una simulación causal de nuevas intervenciones. | scGPT: hacia la construcción de un modelo fundacional para la multiómica de célula única mediante IA generativaResumen; tareas posteriores |
Preguntas de investigación que conviene contrastar
- Con el mismo rango dinámico entre controles positivos y negativos, ¿qué tipos de perturbación explican las mejoras de los modelos profundos?
- ¿Pueden transferirse entre donantes las predicciones de residuos reales de interacción entre perturbaciones combinadas?
- ¿Pueden reproducirse en lotes experimentales independientes las mejoras en las proporciones de subpoblaciones obtenidas por los modelos de distribución?
Correspondencia entre fuentes primarias y afirmaciones
- Transfer learning enables predictions in network biologyTheodoris et al. · 2023-05-31Pretraining, context-dependent representations and in silico perturbations.
- scGPT: toward building a foundation model for single-cell multi-omics using generative AICui et al. · 2024Single-cell pretraining and downstream adaptation; not a universal causal simulator.
- Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselinesAhlmann-Eltze et al. · 2025Unseen and combination perturbation benchmarks; Methods specify model versions and evaluation.
- Deep learning perturbation models can outperform baselines on calibrated metricsMiller et al. · 2026-10-0114 datasets, 18 metrics; positive-control calibration, weighted errors and task-dependent conclusions.
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo en JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original escritos por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio todavía no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos, clínicos o físicos para este artículo.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se mantienen las fuentes de cada sección y los límites entre la evidencia de las investigaciones originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos que acompañan al artículo; sus leyendas especifican, punto por punto, los supuestos y las definiciones de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c