
摘要
单细胞基础模型能学习广泛的表达表征,但“虚拟细胞”更强的要求是预测未见干预后的细胞反应。2025 年一项研究发现多种深度方法未稳定超过简单线性基线;2026 年另一项研究指出常用指标可能被不受扰动的背景基因稀释,经过校准的指标可以揭示深度方法相对无信息基线的增益。本文不把这两者简化为胜负翻转,而是分析任务、指标和对照如何共同决定结论。我们给出稀疏效应、组合交互与统计分层的可复算框架,并提出前瞻性验证设计。[3] Deep-learning-based gene perturbation effect prediction[4] Deep learning perturbation models can outperform baseli[2] scGPT: toward building a foundation model for single-ce
English abstract
A useful virtual cell must predict responses to interventions, not merely reconstruct familiar expression profiles. We examine Geneformer, scGPT and contrasting perturbation benchmarks from 2025 and 2026. An explicit sparse-effect construction demonstrates metric dilution, and an additive-versus-interaction analysis isolates the scientific content of combination prediction. We distinguish cell-level replication, perturbation-level generalization and distributional prediction, then propose a preregistered multi-metric protocol with positive and negative controls.
1. 表征质量与干预预测是不同能力
Geneformer 和 scGPT 分别探索大规模预训练及下游任务适配。一个模型能形成清晰的细胞类型表示,说明它捕获了表达中的可用结构;但预测未见基因干预,还需要将干预身份、细胞背景、时间与响应连接起来。若训练和测试只分开同一扰动下的不同细胞,评测可能主要检验重构而非新扰动泛化。本文将“未见细胞”“未见干预”“未见组合”和“未见背景”列为不同问题,每种问题必须单独报告,不能由漂亮的低维嵌入图替代。[1] Transfer learning enables predictions in network biolog[2] scGPT: toward building a foundation model for single-ce
2. 线性基线质疑揭示的是具体基准上的不足
2025 年的比较在明确的数据、版本与适配方案下检验多种扰动预测方法,并强调简单基线的竞争力。其方法部分还说明了不同模型的接口、训练预算和部分表征需要附加解码器的处理。这个结论要求研究者认真设置基线,却不证明所有深度模型永远无法学到扰动机制。比较时应复用相同输入、划分、预处理和预算,分别检查模型本体与后接解码器的贡献;否则“基础模型优于线性方法”的说法可能主要反映了额外监督或调参量的差异。[3] Deep-learning-based gene perturbation effect prediction
3. 新的指标研究为何可能给出不同观察
2026 年研究用 14 个数据集与 18 个指标讨论校准,强调正对照与负对照之间是否有足够动态范围。它指出一些常用总体误差或相关指标对弱而稀疏的扰动效应敏感度不足,并评估加权、差分与检索类指标。这个进展不意味着可以事后挑选让偏好模型胜出的指标;它要求先证明指标能识别已知的正负对照,再比较模型。本文据此把“模型是否学到信号”和“指标是否看得到信号”分成两个可分别失败的假设。[4] Deep learning perturbation models can outperform baseli
4. 本文推导:背景基因可以稀释有效差异
构造 1000 个基因,其中 10 个响应幅度均为 2,其余无变化。完全预测零变化的模型,总体 MSE 仅为 0.04;对真实响应只预测一半幅度的模型,MSE 为 0.01。若另一模型在响应基因上完全正确,却对 990 个背景基因各引入 0.25 的误差,总体 MSE 约为 0.0619,会被前两者击败。这个例子并不证明背景误差可以忽略,而是揭示总体重构误差与生物效应恢复衡量不同目标。图同时展示全部基因与响应子集的误差,避免只用一个总分选出科学结论。作者分析与复核建议 / Author analysis
5. 加权评价也需要防止答案泄漏
按效应强度或差异基因加权可以提高对扰动信号的关注,但权重与基因集合的选择不能把测试答案反馈给训练或调参。本文建议预先定义评价规则,并将用于评价的测试测量与建模过程隔离;若基因集合来自测试真值,必须说明它只用于事后固定评分,不能成为模型输入。还应同时报告背景基因的偏差和伪造效应率。一个只优化显著变化基因的模型,若在其余基因制造大量假变化,也不能被称为完整的细胞响应模拟器。作者分析与复核建议 / Author analysis
6. 本文推导:组合预测必须超过可解释的加和基线
对单扰动 A、B 和对照的平均响应,可构成双扰动的加和预测;真实双扰动减去此基线即为相对于当前尺度的交互残差。若组合测试中两个单扰动都已见,任务与“两个单扰动均未见”完全不同。更高的双扰动表达相关可能仅来自保留了细胞基线。本文建议分别评价总响应、相对于对照的差分与交互残差,并按组合成分的可见性分层。只有在残差上超过加和基线,才支持模型学到了该基准中超出简单相加的信息。作者分析与复核建议 / Author analysis
7. 平均细胞并不能代表响应分布
在相同干预下,细胞可能分成响应与不响应亚群,也可能沿多条状态路径变化。预测均值可在均方损失下最优,却产生实验中并不存在的中间状态。本文提出将总体均值、亚群比例和分布差异分别记录;分布检验也需要控制批次、测序深度与细胞数量,否则技术噪声会被误解为异质性。生成式模型给出更丰富分布并不自动说明它更真实,必须与独立样品中的分布和相同无信息基线比较,并保存失败的细胞状态。作者分析与复核建议 / Author analysis
8. 本文分析:有效样本量不是细胞总数
一个扰动有数千细胞,并不等于数千个独立干预实验;同一供体和批次中的细胞共享大量条件。主要终点若是对未见扰动的泛化,统计单位应至少考虑扰动和生物重复,而非对每个细胞独立重采样。本文建议先在每个扰动内汇总技术不确定性,再在扰动或供体层比较方法,另报细胞数不足导致的不可判定。若大量重复来自少数易预测扰动,直接合并细胞会使平均性能偏向这些对象,并给出过窄的置信区间。作者分析与复核建议 / Author analysis
9. 一个能让争论转化为知识的前瞻性实验
先冻结干预集合与细胞背景,预注册线性、均值、加和与深度模型及预算,再确定通过正负对照校准的主要指标。模型预测完成后才释放外部测量;同时报告全基因误差、扰动差分、交互残差与亚群分布。若某模型只在特定强效应扰动上获益,应说明适用条件;若不同指标结论冲突,检查科学终点与指标敏感度,而非删除不利指标。这样的设计可以将关于模型规模的争论转化为可重复的条件性结论。作者分析与复核建议 / Author analysis
技术补充 A · 计数、归一化与生物效应的尺度
单细胞表达既受真实 RNA 状态影响,也受捕获与测序深度影响。库大小归一化和对数变换能改变噪声与差分解释,因此加和关系必须明确在哪个尺度成立。原始计数加和、归一化表达加和与 log1p 空间加和不是同一假设。本文建议保留原始计数摘要与所有变换参数,并在模型训练和评价间保持一致。若某种指标在变换后改善,应先判断它是否仍对应预定生物终点,而不是自动视为更准确的细胞响应。作者分析与复核建议 / Author analysis
技术补充 B · 扰动身份与背景必须共同输入
预测未见扰动需要某种可迁移的扰动表征,例如基因特征、先验网络或序列相关信息;只有一个从未见过的离散标签并不会自动提供生物机制。与此同时,同一基因干预在不同细胞背景中可能产生不同响应。本文建议将模型写成背景、干预、时间等条件到响应的函数,并分别消融这些信息。若一个模型主要利用平均背景恢复表达,其总分可能很好,却没有识别扰动。评价未见任务时,应保留输入实际包含了哪些先验信息。[1] Transfer learning enables predictions in network biolog[2] scGPT: toward building a foundation model for single-ce
技术补充 C · 正对照也有测量噪声
用技术重复或独立细胞子集构造正对照,可估计评价指标对可重复信号的敏感度,但正对照本身并非无噪声真值。细胞数量不等、批次与采样组成会影响其上限。本文建议在每个数据集内记录正负对照构造,检查指标动态范围随细胞数和效应强度的变化。若一个指标连正对照都无法可靠区分,模型排名解释受限;若正对照质量差,也不能据此断言该科学任务本身不可预测。[4] Deep learning perturbation models can outperform baseli
技术补充 D · 组合交互需要足够测量能力
设双扰动与两个单扰动均由有限细胞估计,交互残差的方差由四项均值方差和协方差共同决定。即使真实交互存在,测量误差也可能使它不可判定。本文建议先用独立重复估计可分辨的交互尺度,再确定模型评价目标,并将不可判定与预测错误区分。这样可以避免一方面用噪声残差惩罚模型,另一方面又因总体误差小而忽略真正的非加和信号。需要报告的是超出加和基线的可重复信息,而不是任意微小差值。作者分析与复核建议 / Author analysis
10. 结论:虚拟细胞需要可干预、可反证的承诺
虚拟细胞的科学价值不是重画已知细胞图谱,而是对尚未测量的干预提出准确、有边界且能被推翻的预测。现有基础模型与评价研究共同说明,任务定义、强基线和校准指标缺一不可。本文的稀疏效应与交互例子仅用于解释测量逻辑,不能登记为实际细胞实验。后续平台应把每条预测与干预身份、背景、测量时间和模型版本绑定,让复现和负结果能够返回同一个科学问题,而不是不断生成难以比较的新排行榜。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 给定相同背景与尺度的组合加和基线;双扰动超出此项的部分才是交互残差。
LaTeX
\widehat\mu_{A+B}^{\mathrm{add}}=\mu_A+\mu_B-\mu_0(2) 全基因平均误差对稀疏效应可能不敏感;仍需保留背景误差。
LaTeX
\operatorname{MSE}=\frac1G\sum_{g=1}^{G}(\widehat\Delta_g-\Delta_g)^2(3) 本文一般加权误差定义;权重必须预定义,不冒充来源研究所有具体校准指标。
LaTeX
\operatorname{WMSE}=\frac{\sum_g w_g(\widehat\Delta_g-\Delta_g)^2}{\sum_g w_g}(4) 选定表达尺度上的组合交互残差;尺度改变可改变数值解释。
LaTeX
\epsilon_{AB}=\mu_{AB}-\mu_A-\mu_B+\mu_0方法与证据流程
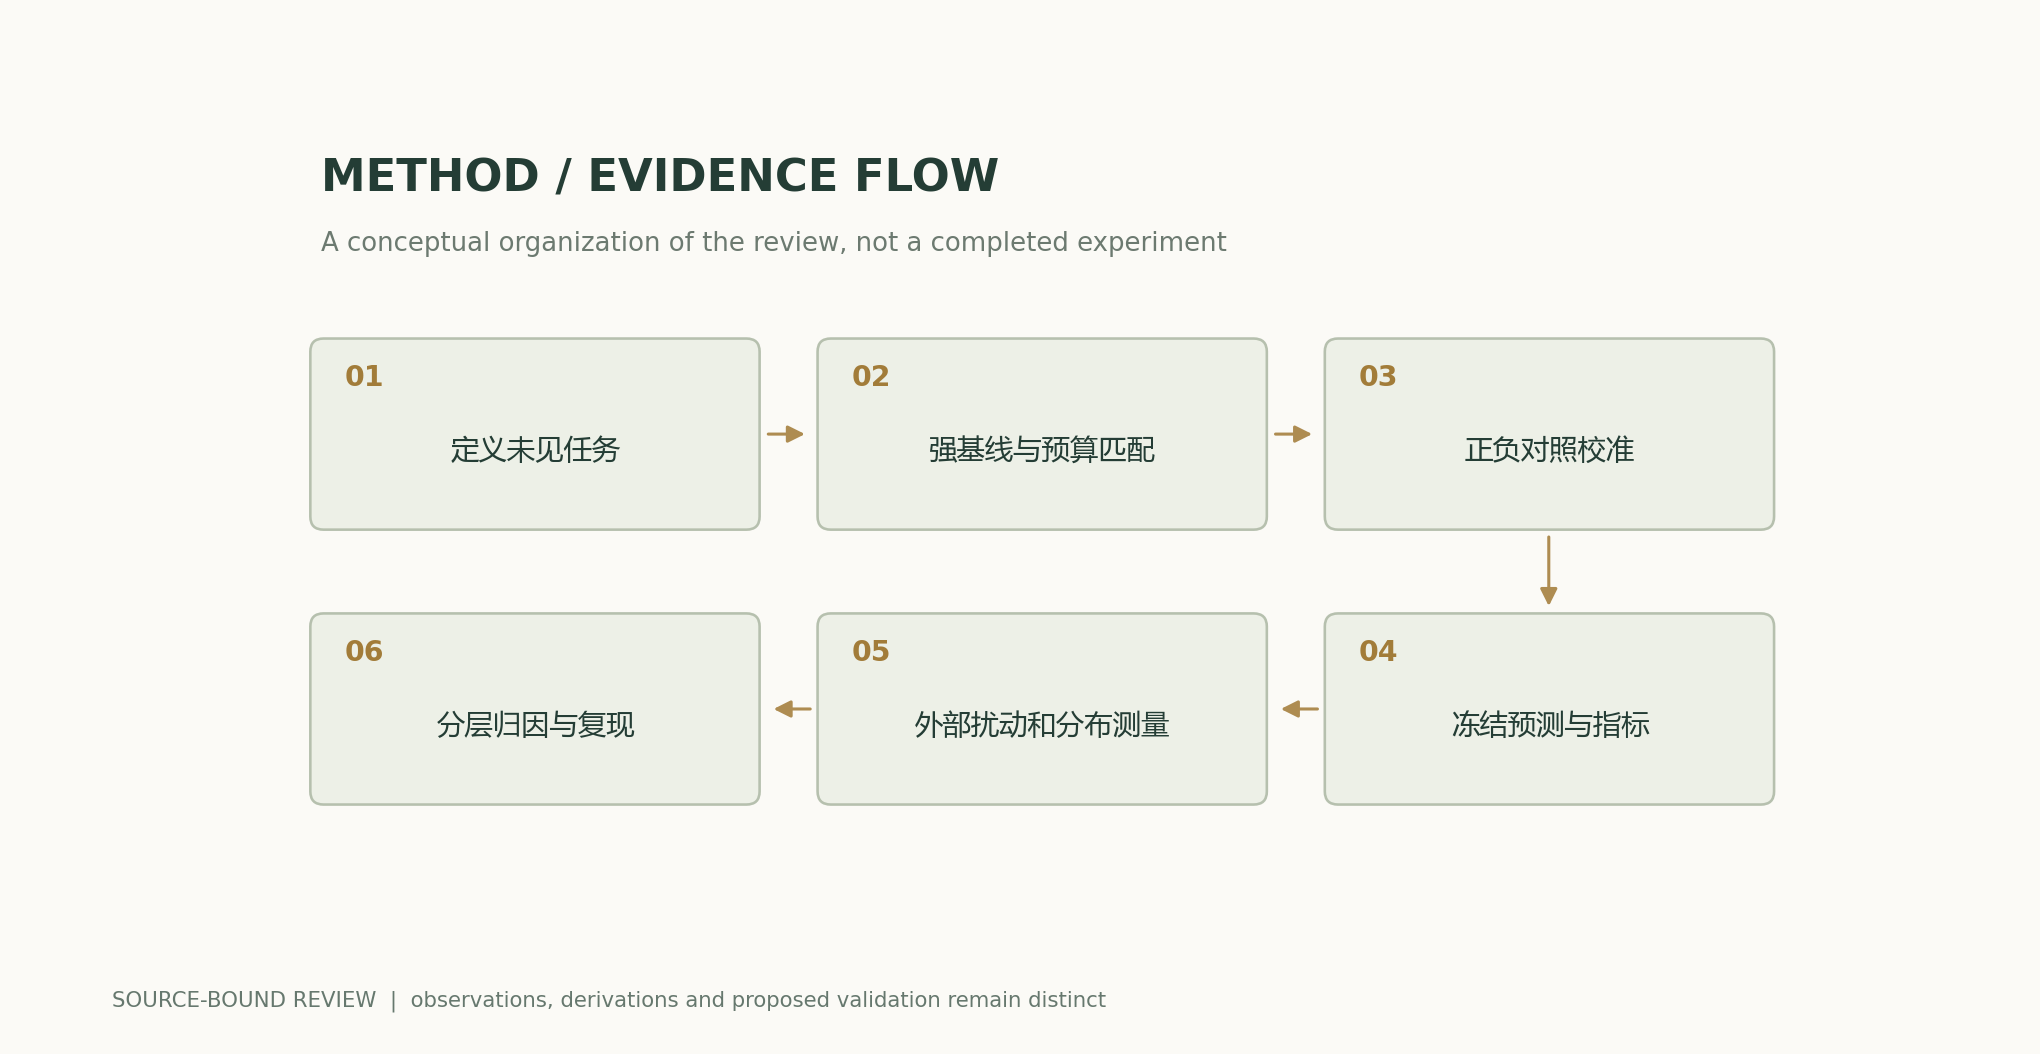
解析图与数值示例
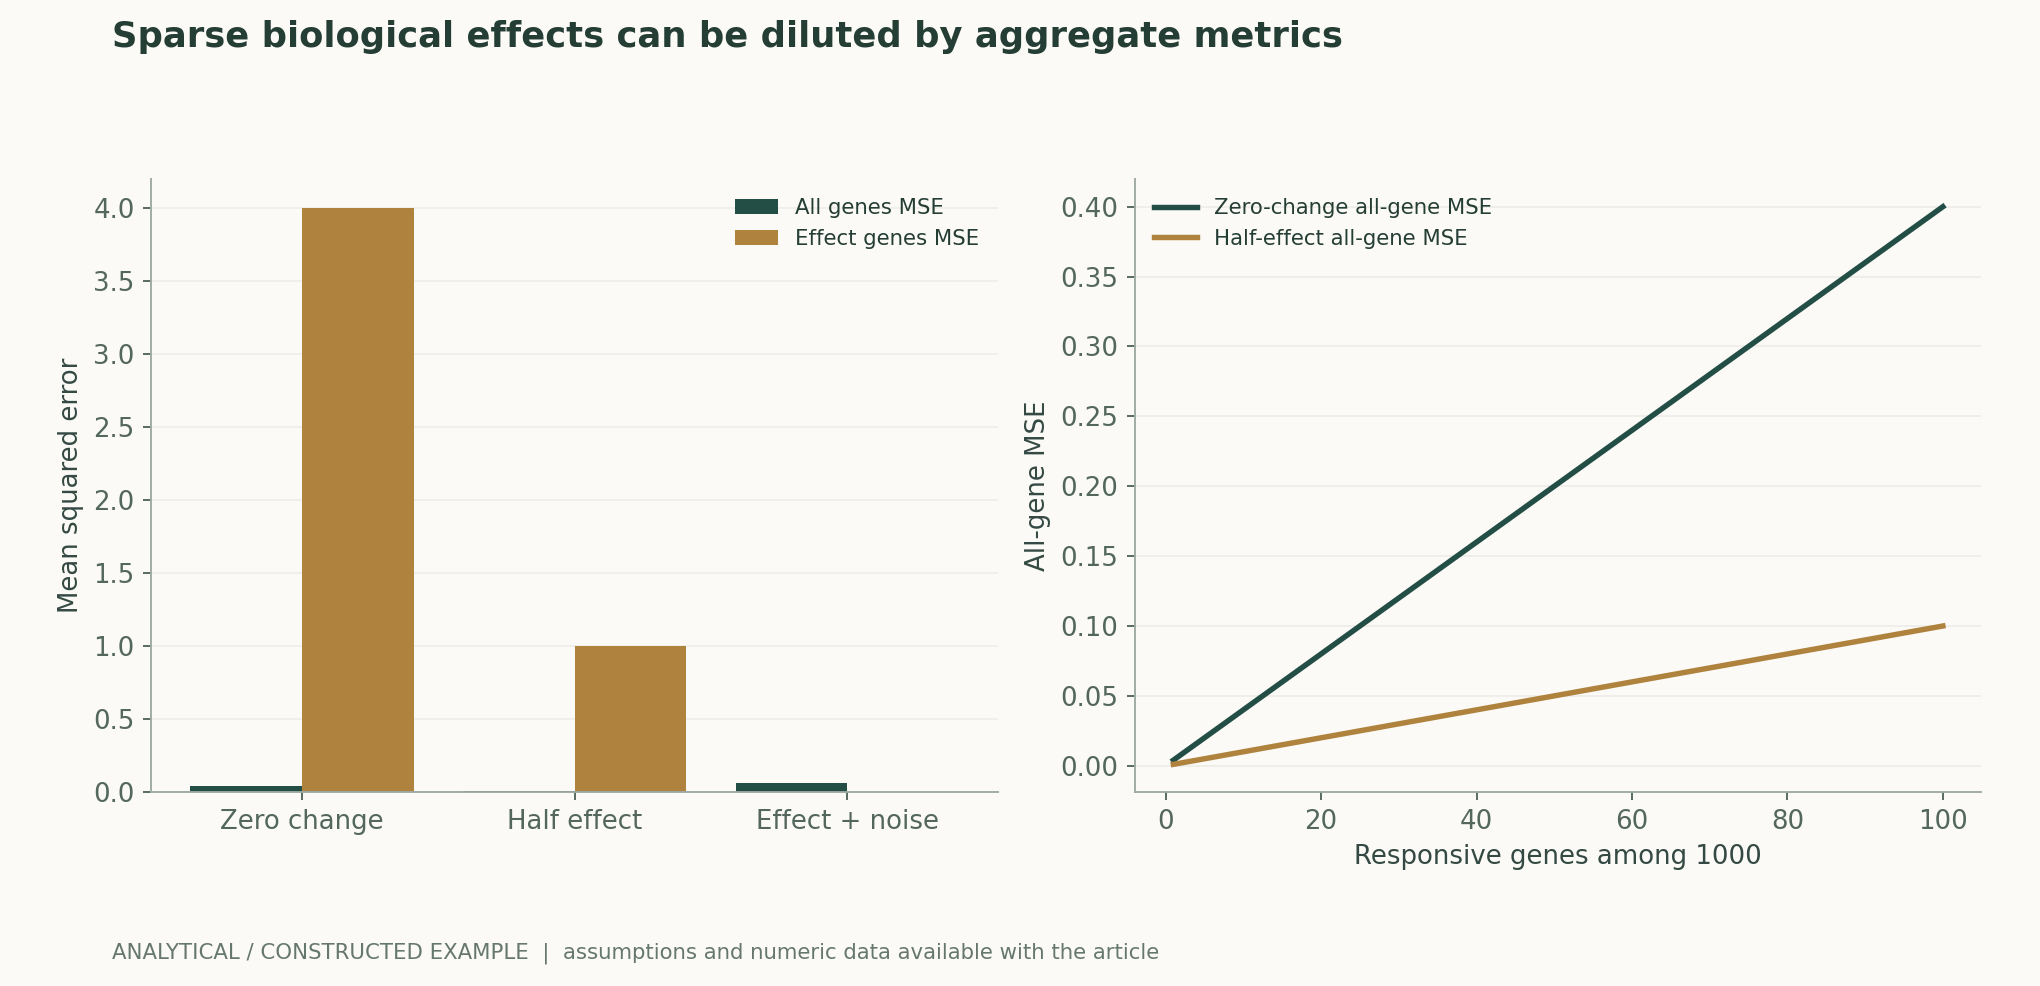
可复算例题
零变化MSE=10×4/1000=0.04;半效应为0.01;响应基因完全正确而背景误差0.25时,总MSE=0.061875。
方法比较
| 任务或指标 | 必要基线 / 对照 | 应拒绝的混用 |
|---|---|---|
| 未见细胞 | 同扰动均值重构 | 称作未见干预 |
| 未见干预 | 均值及特征匹配线性模型 | 随机细胞切分 |
| 未见组合 | 已见成分的加和预测 | 只报告总表达相关 |
| 新细胞背景 | 背景匹配与供体留出 | 跨批次技术差异当机制 |
| 稀疏效应 | 正负对照校准和背景误差 | 事后挑有利指标 |
| 状态分布 | 亚群比例与相同细胞预算 | 均值正确等于分布正确 |
复核与实验方案
- 冻结干预、背景、剂量标签与观测时间的任务字典。
- 按干预、组合成分、供体和批次分别设置留出。
- 统一预处理与训练预算,保存均值、线性和加和基线。
- 仅用训练集选择输入特征与超参数,隔离测试测量。
- 先验证评价指标能区分正、负对照,再预定主要终点。
- 同时报告全基因、差分、交互和背景伪变化,保留冲突。
- 以干预与生物重复为统计层级,单独记录不可判定样本。
- 预测冻结后获取新测量,公开全部结果与版本差异。
适用范围与局限
- 稀疏效应图完全由构造数据生成。
- 没有训练单细胞模型或执行新细胞扰动。
- 2025 与 2026 研究的任务和指标不能直接拼成统一排名。
- 加和残差的解释依赖表达尺度和共同背景。
- 细胞分布与因果机制仍需要独立生物重复和干预证据。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 多种深度方法在其测试设置中未稳定超过简单线性基线。 | 结论绑定数据、模型版本、预算与指标。 | Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselinesResults and Methods |
| 14 数据集、18 指标的校准分析显示部分深度方法可超过无信息基线。 | 不能据此事后选择有利指标或宣布普适领先。 | Deep learning perturbation models can outperform baselines on calibrated metricsAbstract; metric calibration; model evaluation |
| 探索预训练表示和多个适配任务。 | 表征迁移不自动等价于新干预因果模拟。 | scGPT: toward building a foundation model for single-cell multi-omics using generative AIAbstract; downstream tasks |
值得检验的研究问题
- 在相同正负对照动态范围下,深度模型的增益来自哪些扰动类型?
- 对真实组合交互残差的预测能否跨供体迁移?
- 分布模型改善的亚群比例能否在独立实验批次复现?
一手来源与主张对应
- Transfer learning enables predictions in network biologyTheodoris et al. · 2023-05-31Pretraining, context-dependent representations and in silico perturbations.
- scGPT: toward building a foundation model for single-cell multi-omics using generative AICui et al. · 2024Single-cell pretraining and downstream adaptation; not a universal causal simulator.
- Deep-learning-based gene perturbation effect prediction does not yet outperform simple linear baselinesAhlmann-Eltze et al. · 2025Unseen and combination perturbation benchmarks; Methods specify model versions and evaluation.
- Deep learning perturbation models can outperform baselines on calibrated metricsMiller et al. · 2026-10-0114 datasets, 18 metrics; positive-control calibration, weighted errors and task-dependent conclusions.
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c