
Resumen
La segmentación guiada por indicaciones especifica el objetivo mediante entradas como puntos y recuadros, pero el modo de proporcionar indicaciones, el nivel jerárquico del objeto y el presupuesto de interacción humana afectan a los resultados. Este artículo analiza las interfaces de codificación de imágenes y decodificación de máscaras de SAM, así como el contexto de memoria de vídeo de SAM 2, y distingue entre solapamiento espacial, consistencia temporal y corrección semántica. La figura muestra la intersección sobre unión (IoU) calculada analíticamente tras la traslación de un rectángulo, no resultados de pruebas de ningún modelo SAM.[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos[3] Learning Transferable Visual Models From Natural Langua
Traducción del resumen en inglés
La segmentación guiada por indicaciones se evalúa como un sistema interactivo con un objeto y un presupuesto de indicaciones especificados. Distinguimos entre ambigüedad de las máscaras, predicción de confianza, memoria temporal y reconocimiento semántico. Un ejemplo de un rectángulo trasladado permite derivar la sensibilidad de la IoU sin ejecutar SAM. La transferencia entre dominios y la consistencia en vídeo requieren una evaluación independiente con datos etiquetados.
1. Las indicaciones definen la tarea, no solo el formato de entrada
Un punto puede señalar un objeto completo, una parte o una región de textura, y varias máscaras pueden ser razonables. Primero deben establecerse la definición del objeto y la política de anotación, y después explicarse cómo se generan los puntos, recuadros o textos. La selección manual de las indicaciones más favorables tiene un coste distinto del uso de indicaciones automáticas fijas. Las pruebas de modelos guiados por indicaciones deben contabilizar el número de interacciones, las correcciones y los fallos, en lugar de informar únicamente de la mejor máscara elegida retrospectivamente entre varios candidatos.[1] Segment Anything
2. La reutilización de la codificación y la decodificación ligera tienen requisitos de ingeniería
La codificación de la imagen puede reutilizarse entre varias indicaciones, y los resultados se generan después utilizando las indicaciones y el decodificador de máscaras; la clave de reutilización debe vincularse a la imagen, el preprocesamiento y la versión del modelo. Los errores de escalado, recorte y transformación de coordenadas pueden desplazar la ubicación de las indicaciones. La latencia debe desglosarse en codificación inicial e interacciones posteriores, y también debe registrarse el uso de memoria. Si solo se mide la decodificación con la caché ya preparada, el resultado no debe presentarse como la latencia total desde la carga inicial hasta la salida.[1] Segment Anything
3. Las máscaras múltiples y las puntuaciones de calidad no constituyen una verdad de referencia externa
El modelo puede producir varios candidatos y estimaciones de calidad para abordar la ambigüedad. Las puntuaciones predichas requieren una calibración independiente y no sustituyen la comparación con las anotaciones; elegir el candidato de mayor puntuación y utilizar la verdad de referencia para elegir el mejor candidato son protocolos de evaluación distintos. También deben examinarse los objetos pequeños, los límites finos y alargados, las oclusiones y los objetos adyacentes similares, ya que la IoU media puede ocultar fallos críticos. Cuando la extensión del objeto no coincide, un solapamiento bajo también puede deberse a ambigüedad en la anotación y no a un error puramente visual.[1] Segment Anything
4. La consistencia en vídeo puede mantener el seguimiento del objeto equivocado
SAM 2 amplía la segmentación guiada por indicaciones al contexto del vídeo. La memoria facilita la propagación entre fotogramas, pero también puede perpetuar errores tempranos. La suavidad temporal y la coherencia de las trayectorias no garantizan la corrección de la identidad ni de los límites; las oclusiones, las reapariciones y los intercambios de posición entre objetos similares requieren pruebas específicas. Deben registrarse cuándo se permiten nuevas indicaciones, quién las proporciona y cuántas correcciones se realizan, e incluirse el reinicio de la memoria y los escenarios de nuevos planos en las pruebas de aceptación.[2] SAM 2: Segment Anything in Images and Videos
5. La segmentación y el reconocimiento semántico requieren evidencias diferentes
Una máscara indica qué píxeles pertenecen a la región objetivo, pero no proporciona necesariamente la especie, la categoría patológica o el tipo de material correctos. Las representaciones de tipo CLIP se centran en la correspondencia entre imágenes y texto y tampoco proporcionan automáticamente límites precisos a nivel de píxel. Al combinar ambos enfoques, deben validarse por separado la localización y la semántica, especialmente en ámbitos especializados. Un buen rendimiento en imágenes naturales públicas no puede considerarse una prueba directa de utilidad en imágenes médicas, de teledetección o de microscopía; deben utilizarse anotaciones del dominio obtenidas legalmente y explicitarse los costes de los errores.[3] Learning Transferable Visual Models From Natural Langua[1] Segment Anything
6. La verificación debe fijar el presupuesto de indicaciones y las particiones de datos
Las particiones deben separarse por fuente de imagen o secuencia de vídeo para evitar la filtración de fotogramas adyacentes; las reglas de generación de indicaciones y selección de candidatos deben determinarse de antemano. Deben comunicarse la IoU, la calidad de los límites, la pérdida de objetos y el coste de interacción, con resultados estratificados por tamaño, oclusión y dominio. El ejemplo de rectángulos de este artículo solo demuestra la relación entre el desplazamiento de los límites y la IoU, y no sustituye la evaluación de formas complejas reales y modelos. El despliegue real también requiere cachés versionadas, mecanismos alternativos ante fallos y vías de corrección humana.[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos
Ecuaciones fundamentales y derivaciones
(1) M es la predicción y G la anotación; deben establecerse reglas separadas para los conjuntos vacíos y las anotaciones ambiguas.
LaTeX
\operatorname{IoU}=\frac{|M\cap G|}{|M\cup G|}=\frac{TP}{TP+FP+FN}(2) La relación se cumple cuando dos rectángulos de igual tamaño se desplazan únicamente en horizontal una distancia d y se solapan por completo en vertical; la figura utiliza w=100 y una altura de 60.
LaTeX
\operatorname{IoU}(d)=\frac{w-d}{w+d},\qquad0\le d\le w(3) Las interacciones posteriores que reutilizan la codificación y el procesamiento inicial deben cronometrarse por separado; en este artículo no se realizaron mediciones empíricas de la latencia del modelo.
LaTeX
\tau_{\mathrm{interaction}}=\tau_{\mathrm{prompt}}+\tau_{\mathrm{decode}},\quad\tau_{\mathrm{first}}=\tau_{\mathrm{encode}}+\tau_{\mathrm{interaction}}Flujo del método y de la evidencia
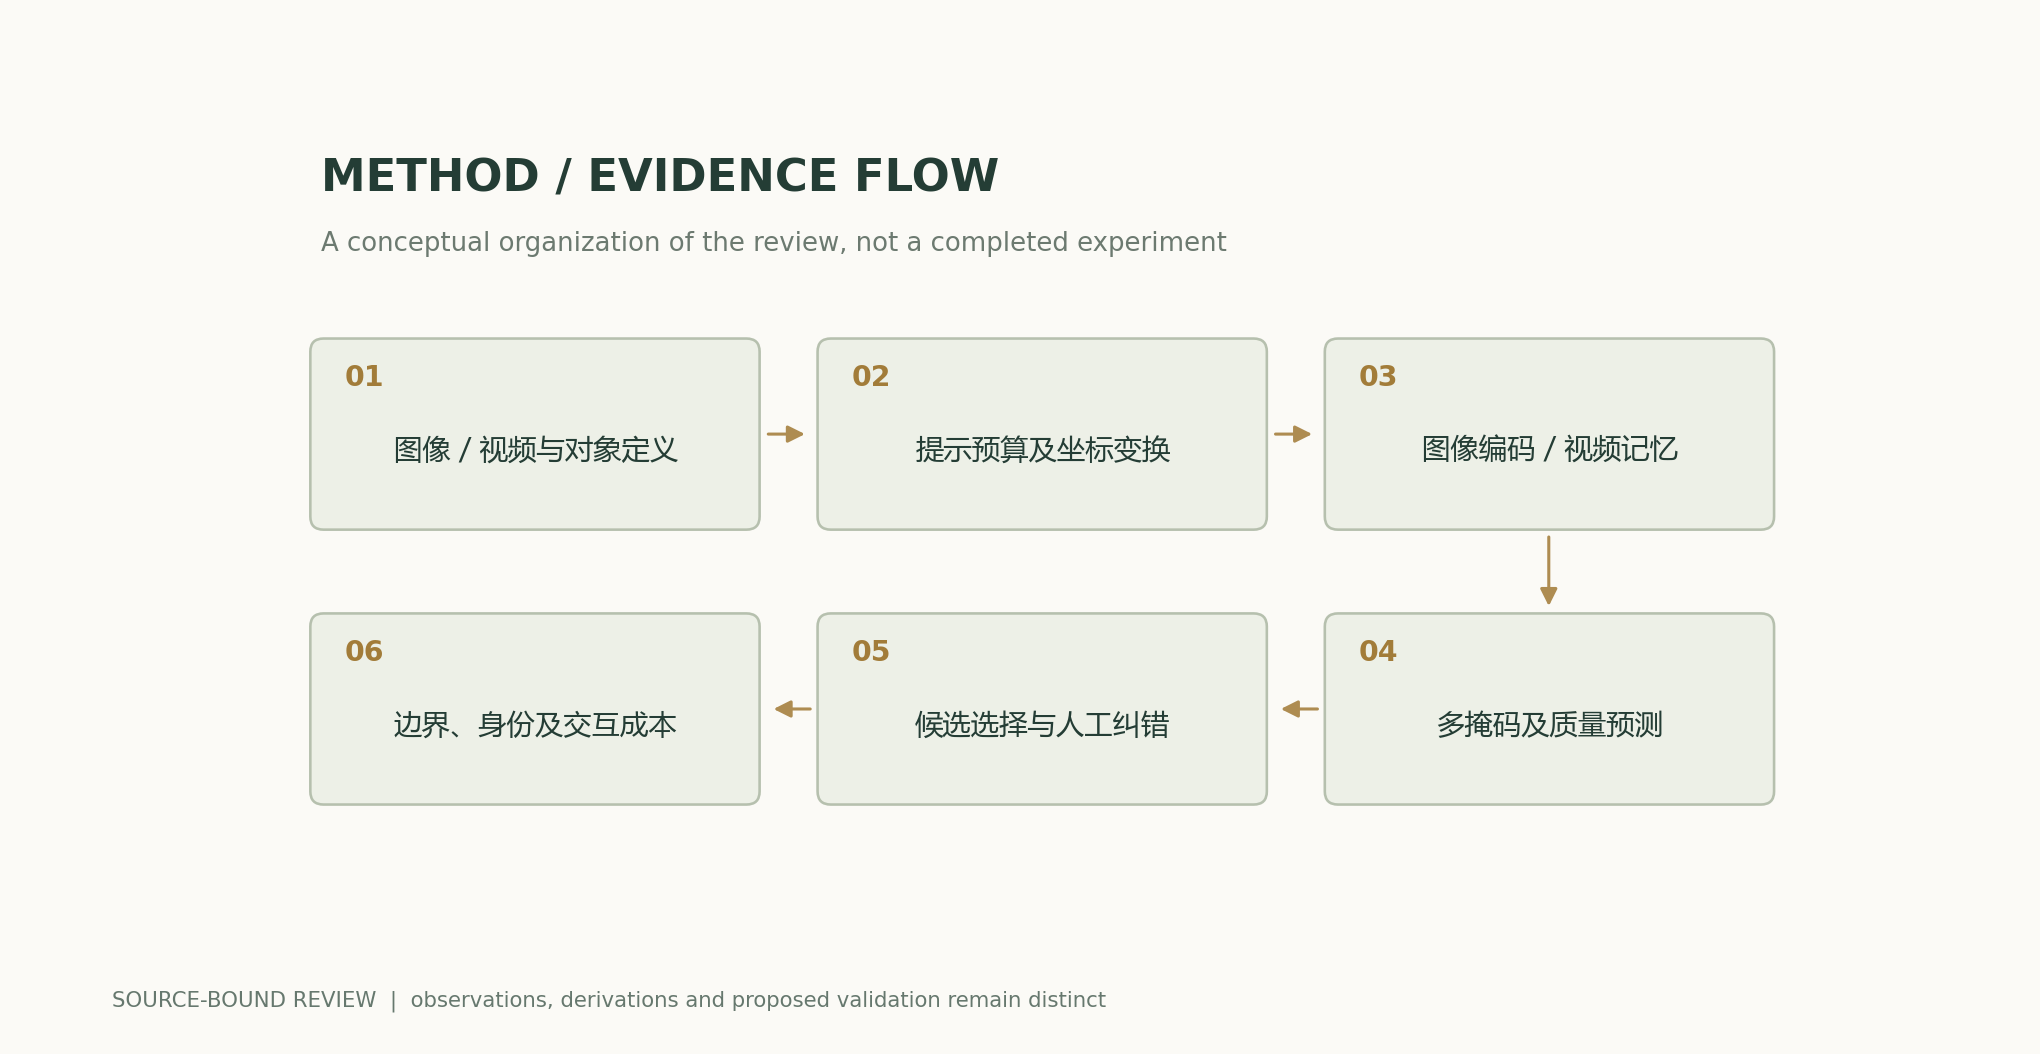
Figuras analíticas y ejemplos numéricos
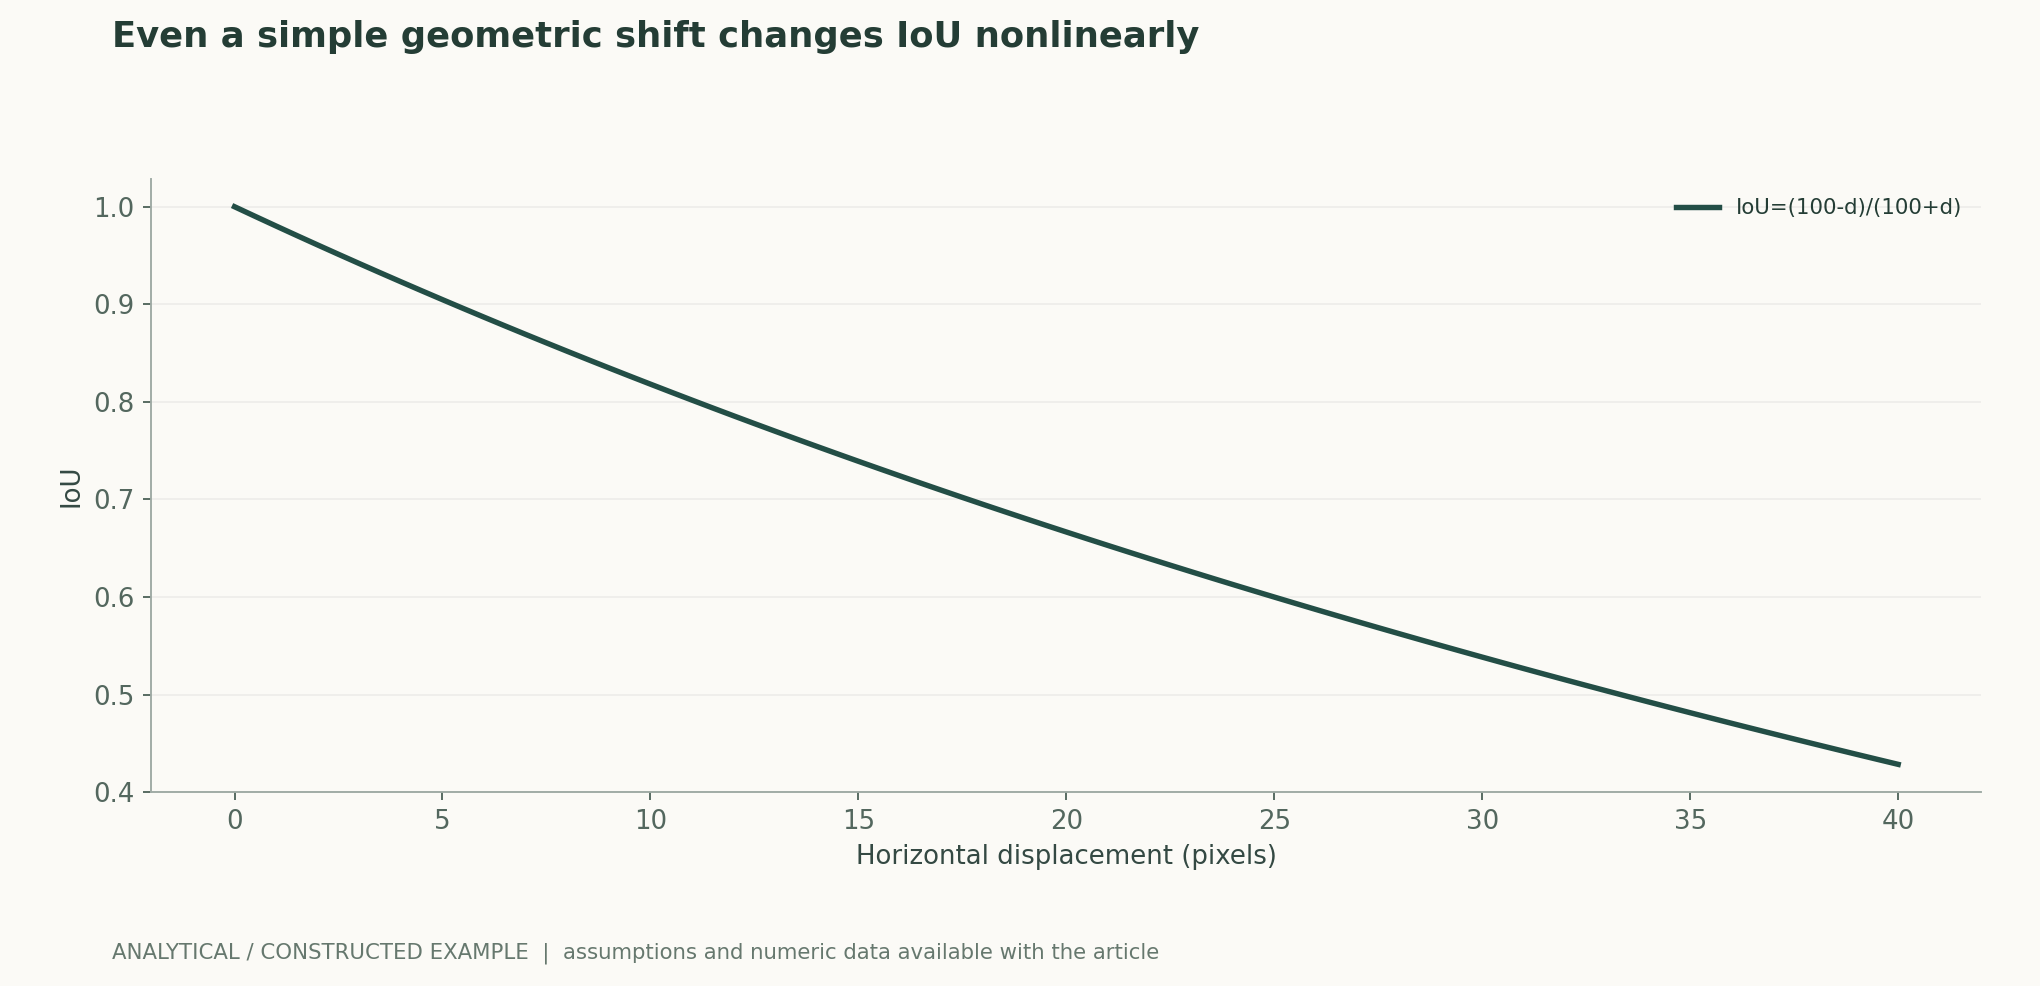
Ejemplo resuelto que permite repetir los cálculos
Con un desplazamiento horizontal de 10 píxeles, IoU=90/110≈0.818; con un desplazamiento de 25 píxeles, el valor es 75/125=0.6. Los límites complejos y la ambigüedad de las anotaciones no pueden describirse por completo mediante este modelo de rectángulos.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Protocolo de indicaciones | Fijar el origen de los puntos/recuadros, el número de interacciones y la definición del objeto | La selección humana retrospectiva infla los resultados |
| Calidad de los candidatos | Distinguir la selección basada en predicciones de la selección del mejor candidato según la verdad de referencia | Las puntuaciones predichas no son anotaciones |
| Memoria de vídeo | Evaluar oclusiones, reapariciones, cambios de plano y correcciones | La consistencia temporal puede mantener el seguimiento del objeto equivocado |
| Transferencia entre dominios | Anotaciones independientes del dominio y estratificación del riesgo | Los resultados en imágenes naturales no pueden extrapolarse directamente |
Plan de verificación y experimentación
- Fijar las versiones del modelo, el preprocesamiento, la definición del objeto y las anotaciones obtenidas legalmente.
- Dividir por fuente/vídeo para evitar la filtración de fotogramas adyacentes o variantes de la misma imagen.
- Fijar de antemano los presupuestos de indicaciones y selección de candidatos, y registrar todas las correcciones.
- Evaluar objetivos pequeños, límites, oclusiones, objetos similares, reapariciones y nuevos planos.
- Informar conjuntamente del solapamiento, los límites, la pérdida de identidad, el número de interacciones y los fallos estratificados.
- Medir por separado los costes de la codificación inicial y de las interacciones con caché, y comprobar las versiones de la caché y las transformaciones de coordenadas.
Ámbito de aplicación y limitaciones
- La IoU de rectángulos no es un resultado de rendimiento de SAM.
- La consistencia temporal no demuestra que la identidad sea correcta.
- La transferencia entre dominios requiere anotaciones independientes.
- Los presupuestos de indicaciones y candidatos afectan a la comparación.
Fuentes primarias y afirmaciones correspondientes
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SAM 2: Segment Anything in Images and Videos, , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled SAM 2: Segment Anything in Images and Videos, by Nikhila Ravi and 17 other authors · 2024-08-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag permanece igual. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de las figuras científicas; estas se calculan a partir de fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versiones e historial de correcciones · /guides/vision-segmentation-foundation/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770